Perplexity APIのFast Searchと標準webを比較:料金・速度・検索品質
Perplexity APIのFast Searchと標準webを、料金、レイテンシ、検索品質、情報源の網羅性で比較。10,000回の検索費用は$10対$50です。反復的な検索にはfast、曖昧で網羅性が重要な調査にはwebを使い分ける判断基準と、本番導入前に確認すべき検証手順を実務目線で解説します。




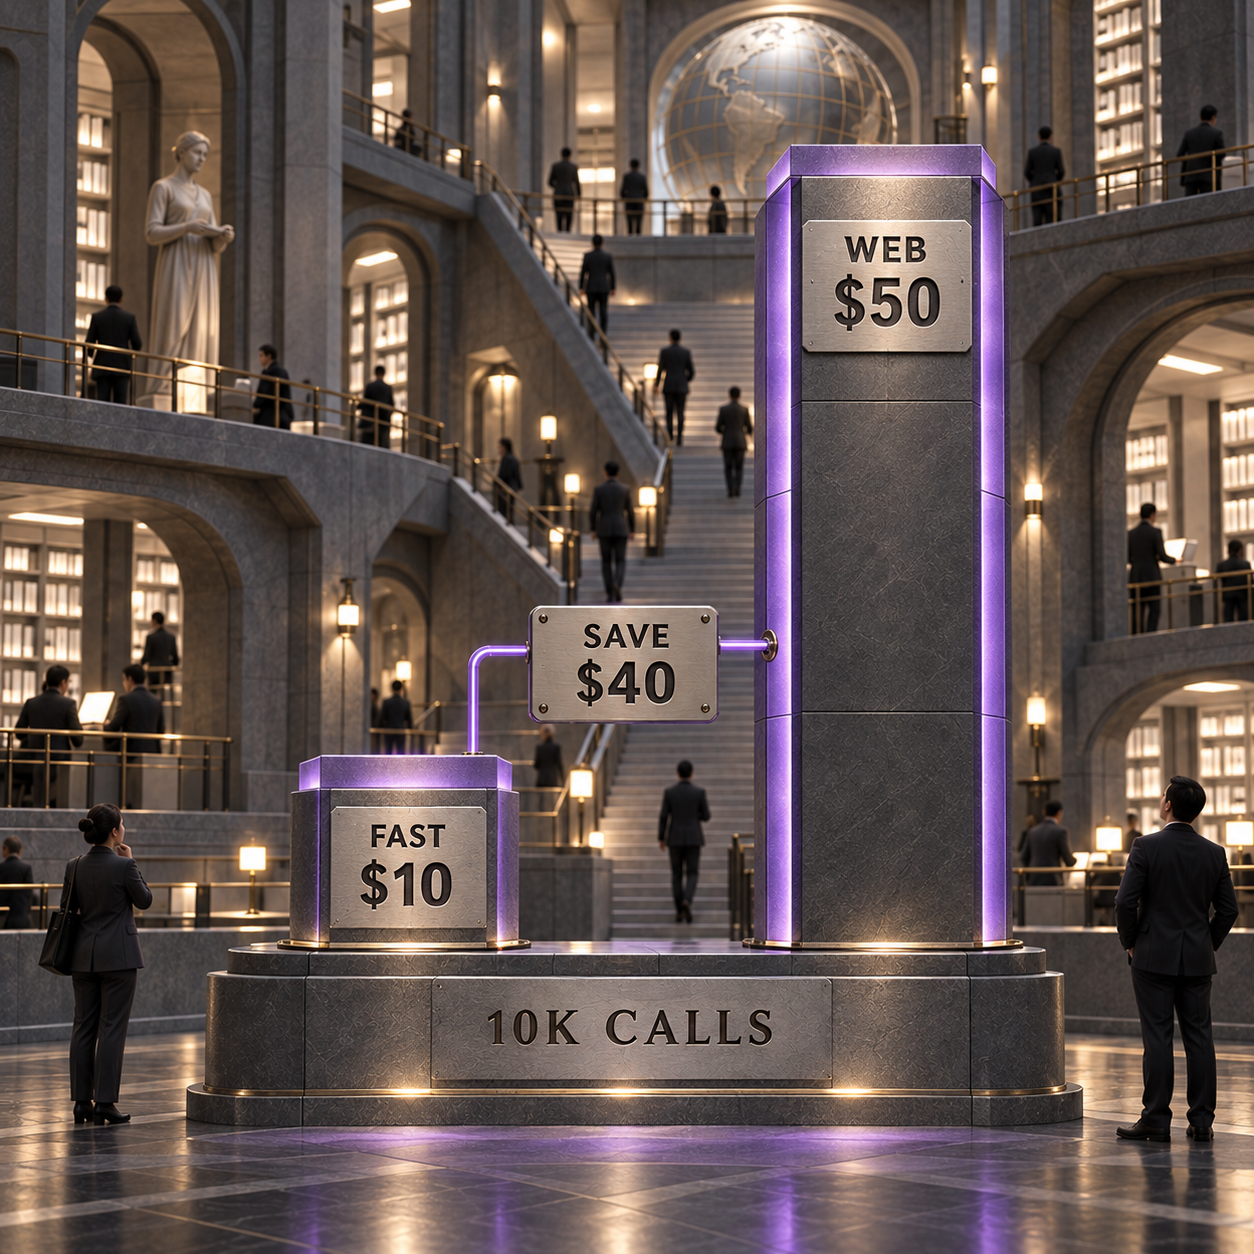
Perplexity APIでFast Searchと標準モードをどう使い分けるかは、ルーティングの問題です。繰り返し可能なエージェント検索には、成功した1,000回の呼び出しあたり$1のfastを使い、曖昧な調査や網羅性が重要な調査には$5の標準webを残します。10,000回なら、結果を処理するモデルの費用を含める前の検索料金は$10対$50です。
Perplexity APIはFast Searchと標準webのどちらを選ぶべきか
範囲が明確で繰り返し可能な処理にはFast Searchを、情報源を1つ見落とすだけで判断が変わり得る調査には標準webを選びます。 料金とレイテンシではFastが優位です。一方、検索品質と回答可能性では標準webが勝ります。本番環境のエージェントは、すべてのクエリを一方に固定せず、両者を振り分けるべきです。
Perplexityの現行Fast Searchガイドでは、日常的なエージェント処理にはfast、まれで難しい、または曖昧な質問には標準のweb設定を推奨しています。この比較に用いた料金とベンダー測定値は、2026年9月24日にPerplexityの公開中のページで確認しました。
サポートエージェントを開発する個人ビルダーなら、定型的なドキュメント検索やステータス確認はfastから始め、結果が空、または根拠が弱いときだけwebへ引き上げます。標準webを1回使う追加費用$0.004は、見落としによって人の確認が必要になる場面では小額です。しかし、低リスクの検索を何千回も繰り返すなら無駄になります。
市場調査プロダクトを作る資金調達済みの創業者なら、企業、政策、競合に関する曖昧な質問は標準webに任せるべきです。既知の情報源の確認、製品の提供状況、定期モニタリングにはFastも使えます。画面上の検索ボックスが1つでも、ワークロードには2種類の検索クラスがあります。
ミッドマーケット企業のCTOなら、社内のリプレイ検証でFast Searchが必要な情報源一式を維持できると確認するまでは、調達、セキュリティ、規制、インシデント調査に標準webを使います。リクエスト単価が5分の1でも、アナリストが根拠資料を修復しなければならないなら、安くはありません。
Perplexity Fast SearchのAPI:Photonで何が変わるのか
Fast Searchで変わるのは検索に使う計算予算であり、エンドポイントや結果スキーマではありません。 Perplexityは2026年9月24日、自社開発の検索・ランキングエンジンPhotonを基盤とするこのモードを公開しました。現行のFast Searchドキュメントでも、同じPOST /searchエンドポイントが同じ順位付きresults[]配列を返し、リクエストにsearch_type: "fast"を加えるだけで利用できることを確認できます。
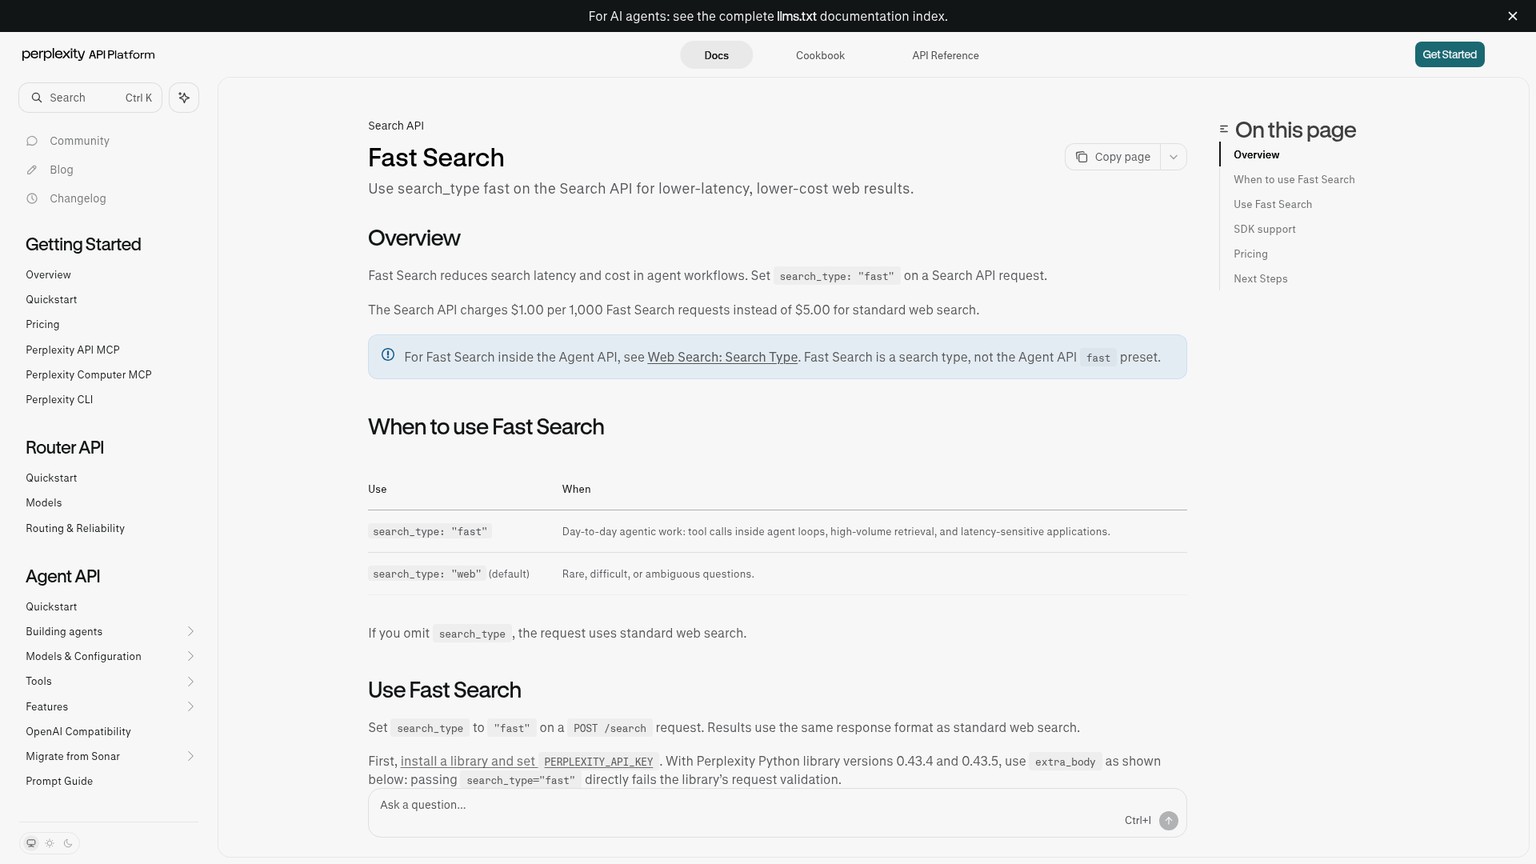
search_typeを省略すると、Perplexityは標準のwebを使います。ここでいう「標準」は、一般ユーザー向けPerplexityアプリのデフォルト言語モデルではなく、Search APIの標準検索モードです。どちらのモードも、後続処理に使えるタイトル、URL、スニペットに加え、任意で公開日と更新日を返します。
Photonのリリース説明によれば、このエンジンはクエリに必要なデータだけを読み込み、ディスク待機を重ねて処理し、バッチを考慮したキャッシュを使います。Perplexityの公式アーキテクチャ図には、ブローカーとシャードを通るリクエスト経路が示されています。こうした設計が高速性の根拠です。ただし、意図的なランキング上のトレードオフが消えるわけではありません。Fast Searchは計算量を抑える代わりに、広範な検索品質の一部を手放します。
Perplexity Photonはエンジンであり、第3のモードではない
PhotonはPerplexityの検索スタックを支える基盤です。APIで選べるのは引き続きfast、web、そして独立した検索タイプのpeopleです。開発者がPhotonを直接選択したり、デプロイしたり、別形式のレスポンスオブジェクトを受け取ったりすることはありません。
現行SDKには実務上の注意点があります。PerplexityはPythonライブラリのバージョン0.43.4と0.43.5について、新しい値が直接のバリデーションで拒否されるため、extra_body={"search_type": "fast"}の利用を案内しています。TypeScriptの例では、型定義が追いつくまでSDK 0.38.5で"fast" as anyにキャストしています。HTTPを直接呼び出せば、どちらの一時的なクライアント側制約も回避できます。
Perplexity APIの料金比較:10,000リクエストで$10対$50
勝者はFast Searchです。 現行のPerplexity料金表では、Raw Fast Searchは成功した1,000リクエストあたり$1、標準webは成功した1,000リクエストあたり$5で、Search APIに追加のトークン料金はありません。
同じ処理量にそろえると、計算はシンプルです。
- 10,000回のFast Search: 10,000 × $0.001 = $10。
- 10,000回の標準web: 10,000 × $0.005 = $50。
- 差額: $40。Raw検索費用を80%削減できます。
ただし、この$40だけでエージェント全体の請求額は決まりません。結果を読むモデル、追加取得、再試行、検証、人による確認は後段で発生します。Fastが本当に安いのは、10,000回のバッチ全体で追加作業を$40より増やさない場合だけです。
成功しても結果が空なら料金は発生する
POST /searchが成功すれば、results[]が空でも課金対象です。現行の料金ルールでは、不正なリクエスト、レート制限を受けたリクエスト、上流側の障害は課金されません。したがって、空結果率は品質だけでなく予算の指標でもあります。
バッチ処理で変わるのは請求額であり、品質判断ではない
Perplexityのマルチクエリ・クイックスタートでは、関連するクエリを1リクエストに最大5件まで含められます。成功したマルチクエリのリクエストは1課金単位ですが、各クエリは引き続きレート制限に数えられます。20件のクエリを各モード4リクエストにまとめれば、合計費用は**$0.024です。40件を個別のシングルクエリとして送る場合は$0.12**になります。
1回あたりのレイテンシ比較にバッチ処理を使ってはいけません。5件のクエリを含むペイロードはリクエストの処理量を変え、クエリ単位の所要時間を見えなくします。まず各モードで20回のシングルクエリを比較し、モードの判断が固まってからバッチ処理を別に検証します。
Agent APIのツール料金は別の予算項目にする
Agent APIのツール料金表には別の標準料金があり、fastのweb_searchは1,000回の呼び出しあたり**$1**、標準webは1,000回の呼び出しあたり**$2.50**で、選択したモデルのトークン料金が加わります。これはRaw Search APIの$1と$5の料金とは異なります。また、Fast SearchとAgent APIにある別のfastプリセットは、同じ語が使われていても別物です。
既存のPerplexity・Exa・Tavilyのコスト比較は、どのプロバイダーを選ぶかに答える記事です。今回の判断はさらに1段深く、Perplexityをすでに採用した後の選択です。
レイテンシはFastが優位、ただしベンダー測定という注記付き
Perplexityの測定では、勝者はFast Searchです。 Perplexityの公式レイテンシ図は、Fast Searchのシングル呼び出しについてp50で160 ms、p95で230 msと報告しています。周辺のリリース文や現行のFast Searchガイドには、標準webを同条件で測ったp50とp95が掲載されていません。そのため、両者の正確なレイテンシ比は示せません。
パーセンタイルには意味があります。p50は中央のリクエスト、p95は95%のリクエストが完了するまでの上限です。検索を複数回、順番に実行するエージェントは、中央値より遅い側の裾の影響を強く受けます。1回のツール呼び出しの遅れが、計画全体を止めるためです。
したがって、レイテンシ重視の処理はFastに任せるのが妥当です。ただし、本番での答えはワークロードごとに異なります。ネットワーク距離、フィルター、要求する結果数、抽出コンテキスト、バッチ処理、再試行ポリシーは、いずれもエージェントが体感するエンドツーエンド時間に影響します。ベンダーの数値は基準値であり、あらゆる実装に対するサービスレベルの保証ではありません。
Mikhail Basyukの実務家としての見方は、適切な基準を示しています。250 ms未満のp95に価値があるのは、タスクに必要な関連性が保たれる場合だけです。速度と根拠は同じダッシュボードで見る必要があります。
情報源の網羅性では標準webが優位
難しい調査や曖昧な調査では、標準webが勝者です。 Perplexityの社内検索評価図では、Fast Searchの関連性スコアは2.21、標準は2.45で、差は0.24ポイントです。回答可能性は0.567対0.596で、2.9パーセントポイントの差があります。
関連性は、順位付けされた情報がクエリに適合しているかを測ります。回答可能性は、回答を裏付けるだけの情報を検索で見つけられたかを測る指標です。Fastはすばやく結果を返しても、次のモデルに渡す根拠が薄い場合があります。そのため、幅広い政策上の質問、複数企業の比較、見解が分かれる主張は、fastが軽快に見えても標準webに任せるべきです。
一方、Perplexityはベンダー集計図で、一見すると逆の結果も報告しています。公開されている6つのエージェント型ベンチマークから選んだ3,554件のタスク全体で、Fastはモデルと検索の推定総コスト**$59.73で64.3%、標準は$187.60で64.0%**でした。ベンダーは、fast構成が同程度の総合タスク品質を保ちながら約68%安いと説明しています。
この2つの結果は矛盾しません。総合的なエージェントは、モデル自身の知識や推論、繰り返し呼び出しで弱い検索を補える場合があります。また、選ばれたタスクでは、情報源の欠落が毎回不利になるとは限りません。コンプライアンスや事業調査にRaw検索システムを使う場合、後段のモデルが欠けた文書を補ってくれると想定してはいけません。
より広いAI検索APIガイドでも、各ベンダーに同じ運用原則を適用しています。次の決定論的なチェックを通過できる根拠一式が得られる範囲で、最も安い検索レベルを選ぶという考え方です。
Perplexity Search APIでsearch_typeをfastに設定する方法
同じリクエストを2回使い、search_typeだけを変えます。 query、max_results、search_context_size、フィルター、地域、クライアントの場所は同じ条件に固定します。現行のSearch APIリファレンスでは、webが標準で、max_resultsのデフォルトは10、抽出コンテキストサイズのデフォルトはhighです。比較時は両方を明示し、将来APIのデフォルトが変わっても再実行結果が変わらないようにします。
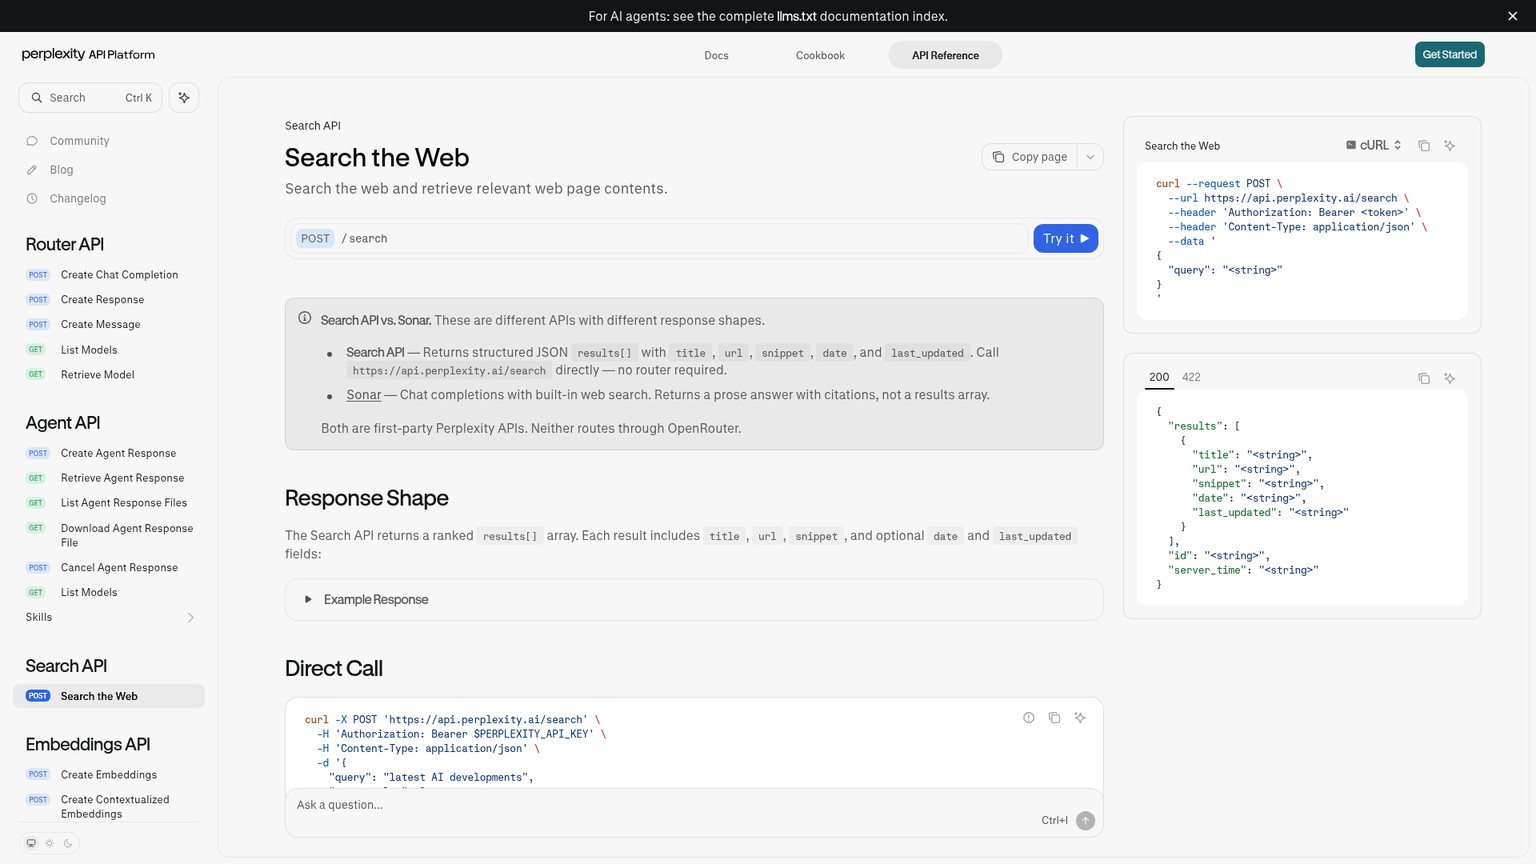
次の2つのリクエストは、そのまま実行できます。
set -euo pipefail
: "${PERPLEXITY_API_KEY:?Set PERPLEXITY_API_KEY first}"

QUERY='Which CRM has the stronger current EU data residency and audit-control evidence?'
COMMON=$(jq -nc --arg query "$QUERY" '{
  query: $query,
  max_results: 10,
  search_context_size: "high"
}')

for MODE in fast web; do
  jq --arg mode "$MODE" '. + {search_type: $mode}' <<<"$COMMON" |
    curl -sS 'https://api.perplexity.ai/search' \
      -H "Authorization: Bearer $PERPLEXITY_API_KEY" \
      -H 'Content-Type: application/json' \
      -o "$MODE.json" \
      -w "$MODE\tHTTP %{http_code}\t%{time_total}s\n" \
      --data-binary @-
done
この記事の制作時には、Perplexity APIの認証情報を利用できませんでした。そのため、レイテンシ、網羅性、空結果率、回答の裏付けについて、独自の測定結果は提示していません。以下の手順は小規模なペア比較であり、Perplexityによる6ベンチマークの調査を再現するものではありません。
事業調査向けのクエリを20件用意します。内訳は、権威ある情報源が明確な具体的検索10件と、複数の情報源を要する曖昧な質問10件です。実用的な固定セットには、現在のSaaS料金、クラウドの上限、規制の日付、対応国、セキュリティ統制、最近の提出書類、ベンダー比較、政策の影響、総コストに関する質問、賛否それぞれに信頼できる根拠がある主張を含められます。
シングルクエリ単位では、後段のモデル呼び出しを含める前の成功した40件のRawリクエストは$0.12です。内訳はfast 20回で$0.02、標準web 20回で$0.10です。
リクエスト条件を固定する
両モードで
max_results: 10とsearch_context_size: "high"を使います。フィルター、国、言語、クライアントの地域も同一にします。ウォームキャッシュや一時的なネットワーク状況が常に一方を有利にしないよう、クエリごとに先に実行するモードをランダム化します。検索動作を記録する
エンドツーエンドの
time_total、HTTPステータス、結果数、空レスポンスのフラグ、固有ドメイン、権威ある情報源の数、想定した一次情報が含まれるかを記録します。確認用にRaw JSONをすべて保存します。有用性を同じ基準で採点する
有用な情報源の網羅性は、意思決定に関係する情報源がなければ0、不完全でも利用可能な一式なら1、進行に十分な独立した根拠があれば2と採点します。同じドメインの重複や、1つの情報源を繰り返す長いスニペットには加点しません。
回答レイヤーを固定する
モデルで結果を回答に変換する場合は、同じモデル、プロンプト、トークン予算、引用チェッカーを使います。重要な主張に根拠がなければ回答の裏付けを0、一部だけ裏付けられれば1、すべての重要な主張が返された根拠に対応していれば2と採点します。
ワークロードの種類ごとに判断する
検索グループと曖昧な質問グループを分け、中央値とp95レイテンシ、空レスポンス、情報源の網羅性、回答の裏付けを比較します。チームの合格範囲内に根拠スコアを維持できたクラスだけをfastへ移します。
重要なのは平均結果数ではありません。弱いリンクの山より、少数の一次情報のほうが優れている場合があります。価格とレイテンシを意味ある指標にするのは、有用な網羅性と根拠に支えられた回答です。
切り替えで実際に発生するコスト
リクエスト本文の変更は簡単ですが、運用ポリシーの変更には作業が伴います。 ワークロードを標準webからfastへ移す際、データ移行も新しいエンドポイントも不要です。それでも、検索動作、キャッシュID、監視、障害処理は変わります。
キャッシュキーにはsearch_typeを含めます。広い検索範囲に料金を払った標準webのリクエストに、キャッシュ済みのfastレスポンスを黙って返してはいけません。同じ理由で、コンテキストサイズ、結果数、フィルター、国、言語もキーに含めます。
すべてのリクエストと後段の主張にモードを記録します。これがないと、情報源の採用率低下がモデルドリフトや偶発的な検索ノイズに見えてしまいます。ルーターには、empty_results、missing_primary_source、ambiguous_query、high_impactのようなエスカレーション理由も明示的に残します。
再試行もモードを意識して扱います。同じモードでタイムアウトを再試行するのは可用性対応です。fastからwebへの再試行は品質上のエスカレーションで、料金も変わります。両者を同じカウンターで数えてはいけません。
Fast Searchへ切り替えるべきでないケース
次の条件に当てはまるなら、Fast Searchを一律のデフォルトにしてはいけません。
- 契約、規制、セキュリティ、金融、医療情報、インシデント対応を扱い、情報源の見落としが重大な結果を招くエージェント。
- 既知の事実確認よりも、情報源の多様性を要する曖昧な質問がワークロードの中心である。
- 採用できる根拠の評価基準がなく、「速い」ことだけが目に見える成功指標になってしまう。
- プロバイダーアダプターやSDKが新しいenumを拒否し、チームが文書化された回避策や直接HTTPを安全に使えない。
- 成功した空レスポンスを通信障害と分けて記録していない。
- すべての回答ですでに必要な人の確認コストに比べ、標準webの追加料金が無視できる。
より良い移行方法は、ルーティングを使った段階展開です。繰り返し可能なクラスを1つだけfastへ移し、webをエスカレーション先として残し、採用できた根拠を比較してから対象を広げます。
月曜日に実行すること
全体のデフォルトを変える前に、シンプルな検索ポリシーを導入します。 繰り返し可能で影響の小さい検索はfastへ、曖昧または影響の大きい質問はwebへ送ります。そして、根拠が不合格なら、弱い回答をそのまま返さず自動でエスカレーションします。
作り物のデモではなく、先週のリクエストから始めます。製品の通常業務を代表する20件を選び、具体的な検索と曖昧な質問に分け、上記とまったく同じペアを再実行します。40件のシングルクエリがすべて成功した場合、Raw検索料金は$0.12です。
火曜日に確認するのは4つです。リクエストのp95レイテンシ、成功した空レスポンス、有用な情報源の網羅性、回答の裏付けスコアです。具体的検索グループでFastが根拠の基準を満たすなら、そのクラスだけを移します。曖昧な質問グループで一次情報を取りこぼすなら、総合ベンチマークの結果にかかわらず標準webを維持します。
これがPhotonの事業上の意味です。単一の安価なグローバル設定ではなく、実用的な検索リスクルーターを作れます。許容度の高いクエリでは1,000回あたり$1を使い、広い検索がより高価な見落としを防げるときだけ追加の$4を支払います。
よくある質問
Perplexityが物議を醸すのはなぜですか?
一般ユーザー向け製品、情報源の帰属、パブリッシャーとの関係をめぐる議論は、今回のAPIモード選択とは別の問題です。API導入側は、自組織の要件に照らして情報源の網羅性、利用条件、根拠の扱いを検証すべきです。
デフォルトの検索エンジンをPerplexityに変更する方法は?
これはブラウザーまたはデバイスの設定です。この比較でいう「デフォルト」はSearch APIの動作を指し、search_typeを省略すると標準のwebになり、Fast Searchにはsearch_type: "fast"が必要です。
Perplexityが失敗するのはなぜですか?
この問いの前提は広すぎて、引用したAPIの根拠だけでは立証できません。統合環境では、空結果、想定した一次情報の欠落、有用な網羅性の不足、裏付けのない回答、タイムアウト、上流側のエラーなど、失敗を具体的に定義します。
検索にはPerplexityとGoogleのAIモードのどちらが優れていますか?
これは一般ユーザー向け回答製品の比較であり、PerplexityのRaw Search APIモード同士の比較ではありません。Fastと標準webは、検索レイテンシ、有用な情報源の網羅性、後段の回答を支える根拠で選びます。
Joe RoganがPerplexityを使っているのはなぜですか?
公の推薦や広告から技術的な理由は立証できず、fastとwebの選択根拠にもなりません。APIは著名人の利用ではなく、ワークロードのデータで判断します。
Perplexityは今でも使えるサービスですか?
Fast Searchには、成功したRawリクエスト1,000回あたり$1という明確な用途があり、Perplexityはp50レイテンシを160 msと報告しています。同時に、ベンダー自身の検索評価から、関連性と回答可能性を広く確保する必要がある場合は標準webが適していることも分かります。
Perplexityの欠点は何ですか?
Fast Searchについて文書化されている欠点は、検索の関連性と回答可能性が低いことです。標準webの欠点は、Rawリクエスト料金が5倍であり、速度向けに設計されたモードよりレイテンシが高いことです。
Perplexityのユーザーは減っていますか?
引用したリリースとAPIページには、監査済みのアクティブユーザー推移データがありません。そのため、この比較からその主張を裏付けることはできません。ユーザー数の増減が分かっても、本番クエリに適したSearch APIモードは決まりません。
Perplexity AIはChatGPTより優れていますか?
PerplexityのRaw Search APIは、別のシステムが処理するための順位付きWeb検索結果を返します。一方、ChatGPTは独自のツールとモデルを備えたエンドユーザー向けアシスタントです。ブランドを抽象的に比べるのではなく、具体的なワークフローと根拠の要件を比較します。
ルーティング、検証、コストの論点を1枚で整理したい方は、AI Business Workflow Audit Checklistをダウンロードして、月曜日に最初の検索リスクルーターを設計してください。
- 最終更新
- 2026年9月24日
- カテゴリー
- Build
Googleでこのサイトを優先する


omidsaffari.comを優先ソースに設定すると、GoogleがTop Stories・AI Overviews・AI Modeであなたのために優先表示します。

AIエージェント コストの盲点:有料フォールバックが既定経路になった日
AIエージェント コストの盲点を、実際の公開障害から読み解きます。画像ファイルの受け渡しが止まり、有料フォールバックが既定経路となり、共有残高は$8.30から$0へ。カバーや埋め込みが欠けてもジョブはdoneのままでした。サンドボックス境界、認証情報の所有、完了条件、従量課金の監視をどう設計し直すべきかを解説します。2026年9月24日Build
Cursor 料金を検証:Rolloutsは無料で使えるのか
Cursor Rolloutsは無料ではなく、Teamsは1ユーザー月額$40、Enterpriseは個別見積もりです。10日間のローンチクレジットでTeamsは約50件、Enterpriseは約500件の変更を試せますが、その後の単価は未公表。料金の仕組みと導入判断を整理します。2026年9月24日Build
AIエージェント基盤「Unreal Agent」を実務で評価する方法
AIエージェント実行基盤「Unreal Agent」をコマンドラインで安全に試す手順を解説します。リリース、モデル、推論レベルを固定し、JSONL、実行時間、終了ステータス、トークン使用量、差分を記録して、既存エージェントとの品質・コスト比較や、ランナーとGoライブラリの選び分けまで判断できる実践ガイドです。2026年9月24日Build
JetBrains Airの使い方:Alphaプラグイン導入・設定・レビュー手順
JetBrains Airの使い方を、Air Alphaの導入からエージェント接続、@file:でのコンテキスト指定、差分レビュー、テスト、元に戻す判断まで実践的に解説します。Standard Accessで小さな修正から安全に始める手順に加え、料金、互換性、具体的な活用例も分かりやすくまとめました。2026年9月23日Build
JetBrains Airは無料?料金の仕組みと支払元を徹底整理
JetBrains AirのAir Alphaプラグインは無料ですが、IDE本体や接続するAIエージェント、API利用料まで無料とは限りません。Junie Lite、既存アカウント、APIキー、JetBrains AIという4つの認証経路ごとに、誰が料金を負担するのかを公開情報と具体的な料金比較で整理します。2026年9月23日Build
Firecrawl APIをセルフホストする方法:Docker導入と料金比較
Firecrawl APIをセルフホストする手順を、v2.11.162への固定、実スクレイプと再起動後の検証、証跡保存まで詳しく解説します。さらにFirecrawl Cloudとの機能差と30日間の費用を比較し、セルフホストを選ぶべき条件、運用負荷、導入前に確認すべきセキュリティと本番要件を整理します。2026年9月22日Build
生成AI ガバナンスの盲点:有料リトライを人が承認する設計
AIエージェントが自らの品質判定で有料レンダリングを再実行し、人が確認する前に$5.48を消費した事例を解説します。生成AI ガバナンスで見落としやすいのは、レビュー権限と購入権限の違いです。人だけが承認を書き込めるフィールドを設け、有料ツール呼び出しの直前で再購入を拒否する実装と、その適用範囲を具体的に整理します。2026年9月22日Build