Runpod pricing en 2026: cuándo elegir Pods o Serverless
Compara los precios de Runpod para Pods, Serverless y almacenamiento, con cálculos de H100 y el punto de equilibrio según el tiempo facturable.


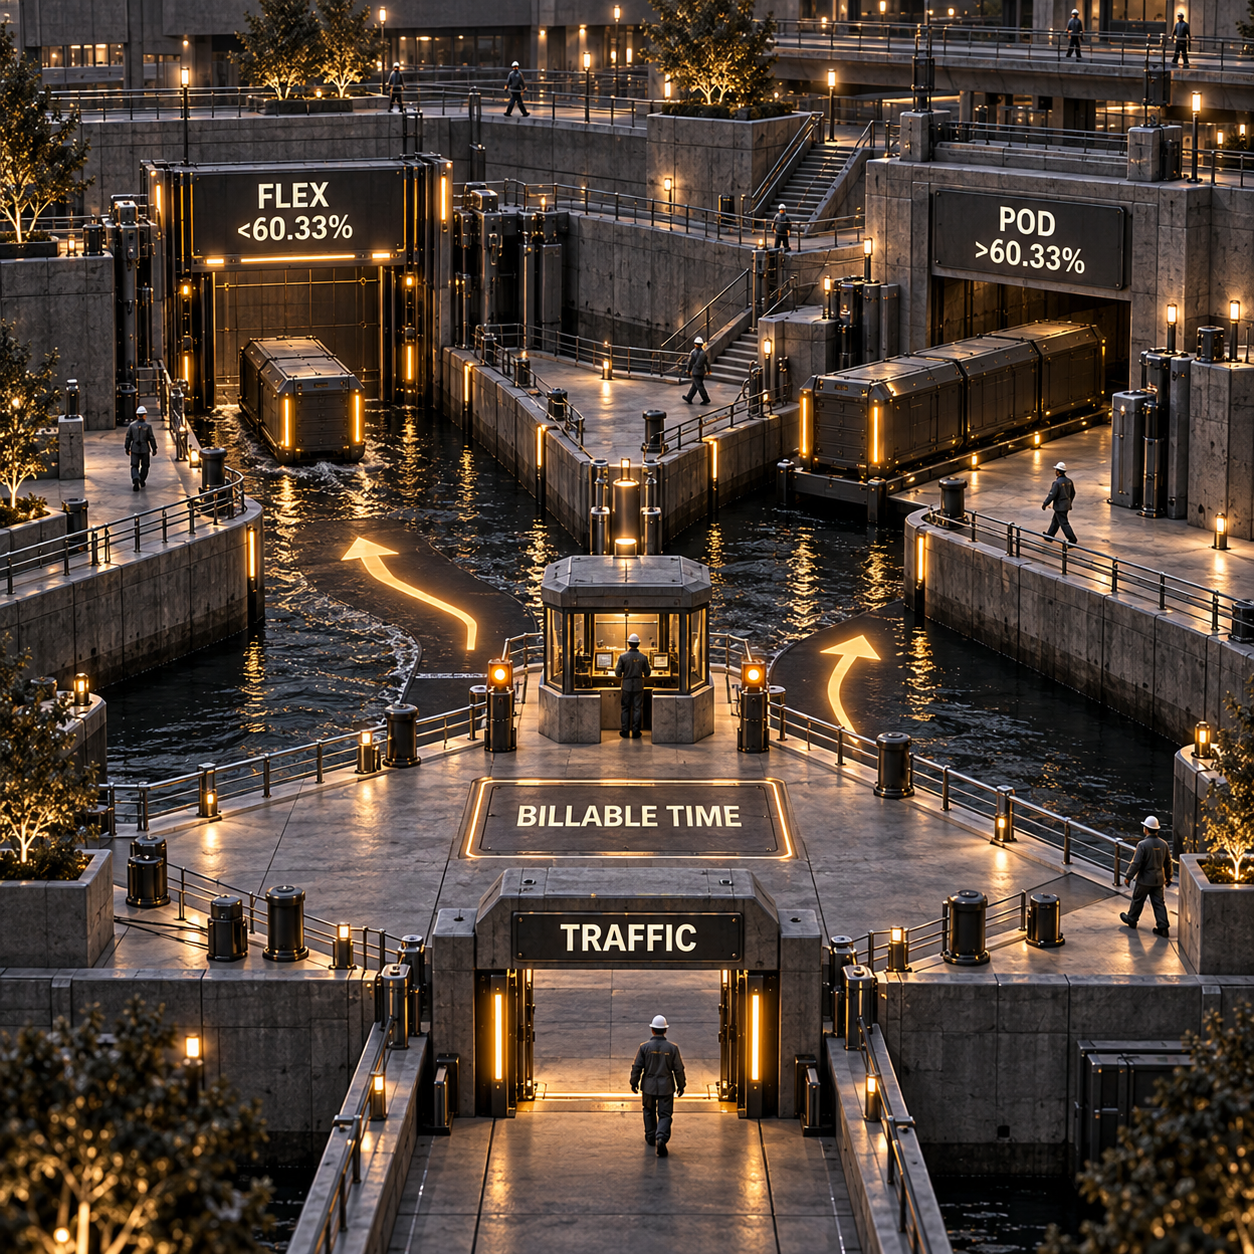
En esta guía de Runpod pricing, una H100 para producción parte de $2.89 por hora en un Secure Cloud Pod o de $4.79 por hora facturable de worker en Serverless, antes del almacenamiento. Serverless solo gana mientras la suma del arranque, la ejecución, los reintentos y el tiempo inactivo se mantenga por debajo del 60.33% de la ventana de ejecución del Pod; por encima de ese punto, conviene conservar la GPU.
Runpod pricing: precios de un vistazo
Runpod es infraestructura con pago por uso, no un plan SaaS mensual. La decisión práctica consiste en pagar por un Pod dedicado mientras está activo, pagar por workers de Serverless solo durante el tiempo que permanecen en ejecución o contratar capacidad cotizada para una carga sostenida.
Los precios siguientes se verificaron en la página de precios de Runpod el 25 de septiembre de 2026. Esa página está fechada el 13 de septiembre de 2026. La consola sigue siendo la referencia para confirmar la disponibilidad y la tarifa final de cada GPU, nivel de nube y región.
Runpod no tiene el típico selector entre pago mensual y anual. Los Pods se contratan bajo demanda; un Pod Savings Plan se prepaga por 3 o 6 meses; y los Reserved Clusters publican plazos de hasta 12 meses y superiores, aunque exigen una cotización. Tampoco existe un recargo convencional por exceso de uso: el cómputo y el almacenamiento siguen acumulando cargos hasta que la carga se detiene, el saldo llega a cero o interviene el límite de gasto predeterminado de $80/hora para toda la cuenta. Runpod indica que soporte puede elevar ese límite.
Precios de GPU en Runpod para Pods
Las tarifas de los Pods favorecen las instancias dedicadas cuando un modelo necesita permanecer en la GPU durante periodos largos y previsibles. El usuario controla el contenedor y conserva una GPU dedicada mientras el Pod está activo; a cambio, también paga los minutos sin actividad.
El catálogo actual de Pods publica estas tarifas por hora, todas facturadas por segundo:
- 80GB o más: B300 $7.89, B200 $6.79, H200 $4.59, RTX Pro 6000 $2.09, H100 NVL $3.19, H100 PCIe $2.89, H100 SXM $3.49, A100 PCIe $1.59 y A100 SXM $1.59.
- 48GB: Pro 6000 MIG $1.09, L40S $1.09, RTX 6000 Ada $0.84, A40 $0.49, L40 $0.82 y RTX A6000 $0.53.
- De 24GB a 32GB: RTX 5090 $0.99, Pro 6000 MIG 24GB $0.59, L4 $0.49, RTX 3090 $0.50, RTX 4090 $0.74 y RTX A5000 $0.27.
Son precios de catálogo, no una promesa de que cada tarjeta esté disponible en todas las ubicaciones. Antes de cerrar un presupuesto, hay que seleccionar la GPU, el nivel de nube y la región en la consola.
Community Cloud frente a Secure Cloud
Secure Cloud es la opción predeterminada para producción. Runpod la describe como hardware de un solo inquilino en centros de datos T3/T4 y la orienta a producción o datos regulados. Community Cloud recurre a capacidad de terceros previamente evaluada y conviene tratarla como un grupo más económico para experimentos y tareas que puedan reanudarse.
Para la H100 PCIe, el comparador de H100 publicado muestra $1.99/hora en Community Cloud y $2.89/hora en Secure Cloud. Esa diferencia de $0.90 ahorra $90 a lo largo de 100 horas de GPU, pero no es un descuento sin contrapartidas. Un agente de cara al cliente con un compromiso de entrega no debería renunciar al nivel de producción solo para ahorrar $0.90 por hora.
Hay una incoherencia en la página del proveedor que conviene conocer. El encabezado y el comparador de la página actual de H100 coinciden con la página principal de precios en $2.89/hora para Secure Cloud, pero una sección de preguntas frecuentes situada más abajo aún indica $2.39/hora. Debe usarse $2.89 hasta que la consola muestre otra cifra.
Los Savings Plans son la opción con compromiso para un Pod. Exigen el pago anticipado de 3 o 6 meses, cubren únicamente el cómputo de GPU, excluyen el almacenamiento, tienen fechas de vencimiento fijas y no son reembolsables. Si se detiene un Pod, el plan puede trasladarse a la siguiente implementación del mismo tipo de GPU. Es útil para una flota estable, pero encaja mal en un equipo que todavía cambia de tarjetas o de patrón de tráfico.
Runpod Serverless: se paga el tiempo del worker, no las solicitudes
Serverless resulta más barato que un Pod siempre activo solo si los workers pasan suficiente tiempo escalados a cero. La factura sigue el tiempo de vida del worker, no las llamadas correctas a la API; por eso, los arranques en frío, la carga del modelo, los intentos fallidos y el tiempo de espera inactivo forman parte del presupuesto.
Runpod ofrece dos tipos de worker:
- Los workers Flex escalan a cero y aplican la tarifa por segundo publicada.
- Los workers Active permanecen activos 24/7 para ofrecer tráfico constante y baja latencia. La documentación de facturación de Runpod señala que hay descuentos disponibles mediante una consulta comercial, pero no promete un porcentaje fijo.
No se debe presupuestar H100 Flex a $4.18/hora ni dar por hecho que todos los workers Active reciben un 30% de descuento. La tarifa actual de H100 Flex es de $4.79/hora, y la tarifa Active depende de la cotización. Un porcentaje fijo antiguo puede hacer que la arquitectura equivocada parezca más barata antes de que llegue una sola solicitud.
Tarifas de GPU para Runpod Serverless
El catálogo actual de Flex tiene 13 categorías de precios:
- Memoria amplia: B300 $9.98/hora, B200 $8.64, H200 $5.93, RTX 6000 Pro $3.49, H100 $4.79 y A100 $2.72.
- 48GB y 32GB: L40/L40S/6000 Ada/MIG 48GB $1.75, A6000/A40 $1.22, RTX 5090 $1.58 y RTX PRO 4500 Blackwell $1.15.
- 24GB y 16GB: RTX 4090 $1.10, L4/A5000/3090/MIG 24GB $0.69 y A4000/A4500/RTX 4000/RTX 2000 $0.58.
La categoría depende de la GPU del worker, no del nombre del modelo ni de la solicitud. Un worker de 24GB que procesa una solicitud diminuta sigue siendo un worker de $0.69/hora mientras esté activo. Una H100 que procesa una solicitud fallida también consume los segundos durante los que funcionó.
El reloj facturable se divide en tres partes:
- Arranque: inicializar el contenedor y cargar el modelo en la memoria de la GPU.
- Ejecución: procesar la solicitud, incluido el trabajo que después falla.
- Tiempo de espera inactivo: mantener el worker activo cuando termina el trabajo por si llega otra solicitud. El valor predeterminado documentado es de 5 segundos.
La cantidad de workers multiplica las tres fases. Cada worker que carga el modelo añade su propio tiempo de arranque antes de iniciar la ejecución. El autoescalado puede ahorrar capacidad inactiva, pero un escalado agresivo también puede repetir el costo de arranque en varios workers.
Hoja de cálculo de costos de Runpod: 100 horas, 730 horas y solicitudes correctas
Este modelo de costos de Runpod es reproducible; no pretende medir el rendimiento. Antes de aprobar el gasto de producción, hay que sustituir cada supuesto por registros guardados de facturación y solicitudes.
El caso base, fechado, utiliza:
- GPU: una NVIDIA H100.
- Pod: Secure Cloud H100 PCIe a $2.89/hora.
- Serverless: un worker H100 Flex a $4.79/hora.
- Región: se supone Estados Unidos; se utiliza la tarifa del catálogo global, y es necesario comprobar en la consola el inventario y el precio de la región seleccionada.
- Almacenamiento: un volumen de red estándar de 100GB conservado durante un mes por $7.
- Modelo de solicitudes: 20 segundos de arranque por ventana de tráfico, 2 segundos de ejecución por intento, el tiempo de espera inactivo documentado de 5 segundos, un 2% de intentos fallidos y 100 solicitudes correctas por ventana.
- Base de solicitudes del Pod: un Pod de producción activo durante todo el mes de 730 horas para responder en cualquier momento.
Las filas de solicitudes dejan a la vista el efecto del patrón de tráfico. No afirman que una H100 necesite 2 segundos para el modelo del lector. Indican que, si la carga requiere 2 segundos por intento y llega en grupos de 100, mil solicitudes correctas cuestan esa cantidad.
Para 1,000 resultados correctos, se divide entre un 98% de éxito y se redondea hacia arriba para obtener 1,021 intentos. El worker dedica 200 segundos al arranque en 10 ventanas, 2,042 segundos a la ejecución y 50 segundos a la espera inactiva. Total: 2,292 segundos facturables, es decir, $3.05 de cómputo H100.
Para 10,000 resultados correctos, el mismo método produce 10,205 intentos, 2,000 segundos de arranque, 20,410 segundos de ejecución y 500 segundos de espera inactiva. Total: 22,910 segundos facturables, es decir, $30.48 de cómputo.
El almacenamiento se cobra por separado. Al sumar el volumen de red estándar de 100GB, el total mensual llega a $10.05 y $37.48, aunque ese volumen también puede atender otro tráfico. No debe esconderse dentro de una tarifa por solicitud inventada.
Sensibilidad: la cadencia del tráfico cambia el resultado
Una imagen base más rápida y un patrón de tráfico más cálido pueden reducir el costo de cómputo. Con 5 segundos de arranque, 1 segundo de ejecución, ningún fallo, un periodo inactivo de 5 segundos y 100 resultados correctos por ventana, el cómputo modelado es de $1.46 para 1,000 resultados correctos y $14.64 para 10,000.
El patrón opuesto sale caro. Si cada intento llega después de escalar a cero y provoca su propio arranque de 20 segundos, una ejecución de 2 segundos y un periodo inactivo de 5 segundos, el costo de cómputo modelado sube a $36.68 para 1,000 resultados correctos y $366.61 para 10,000.
Ese rango explica por qué las solicitudes son una mala unidad bruta de facturación. Solo resultan útiles después de asociarlas con los segundos de worker observados, la tasa de fallos y la concurrencia.
El punto de equilibrio entre Pods y Serverless depende de los segundos facturables
El punto de equilibrio solo para cómputo de la H100 base es exacto: se divide la tarifa de $2.89 del Secure Pod entre la tarifa de $4.79 de Serverless. El resultado es 60.33%.
Para cualquier ventana de observación:
Serverless wins when billable worker seconds < window seconds × 2.89 / 4.79.
En una ventana de servicio de 100 horas, Serverless debe mantenerse por debajo de 60.33 horas facturables de worker para superar al Pod de $289. En un mes de 730 horas, debe quedar por debajo de 440.44 horas facturables de worker para superar $2,109.70. Si el almacenamiento es idéntico, se cancela en la comparación; si cambia, no.
Community Cloud cambia el cálculo, no el riesgo. Con $1.99/hora para una H100 PCIe, su punto de equilibrio solo de cómputo frente a Serverless a $4.79 es del 41.54%, o 303.28 horas facturables en un mes de 730 horas. Ese umbral inferior importa para trabajos reiniciables. No justifica mover tráfico sensible de clientes a capacidad de terceros.
Una cotización de workers Active puede volver a desplazar el umbral. Hasta que Runpod entregue la tarifa por escrito, no existe una cifra honesta que pueda incluirse. Un 30% fijo supuesto no es una cotización.
Precios de almacenamiento de Runpod: un Pod detenido no es gratis
La documentación de almacenamiento de Pods de Runpod contempla tres comportamientos estándar. Confundirlos puede hacer que un Pod detenido genere una factura de almacenamiento mayor.
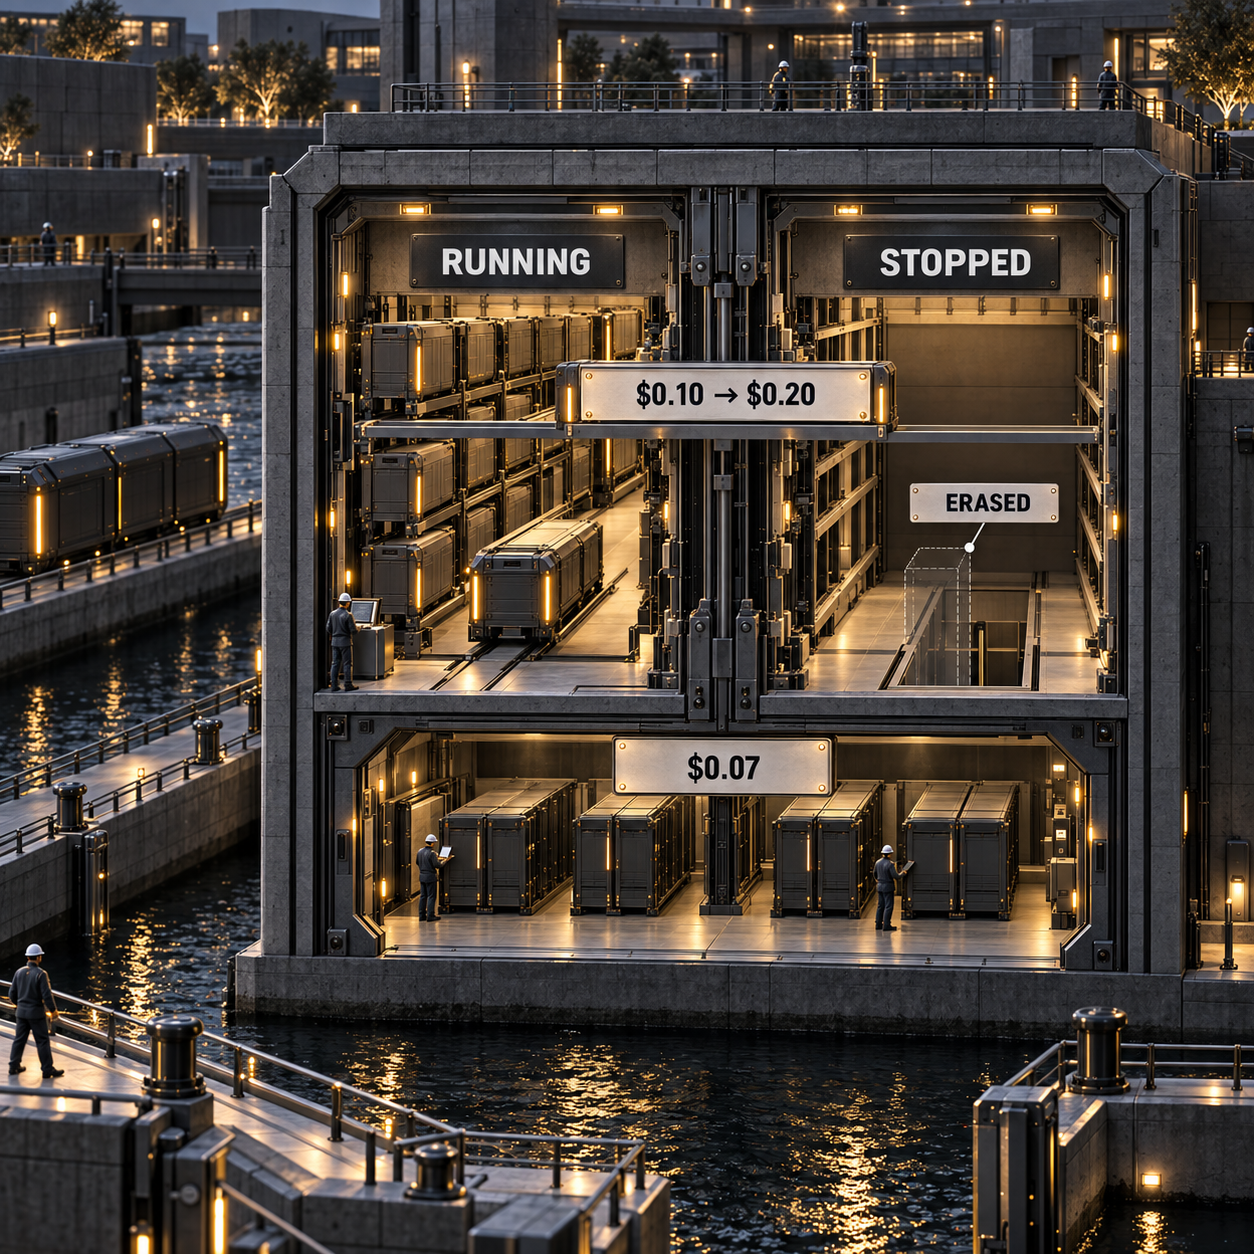
- Disco del contenedor: $0.10/GB/mes mientras está activo. No se cobra cuando se detiene porque los datos se borran.
- Disco de volumen: $0.10/GB/mes mientras está activo y $0.20/GB/mes mientras está detenido. Por lo tanto, un volumen retenido de 100GB pasa de $10 a $20 al mes después de detener el Pod.
- Volumen de red estándar: $0.07/GB/mes por debajo de 1TB y $0.05/GB/mes por encima de 1TB, tanto si el cómputo está activo como si está detenido.
- Almacenamiento de red de alto rendimiento: la página principal de precios indica $0.14/GB/mes, mientras que la documentación de almacenamiento dice que la tarifa exacta varía según el centro de datos. La consola debe considerarse definitiva.
El costo de almacenamiento de Runpod también condiciona la ubicación. Los volúmenes de red solo están disponibles para Pods en Secure Cloud. Deben elegirse durante la implementación y después no pueden conectarse ni desconectarse sin eliminar el Pod. En Serverless, cada volumen está ligado a un centro de datos, lo que puede reducir la disponibilidad de GPUs. Varios volúmenes pueden ampliar las opciones de ubicación, pero Runpod indica que no se sincronizan automáticamente.
Para compartir los pesos del modelo entre workers elásticos, un volumen de red puede evitar descargas repetidas. Para un experimento desechable, el disco del contenedor puede ser más barato. Si un Pod detenido debe conservar su espacio de trabajo local, el disco de volumen es la sorpresa costosa.
Alternativas a Runpod: comparación por una hora pagada de H100
Antes de incorporar las funciones de cada plataforma a la decisión, conviene comparar las alternativas usando el mismo tiempo pagado de acelerador. Para 100 horas pagadas de GPU H100, las tarifas actuales de los proveedores arrojan estos costos de cómputo:
- Runpod Secure Cloud Pod: $289 por H100 PCIe.
- Lambda: $329 por una instancia con una GPU H100 PCIe. La página de instancias de Lambda incluye 1TiB SSD en esa configuración e indica que los impuestos sobre ventas, el IVA o el GST aplicables se cobran aparte.
- Modal: $394.92 en cargos de GPU H100 SXM5 a partir de $0.001097 por segundo, antes de sus cargos independientes de CPU y memoria. Modal Starter incluye $30 mensuales de crédito gratuito.
- Runpod Serverless: $479 si las 100 horas de worker son facturables.
- AWS: $519.10 por una H100 p5.4xlarge Capacity Block en US East, a partir de $5.191 por hora de acelerador. AWS cobra por adelantado la reserva, por lo que no es un equivalente de Serverless bajo demanda.
Esta normalización es deliberadamente limitada. Modal utiliza H100 SXM5; las filas de Runpod y Lambda utilizan H100 PCIe; AWS vende una Capacity Block programada; y las CPU, la memoria, el almacenamiento, la orquestación y la disponibilidad incluidos son diferentes. La lista responde a la pregunta sobre la tarifa del acelerador sin fingir que los servicios son intercambiables.
Runpod frente a Vast.ai
Una comparación fija con Vast.ai no puede reducirse a una única cifra duradera para H100. Vast.ai explica que los precios de su marketplace cambian con la oferta y la demanda, actualiza su tabla en vivo cada hora, denomina “desde” a la oferta alquilable más barata y publica una mediana independiente. Runpod publica una tarifa de catálogo y divide la capacidad entre los niveles Community y Secure.
Vast.ai conviene cuando es posible consultar las ofertas en vivo, filtrar por fiabilidad y trasladar el trabajo cuando cambia la oferta. Runpod resulta más adecuado cuando pesan más una tarifa publicada estable, un nivel Secure y la ruta de Pod a Serverless que aprovechar el anuncio más barato de un momento concreto.
Si la verdadera alternativa es una API de inferencia gestionada, también debe compararse el trabajo operativo, no solo el tiempo de GPU. El análisis de precios de Together AI ofrece un contrapunto útil a la factura de una GPU autogestionada.
Qué modalidad conviene en cada caso
Los Secure Cloud Pods son adecuados para un agente de IA de cara al cliente o un servicio de procesamiento de documentos que mantiene una GPU ocupada durante gran parte del día. La tarifa del Pod es menor, la ubicación del almacenamiento resulta más clara y un modelo caliente evita arranques repetidos. El límite es la capacidad inactiva: se paga cada minuto sin actividad.
Serverless Flex encaja en una función con largos periodos de inactividad, campañas por ráfagas, lotes programados o un tráfico de lanzamiento incierto. Puede escalar a cero, pero los segundos de arranque, reintentos e inactividad deben quedar por debajo del punto de cruce. El límite es repetir el ciclo de vida del worker, en especial cuando un modelo grande tarda en cargar o el autoescalado se expande con demasiada agresividad.
Los workers Active solo deben elegirse cuando los requisitos de latencia y el tráfico medido justifiquen una conversación comercial. Permanecen activos 24/7. Sin una cotización por escrito, no existe un descuento fiable que pueda modelarse.
Los Community Cloud Pods son apropiados para experimentos, evaluación y trabajo por lotes reiniciable. No son la opción para datos regulados ni para un endpoint de producción cuya disponibilidad forme parte de la promesa del producto.
Los Instant o Reserved Clusters tienen sentido para trabajo realmente multi-GPU, no como mejora predeterminada de inferencia. Instant Clusters publica precios de A100 y H200 y escala hasta 64 GPUs; otros tipos de GPU y todos los plazos de Reserved Clusters exigen una consulta comercial.
Antes de elegir el hardware, hay que decidir qué modelo usar y quién conservará su control. La guía de modelos privados para agentes ayuda a dimensionar el modelo, mientras que agentes de programación gestionados frente a autogestionados plantea la contrapartida operativa.
- Facturación por segundo en Pods y Serverless, sin cargos de entrada ni salida de datos.
- Una ruta desde Pods económicos hasta inferencia con escalado a cero y clústeres multi-GPU.
- Tarifas de catálogo publicadas para GPUs de consumo, de centros de datos y Blackwell.
- La capacidad Secure y Community permite asignar presupuestos de riesgo distintos al trabajo reiniciable y al de producción.
- La misma página oficial de H100 contiene un precio obsoleto de Secure Cloud en sus preguntas frecuentes.
- Los descuentos para workers Active solo se ofrecen mediante cotización, por lo que no puede modelarse públicamente una tarifa central de producción.
- El disco de volumen cuesta el doble cuando un Pod está detenido.
- La ubicación del volumen de red puede reducir la disponibilidad de GPUs en Serverless, y los volúmenes no se sincronizan automáticamente.
- La disponibilidad y el precio regional final todavía deben confirmarse en la consola.
La tarea para el lunes es sustituir los supuestos por la evidencia de una semana representativa.
Delimite la carga de trabajo
Elija un modelo, una clase de GPU, un nivel de nube y una región. No compare una H100 Community con una H100 Secure ni mezcle el rendimiento de H100 y A100.
Registre cada fase facturable
Capture las marcas de tiempo de inicio del worker, modelo listo, inicio de solicitud, fin de solicitud y detención del worker. Registre la cantidad de workers y los intentos fallidos junto con las solicitudes correctas.
Separe los estados del almacenamiento
Enumere en GB el almacenamiento de contenedor, volumen y red. Calcule por separado los periodos activos y detenidos en lugar de etiquetar todos los datos conservados como “almacenamiento”.
Aplique el punto de cruce
Sume los segundos de worker de arranque, ejecución, reintentos e inactividad. Compare el total con el 60.33% de la ventana del Secure Pod y después sustituya $2.89 y $4.79 por las tarifas de la consola y de las cotizaciones que realmente pueda contratar.
Preguntas frecuentes sobre Runpod pricing
¿Qué es más barato que Runpod?
Vast.ai u otro marketplace puede publicar una oferta en vivo más baja, y el cargo actual de GPU H100 de Modal es inferior al de Runpod H100 Serverless cuando todo su tiempo es facturable. Runpod Community Cloud también puede costar menos que Secure Cloud. La factura más barata sigue dependiendo del tiempo inactivo del worker, el almacenamiento, la fiabilidad y lo que incluya el servicio.
¿Vale la pena Runpod?
Runpod vale la pena cuando se necesita un contenedor, un modelo y una GPU propios con facturación por segundo. Conviene descartarlo si una API de modelo gestionada cuesta menos que operar imágenes, escalado, monitoreo y reintentos, o si los compromisos existentes con otro proveedor de nube pesan más que el precio publicado de la GPU.
¿Runpod es mejor que AWS?
Runpod es más sencillo y barato en este ejemplo normalizado con una sola H100: $2.89 por hora de Secure Pod frente a $5.191 por hora de acelerador H100 para una AWS p5.4xlarge Capacity Block en US East. AWS puede seguir siendo la mejor opción de sistema si la carga depende de sus redes, servicios de datos, gobernanza o gasto comprometido.
¿Runpod es gratis?
La página de precios en vivo no muestra un nivel general de cómputo gratuito. Se añaden fondos y se paga por los recursos medidos. Las startups elegibles y algunos programas de socios pueden recibir créditos, pero son programas sujetos a condiciones, no un plan gratuito permanente.
¿Cuánto cuesta Runpod?
El catálogo actual de Pods utilizado aquí va desde $0.27/hora para RTX A5000 hasta $7.89/hora para B300. Serverless va desde $0.58/hora para la categoría de 16GB hasta $9.98/hora para B300. El almacenamiento y el patrón de tiempo de los workers se añaden a esas cifras.
¿Cuál es la opción más barata para alquilar una GPU?
En la tabla actual publicada por Runpod para Pods, RTX A5000 tiene la tarifa más baja: $0.27/hora. Un marketplace puede mostrar una oferta temporal inferior, pero la disponibilidad, la fiabilidad del host, el ancho de banda y el almacenamiento pueden anular el ahorro aparente.
¿Es rentable alquilar una GPU?
Puede serlo, pero la tarifa de alquiler no basta para responder. El beneficio bruto por resultado correcto debe superar el cómputo, el almacenamiento, los intentos fallidos, la capacidad inactiva, el monitoreo y la ingeniería. La hoja de cálculo por solicitudes correctas debe completarse con los ingresos y registros observados.
¿Cuál es la GPU más barata disponible ahora mismo?
El catálogo en vivo de Runpod muestra RTX A5000 a $0.27/hora, pero la GPU implementable más barata depende del inventario actual en el nivel y la región elegidos. La oferta debe confirmarse en la consola justo antes del lanzamiento.
¿Cuánto cuesta alquilar una GPU NVIDIA?
En el catálogo actual de Pods de Runpod, el rango utilizado aquí va de $0.27 a $7.89 por hora de GPU. Una H100 PCIe de Secure Cloud cuesta $2.89/hora, mientras que H100 Serverless cuesta $4.79 por hora facturable de worker.
¿Cómo funcionan los créditos gratuitos de Runpod?
El Runpod Startup Program indica que los miembros Starter aceptados reciben $1,000 en créditos de una sola vez. Los miembros Growth comprometen $50,000 por adelantado y reciben una bonificación de $25,000, para un total de $75,000 bajo un acuerdo de 12 meses sin recarga de créditos.
¿Runpod ofrece descuento para estudiantes?
No se encontró un descuento público específico para estudiantes en las páginas de precios en vivo, documentación o Startup Program revisadas el 25 de septiembre de 2026. Los estudiantes deben presupuestar las tarifas de autoservicio o solicitar acceso a un programa de créditos elegible, en lugar de asumir que existe un precio educativo.
¿Cuál es la política de reembolsos de Runpod?
Los términos de Runpod indican que las tarifas de servicio no suelen ser reembolsables y que las suscripciones canceladas no reciben un reembolso prorrateado por el periodo vigente. Los Pod Savings Plans también se declaran expresamente no reembolsables.
¿Han cambiado los precios de Runpod?
El precio actual de H100 Serverless es de $4.79/hora. El material publicado anteriormente todavía muestra $4.18, y la tabla de tarifas de Runpod del 10 de agosto muestra $4.55, pero en esta verificación no se encontró un registro oficial de cambios que indique una fecha exacta de entrada en vigor. Debe utilizarse la tarifa en vivo con fecha.
- Última actualización
- 25 sept 2026
- Categoría
- Build
Prefiera este sitio en Google


Marque omidsaffari.com como fuente preferida y Google lo destacará para usted en Top Stories, AI Overviews y AI Mode.

Vercel Sandbox Drives: cómo crear espacios de trabajo persistentes
Aprende a montar Vercel Sandbox Drives, conservar archivos entre sandboxes y medir almacenamiento, lecturas, escrituras y costos de cómputo.25 sept 2026Build
Web scraping: 7 alternativas a Firecrawl comparadas
Comparamos 7 alternativas a Firecrawl para web scraping por costos, rastreo, Markdown, JSON, alojamiento propio y carga operativa en equipos pequeños.25 sept 2026Build
Alternativas a CodeRabbit: 7 opciones según precio y control
Comparamos 7 alternativas a CodeRabbit por precio, privacidad, compatibilidad con Git y control operativo para elegir la opción que mejor encaja con su equipo.25 sept 2026Build
CodeRabbit vs Greptile: precios, límites y cuál elegir
Comparamos CodeRabbit vs Greptile en precio, límites, profundidad de revisión y compatibilidad para saber qué revisor de código con IA encaja mejor.25 sept 2026Build
Perplexity Computer en local: guía para Windows con AMD
Guía para usar Perplexity Computer en local con Windows y Ryzen AI Max: requisitos, permisos, prueba de archivos y control del acceso a la nube.25 sept 2026Build
AgentRun a prueba: flujos de trabajo con IA bajo control
Probamos AgentRun beta.4 para flujos de trabajo con IA: contratos tipados, ramas visibles, llamadas limitadas y escalamiento explícito frente a otras opciones.24 sept 2026Build
Perplexity Search API: Fast Search o web por defecto
Comparamos Fast Search y el modo web de Perplexity Search API en precio, latencia y cobertura, con una regla práctica para enrutar cada consulta.24 sept 2026Build