Cloud GPU Runpod : le vrai coût des Pods face au Serverless
Comparez les tarifs du cloud GPU Runpod pour les Pods et le Serverless, le coût du stockage et le seuil de 60.33% qui détermine l’option la moins chère.


Le cloud GPU Runpod pour un H100 de production démarre à $2.89 par heure avec un Secure Cloud Pod, contre $4.79 par heure de worker facturable en Serverless, hors stockage. Le Serverless n’est plus avantageux dès que le démarrage, l’exécution, les nouvelles tentatives et l’inactivité dépassent 60.33% de la durée de fonctionnement du Pod ; au-delà, mieux vaut garder le GPU.
Cloud GPU Runpod : les tarifs en un coup d’œil
Runpod est une infrastructure facturée à l’usage, et non un SaaS à abonnement mensuel. En pratique, il faut choisir entre un Pod dédié payé tant qu’il fonctionne, des workers Serverless payés uniquement tant qu’ils restent actifs, ou une capacité sur devis pour une charge durable.
Les prix ci-dessous ont été vérifiés sur la page tarifaire en ligne de Runpod le 25 septembre 2026. Cette page est datée du 13 septembre 2026. La disponibilité et le tarif final dépendent toujours du GPU, du niveau de cloud et de la région choisis dans la console.
Runpod ne propose pas le classique choix mensuel ou annuel. Les Pods sont à la demande, un Pod Savings Plan préfinance 3 ou 6 mois, et les Reserved Clusters affichent des durées allant jusqu’à 12 mois et au-delà, mais uniquement sur devis. Il n’existe pas non plus de ligne de dépassement classique : le calcul et le stockage continuent d’être mesurés jusqu’à l’arrêt de la charge, l’épuisement du solde ou le déclenchement de la limite de dépenses par défaut de $80/heure pour l’ensemble du compte. Runpod indique que le support peut relever cette limite.
Prix des GPU Runpod pour les Pods
Les tarifs des Pods avantagent les instances dédiées dès qu’un modèle doit rester longtemps et de façon prévisible en mémoire GPU. Vous contrôlez le conteneur et conservez un GPU dédié tant que le Pod fonctionne ; en contrepartie, les minutes creuses sont elles aussi facturées.
Le catalogue actuel des Pods affiche les tarifs horaires suivants, tous facturés à la seconde :
- 80GB et plus : B300 $7.89, B200 $6.79, H200 $4.59, RTX Pro 6000 $2.09, H100 NVL $3.19, H100 PCIe $2.89, H100 SXM $3.49, A100 PCIe $1.59 et A100 SXM $1.59.
- 48GB : Pro 6000 MIG $1.09, L40S $1.09, RTX 6000 Ada $0.84, A40 $0.49, L40 $0.82 et RTX A6000 $0.53.
- 24GB à 32GB : RTX 5090 $0.99, Pro 6000 MIG 24GB $0.59, L4 $0.49, RTX 3090 $0.50, RTX 4090 $0.74 et RTX A5000 $0.27.
Il s’agit de prix catalogue, pas de la garantie qu’une carte sera disponible partout. Avant d’arrêter un budget, sélectionnez le GPU, le niveau de cloud et la région dans la console.
Community Cloud ou Secure Cloud
Secure Cloud est le choix par défaut pour la production. Runpod le présente comme du matériel single-tenant hébergé dans des data centers T3/T4 et le destine à la production ou aux données réglementées. Community Cloud s’appuie sur des capacités tierces validées ; mieux vaut le réserver aux expérimentations et aux tâches capables de reprendre après une interruption.
Pour le H100 PCIe, le comparatif H100 en ligne indique $1.99/heure sur Community Cloud et $2.89/heure sur Secure Cloud. Cet écart de $0.90 représente $90 d’économie sur 100 heures-GPU, mais ce n’est pas une remise sans contrepartie. Pour économiser $0.90 par heure, un agent destiné aux clients et soumis à un engagement de livraison ne devrait pas renoncer au niveau de production.
Une incohérence subsiste sur les pages du fournisseur. Le titre et le bloc comparatif de la page H100 actuelle concordent avec la page tarifaire principale à $2.89/heure pour Secure Cloud, tandis qu’une FAQ située plus bas sur cette même page mentionne encore $2.39/heure. Retenez $2.89 tant que la console n’affiche pas autre chose.
Les Savings Plans constituent l’option d’engagement pour un Pod. Ils exigent le paiement anticipé de 3 ou 6 mois, couvrent uniquement le calcul GPU, excluent le stockage, ont une date d’expiration fixe et ne sont pas remboursables. Si un Pod est arrêté, le plan peut être transféré au déploiement suivant utilisant le même type de GPU. C’est utile pour une flotte stable, beaucoup moins pour une équipe qui change encore de cartes ou de profil de trafic.
Tarifs Runpod Serverless : payer le temps du worker, pas les requêtes
Le Serverless ne coûte moins cher qu’un Pod actif en permanence que si les workers restent assez longtemps à zéro. La facture suit leur durée de vie, pas le nombre d’appels API réussis : les démarrages à froid, le chargement du modèle, les tentatives échouées et le délai d’inactivité doivent donc entrer dans le budget.
Runpod propose deux types de workers :
- Les workers Flex reviennent à zéro et appliquent le tarif public à la seconde.
- Les workers Active fonctionnent en continu, 24/7, pour assurer un trafic régulier et une faible latence. La documentation de facturation Runpod indique que des remises sont accessibles sur demande commerciale, sans garantir de pourcentage fixe.
Ne budgétez pas le H100 Flex à $4.18/heure et ne supposez pas que chaque worker Active bénéficie de 30% de remise. Le tarif actuel du H100 Flex est de $4.79/heure, tandis que celui d’Active dépend du devis. Un ancien pourcentage fixe peut donner l’illusion qu’une architecture est moins chère avant même la première requête.
Grille tarifaire des GPU Runpod Serverless
Le catalogue Flex actuel comprend 13 catégories tarifaires :
- Grande mémoire : B300 $9.98/heure, B200 $8.64, H200 $5.93, RTX 6000 Pro $3.49, H100 $4.79 et A100 $2.72.
- 48GB et 32GB : L40/L40S/6000 Ada/MIG 48GB $1.75, A6000/A40 $1.22, RTX 5090 $1.58 et RTX PRO 4500 Blackwell $1.15.
- 24GB et 16GB : RTX 4090 $1.10, L4/A5000/3090/MIG 24GB $0.69 et A4000/A4500/RTX 4000/RTX 2000 $0.58.
La catégorie dépend du GPU du worker, et non du nom du modèle ou de la requête. Un worker 24GB qui traite une requête minuscule reste facturé $0.69/heure tant qu’il est actif. Un H100 qui traite une requête échouée consomme tout de même les secondes pendant lesquelles il a fonctionné.
Le compteur facturable se décompose en trois phases :
- Démarrage : initialiser le conteneur et charger le modèle en mémoire GPU.
- Exécution : traiter la requête, y compris lorsque le traitement finit par échouer.
- Délai d’inactivité : maintenir le worker actif après le traitement au cas où une autre requête arriverait. La valeur documentée par défaut est de 5 secondes.
Le nombre de workers multiplie le coût des trois phases. Chaque worker qui charge le modèle ajoute son propre temps de démarrage avant le début de l’exécution. L’autoscaling peut réduire la capacité inactive, mais une montée en charge trop agressive peut aussi répéter ce coût de démarrage sur plusieurs workers.
Calcul du coût Runpod : 100 heures, 730 heures et requêtes réussies
Ce modèle de coût Runpod est reproductible ; il ne prétend pas mesurer le débit réel. Avant de valider les dépenses de production, remplacez chaque hypothèse par vos logs de facturation et de requêtes enregistrés.
Le scénario de référence daté repose sur les hypothèses suivantes :
- GPU : un NVIDIA H100.
- Pod : Secure Cloud H100 PCIe à $2.89/heure.
- Serverless : un worker H100 Flex à $4.79/heure.
- Région : hypothèse US ; le tarif du catalogue mondial est utilisé, mais il faut vérifier le stock et le prix de la région choisie dans la console.
- Stockage : un volume réseau standard de 100GB conservé pendant un mois à $7.
- Modèle de requêtes : 20 secondes de démarrage par fenêtre de trafic, 2 secondes d’exécution par tentative, le délai d’inactivité documenté de 5 secondes, 2% de tentatives échouées et 100 requêtes réussies par fenêtre.
- Référence du Pod pour les requêtes : un Pod de production maintenu actif pendant les 730 heures du mois afin de pouvoir répondre à tout moment.
Les lignes consacrées aux requêtes montrent l’effet de la forme du trafic. Elles n’affirment pas que votre modèle a besoin de 2 secondes sur un H100. Elles indiquent que si chaque tentative dure 2 secondes et que les requêtes arrivent par groupes de 100, mille requêtes réussies coûtent ce montant.
Pour 1,000 réussites, une division par le taux de réussite de 98%, arrondie à l’entier supérieur, donne 1,021 tentatives. Sur 10 fenêtres, le worker passe 200 secondes à démarrer, 2,042 secondes à exécuter les tâches et 50 secondes en attente. Total : 2,292 secondes facturables, soit $3.05 de calcul H100.
Pour 10,000 réussites, la même méthode produit 10,205 tentatives, 2,000 secondes de démarrage, 20,410 secondes d’exécution et 500 secondes d’inactivité. Total : 22,910 secondes facturables, soit $30.48 de calcul.
Le stockage reste séparé. L’ajout du volume réseau standard de 100GB porte le total mensuel à $10.05 et $37.48, mais ce volume peut également servir à d’autres flux. Ne le dissimulez pas dans un coût par requête inventé.
Sensibilité : la cadence du trafic change le résultat
Une image de base plus rapide et un trafic plus régulier peuvent réduire le coût du calcul. Avec 5 secondes de démarrage, 1 seconde d’exécution, aucun échec, 5 secondes d’inactivité et 100 réussites par fenêtre, le calcul modélisé revient à $1.46 pour 1,000 réussites et $14.64 pour 10,000.
Le scénario opposé coûte cher. Si chaque tentative arrive après un retour à zéro et déclenche son propre démarrage de 20 secondes, suivi de 2 secondes d’exécution et de 5 secondes d’inactivité, le coût de calcul modélisé grimpe à $36.68 pour 1,000 réussites et $366.61 pour 10,000.
Cet écart explique pourquoi le nombre de requêtes est une mauvaise unité de facturation brute. Il ne devient utile qu’une fois associé aux secondes-worker observées, au taux d’échec et à la concurrence.
Entre Pods et Serverless, le seuil de rentabilité dépend des secondes facturables
Pour le H100 du scénario de référence, le seuil de rentabilité hors stockage est exact : il suffit de diviser le tarif Secure Pod de $2.89 par celui du Serverless, à $4.79. Le résultat est 60.33%.
Quelle que soit la fenêtre d’observation :
Serverless wins when billable worker seconds < window seconds × 2.89 / 4.79.
Sur une fenêtre de service de 100 heures, le Serverless doit rester sous 60.33 heures-worker facturables pour battre le Pod à $289. Sur un mois de 730 heures, il doit rester sous 440.44 heures-worker facturables pour battre $2,109.70. Un stockage identique s’annule dans la comparaison ; des choix de stockage différents, non.
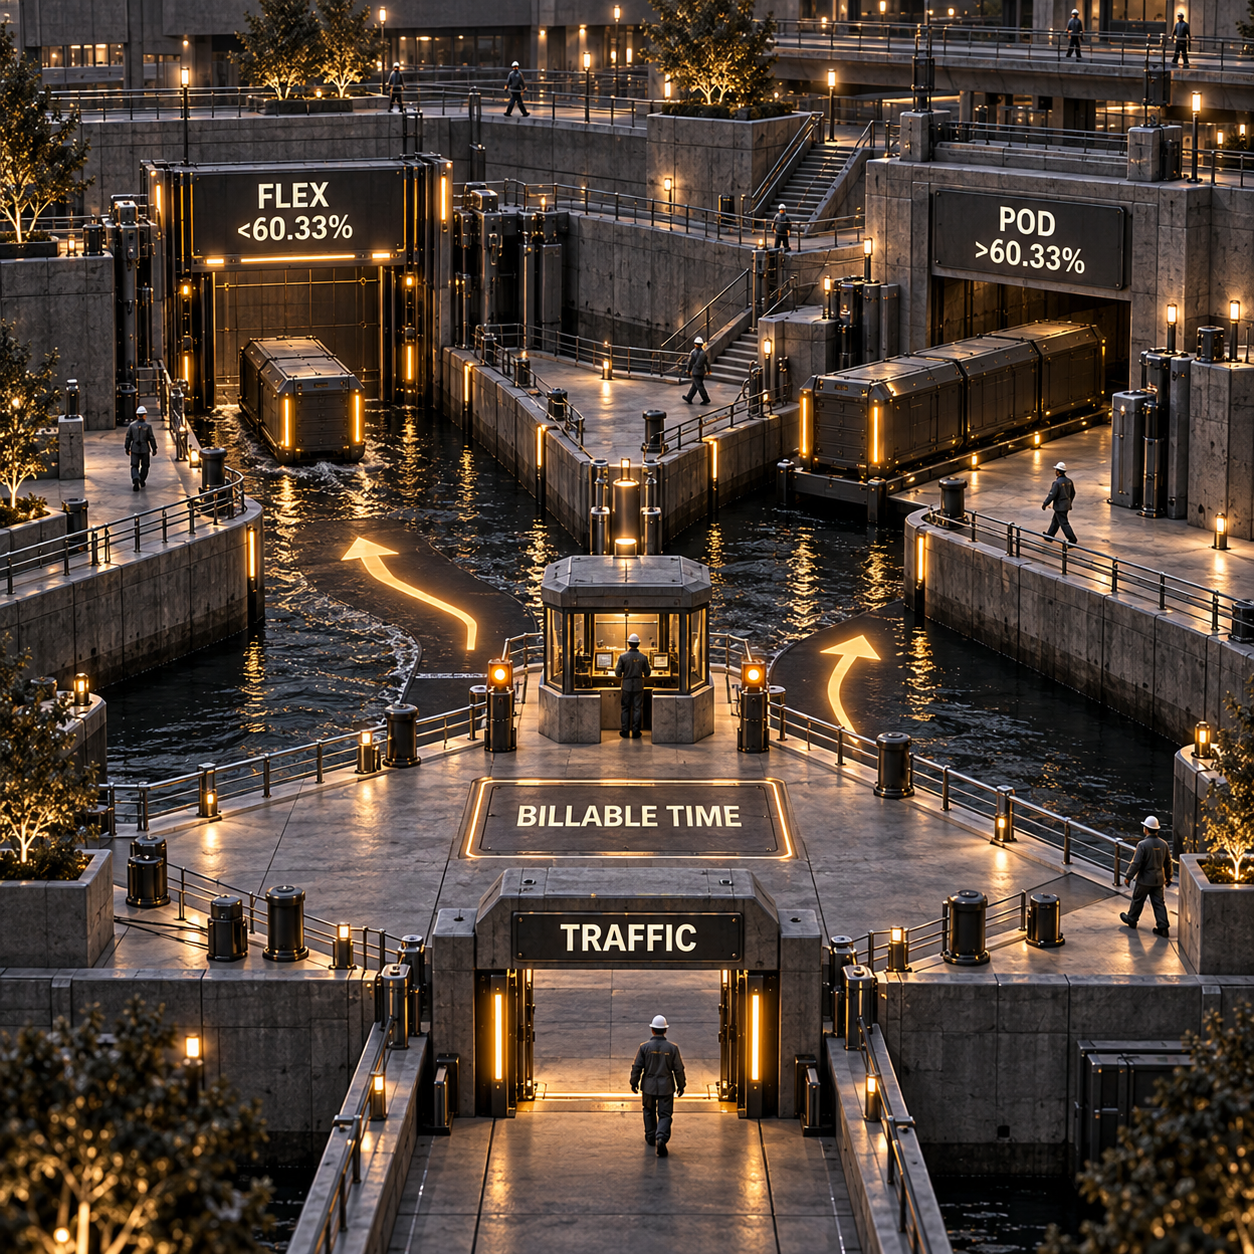
Community Cloud modifie le calcul, pas le risque. À $1.99/heure pour un H100 PCIe, son seuil hors stockage face au Serverless à $4.79 est de 41.54%, soit 303.28 heures facturables sur un mois de 730 heures. Ce seuil plus bas est pertinent pour les tâches relançables. Il ne justifie pas de déplacer un trafic client sensible vers des capacités tierces.
Un devis pour un worker Active peut encore déplacer le seuil. Tant que Runpod ne vous a pas communiqué le tarif par écrit, aucun chiffre honnête ne peut être inséré. Une hypothèse fixe de 30% n’est pas un devis.
Prix du stockage Runpod : un Pod arrêté n’est pas gratuit
La documentation de Runpod sur le stockage des Pods décrit trois comportements standard. Les confondre peut alourdir la facture de stockage après l’arrêt d’un Pod.
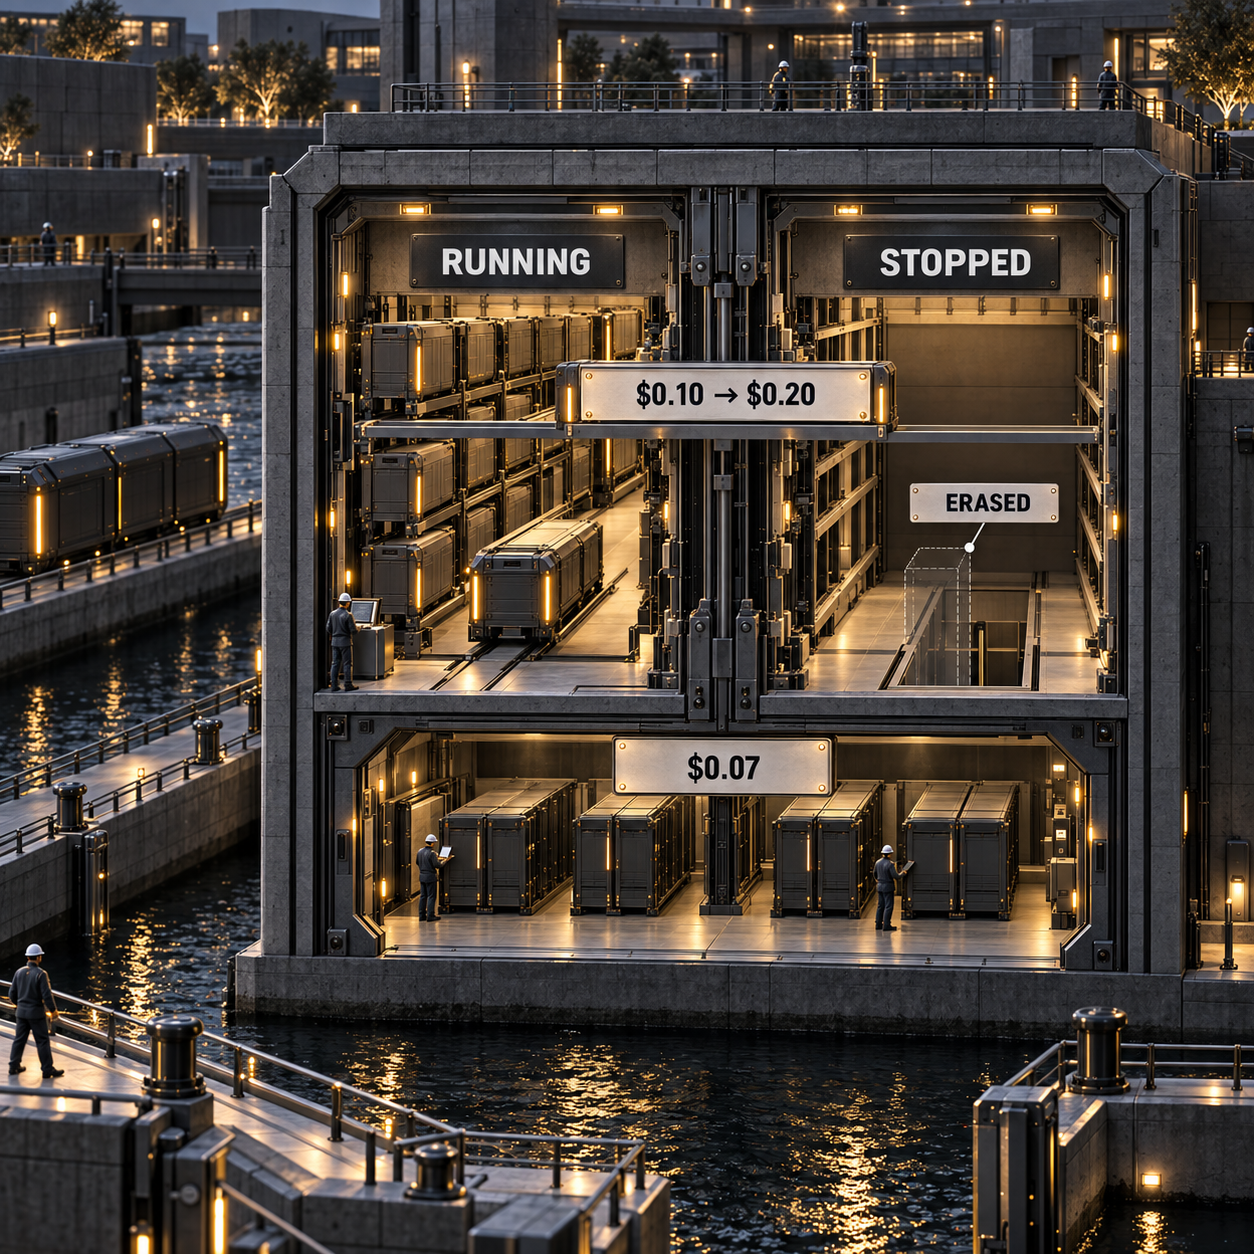
- Disque du conteneur : $0.10/GB/mois pendant l’exécution. Il n’est pas facturé à l’arrêt, car les données sont effacées.
- Disque du volume : $0.10/GB/mois pendant l’exécution et $0.20/GB/mois à l’arrêt. Un volume conservé de 100GB passe donc de $10 à $20 par mois une fois le Pod arrêté.
- Volume réseau standard : $0.07/GB/mois sous 1TB et $0.05/GB/mois au-dessus de 1TB, que le calcul fonctionne ou soit arrêté.
- Stockage réseau haute performance : la page tarifaire principale affiche $0.14/GB/mois, tandis que la documentation de stockage précise que le tarif exact varie selon le data center. La console fait foi.
Le coût du stockage Runpod influe aussi sur le placement. Les volumes réseau ne sont accessibles aux Pods que dans Secure Cloud. Ils doivent être choisis au déploiement et ne peuvent ensuite être attachés ou détachés sans supprimer le Pod. En Serverless, un volume est lié à un data center, ce qui peut réduire la disponibilité des GPU. Plusieurs volumes permettent de répartir le placement, mais Runpod précise qu’ils ne se synchronisent pas automatiquement.
Pour des poids de modèle partagés par des workers élastiques, un volume réseau peut éviter des téléchargements répétés. Pour une expérimentation jetable, le disque du conteneur peut coûter moins cher. Pour un Pod arrêté qui doit conserver son espace de travail local, le disque du volume est la mauvaise surprise.
Alternatives à Runpod : comparer une heure H100 facturée
Avant de s’intéresser aux fonctionnalités des plateformes, il faut comparer les alternatives sur un même temps d’accélérateur facturé. Pour 100 heures-GPU H100 facturées, les tarifs actuels des fournisseurs donnent les coûts de calcul suivants :
- Runpod Secure Cloud Pod : $289 pour H100 PCIe.
- Lambda : $329 pour une instance H100 PCIe à un GPU. La page des instances Lambda inclut un SSD de 1TiB dans cette configuration et précise que les taxes sur les ventes, la TVA ou la GST applicables s’ajoutent.
- Modal : $394.92 de frais GPU H100 SXM5 à raison de $0.001097 par seconde, avant les frais distincts de CPU et de mémoire. Modal Starter inclut $30 de crédit gratuit par mois.
- Runpod Serverless : $479 si les 100 heures-worker sont toutes facturables.
- AWS : $519.10 pour un Capacity Block H100 p5.4xlarge en US East, sur la base de $5.191 par heure d’accélérateur. AWS facture les frais de réservation à l’avance : il ne s’agit donc pas d’un équivalent Serverless à la demande.
Cette normalisation est volontairement étroite. Modal utilise H100 SXM5, les lignes Runpod et Lambda H100 PCIe, et AWS vend un Capacity Block planifié ; les CPU, la mémoire, le stockage, l’orchestration et la disponibilité inclus diffèrent. Cette liste répond à la question du prix de l’accélérateur sans prétendre que ces services sont interchangeables.
Runpod face à Vast.ai
Une comparaison fixe avec Vast.ai ne peut pas se résumer à un unique prix H100 durable. Vast.ai explique que les prix de sa marketplace varient avec l’offre et la demande, que son tableau en direct est actualisé chaque heure, que le prix « à partir de » correspond à l’offre disponible la moins chère et qu’une médiane distincte est également publiée. Runpod affiche un tarif catalogue et sépare ses capacités entre Community et Secure.
Choisissez Vast.ai si vous pouvez interroger les offres en direct, filtrer leur fiabilité et déplacer les tâches lorsque l’offre évolue. Préférez Runpod si un tarif public stable, un niveau Secure et la possibilité de passer d’un Pod au Serverless comptent davantage que la recherche ponctuelle du prix le plus bas.
Si la véritable alternative est une API d’inférence managée, comparez aussi la charge opérationnelle, pas seulement le temps GPU. L’analyse des tarifs de Together AI offre un contrepoint utile à la facture d’un GPU auto-hébergé.
Quelle formule choisir selon le besoin
Choisissez les Secure Cloud Pods pour un agent IA destiné aux clients ou un service de traitement documentaire qui exploite réellement un GPU pendant la majeure partie de la journée. Le prix du Pod est plus bas, le placement du stockage plus clair, et un modèle déjà chaud évite les démarrages répétés. La limite reste la capacité inactive : chaque minute creuse est payante.
Choisissez Serverless Flex pour une fonctionnalité avec de longues périodes creuses, des campagnes ponctuelles, des lots planifiés ou un trafic de lancement incertain. Il peut revenir à zéro, mais le démarrage, les nouvelles tentatives et l’inactivité doivent rester sous le seuil. Le point faible est la répétition du cycle de vie des workers, en particulier lorsqu’un grand modèle se charge lentement ou que l’autoscaling se déploie trop agressivement.
Ne choisissez les workers Active qu’après avoir vérifié que les exigences de latence et le trafic mesuré justifient une discussion commerciale. Ils restent actifs 24/7. Sans devis écrit, aucune remise fiable ne peut être modélisée.
Réservez les Community Cloud Pods aux expérimentations, aux évaluations et aux traitements par lots relançables. Écartez-les pour les données réglementées ou pour un endpoint de production dont la disponibilité fait partie de la promesse produit.
Choisissez les Instant ou Reserved Clusters pour de véritables charges multi-GPU, et non comme une montée en gamme par défaut de l’inférence. Instant Clusters publie les prix des A100 et H200 et monte jusqu’à 64 GPU ; plusieurs autres types de GPU et toutes les durées de Reserved Cluster passent par le service commercial.
Avant de choisir le matériel, tranchez le choix du modèle et du mode de propriété. Le guide des modèles privés pour agents aide à dimensionner le modèle, tandis que le comparatif entre agents de code managés et auto-hébergés cadre les compromis opérationnels.
- Facturation à la seconde pour les Pods et le Serverless, sans frais d’entrée ni de sortie de données.
- Un parcours allant des Pods économiques à l’inférence pouvant revenir à zéro et aux clusters multi-GPU.
- Des tarifs catalogue publics pour les GPU grand public, de data center et Blackwell.
- Les capacités Secure et Community permettent d’appliquer des budgets de risque différents aux tâches relançables et à la production.
- La même page officielle du H100 contient un ancien prix Secure Cloud dans sa FAQ.
- Les remises des workers Active sont uniquement sur devis, ce qui empêche de modéliser publiquement un tarif de production central.
- Le disque du volume coûte deux fois plus cher lorsqu’un Pod est arrêté.
- Le placement des volumes réseau peut réduire la disponibilité des GPU Serverless, et ces volumes ne se synchronisent pas automatiquement.
- La disponibilité et le prix régional final doivent toujours être vérifiés dans la console.
Dès lundi, remplacez les hypothèses par les données d’une semaine représentative.
Délimiter précisément la charge
Choisissez un modèle, une catégorie de GPU, un niveau de cloud et une région. Ne comparez pas un H100 Community à un H100 Secure, et ne mélangez pas le débit d’un H100 avec celui d’un A100.
Journaliser chaque phase facturable
Enregistrez l’heure de démarrage du worker, celle où le modèle est prêt, le début et la fin de chaque requête, puis l’arrêt du worker. Notez le nombre de workers et les tentatives échouées à côté des requêtes réussies.
Séparer les états du stockage
Répertoriez en GB le stockage du conteneur, du volume et du réseau. Chiffrez séparément les périodes actives et arrêtées, au lieu de regrouper toutes les données conservées sous l’étiquette « stockage ».
Appliquer le seuil de rentabilité
Additionnez les secondes-worker de démarrage, d’exécution, de nouvelle tentative et d’inactivité. Comparez le total à 60.33% de la fenêtre du Secure Pod, puis remplacez $2.89 et $4.79 par les tarifs de la console et des devis auxquels vous avez réellement accès.
FAQ sur les tarifs Runpod
Quelles solutions coûtent moins cher que Runpod ?
Vast.ai ou une autre marketplace peut afficher une offre en direct moins chère, et le coût GPU H100 actuel de Modal est inférieur à celui d’un H100 Runpod Serverless entièrement facturé. Runpod Community Cloud peut aussi passer sous Secure Cloud. Mais la facture la plus basse dépend toujours du temps d’inactivité des workers, du stockage, de la fiabilité et des services inclus.
Runpod vaut-il son prix ?
Runpod vaut son prix si vous avez besoin de votre propre conteneur, de votre propre modèle et d’un GPU avec une facturation à la seconde. Passez votre chemin si une API de modèle managée coûte moins cher que l’exploitation des images, du scaling, du monitoring et des nouvelles tentatives, ou si vos engagements cloud existants comptent davantage que le prix affiché du GPU.
Runpod est-il meilleur qu’AWS ?
Dans ce comparatif normalisé sur un seul H100, Runpod est plus simple et moins cher : $2.89 par heure de Secure Pod, contre $5.191 par heure d’accélérateur H100 pour un Capacity Block AWS p5.4xlarge en US East. AWS peut néanmoins rester le meilleur choix système si la charge dépend de son réseau, de ses services de données, de sa gouvernance ou de dépenses déjà engagées.
Runpod est-il gratuit ?
La page tarifaire en ligne ne présente aucune offre générale de calcul gratuit. Vous créditez le compte, puis payez les ressources mesurées. Les startups éligibles et certains programmes partenaires peuvent recevoir des crédits, mais il s’agit d’offres conditionnelles, pas d’un forfait gratuit permanent.
Combien coûte Runpod ?
Le catalogue actuel des Pods utilisé ici va de $0.27/heure pour RTX A5000 à $7.89/heure pour B300. Le Serverless s’étend de $0.58/heure pour la catégorie 16GB à $9.98/heure pour B300. Le stockage et le profil de temps des workers s’y ajoutent.
Quelle est l’option de location GPU la moins chère ?
Dans le tableau public actuel des Pods Runpod, RTX A5000 affiche le prix le plus bas à $0.27/heure. Une marketplace peut proposer temporairement moins cher, mais la disponibilité, la fiabilité de l’hôte, la bande passante et le stockage peuvent annuler l’économie apparente.
La location d’un GPU peut-elle être rentable ?
Oui, mais le prix de location ne suffit pas pour le savoir. La marge brute par résultat réussi doit dépasser le calcul, le stockage, les tentatives échouées, la capacité inactive, le monitoring et l’ingénierie. Appliquez le calcul par requête réussie à vos revenus et à vos logs observés.
Quel est le GPU le moins cher disponible actuellement ?
Le catalogue en ligne de Runpod affiche RTX A5000 à $0.27/heure, mais le GPU déployable le moins cher dépend du stock disponible dans le niveau et la région choisis. Confirmez l’offre dans la console juste avant le lancement.
Combien coûte la location d’un GPU NVIDIA ?
Dans le catalogue actuel des Pods Runpod utilisé ici, la fourchette va de $0.27 à $7.89 par heure-GPU. Un H100 PCIe Secure Cloud coûte $2.89/heure, tandis qu’un H100 Serverless revient à $4.79 par heure de worker facturable.
Comment fonctionnent les crédits gratuits Runpod ?
Le Runpod Startup Program indique que les membres Starter acceptés reçoivent $1,000 de crédits en une seule fois. Les membres Growth s’engagent à verser $50,000 à l’avance et reçoivent un bonus de $25,000, soit $75,000 au total dans le cadre d’un accord de 12 mois sans recharge des crédits.
Runpod propose-t-il une remise étudiante ?
Aucune remise publique destinée spécifiquement aux étudiants ne figurait sur les pages de tarification, de documentation ou du Startup Program consultées le 25 septembre 2026. Les étudiants devraient budgéter les tarifs en libre-service ou candidater à un programme de crédits éligible, plutôt que de supposer l’existence d’un tarif éducation.
Quelle est la politique de remboursement de Runpod ?
Les conditions de Runpod indiquent que les frais de service ne sont généralement pas remboursables et que l’annulation d’un abonnement n’entraîne aucun remboursement au prorata de la période en cours. Les Pod Savings Plans sont eux aussi explicitement non remboursables.
Les tarifs Runpod ont-ils changé ?
Le prix actuel du H100 Serverless est de $4.79/heure. D’anciens contenus publiés indiquent encore $4.18, et le tableau de prix Runpod du 10 août affiche $4.55, mais aucun journal des modifications officiel trouvé lors de cette vérification ne donne de date d’entrée en vigueur précise. Utilisez le tarif en ligne daté.
Recevez la checklist d’audit des workflows IA et la newsletter pour les opérateurs.
- Dernière mise à jour
- 25 sept. 2026
- Catégorie
- Build
Préférez ce site dans Google


Marquez omidsaffari.com comme source préférée et Google le met en avant pour vous dans Top Stories, AI Overviews et AI Mode.

Vercel Sandbox Drive : un stockage persistant pour les agents de code
Découvrez comment monter un Vercel Sandbox Drive, conserver fichiers et caches entre deux sandboxes, gérer les accès concurrents et maîtriser les coûts.25 sept. 2026Build
Web scraping IA : 7 alternatives à Firecrawl comparées
Comparez 7 alternatives à Firecrawl pour vos pipelines IA : crawl, sorties Markdown et JSON, effort de migration et coût par page réellement exploitable.25 sept. 2026Build
7 alternatives à CodeRabbit pour la revue de code IA
Comparez 7 alternatives à CodeRabbit : prix, hébergement, confidentialité et coûts pour 300 revues, afin de choisir selon vos contraintes réelles.25 sept. 2026Build
CodeRabbit ou Greptile : quel outil de revue de code IA choisir ?
CodeRabbit ou Greptile ? Comparez tarifs, limites de revue, intégrations Git et coûts réels pour choisir l’outil adapté à votre équipe de développement.25 sept. 2026Build
Perplexity Windows : configurer Portable Computer en local
Configurez Perplexity Portable Computer sur un PC Windows AMD compatible, testez l’inférence locale et maîtrisez permissions, coûts et passages cloud.25 sept. 2026Build
AgentRun : test d’un framework agent IA TypeScript
AgentRun encadre les workflows d’agents IA en TypeScript. Test des branches, schémas, escalades, coûts et limites face à LangGraph.js et Temporal.24 sept. 2026Build
Perplexity Search API : Fast Search ou mode web par défaut ?
Fast Search coûte cinq fois moins cher, mais le mode web couvre mieux les requêtes complexes. Voici comment router chaque recherche dans Perplexity Search API.24 sept. 2026Build