Runpod pricing 2026: quanto costano Pod e Serverless
Runpod pricing spiegato con costi di Pod, Serverless e storage, un calcolo H100 con data certa e la soglia di pareggio basata sul tempo fatturabile.


Con Runpod pricing, una H100 in produzione parte da $2.89 l'ora su un Secure Cloud Pod o da $4.79 per ora fatturabile del worker su Serverless, storage escluso. Serverless conviene soltanto finché avvio, esecuzione, tentativi ripetuti e inattività restano sotto il 60.33% del tempo di attività del Pod; oltre questa soglia, è meglio tenere la GPU.
Runpod pricing in sintesi
Runpod è un'infrastruttura a consumo, non un servizio SaaS con canone mensile. La scelta concreta è tra pagare un Pod dedicato per tutto il tempo in cui rimane in esecuzione, pagare i worker Serverless soltanto quando sono attivi oppure acquistare capacità su preventivo per un carico continuativo.
I prezzi riportati di seguito sono stati verificati sulla pagina ufficiale dei prezzi Runpod il 25 settembre 2026. La pagina è datata 13 settembre 2026. Disponibilità e tariffa finale per la combinazione scelta di GPU, livello cloud e regione dipendono comunque dalla console.
Runpod non offre il classico selettore tra piano mensile e annuale. I Pod sono on demand, un Pod Savings Plan si paga in anticipo per 3 o 6 mesi, mentre i Reserved Clusters prevedono durate pubblicate fino a 12 mesi e oltre, ma richiedono un preventivo. Non esiste neppure una voce di sovrapprezzo tradizionale: compute e storage continuano a essere conteggiati finché il carico non viene arrestato, il saldo non arriva a zero oppure interviene il limite di spesa predefinito di $80/hour per l'intero account. Runpod dichiara che il supporto può aumentare questo limite.
Prezzi Runpod delle GPU per i Pod
Le tariffe dei Pod favoriscono le istanze dedicate quando un modello richiede una permanenza sulla GPU lunga e prevedibile. Il container resta sotto il proprio controllo e la GPU è dedicata finché il Pod è in esecuzione; in cambio, anche i minuti senza attività vengono conteggiati.
Il catalogo Pod attuale pubblica queste tariffe orarie, tutte fatturate al secondo:
- 80GB e oltre: B300 $7.89, B200 $6.79, H200 $4.59, RTX Pro 6000 $2.09, H100 NVL $3.19, H100 PCIe $2.89, H100 SXM $3.49, A100 PCIe $1.59 e A100 SXM $1.59.
- 48GB: Pro 6000 MIG $1.09, L40S $1.09, RTX 6000 Ada $0.84, A40 $0.49, L40 $0.82 e RTX A6000 $0.53.
- Da 24GB a 32GB: RTX 5090 $0.99, Pro 6000 MIG 24GB $0.59, L4 $0.49, RTX 3090 $0.50, RTX 4090 $0.74 e RTX A5000 $0.27.
Sono prezzi di catalogo, non la garanzia che ogni scheda sia disponibile in ogni località. Prima di fissare il budget, seleziona GPU, livello cloud e regione nella console.
Community Cloud o Secure Cloud
Secure Cloud è la scelta predefinita per la produzione. Runpod la descrive come hardware single-tenant in data center T3/T4 e la propone per ambienti produttivi o dati regolamentati. Community Cloud attinge invece a capacità di terze parti sottoposte a verifica: è più adatta come pool economico per esperimenti e processi che possono riprendere dopo un'interruzione.
Per H100 PCIe, il riquadro di confronto H100 aggiornato indica $1.99/hour su Community Cloud e $2.89/hour su Secure Cloud. La differenza di $0.90 consente di risparmiare $90 su 100 GPU-hours, ma non è uno sconto privo di compromessi. Per risparmiare $0.90 l'ora, un agente rivolto ai clienti e soggetto a un impegno di consegna non dovrebbe rinunciare al livello pensato per la produzione.
Va segnalata un'incoerenza nelle pagine del fornitore. Il titolo e il riquadro di confronto della pagina H100 attuale concordano con la pagina principale dei prezzi e indicano $2.89/hour per Secure Cloud, ma una FAQ più in basso nella stessa pagina riporta ancora $2.39/hour. Finché la console non mostra un valore diverso, usa $2.89.
I Savings Plans sono l'opzione con impegno per un Pod. Richiedono il pagamento anticipato di 3 o 6 mesi, coprono soltanto il calcolo GPU, escludono lo storage, hanno scadenze fisse e non sono rimborsabili. Se un Pod viene arrestato, il piano può passare al deployment successivo dello stesso tipo di GPU. È una soluzione utile per una flotta stabile, ma poco adatta a un team che sta ancora cambiando schede o profilo del traffico.
Runpod Serverless pricing: si paga il tempo del worker, non le richieste
Serverless costa meno di un Pod sempre attivo solo se i worker possono restare a zero abbastanza a lungo. La fattura segue il ciclo di vita del worker, non le chiamate API riuscite: cold start, caricamento del modello, tentativi falliti e timeout di inattività devono quindi rientrare nel budget.
Runpod offre due tipi di worker:
- I worker Flex scalano fino a zero e applicano la tariffa pubblicata al secondo.
- I worker Active restano in esecuzione 24/7 per offrire traffico costante e bassa latenza. La documentazione Runpod sulla fatturazione afferma che gli sconti sono disponibili contattando il reparto commerciale, senza promettere una percentuale fissa.
Non stimare H100 Flex a $4.18/hour e non dare per scontato che ogni worker Active riceva il 30% di sconto. La tariffa H100 Flex attuale è $4.79/hour, mentre quella Active dipende dal preventivo. Una vecchia percentuale fissa può far sembrare più economica l'architettura sbagliata ancora prima che arrivi la prima richiesta.
Tariffe GPU di Runpod Serverless
Il catalogo Flex attuale comprende 13 fasce di prezzo:
- Memoria elevata: B300 $9.98/hour, B200 $8.64, H200 $5.93, RTX 6000 Pro $3.49, H100 $4.79 e A100 $2.72.
- 48GB e 32GB: L40/L40S/6000 Ada/MIG 48GB $1.75, A6000/A40 $1.22, RTX 5090 $1.58 e RTX PRO 4500 Blackwell $1.15.
- 24GB e 16GB: RTX 4090 $1.10, L4/A5000/3090/MIG 24GB $0.69 e A4000/A4500/RTX 4000/RTX 2000 $0.58.
La fascia dipende dalla GPU del worker, non dal nome del modello o dalla richiesta. Un worker da 24GB che gestisce una richiesta minima continua a costare $0.69/hour finché resta attivo. Anche una H100 che elabora una richiesta fallita consuma tutti i secondi in cui ha lavorato.
Il contatore fatturabile si divide in tre fasi:
- Avvio: inizializzazione del container e caricamento del modello nella memoria GPU.
- Esecuzione: elaborazione della richiesta, compreso il lavoro che in seguito non va a buon fine.
- Timeout di inattività: il worker resta attivo dopo la fine del lavoro in attesa di un'altra richiesta. Il valore predefinito documentato è 5 secondi.
Il numero di worker moltiplica tutte e tre le fasi. Ogni worker che carica il modello aggiunge il proprio tempo di avvio prima che inizi l'esecuzione. L'autoscaling può ridurre la capacità inattiva, ma se troppo aggressivo può anche ripetere il costo di avvio su più worker.
Calcolo dei costi Runpod: 100 ore, 730 ore e richieste riuscite
Questo modello di costo Runpod è riproducibile, ma non rappresenta una misurazione del throughput. Prima di approvare la spesa di produzione, sostituisci ogni ipotesi con i log salvati di fatturazione e richieste.
Il caso base, riferito alla data di verifica, usa:
- GPU: una NVIDIA H100.
- Pod: Secure Cloud H100 PCIe a $2.89/hour.
- Serverless: un worker H100 Flex a $4.79/hour.
- Regione: ipotesi US; viene utilizzata la tariffa del catalogo globale, mentre disponibilità e prezzo della regione selezionata devono essere controllati nella console.
- Storage: un volume di rete standard da 100GB mantenuto per un mese al costo di $7.
- Modello di richiesta: 20 secondi di avvio per finestra di traffico, 2 secondi di esecuzione per tentativo, il timeout di inattività documentato di 5 secondi, 2% di tentativi falliti e 100 richieste riuscite per finestra.
- Riferimento per le richieste sul Pod: un Pod di produzione mantenuto attivo per tutto il mese di 730 ore, così da poter rispondere in qualsiasi momento.
Le righe dedicate alle richieste rendono visibile l'effetto del profilo di traffico. Non affermano che una H100 impieghi 2 secondi con il tuo modello. Dicono che, se il carico richiede 2 secondi per tentativo e arriva in gruppi di 100, mille richieste riuscite costano questa cifra.
Per 1,000 richieste riuscite, dividendo per un tasso di successo del 98% e arrotondando per eccesso si ottengono 1,021 tentativi. Il worker impiega 200 secondi per gli avvii distribuiti su 10 finestre, 2,042 secondi per l'esecuzione e 50 secondi in inattività. Totale: 2,292 secondi fatturabili, pari a $3.05 di calcolo H100.
Per 10,000 richieste riuscite, lo stesso metodo produce 10,205 tentativi, 2,000 secondi di avvio, 20,410 secondi di esecuzione e 500 secondi di inattività. Totale: 22,910 secondi fatturabili, pari a $30.48 di calcolo.
Lo storage rimane separato. Aggiungendo il volume di rete standard da 100GB si arriva a $10.05 e $37.48 per il mese, ma lo stesso volume può servire anche altro traffico. Non nasconderlo dentro una tariffa per richiesta che non esiste.
Sensibilità: la cadenza del traffico cambia il risultato
Un'immagine base più veloce e richieste abbastanza ravvicinate da mantenere caldo il worker possono ridurre il costo di calcolo. Con 5 secondi di avvio, 1 secondo di esecuzione, nessun errore, 5 secondi di inattività e 100 richieste riuscite per finestra, il calcolo simulato costa $1.46 per 1,000 richieste riuscite e $14.64 per 10,000.
Lo scenario opposto è costoso. Se ogni tentativo arriva dopo lo scale-to-zero e innesca da solo 20 secondi di avvio, 2 secondi di esecuzione e 5 secondi di inattività, il costo simulato sale a $36.68 per 1,000 richieste riuscite e $366.61 per 10,000.
È per questa variabilità che il numero di richieste, da solo, è l'unità di fatturazione sbagliata. Diventa utile soltanto quando gli si associano i secondi osservati del worker, il tasso di errore e la concorrenza.
Il punto di pareggio tra Pods e Serverless dipende dai secondi fatturabili
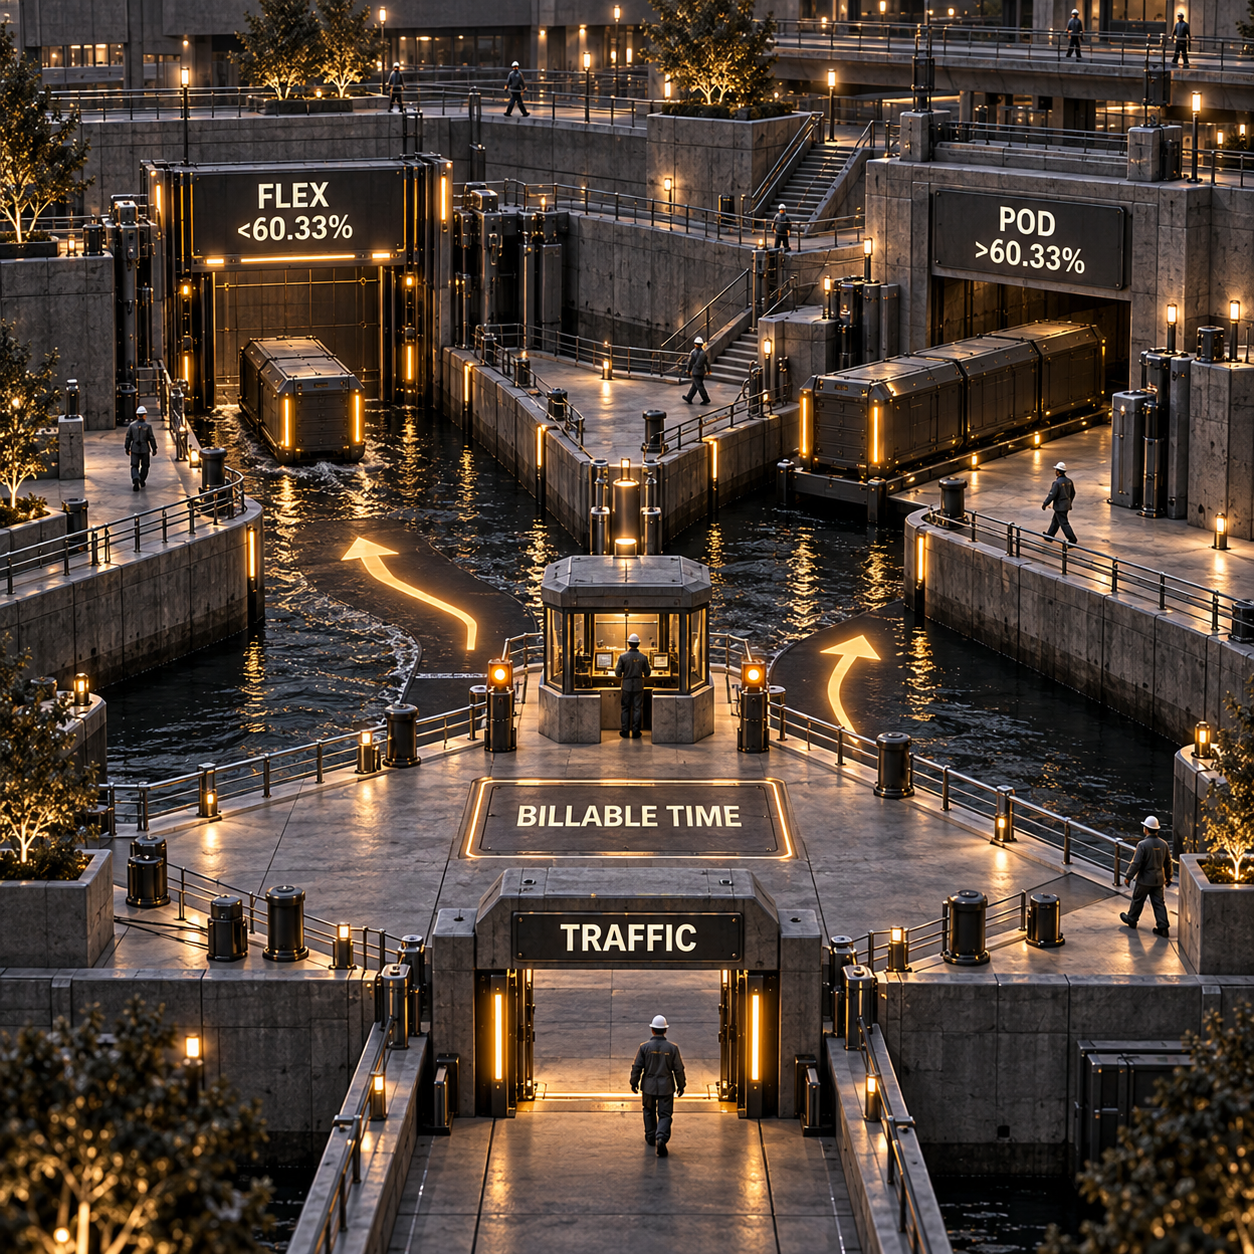
Il pareggio del solo calcolo per la H100 del caso base è esatto: basta dividere la tariffa Secure Pod di $2.89 per quella Serverless di $4.79. Il risultato è 60.33%.
Per qualsiasi finestra di osservazione:
Serverless wins when billable worker seconds < window seconds × 2.89 / 4.79.
In una finestra di servizio di 100 ore, Serverless deve restare sotto 60.33 ore fatturabili del worker per battere il Pod da $289. In un mese da 730 ore, deve restare sotto 440.44 ore fatturabili del worker per battere $2,109.70. Se lo storage è identico, si annulla nel confronto; scelte di storage diverse, invece, no.
Community Cloud cambia i conti, non il rischio. A $1.99/hour per una H100 PCIe, il pareggio del solo calcolo rispetto a Serverless da $4.79 è 41.54%, ossia 303.28 ore fatturabili in un mese di 730 ore. Questa soglia più bassa è pertinente per i processi riavviabili. Non è un motivo per spostare traffico sensibile dei clienti su capacità di terze parti.
Un preventivo per un worker Active può spostare ancora la soglia. Finché Runpod non fornisce la tariffa per iscritto, non esiste un numero corretto da inserire. Ipotizzare uno sconto fisso del 30% non equivale a un preventivo.
Prezzi dello storage Runpod: arrestato non significa gratuito
La documentazione Runpod sullo storage dei Pod descrive tre comportamenti standard. Confonderli può trasformare l'arresto di un Pod in una fattura di storage più alta.
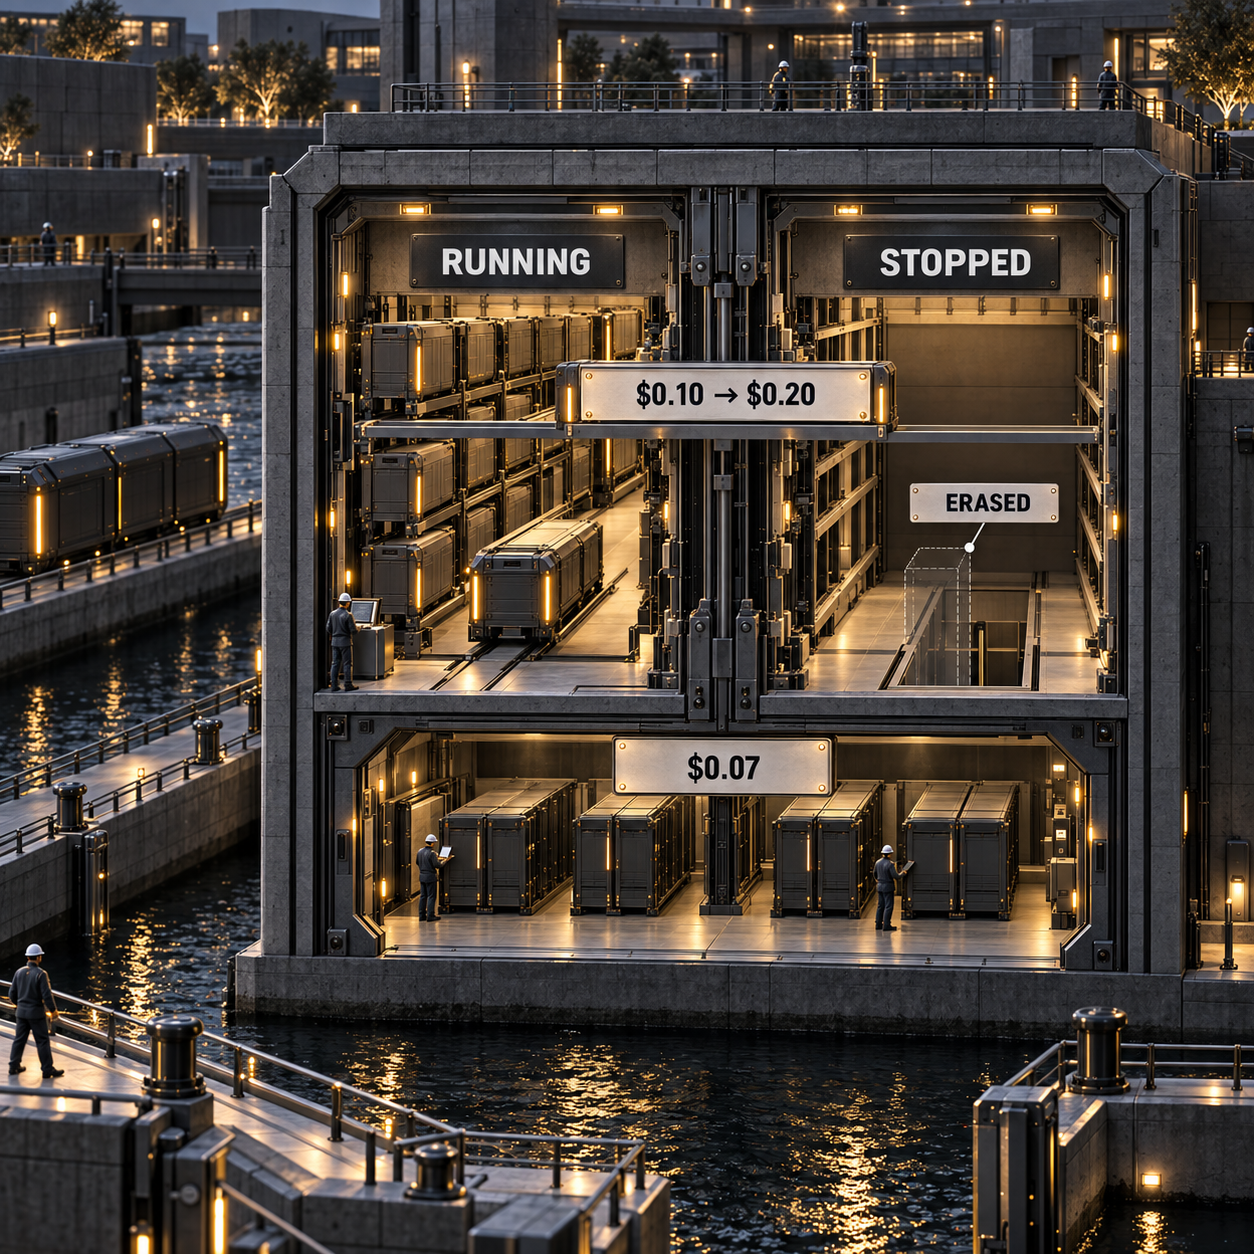
- Disco del container: $0.10/GB/month durante l'esecuzione. Quando il Pod è arrestato non viene addebitato, perché i dati vengono eliminati.
- Disco del volume: $0.10/GB/month durante l'esecuzione e $0.20/GB/month quando è arrestato. Dopo l'arresto del Pod, un volume da 100GB conservato passa quindi da $10 a $20 al mese.
- Volume di rete standard: $0.07/GB/month sotto 1TB e $0.05/GB/month sopra 1TB, indipendentemente dal fatto che il calcolo sia attivo o arrestato.
- Storage di rete ad alte prestazioni: la pagina principale dei prezzi indica $0.14/GB/month, mentre la documentazione sullo storage afferma che la tariffa esatta varia in base al data center. La console resta il riferimento definitivo.
Il costo dello storage Runpod incide anche sul posizionamento. I volumi di rete sono disponibili per i Pod solo in Secure Cloud. Devono essere scelti durante il deployment e in seguito non possono essere collegati o scollegati senza eliminare il Pod. Su Serverless, un volume è vincolato a un data center e può quindi ridurre la disponibilità delle GPU. Più volumi possono ampliare le possibilità di posizionamento, ma Runpod avverte che non si sincronizzano automaticamente.
Per i pesi di un modello condivisi da worker elastici, un volume di rete può evitare download ripetuti. Per un esperimento usa e getta, un disco del container può costare meno. Per un Pod arrestato che deve conservare il proprio spazio di lavoro locale, il disco del volume è la sorpresa più cara.
Alternative a Runpod: normalizzare un'ora H100 fatturata
Prima di considerare le funzionalità delle piattaforme, le alternative vanno confrontate sullo stesso tempo di acceleratore pagato. Per 100 ore GPU H100 fatturate, le tariffe attuali dei fornitori producono questi costi di calcolo:
- Runpod Secure Cloud Pod: $289 per H100 PCIe.
- Lambda: $329 per un'istanza H100 PCIe con una GPU. La pagina delle istanze Lambda include 1TiB SSD in questa configurazione e precisa che eventuali imposte sulle vendite, IVA o GST sono extra.
- Modal: $394.92 di costo GPU H100 SXM5, calcolato da $0.001097 al secondo, prima degli addebiti separati per CPU e memoria. Modal Starter include $30 al mese di credito gratuito.
- Runpod Serverless: $479 se tutte le 100 ore del worker sono fatturabili.
- AWS: $519.10 per una H100 p5.4xlarge Capacity Block in US East, sulla base di $5.191 per ora di acceleratore. AWS addebita in anticipo la quota di prenotazione, quindi non è l'equivalente di un servizio Serverless on demand.
Questa normalizzazione è volutamente circoscritta. Modal utilizza H100 SXM5, le righe Runpod e Lambda utilizzano H100 PCIe, AWS vende un Capacity Block programmato; differiscono inoltre CPU, memoria e storage inclusi, l'orchestrazione e la disponibilità. L'elenco risponde alla domanda sulla tariffa dell'acceleratore senza fingere che i servizi siano intercambiabili.
Runpod vs Vast.ai
Un confronto fisso con Vast.ai non può essere ridotto a un unico prezzo H100 destinato a durare. Vast.ai dichiara che i prezzi del suo marketplace cambiano con domanda e offerta, aggiorna ogni ora la tabella in tempo reale, definisce tariffa "from" l'offerta disponibile più economica e riporta separatamente la mediana. Runpod pubblica invece una tariffa di catalogo e divide la capacità tra i livelli Community e Secure.
Scegli Vast.ai se puoi interrogare le offerte in tempo reale, filtrare per affidabilità e spostare il lavoro quando cambia l'offerta. Scegli Runpod se contano di più una tariffa pubblicata stabile, un livello Secure e il percorso da Pod a Serverless che non la possibilità di cogliere l'offerta più economica del momento.
Se la vera alternativa è un'API di inferenza gestita, confronta anche il lavoro operativo, non soltanto il tempo GPU. L'analisi dei prezzi di Together AI offre un utile contrappeso alla fattura di una GPU autogestita.
Quale opzione scegliere
Scegli i Secure Cloud Pods per un agente AI rivolto ai clienti o per un servizio di elaborazione documenti che mantiene utile una GPU per gran parte della giornata. La tariffa del Pod è più bassa, il posizionamento dello storage è più chiaro e un modello già caldo evita avvii ripetuti. Il limite è la capacità inattiva: ogni minuto senza carico viene pagato.
Scegli Serverless Flex per una funzionalità con lunghi periodi di quiete, campagne a picchi, batch pianificati o traffico di lancio incerto. Può scalare fino a zero, ma i secondi di avvio, nuovi tentativi e inattività devono restare sotto il punto di incrocio. Il limite sono i cicli di vita ripetuti dei worker, soprattutto quando un modello grande si carica lentamente o l'autoscaling si espande in modo troppo aggressivo.
Scegli i worker Active soltanto dopo che i requisiti di latenza e il traffico misurato giustificano una trattativa commerciale. Restano attivi 24/7. Senza un preventivo scritto non esiste uno sconto affidabile da inserire nel modello.
Scegli i Community Cloud Pods per esperimenti, valutazioni e processi batch riavviabili. Evitali per dati regolamentati o per un endpoint di produzione la cui disponibilità fa parte della promessa del prodotto.
Scegli gli Instant o Reserved Clusters per veri carichi multi-GPU, non come aggiornamento predefinito dell'inferenza. Gli Instant Clusters pubblicano i prezzi di A100 e H200 e arrivano a 64 GPU; diversi altri tipi di GPU e tutte le durate dei Reserved Clusters richiedono il reparto commerciale.
Prima di scegliere l'hardware, definisci il modello e la decisione sulla proprietà. La guida ai modelli privati aiuta a dimensionare il modello, mentre il confronto tra coding agent gestiti e self-hosted inquadra il compromesso operativo.
- Fatturazione al secondo per Pods e Serverless, senza costi per il traffico in ingresso o in uscita.
- Un percorso che va dai Pod economici all'inferenza con scalabilità a zero e ai cluster multi-GPU.
- Tariffe di catalogo pubblicate per GPU consumer, da data center e Blackwell.
- La capacità Secure e Community consente di assegnare budget di rischio diversi ai processi riavviabili e a quelli di produzione.
- La stessa pagina H100 ufficiale contiene una vecchia tariffa Secure Cloud nella FAQ.
- Gli sconti dei worker Active sono solo su preventivo, quindi una tariffa centrale nel calcolo della produzione non può essere modellata pubblicamente.
- Il disco del volume costa il doppio mentre un Pod è arrestato.
- Il posizionamento dei volumi di rete può ridurre la disponibilità di GPU Serverless e i volumi non si sincronizzano automaticamente.
- Disponibilità e prezzo regionale definitivo richiedono comunque una verifica nella console.
Lunedì, il primo passo è sostituire le ipotesi con i dati di una settimana rappresentativa.
Definisci il perimetro del carico
Scegli un modello, una classe di GPU, un livello cloud e una regione. Non confrontare una H100 Community con una H100 Secure e non mescolare il throughput di H100 e A100.
Registra ogni fase fatturabile
Registra i timestamp di avvio del worker, disponibilità del modello, inizio e fine della richiesta e arresto del worker. Annota il numero di worker e i tentativi falliti accanto alle richieste riuscite.
Separa gli stati dello storage
Elenca in GB lo storage del container, del volume e di rete. Calcola separatamente i periodi di esecuzione e di arresto, invece di chiamare tutti i dati conservati semplicemente "storage".
Applica il punto di incrocio
Somma i secondi dei worker dedicati ad avvio, esecuzione, nuovi tentativi e inattività. Confronta il totale con il 60.33% della finestra del Secure Pod, poi sostituisci $2.89 e $4.79 con le tariffe della console e dei preventivi che puoi davvero acquistare.
FAQ sui prezzi Runpod
Quali servizi costano meno di Runpod?
Vast.ai o un altro marketplace possono pubblicare un'offerta in tempo reale più bassa, mentre il costo GPU H100 attuale di Modal è inferiore a quello di Runpod H100 Serverless quando viene fatturato per intero. Anche Runpod Community Cloud può costare meno di Secure Cloud. La fattura più bassa dipende comunque dal tempo di inattività del worker, dallo storage, dall'affidabilità e da ciò che il servizio include.
Runpod conviene?
Runpod conviene quando servono container, modello e GPU propri con fatturazione al secondo. È meglio evitarlo quando un'API di modelli gestita costa meno rispetto alla gestione interna di immagini, scalabilità, monitoraggio e nuovi tentativi, oppure quando gli impegni già assunti con un altro cloud contano più del prezzo esposto della GPU.
Runpod è meglio di AWS?
In questo confronto normalizzato su una singola H100, Runpod è più semplice ed economico: $2.89 per ora di Secure Pod contro $5.191 per ora di acceleratore H100 per un AWS p5.4xlarge Capacity Block in US East. AWS può comunque essere la scelta di sistema migliore quando il carico dipende dai suoi servizi di rete, dati, governance o dalla spesa già impegnata.
Runpod è gratis?
Nella pagina dei prezzi attuale non compare un piano generale con calcolo gratuito. Si aggiungono fondi e si pagano le risorse misurate. Le startup idonee e alcuni programmi partner possono ricevere crediti, ma si tratta di iniziative con condizioni specifiche, non di un piano gratuito permanente.
Quanto costa Runpod?
Il catalogo Pod pubblicato e utilizzato in questa analisi va da $0.27/hour per RTX A5000 a $7.89/hour per B300. Serverless va da $0.58/hour per la fascia da 16GB a $9.98/hour per B300. A questi valori si aggiungono storage e profilo temporale del worker.
Qual è l'opzione più economica per il noleggio GPU?
Nella tabella Pod attualmente pubblicata da Runpod, RTX A5000 ha la tariffa più bassa: $0.27/hour. Un marketplace può mostrare un'offerta temporanea inferiore, ma disponibilità, affidabilità dell'host, banda e storage possono annullare il risparmio apparente.
Noleggiare una GPU è redditizio?
Può esserlo, ma la sola tariffa di noleggio non basta a rispondere. Il margine lordo per risultato riuscito deve superare calcolo, storage, tentativi falliti, capacità inattiva, monitoraggio e ingegneria. Applica il calcolo per richieste riuscite ai ricavi e ai log osservati.
Qual è la GPU più economica disponibile adesso?
Il catalogo in tempo reale di Runpod indica RTX A5000 a $0.27/hour, ma la GPU più economica che si può effettivamente avviare dipende dalla disponibilità del momento nel livello e nella regione selezionati. Conferma l'offerta nella console subito prima del lancio.
Quanto costa noleggiare una GPU NVIDIA?
Nel catalogo Pod di Runpod utilizzato qui, la fascia attuale va da $0.27 a $7.89 per GPU-hour. Una H100 PCIe Secure Cloud costa $2.89/hour, mentre H100 Serverless costa $4.79 per ora fatturabile del worker.
Come funzionano i crediti gratuiti Runpod?
Il Runpod Startup Program dichiara che i membri Starter accettati ricevono $1,000 in crediti una tantum. I membri Growth versano $50,000 in anticipo e ricevono un bonus di $25,000, per un totale di $75,000 nell'ambito di un accordo di 12 mesi senza ricarica dei crediti.
Runpod offre uno sconto studenti?
Nelle pagine dei prezzi, nella documentazione e nel programma Startup verificati il 25 settembre 2026 non compariva alcuno sconto pubblico dedicato agli studenti. È quindi opportuno calcolare le tariffe self-service o candidarsi a un programma di crediti idoneo, senza presumere l'esistenza di un prezzo education.
Qual è la politica di rimborso di Runpod?
I termini di Runpod affermano che i costi del servizio sono generalmente non rimborsabili e che gli abbonamenti annullati non ricevono rimborsi proporzionali per il periodo in corso. Anche i Pod Savings Plans sono espressamente non rimborsabili.
I prezzi di Runpod sono cambiati?
Il prezzo attuale di H100 Serverless è $4.79/hour. Materiali pubblicati in precedenza riportano ancora $4.18, mentre la tabella delle tariffe Runpod del 10 agosto indica $4.55, ma durante questa verifica non è stato trovato alcun registro ufficiale delle modifiche che specifichi una data esatta di entrata in vigore. Usa la tariffa in tempo reale con data certa.
- Ultimo aggiornamento
- 25 set 2026
- Categoria
- Build
Preferisca questo sito su Google


Segni omidsaffari.com come fonte preferita e Google lo mette in evidenza per lei in Top Stories, AI Overviews e AI Mode.

Vercel Sandbox Drives: workspace persistenti per agenti
Scopri come usare Vercel Sandbox Drives per conservare workspace, cache e file tra sandbox diverse, gestendo snapshot, regioni, limiti e costi.25 set 2026Build
Web crawler alternativi a Firecrawl: 7 opzioni a confronto
Confronto tra 7 web crawler alternativi a Firecrawl: prezzi, modelli operativi e costi per pagina accettata, con un piano pratico per migrare.25 set 2026Build
AI code review: 7 alternative a CodeRabbit a confronto
Confronto tra 7 alternative a CodeRabbit per AI code review: prezzi, host Git, privacy, self-hosting e costi reali per un team di cinque sviluppatori.25 set 2026Build
AI code review: Greptile o CodeRabbit, quale conviene?
Confronto tra Greptile e CodeRabbit per AI code review: prezzi, limiti, piattaforme, crediti e costi reali per un team di cinque sviluppatori.25 set 2026Build
Perplexity Computer su Windows: guida alla modalità locale
Configura Perplexity Computer in locale su un PC Windows compatibile, scegli il modello giusto e prova un flusso ricorrente sui file con permessi cloud chiari.25 set 2026Build
Workflow AI sotto controllo: AgentRun alla prova
AgentRun mette confini espliciti ai workflow AI: la prova di stato tipizzato, chiamate agli agenti, escalation, costi e limiti della beta.4.24 set 2026Build
Perplexity API: Fast Search o ricerca web predefinita?
Perplexity API a confronto: costi, latenza e copertura di Fast Search e ricerca web, con una regola pratica per scegliere la modalità giusta.24 set 2026Build