Runpod 料金ガイド(2026年版):PodsとServerlessはどちらが得か
Runpod 料金をPods、Serverless、ストレージ別に整理。H100の実勢価格、100時間・730時間・リクエスト単位の試算、課金時間60.33%の損益分岐点を、2026年9月25日に確認した公式価格に基づいて比較します。GPUクラウドの構成選びと予算化に必要な判断基準も分かります。


このRunpod 料金ガイドでは、本番向けH100の価格を比較します。Secure Cloud Podは1時間$2.89、Serverlessは課金対象のワーカー時間あたり$4.79からで、ストレージは別料金です。起動・実行・再試行・アイドル時間の合計がPodの稼働時間の60.33%未満ならServerless、それ以上ならGPUを確保し続ける方が有利です。
Runpod 料金の早見表
Runpod 料金は月額制SaaSのような定額プランではなく、使用量に応じて決まります。実際の選択肢は、専用Podの稼働中ずっと料金を払うか、Serverlessワーカーが生きている時間だけ払うか、継続的なワークロード向けに見積もり制のキャパシティを契約するかです。
以下の価格は、2026年9月25日にRunpodの公開料金ページで確認しました。同ページの日付は2026年9月13日です。利用できるGPU、クラウド階層、リージョンと最終価格は、現在もコンソール上の表示が基準です。
Runpodには、一般的な月払い・年払いの切り替えはありません。Podはオンデマンドで、Pod Savings Planは3か月または6か月分を前払いします。Reserved Clustersは12か月およびそれ以上の契約期間も示していますが、見積もりが必要です。通常の「超過料金」という項目もなく、ワークロードが停止するか、残高がゼロになるか、アカウント全体に初期設定された**$80/hour**の利用上限に達するまで、コンピュートとストレージの従量課金が続きます。この上限はサポートに依頼すれば引き上げられるとRunpodは説明しています。
Pod向けRunpod GPU料金
モデルが長時間かつ予測可能な形でGPUに常駐するなら、Podの料金体系が専用インスタンスに向いています。コンテナを自分で管理し、Podの稼働中は専用GPUを確保できますが、処理のない時間にも料金がかかります。
現在のPodカタログに掲載されている時間単価は次のとおりです。いずれも秒単位で課金されます。
- 80GB以上: B300 $7.89、B200 $6.79、H200 $4.59、RTX Pro 6000 $2.09、H100 NVL $3.19、H100 PCIe $2.89、H100 SXM $3.49、A100 PCIe $1.59、A100 SXM $1.59。
- 48GB: Pro 6000 MIG $1.09、L40S $1.09、RTX 6000 Ada $0.84、A40 $0.49、L40 $0.82、RTX A6000 $0.53。
- 24GB〜32GB: RTX 5090 $0.99、Pro 6000 MIG 24GB $0.59、L4 $0.49、RTX 3090 $0.50、RTX 4090 $0.74、RTX A5000 $0.27。
これはカタログ価格であり、どのロケーションでも各GPUを利用できるという保証ではありません。予算を確定する前に、コンソールでGPU、クラウド階層、リージョンを選び、表示内容を確認してください。
Community CloudとSecure Cloudの違い
本番環境の基本候補はSecure Cloudです。Runpodは、T3/T4データセンターのシングルテナント型ハードウェアと説明し、本番用途や規制対象データ向けに位置づけています。Community Cloudは審査済みの第三者キャパシティを利用するため、実験や途中から再開できるジョブ向けの低価格な選択肢と考えるのが妥当です。
H100 PCIeについては、公開中のH100比較欄に、Community Cloudは$1.99/hour、Secure Cloudは$2.89/hourとあります。差額は$0.90で、100 GPU-hoursなら$90の節約です。ただし、単純な割引ではありません。提供保証が必要な顧客向けエージェントで、1時間あたり$0.90を抑えるためだけに本番向け階層を手放すべきではありません。
ベンダーページ内には注意すべき不整合があります。現在のH100ページでは、見出しと比較欄がメイン料金ページと同じSecure Cloudの$2.89/hourを示す一方、同じページ下部のFAQにはまだ$2.39/hourと記載されています。コンソールに別の価格が表示されない限り、$2.89を使ってください。
Podの長期利用向けオプションがSavings Plansです。GPUコンピュートだけを対象に3か月または6か月分を前払いし、ストレージは対象外です。有効期限は固定され、返金もありません。Podを停止した場合は、同じGPUタイプを使う次のデプロイへプランを移せます。構成が安定したフリートには便利ですが、GPUやトラフィック特性をまだ見直しているチームには向きません。
Runpod Serverless料金:リクエスト数ではなくワーカー時間で払う
Serverlessが常時稼働のPodより安くなるのは、ワーカーがゼロの時間を十分に確保できる場合だけです。請求対象は成功したAPIコールの数ではなく、ワーカーが生きている時間です。そのため、コールドスタート、モデルの読み込み、失敗した試行、アイドルタイムアウトも予算に含める必要があります。
Runpodには二種類のワーカーがあります。
- Flex workersはゼロまでスケールし、公開されている秒単価が適用されます。
- Active workersは安定したトラフィックと低レイテンシーのため24/7で稼働します。Runpodの課金ドキュメントには営業への問い合わせによる割引があると書かれていますが、固定の割引率は約束されていません。
H100 Flexを$4.18/hourとして予算化したり、すべてのActiveワーカーが30%引きになると仮定したりしないでください。現在のH100 Flex料金は**$4.79/hour**で、Active料金は見積もり次第です。古い固定割引率を使うと、リクエストが一件も届かない段階から、誤ったアーキテクチャの方が安く見えてしまいます。
Runpod ServerlessのGPU料金表
現在のFlexカタログには13の価格クラスがあります。
- 大容量メモリ: B300 $9.98/hour、B200 $8.64、H200 $5.93、RTX 6000 Pro $3.49、H100 $4.79、A100 $2.72。
- 48GB・32GB: L40/L40S/6000 Ada/MIG 48GB $1.75、A6000/A40 $1.22、RTX 5090 $1.58、RTX PRO 4500 Blackwell $1.15。
- 24GB・16GB: RTX 4090 $1.10、L4/A5000/3090/MIG 24GB $0.69、A4000/A4500/RTX 4000/RTX 2000 $0.58。
価格クラスを決めるのはワーカーのGPUであり、モデル名やリクエストではありません。小さなリクエストを処理する24GBワーカーでも、稼働中は$0.69/hourです。失敗したリクエストを処理したH100も、実際に動いた秒数は課金されます。
課金対象の時間は三つに分かれます。
- 起動: コンテナを初期化し、モデルをGPUメモリへ読み込みます。
- 実行: リクエストを処理します。後から失敗となる処理も含みます。
- アイドルタイムアウト: 次のリクエストに備え、処理完了後もワーカーを生かします。ドキュメント上の初期値は5秒です。
ワーカー数が増えると、三つのフェーズすべてがその数だけ増えます。各ワーカーは実行前に個別にモデルを読み込むため、それぞれに起動時間が発生します。オートスケーリングはアイドル状態のキャパシティを減らせますが、過度に積極的なスケーリングでは、複数のワーカーで起動コストを繰り返すことになります。
Runpod 料金シミュレーション:100時間、730時間、成功リクエスト
このRunpodコストモデルは再現可能な試算であり、実測スループットを示すものではありません。本番予算を承認する前に、各仮定を保存済みの請求ログとリクエストログの実測値へ置き換えてください。
基準日は同じまま、次の条件で試算します。
- GPU: NVIDIA H100を1基。
- Pod: Secure Cloud H100 PCIe、$2.89/hour。
- Serverless: H100 Flexワーカー1基、$4.79/hour。
- リージョン: USを想定。グローバルカタログの価格を使い、選択したコンソールのリージョンで在庫と価格を確認する必要があります。
- ストレージ: 100GBのstandard network volumeを1か月保持し、$7。
- リクエストモデル: 各トラフィックウィンドウで起動20秒、各試行の実行2秒、ドキュメント上のアイドルタイムアウト5秒、失敗率2%、各ウィンドウで成功リクエスト100件。
- Pod側の基準: いつでも応答できるよう、本番用Podを730時間の月を通して稼働。
リクエスト単位の行を見ると、トラフィックの形がコストへどう響くかが分かります。ただし、H100がこのモデルの処理に2秒必要だと主張しているわけではありません。「各試行に2秒かかり、100件ずつまとまって到着する」という条件なら、1,000件の成功リクエストにこの金額がかかる、という試算です。
成功1,000件では、成功率98%で割り、切り上げると1,021試行です。10ウィンドウの起動に200秒、実行に2,042秒、アイドルに50秒を使います。合計は課金対象の2,292秒で、H100のコンピュート料金は**$3.05**です。
成功10,000件も同じ方法で、10,205試行、起動2,000秒、実行20,410秒、アイドル500秒となります。合計は課金対象の22,910秒で、コンピュート料金は**$30.48**です。
ストレージは別に計算します。100GBのstandard network volumeを加えると月額は$10.05と$37.48になりますが、このボリュームをほかのトラフィックでも使うことは可能です。根拠のないリクエスト単価へ埋め込んではいけません。
感度分析:トラフィックの間隔で結果は変わる
ベースイメージを高速化し、トラフィックが途切れにくい構成なら、コンピュート料金を下げられます。起動5秒、実行1秒、失敗なし、アイドル5秒、1ウィンドウあたり成功100件の場合、試算上のコンピュート料金は成功1,000件で$1.46、10,000件で$14.64です。
逆のパターンは高くつきます。すべての試行がスケールゼロ後に到着し、そのたびに起動20秒、実行2秒、アイドル5秒が発生すると、試算上のコンピュート料金は成功1,000件で$36.68、10,000件で$366.61まで上がります。
この幅があるため、リクエスト数だけを課金単位として扱うのは不適切です。実測したワーカー秒数、失敗率、同時実行数を組み合わせて初めて、リクエスト数が有効な指標になります。
PodsとServerlessの損益分岐点は課金秒数で決まる
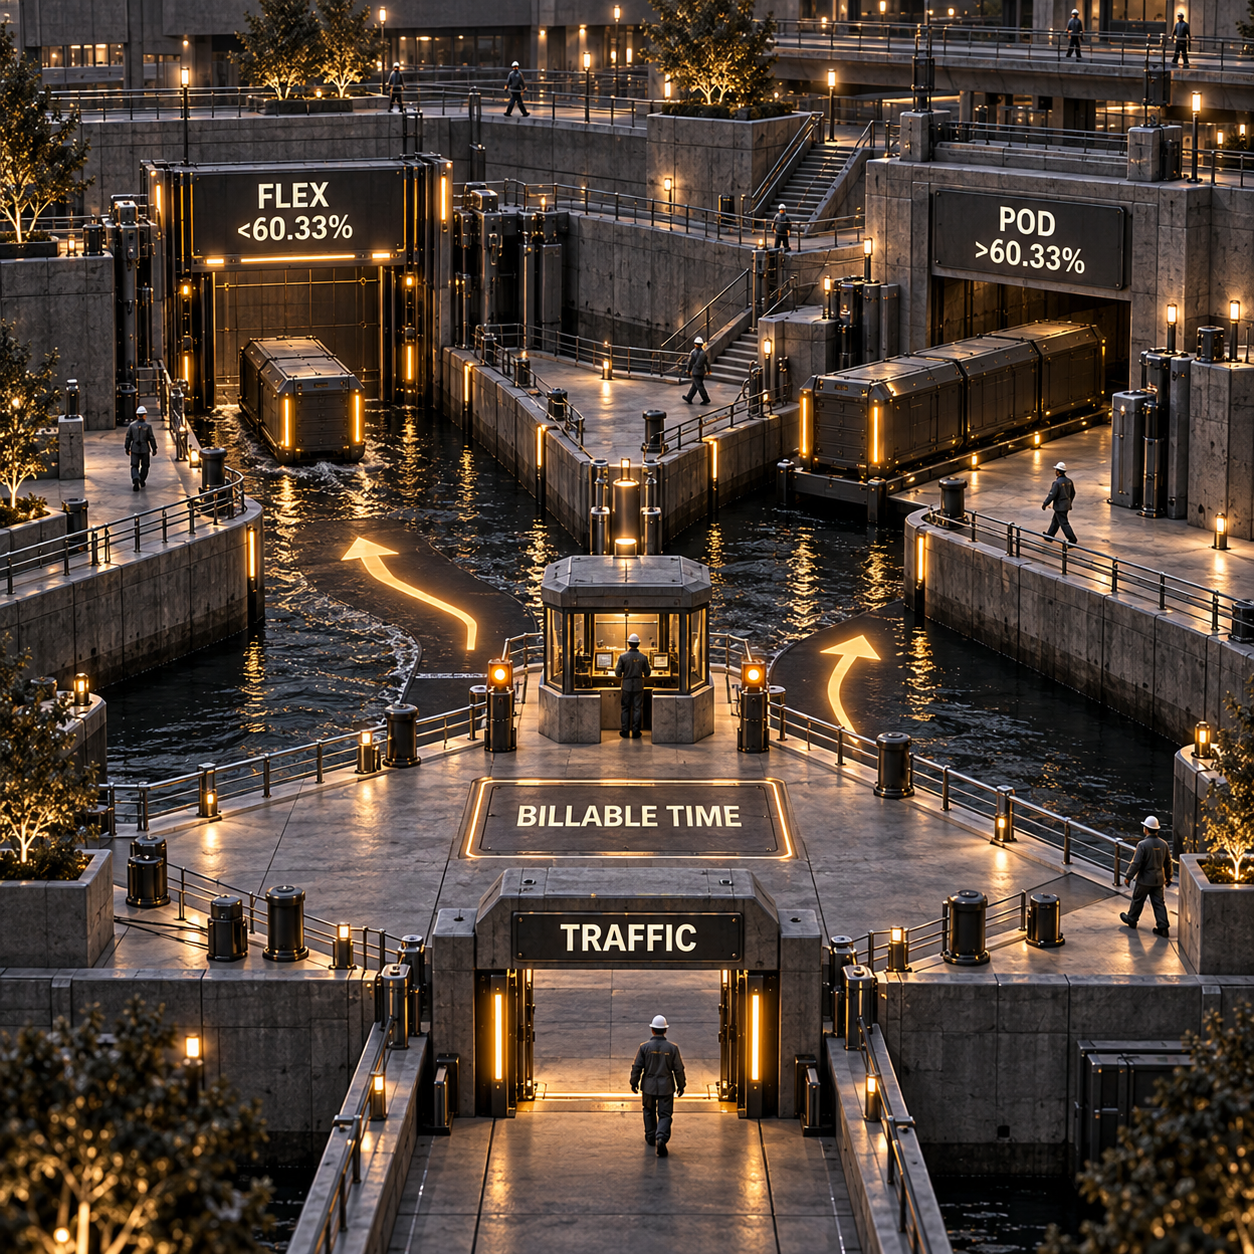
基準としたH100のコンピュート料金だけを比べると、損益分岐点は正確に計算できます。Secure Podの$2.89をServerlessの$4.79で割ると、**60.33%**です。
どの観測期間でも、判定式は次のとおりです。
Serverless wins when billable worker seconds < window seconds × 2.89 / 4.79.
100時間のサービス提供期間なら、Serverlessが$289のPodより安くなるには、課金対象のワーカー時間を60.33時間未満に抑える必要があります。730時間の月なら、$2,109.70を下回る条件は440.44時間未満です。同じストレージを使うなら比較上は相殺されますが、ストレージ構成が違えば相殺されません。
Community Cloudではリスクは変わりませんが、計算結果は変わります。H100 PCIeが$1.99/hourなら、$4.79のServerlessに対するコンピュートのみの損益分岐点は41.54%、730時間の月では課金対象が303.28時間です。この低い基準は再開可能な処理には意味がありますが、機密性の高い顧客トラフィックを第三者のキャパシティへ移す理由にはなりません。
Activeワーカーの見積もりによって、分岐点はさらに変わります。Runpodから書面で価格を受け取るまでは、正直に代入できる数値はありません。固定の30%引きを見積もりとして扱うこともできません。
Runpodストレージ料金:停止しても無料とは限らない
RunpodのPodストレージに関するドキュメントには、標準的な三種類の挙動が示されています。違いを理解していないと、Podを止めた後にストレージ料金が上がることがあります。
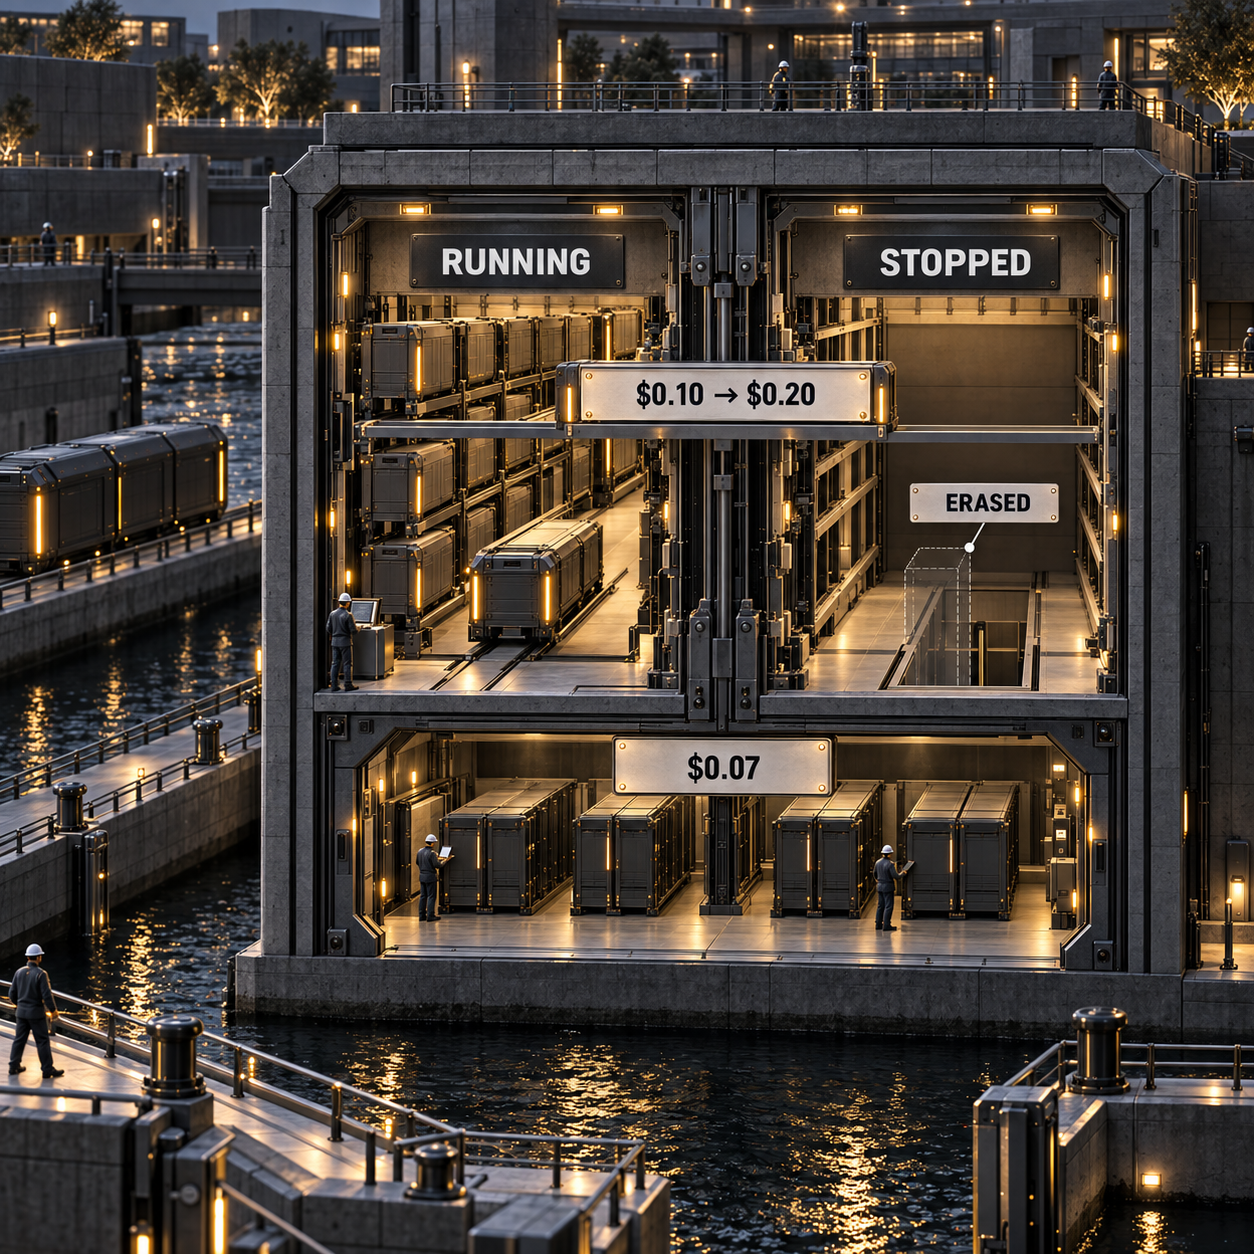
- Container disk: 稼働中は$0.10/GB/month。停止時にはデータが消去されるため、課金されません。
- Volume disk: 稼働中は$0.10/GB/month、停止中は$0.20/GB/month。したがって、保持する100GBのボリュームは、Pod停止後に月額$10から$20へ上がります。
- Standard network volume: コンピュートの稼働・停止にかかわらず、1TB未満は$0.07/GB/month、1TB超は$0.05/GB/month。
- High-performance network storage: メインの料金ページには$0.14/GB/monthとありますが、ストレージのドキュメントではデータセンターによって正確な料金が変わると説明されています。最終的にはコンソールを基準にしてください。
Runpodのストレージコストは、配置にも影響します。Network volumesをPodで利用できるのはSecure Cloudだけです。デプロイ時に選ぶ必要があり、後からPodを削除せずに取り付けたり取り外したりすることはできません。Serverlessではボリュームがデータセンターにひもづくため、利用できるGPUが減る場合があります。複数のボリュームで配置先を分散できますが、自動的には同期されないとRunpodは説明しています。
伸縮するワーカー間でモデルの重みを共有するなら、network volumeによって繰り返しのダウンロードを避けられます。使い捨ての実験なら、container diskの方が安くなる可能性があります。ローカルの作業環境を残したままPodを停止する場合は、volume diskの値上がりが思わぬ出費になります。
Runpodの代替サービス:H100の有料利用1時間にそろえて比較
代替サービスは、まず同じアクセラレーターの有料利用時間にそろえてから、プラットフォーム機能を含めて判断する必要があります。H100を100 GPU-hours利用した場合、各社の現行価格によるコンピュート料金は次のとおりです。
- Runpod Secure Cloud Pod: H100 PCIeで$289。
- Lambda: 1基構成のH100 PCIeインスタンスで$329。Lambdaのインスタンスページによると、この構成には1TiB SSDが含まれ、該当するsales tax、VAT、GSTは別途かかります。
- Modal: H100 SXM5のGPU料金は1秒$0.001097で$394.92。CPUとメモリの料金は別です。Modal Starterには、月額$30の無料クレジットが含まれます。
- Runpod Serverless: 100 worker-hoursがすべて課金対象なら$479。
- AWS: US EastのH100 p5.4xlarge Capacity Block 1基で$519.10。アクセラレーター1時間あたり$5.191を使った計算です。AWSは予約料金を前払いで請求するため、オンデマンドのServerlessと同等ではありません。
この比較は意図的に範囲を絞っています。ModalはH100 SXM5、RunpodとLambdaはH100 PCIeを使い、AWSは時間指定のCapacity Blockを販売しています。また、付属するCPU、メモリ、ストレージ、オーケストレーション、可用性も異なります。サービスを同一視せず、アクセラレーター単価だけを比べるための一覧です。
RunpodとVast.aiの比較
Vast.aiとの比較を、長く使えるH100の固定価格一つにまとめることはできません。Vast.aiの説明によると、マーケットプレイス価格は需要と供給で変動し、公開テーブルは毎時更新されます。また、レンタル可能な最安オファーを「from」価格として、中央値とは別に掲載しています。一方、Runpodはカタログ価格を公開し、キャパシティをCommunityとSecureに分けています。
リアルタイムのオファーを検索し、信頼性で絞り込み、供給状況に応じて処理を移せるならVast.aiが向いています。安定した公開価格、Secure階層、PodからServerlessへ移行できる構成を、一時点の最安値より重視するならRunpodが候補です。
実際の比較対象がマネージド型の推論APIなら、GPU時間だけでなく運用作業も比較してください。Together AIの料金分析は、セルフホストGPUの費用と比べる際の参考になります。
ワークロード別の選び方
顧客向けAIエージェントや文書処理サービスで、一日の大半にわたり1基のGPUを有効活用できるなら、Secure Cloud Podsを選びます。Podの単価は低く、ストレージの配置が明確で、モデルをウォーム状態に保てるため起動の繰り返しも避けられます。弱点はアイドルキャパシティで、処理のない時間にも料金がかかります。
長い空白時間がある機能、突発的なキャンペーン、定期バッチ、需要が読めないローンチにはServerless Flexを選びます。ゼロまでスケールできますが、起動・再試行・アイドル秒数を損益分岐点より下に抑える必要があります。特に、大きなモデルの読み込みが遅い場合や、オートスケーリングでワーカーを過剰に増やす場合は、ワーカーの生存時間が繰り返し発生する点が弱みです。
Active workersは、レイテンシー要件と実測トラフィックから営業担当への相談が妥当だと分かってから選びます。24/7で稼働するため、書面による見積もりがなければ、信頼できる割引額をモデルへ組み込めません。
実験、評価、再開可能なバッチ処理にはCommunity Cloud Podsを選びます。規制対象データや、可用性が製品の約束に含まれる本番エンドポイントには使わない方がよいでしょう。
本当にマルチGPUが必要な処理にはInstant ClustersまたはReserved Clustersを選びます。推論処理の標準的なアップグレード先として選ぶものではありません。Instant ClustersはA100とH200の価格を公開し、最大64 GPUsまで拡張できます。それ以外の複数のGPUタイプと、Reserved Clusterの全契約期間は営業への問い合わせが必要です。
ハードウェアを選ぶ前に、モデルと所有形態を決めてください。プライベートエージェント向けモデルガイドはモデル規模の判断に、マネージド型とセルフホスト型コーディングエージェントの比較は運用上のトレードオフ整理に役立ちます。
- PodとServerlessはいずれも秒単位課金で、ingress feeもegress feeもありません。
- 低価格なPodから、ゼロまでスケールする推論、マルチGPUクラスターまで移行できます。
- コンシューマー向け、データセンター向け、Blackwellの各GPUについてカタログ価格を公開しています。
- SecureとCommunityを使い分け、再開可能な処理と本番処理に異なるリスク予算を設定できます。
- 公式H100ページ内に、古いSecure CloudのFAQ価格が残っています。
- Activeワーカーの割引は見積もり制で、本番環境の中核となる単価を公開情報だけでは試算できません。
- Pod停止中はvolume diskの料金が2倍になります。
- Network volumeの配置によってServerlessで選べるGPUが減る場合があり、ボリュームは自動同期されません。
- 在庫状況と最終的なリージョン価格は、今もコンソールで確認する必要があります。
週明けにやるべきことは、想定値を代表的な一週間分の実測データへ置き換える作業です。
ワークロードの条件を固定する
モデル、GPUクラス、クラウド階層、リージョンを一つずつ決めます。Community H100とSecure H100を比べたり、H100とA100のスループットを混在させたりしないでください。
課金対象の全フェーズを記録する
ワーカー起動、モデル準備完了、リクエスト開始、リクエスト終了、ワーカー停止の各タイムスタンプを取得します。ワーカー数と失敗した試行も、成功リクエストと並べて記録してください。
ストレージの状態を分ける
Container、volume、network storageをGB単位で一覧にします。保持データをすべて「ストレージ」と一括りにせず、稼働中と停止中を別々に見積もってください。
損益分岐点を当てはめる
起動・実行・再試行・アイドルのワーカー秒数を合計し、Secure Podの対象期間に対する60.33%と比較します。その後、$2.89と$4.79を、実際に購入できるコンソール価格と見積もり価格へ置き換えてください。
Runpod 料金に関するよくある質問
Runpodより安いサービスはありますか?
Vast.aiなどのマーケットプレイスでは、リアルタイムでより安いオファーが出ることがあります。また、現在のModalのH100 GPU料金は、全時間が課金対象となるRunpod H100 Serverlessより低額です。Runpod内でもCommunity CloudはSecure Cloudより安くなる場合があります。最終的な安さは、ワーカーのアイドル時間、ストレージ、信頼性、サービスに含まれる内容によって変わります。
Runpodを使う価値はありますか?
独自のコンテナ、モデル、GPUを秒単位課金で使いたいなら、Runpodには利用価値があります。イメージ管理、スケーリング、監視、再試行を自社で運用するよりマネージド型モデルAPIの方が安い場合や、既存クラウドの契約メリットがGPUの表示価格より重要な場合は、別の選択肢が適しています。
RunpodはAWSより優れていますか?
この単一H100の標準化比較では、Runpodの方がシンプルで安価です。Secure Podは$2.89/hour、US EastのAWS p5.4xlarge Capacity BlockはH100アクセラレーター1時間あたり$5.191です。ただし、ワークロードがAWSのネットワーク、データサービス、ガバナンス、契約済み支出に依存するなら、システム全体ではAWSが適することもあります。
Runpodは無料で使えますか?
公開中の料金ページには、コンピュートを一律無料で使えるプランはありません。残高を追加し、従量制リソースの料金を支払います。条件を満たすスタートアップや一部のパートナープログラムではクレジットを受け取れますが、恒久的な無料プランではなく、条件付きの制度です。
Runpodの料金はいくらですか?
この記事で使った現在のPodカタログでは、RTX A5000の$0.27/hourからB300の$7.89/hourまでです。Serverlessは16GBクラスの$0.58/hourからB300の$9.98/hourまでで、これにストレージとワーカーの稼働パターンによる料金が加わります。
最も安いGPUレンタルはどれですか?
Runpodの現行Pod料金表では、RTX A5000が$0.27/hourで最安です。マーケットプレイスには一時的にさらに安いオファーが出る可能性がありますが、在庫、ホストの信頼性、帯域幅、ストレージを含めると、見かけ上の節約が逆転することもあります。
GPUレンタルで利益は出ますか?
利益を出せる可能性はありますが、レンタル料金だけでは判断できません。成功成果あたりの粗利益が、コンピュート、ストレージ、失敗した試行、アイドルキャパシティ、監視、エンジニアリングの合計を上回る必要があります。成功リクエストの試算表に、実測した売上とログを当てはめてください。
今すぐ借りられる最安のGPUはどれですか?
Runpodの公開カタログではRTX A5000が$0.27/hourですが、実際にデプロイできる最安GPUは、選択した階層とリージョンの在庫によって変わります。開始直前にコンソールでオファーを確認してください。
NVIDIA GPUのレンタル料金はいくらですか?
この記事で使ったRunpodの現行Podカタログでは、GPU-hourあたり$0.27〜$7.89です。Secure Cloud H100 PCIeは$2.89/hour、H100 Serverlessは課金対象のworker-hourあたり$4.79です。
Runpodの無料クレジットはどのような仕組みですか?
Runpod Startup Programによると、採択されたStarterメンバーは一度限りの$1,000クレジットを受け取れます。Growthメンバーは$50,000を前払いし、$25,000のボーナスを受け取り、クレジットの再補充なし・12か月契約で合計$75,000となります。
Runpodに学生割引はありますか?
2026年9月25日に確認した公開料金、ドキュメント、Startup Programの各ページには、学生専用の公開割引はありませんでした。教育向け価格があると仮定せず、セルフサービス料金で予算を立てるか、条件を満たすクレジット制度へ申請してください。
Runpodの返金ポリシーはどうなっていますか?
Runpodの利用規約では、サービス料金は原則返金されず、サブスクリプションを解約しても当期分は日割り返金されないとしています。Pod Savings Plansも返金不可と明記されています。
Runpodの料金は変更されましたか?
現在のH100 Serverless料金は$4.79/hourです。古い公開情報にはまだ$4.18とあり、Runpodが8月10日に公開した料金表には$4.55と記載されています。ただし、今回の確認では、正確な適用開始日を示す公式の変更履歴は見つかりませんでした。日付を確認した公開料金を使ってください。
- 最終更新
- 2026年9月25日
- カテゴリー
- Build
Googleでこのサイトを優先する


omidsaffari.comを優先ソースに設定すると、GoogleがTop Stories・AI Overviews・AI Modeであなたのために優先表示します。

Vercel Sandbox Driveで作る永続クラウド開発環境:導入と検証ガイド
Vercel Sandbox Driveで、エージェントの作業フォルダを新しいサンドボックスへ引き継ぐ方法を解説します。永続クラウド開発環境の構築手順、スナップショット、単一ライター制約、リージョン設計、料金、導入前に確認したい4つのテストをTypeScript例とともに整理します。2026年9月25日Build
Webクローラー比較:Firecrawl代替7選を料金・機能・移行コストで検証
Firecrawlの代替となるWebクローラー7製品を、Markdown・JSON出力、探索範囲、レンダリング、料金、運用工数で比較。1,000〜100,000件の採用ページを基準に、Apify、Crawl4AI、ScrapFlyなどの向き不向きと、安全な移行手順まで具体的に整理します。2026年9月25日Build
AI コードレビューで選ぶCodeRabbit代替ツール7選
CodeRabbitの代替7製品を、Gitホスト対応、データ境界、料金単位、セルフホスト可否で比較。5人・300回のAI コードレビューを基準に、Greptile、cubic、Qodo、PR-Agent、Kodus、Cursor Bugbot、GitHub Copilotの費用、選び方、乗り換え条件を整理します。2026年9月25日Build
AI コードレビュー比較:GreptileとCodeRabbitはどちらを選ぶ?
AI コードレビューのGreptileとCodeRabbitを、料金体系、レビュー上限、対応Gitホスト、実行時検証の違いで比較。5人チームの費用試算を基に、定常的なPRにはCodeRabbit、深度調整やT-Rexが必要なレビューにはGreptileを選ぶ判断基準を解説します。2026年9月25日Build
Perplexity Portable Computerの使い方:AMD WindowsでローカルAIを動かす
Perplexity Portable ComputerをAMD Ryzen AI Max搭載Windows PCでローカル実行する条件と設定手順を解説。GPUアクセス可能メモリ24 GB、モデル選択、フォルダー権限、クラウド承認、定期実行まで、既知の例外3件を使った検証方法とともに整理します。2026年9月25日Build
AgentRun レビュー:beta.4を実測、導入価値と限界を検証
AgentRun レビューとしてbeta.4をサポート業務で実測。分岐制御、型付き状態、エスカレーション、料金、LangGraph.jsやTemporalとの違いを検証し、31行のTypeScript関数より導入価値が出る条件、ホスト側に残る実装負担、採用前に確認すべき制約まで具体的なテスト結果から解説します。2026年9月24日Build
Perplexity APIのFast Searchと標準webを比較:料金・速度・検索品質
Perplexity APIのFast Searchと標準webを、料金、レイテンシ、検索品質、情報源の網羅性で比較。10,000回の検索費用は$10対$50です。反復的な検索にはfast、曖昧で網羅性が重要な調査にはwebを使い分ける判断基準と、本番導入前に確認すべき検証手順を実務目線で解説します。2026年9月24日Build