GPU mieten bei Runpod: Was Pods und Serverless 2026 kosten
GPU mieten bei Runpod: Der Vergleich erklärt Pod-, Serverless- und Speicherkosten, rechnet H100-Szenarien durch und zeigt klar den Break-even.


Wer bei Runpod eine GPU mieten möchte, zahlt für eine H100 im Produktivbetrieb ab $2.89 pro Stunde auf einem Secure Cloud Pod oder $4.79 pro abrechenbarer Worker-Stunde mit Serverless – jeweils vor Speicherkosten. Serverless rechnet sich nur, solange Start, Ausführung, Wiederholungsversuche und Leerlauf zusammen unter 60.33% des Pod-Betriebsfensters bleiben. Oberhalb dieser Schwelle ist die dauerhaft belegte GPU günstiger.
GPU mieten mit Runpod: Preise auf einen Blick
Runpod ist nutzungsabhängig abgerechnete Infrastruktur und kein SaaS-Abo mit fester Monatsgebühr. In der Praxis geht es um drei Optionen: einen dedizierten Pod bezahlen, solange er läuft, Serverless-Worker nur für ihre Laufzeit abrechnen oder per Angebot Kapazität für eine dauerhafte Auslastung reservieren.
Die folgenden Preise wurden am 25. September 2026 anhand der Live-Preisseite von Runpod geprüft. Die Seite trägt das Datum 13. September 2026. Verfügbarkeit und endgültiger Preis für die gewählte GPU, Cloud-Stufe und Region richten sich weiterhin nach der Konsole.
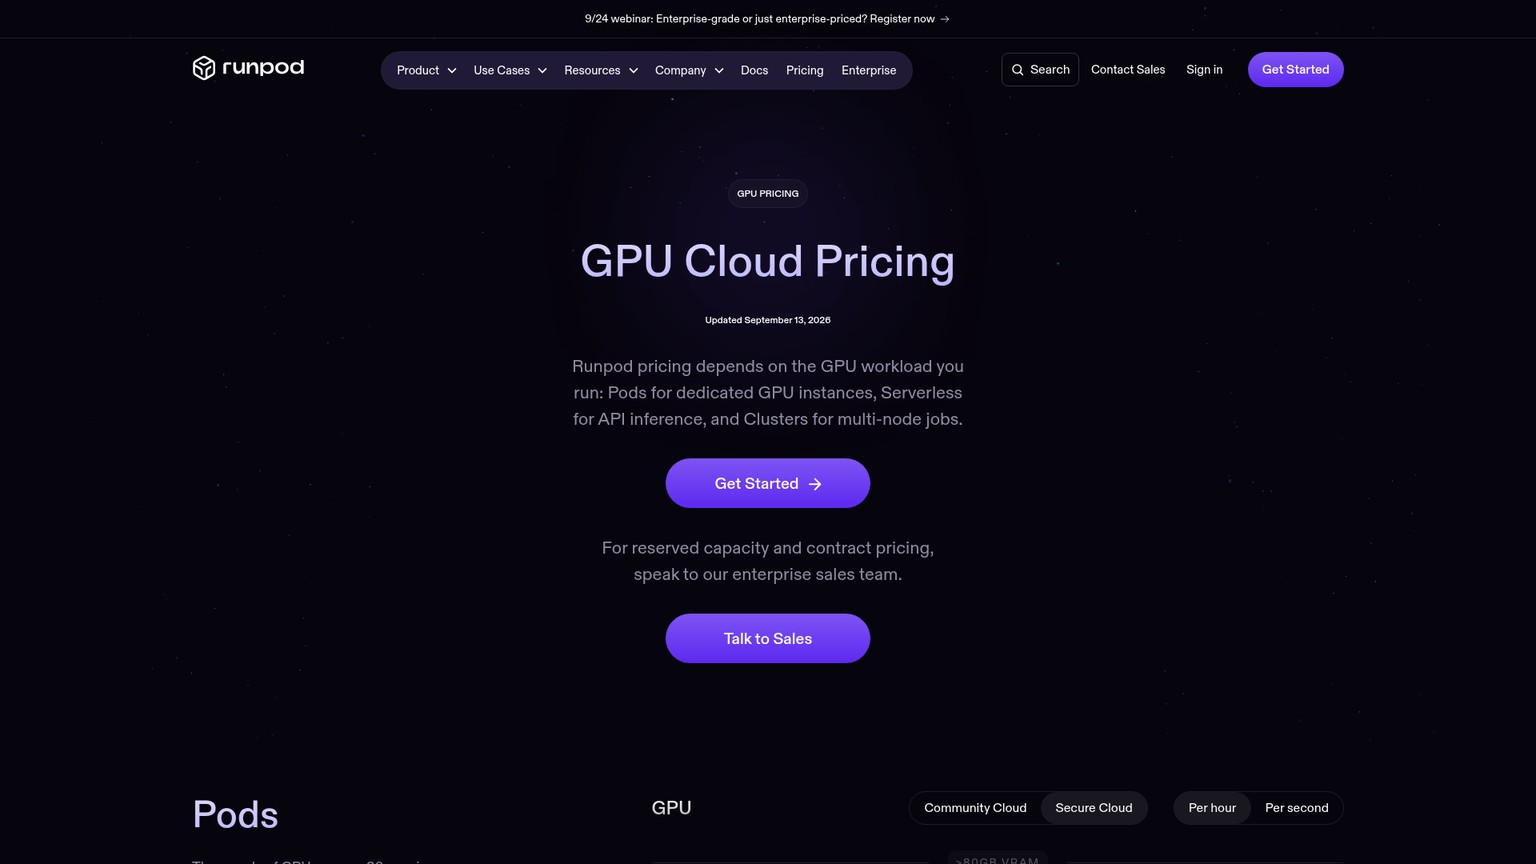
Bei Runpod gibt es keinen üblichen Umschalter zwischen Monats- und Jahresabo. Pods laufen auf Abruf, ein Pod Savings Plan wird für 3 oder 6 Monate im Voraus bezahlt und Reserved Clusters werden mit Laufzeiten von bis zu 12 Monaten und darüber hinaus angeboten, erfordern jedoch ein individuelles Angebot. Auch einen klassischen Aufschlag für Mehrverbrauch gibt es nicht: Rechenleistung und Speicher werden weiter erfasst, bis der Workload endet, das Guthaben aufgebraucht ist oder das standardmäßige kontoweite Ausgabenlimit von $80/hour greift. Laut Runpod kann der Support dieses Limit erhöhen.
Runpod GPU-Preise für Pods
Pod-Tarife spielen ihren Vorteil aus, wenn ein Modell lange und planbar auf der GPU verbleiben muss. Der Container bleibt unter eigener Kontrolle und die dedizierte GPU steht während der gesamten Pod-Laufzeit bereit. Dafür werden auch ruhige Minuten berechnet.
Der aktuelle Pod-Katalog nennt die folgenden Stundenpreise; abgerechnet wird in allen Fällen sekundengenau:
- 80GB und mehr: B300 $7.89, B200 $6.79, H200 $4.59, RTX Pro 6000 $2.09, H100 NVL $3.19, H100 PCIe $2.89, H100 SXM $3.49, A100 PCIe $1.59 und A100 SXM $1.59.
- 48GB: Pro 6000 MIG $1.09, L40S $1.09, RTX 6000 Ada $0.84, A40 $0.49, L40 $0.82 und RTX A6000 $0.53.
- 24GB bis 32GB: RTX 5090 $0.99, Pro 6000 MIG 24GB $0.59, L4 $0.49, RTX 3090 $0.50, RTX 4090 $0.74 und RTX A5000 $0.27.
Das sind Katalogpreise, keine Zusage, dass jede Karte an jedem Standort verfügbar ist. Vor der endgültigen Budgetplanung sollten GPU, Cloud-Stufe und Region in der Konsole ausgewählt werden.
Community Cloud oder Secure Cloud
Für den Produktivbetrieb ist Secure Cloud die Standardwahl. Runpod beschreibt das Angebot als Single-Tenant-Hardware in T3/T4-Rechenzentren und empfiehlt es für produktive Anwendungen oder regulierte Daten. Community Cloud greift auf geprüfte Kapazitäten von Drittanbietern zurück und eignet sich eher als günstiger Pool für Experimente und fortsetzbare Jobs.
Für H100 PCIe zeigt der Live-Vergleich zur H100 $1.99/hour in der Community Cloud und $2.89/hour in der Secure Cloud. Die Differenz von $0.90 spart über 100 GPU-Stunden $90, ist aber kein Rabatt ohne Gegenleistung. Bei einem kundenorientierten Agenten mit Verfügbarkeitsversprechen sollte nicht allein wegen $0.90 Ersparnis pro Stunde auf Secure Cloud verzichtet werden.
Eine Unstimmigkeit auf den Anbieterseiten ist dabei wichtig: Überschrift und Vergleichsblock der aktuellen H100-Seite stimmen mit der Hauptpreisseite überein und nennen $2.89/hour für Secure Cloud. In einem weiter unten stehenden FAQ derselben Seite sind jedoch noch $2.39/hour angegeben. Bis die Konsole etwas anderes ausweist, sollte mit $2.89 gerechnet werden.
Savings Plans sind die Laufzeitoption für einen Pod. Sie werden für 3 oder 6 Monate im Voraus bezahlt, decken ausschließlich die GPU-Rechenleistung ab, schließen Speicher aus, haben ein festes Ablaufdatum und sind nicht erstattungsfähig. Wird ein Pod gestoppt, lässt sich der Plan auf die nächste Bereitstellung desselben GPU-Typs übertragen. Für eine stabile Pod-Flotte ist das nützlich; für Teams, die noch zwischen Karten oder Lastprofilen wechseln, passt es schlecht.
Runpod Serverless: Worker-Zeit statt Requests bezahlen
Serverless ist nur dann günstiger als ein durchgehend aktiver Pod, wenn die Worker lange genug auf null skaliert sind. Abgerechnet wird die Laufzeit des Workers, nicht die Zahl erfolgreicher API-Aufrufe. Deshalb gehören Kaltstarts, das Laden des Modells, fehlgeschlagene Versuche und das Leerlauf-Timeout in die Kalkulation.
Runpod bietet zwei Worker-Typen:
- Flex Worker skalieren auf null und nutzen den veröffentlichten Sekundentarif.
- Active Worker laufen für gleichmäßigen Traffic und niedrige Latenz 24/7. In Runpods Abrechnungsdokumentation sind Rabatte über eine Vertriebsanfrage vorgesehen; ein fester Prozentsatz wird nicht zugesichert.
Für H100 Flex sollte weder mit $4.18/hour kalkuliert noch pauschal ein Rabatt von 30% für jeden Active Worker angesetzt werden. Der aktuelle H100-Flex-Tarif beträgt $4.79/hour, während der Active-Tarif vom individuellen Angebot abhängt. Ein veralteter fester Prozentsatz kann eine ungeeignete Architektur bereits vor dem ersten Request günstiger erscheinen lassen.
GPU-Tarife für Runpod Serverless
Der aktuelle Flex-Katalog umfasst 13 Preisklassen:
- Großer Speicher: B300 $9.98/hour, B200 $8.64, H200 $5.93, RTX 6000 Pro $3.49, H100 $4.79 und A100 $2.72.
- 48GB und 32GB: L40/L40S/6000 Ada/MIG 48GB $1.75, A6000/A40 $1.22, RTX 5090 $1.58 und RTX PRO 4500 Blackwell $1.15.
- 24GB und 16GB: RTX 4090 $1.10, L4/A5000/3090/MIG 24GB $0.69 und A4000/A4500/RTX 4000/RTX 2000 $0.58.
Die Klasse richtet sich nach der GPU des Workers, nicht nach dem Modellnamen oder dem einzelnen Request. Auch ein 24GB-Worker, der einen winzigen Request verarbeitet, kostet während seiner Laufzeit $0.69/hour. Und auch eine H100, auf der ein Request fehlschlägt, verbraucht die tatsächlich gelaufenen Sekunden.
Die abrechenbare Zeit besteht aus drei Phasen:
- Start: Container initialisieren und Modell in den GPU-Speicher laden.
- Ausführung: Request verarbeiten, einschließlich Arbeit, die später fehlschlägt.
- Leerlauf-Timeout: Worker nach Abschluss der Arbeit für einen möglichen Folge-Request aktiv halten. Der dokumentierte Standardwert beträgt 5 Sekunden.
Die Zahl der Worker vervielfacht alle drei Phasen. Jeder Worker, der das Modell lädt, verursacht vor der Ausführung seine eigene Startzeit. Autoscaling kann ungenutzte Kapazität einsparen, doch zu aggressives Skalieren kann die Startkosten über mehrere Worker hinweg wiederholen.
Runpod-Kostenrechnung: 100 Stunden, 730 Stunden und erfolgreiche Requests
Dieses Runpod-Kostenmodell ist reproduzierbar, aber keine Aussage über einen gemessenen Durchsatz. Vor einer Freigabe der Produktionskosten sollte jede Annahme durch gespeicherte Abrechnungs- und Request-Protokolle ersetzt werden.
Der datierte Basisfall setzt Folgendes voraus:
- GPU: eine NVIDIA H100.
- Pod: Secure Cloud H100 PCIe für $2.89/hour.
- Serverless: ein H100 Flex Worker für $4.79/hour.
- Region: Annahme USA; gerechnet wird mit dem globalen Katalogpreis, Bestand und Preis der gewählten Konsolenregion müssen geprüft werden.
- Speicher: ein Standard Network Volume mit 100GB für einen Monat zu $7.
- Request-Modell: 20 Startsekunden pro Trafficfenster, 2 Ausführungssekunden pro Versuch, das dokumentierte Leerlauf-Timeout von 5 Sekunden, 2% fehlgeschlagene Versuche und 100 erfolgreiche Requests pro Fenster.
- Pod-Basiswert für Requests: ein Produktiv-Pod, der über den gesamten Monat mit 730 Stunden aktiv bleibt und jederzeit antworten kann.
Die Request-Zeilen machen sichtbar, wie stark das Lastprofil das Ergebnis verändert. Sie behaupten nicht, dass eine H100 für das eigene Modell 2 Sekunden benötigt. Die Aussage lautet vielmehr: Wenn der Workload 2 Sekunden pro Versuch braucht und in Gruppen zu 100 eintrifft, dann kosten eintausend erfolgreiche Requests den ausgewiesenen Betrag.
Für 1,000 erfolgreiche Requests ergibt die Division durch eine Erfolgsquote von 98% nach dem Aufrunden 1,021 Versuche. Der Worker verbringt über 10 Fenster hinweg 200 Sekunden mit Starts, 2,042 Sekunden mit der Ausführung und 50 Sekunden im Leerlauf. Insgesamt sind das 2,292 abrechenbare Sekunden beziehungsweise $3.05 H100-Rechenkosten.
Für 10,000 erfolgreiche Requests ergibt dieselbe Methode 10,205 Versuche, 2,000 Startsekunden, 20,410 Ausführungssekunden und 500 Leerlaufsekunden. Insgesamt fallen 22,910 abrechenbare Sekunden beziehungsweise $30.48 Rechenkosten an.
Der Speicher wird separat abgerechnet. Mit dem Standard Network Volume von 100GB entstehen im Monat $10.05 beziehungsweise $37.48, wobei dieses Volume auch anderem Traffic dienen kann. Es sollte nicht in einem erfundenen Preis pro Request versteckt werden.
Sensitivität: Der Trafficrhythmus entscheidet
Ein schnelleres Basis-Image und ein wärmeres Lastprofil können die Rechenkosten senken. Bei 5 Startsekunden, 1 Ausführungssekunde, keinen Fehlschlägen, 5 Sekunden Leerlauf und 100 erfolgreichen Requests pro Fenster liegen die modellierten Rechenkosten bei $1.46 für 1,000 erfolgreiche Requests und $14.64 für 10,000.
Das Gegenmodell ist teuer: Trifft jeder Versuch erst nach dem Herunterskalieren auf null ein und löst jeweils einen eigenen Start von 20 Sekunden, 2 Sekunden Ausführung und 5 Sekunden Leerlauf aus, steigen die modellierten Rechenkosten auf $36.68 für 1,000 erfolgreiche Requests und $366.61 für 10,000.
Diese Spannweite zeigt, warum Requests als rohe Abrechnungseinheit ungeeignet sind. Aussagekräftig werden sie erst in Verbindung mit beobachteten Worker-Sekunden, Fehlerrate und Parallelität.
Der Break-even zwischen Pods und Serverless folgt den abrechenbaren Sekunden
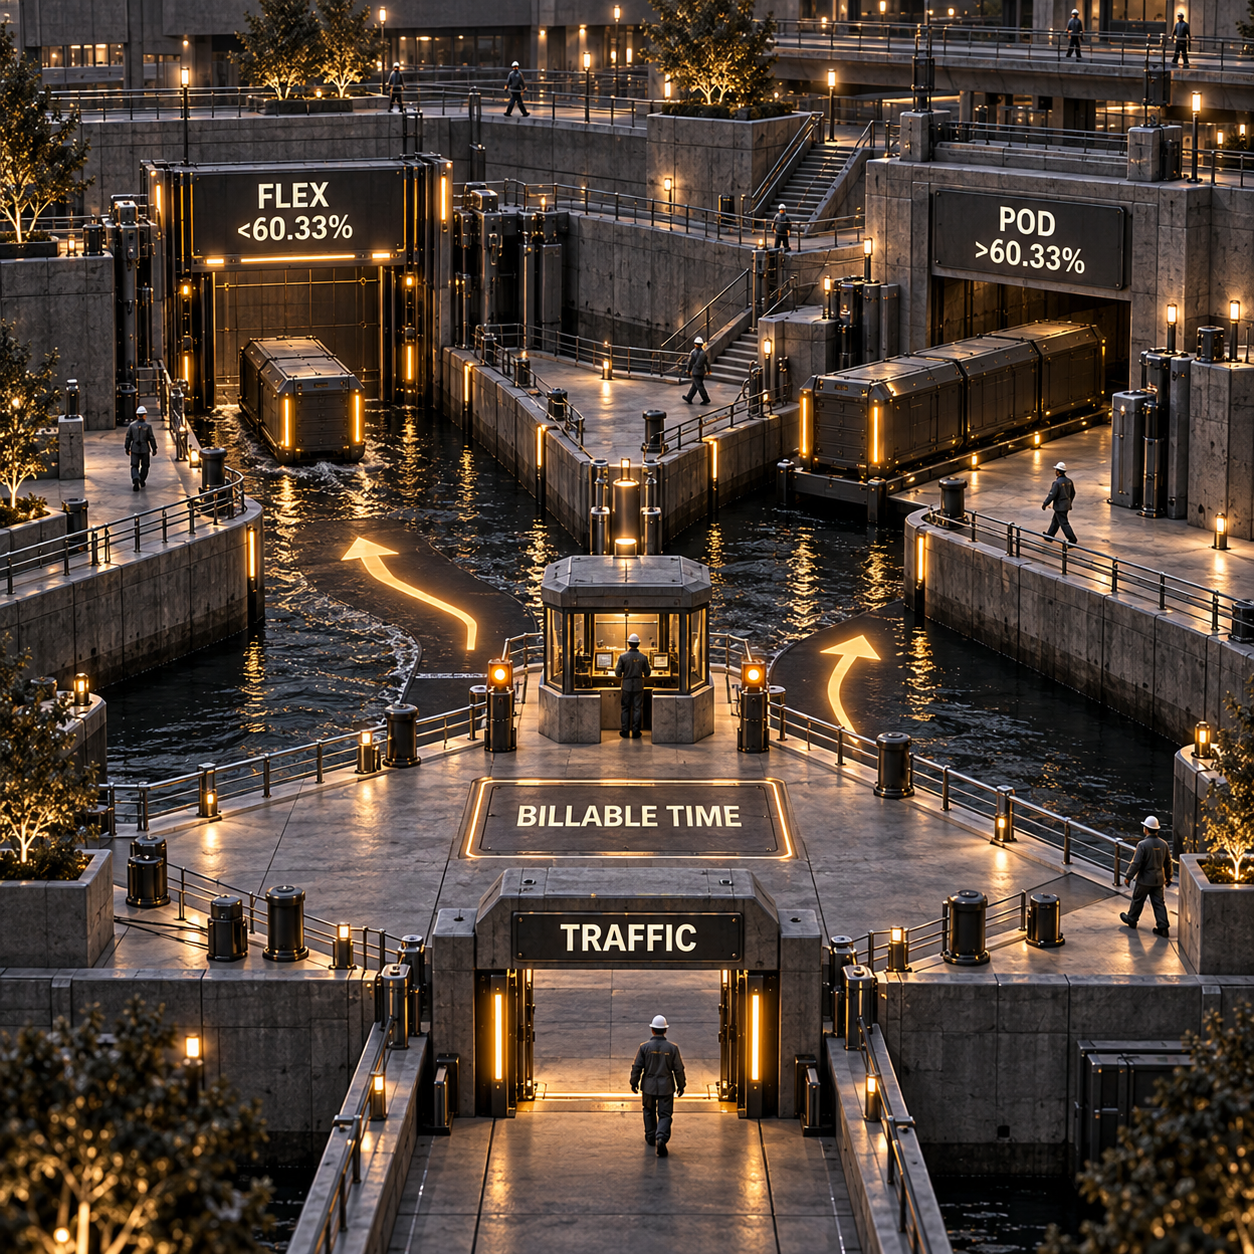
Der reine Rechenkosten-Break-even für die H100 im Basisfall ist exakt: Der Secure-Pod-Tarif von $2.89 wird durch den Serverless-Tarif von $4.79 geteilt. Das Ergebnis beträgt 60.33%.
Für jedes Beobachtungsfenster gilt:
Serverless wins when billable worker seconds < window seconds × 2.89 / 4.79.
In einem Servicefenster von 100 Stunden muss Serverless unter 60.33 abrechenbaren Worker-Stunden bleiben, um den Pod für $289 zu unterbieten. In einem Monat mit 730 Stunden muss Serverless unter 440.44 abrechenbaren Worker-Stunden bleiben, um die Pod-Kosten von $2,109.70 zu unterbieten. Identische Speicherkosten fallen aus dem Vergleich heraus; unterschiedliche Speicheroptionen nicht.
Community Cloud verändert die Rechnung, nicht das Risiko. Bei $1.99/hour für eine H100 PCIe liegt der reine Rechenkosten-Schnittpunkt gegenüber Serverless für $4.79 bei 41.54% beziehungsweise 303.28 abrechenbaren Stunden in einem Monat mit 730 Stunden. Diese niedrigere Schwelle ist für neu startbare Workloads relevant. Sie ist kein Grund, sensible Kundendaten auf Kapazitäten von Drittanbietern zu verlagern.
Ein Angebot für Active Worker kann die Schwelle erneut verschieben. Solange Runpod den Tarif nicht schriftlich nennt, lässt sich dafür keine seriöse Zahl einsetzen. Eine pauschale Annahme von 30% ist kein Angebot.
Runpod-Speicherpreise: Gestoppt bedeutet nicht kostenlos
Die Runpod-Dokumentation zum Pod-Speicher beschreibt drei typische Abrechnungsweisen. Wer sie verwechselt, kann mit einem gestoppten Pod eine höhere Speicherrechnung verursachen.
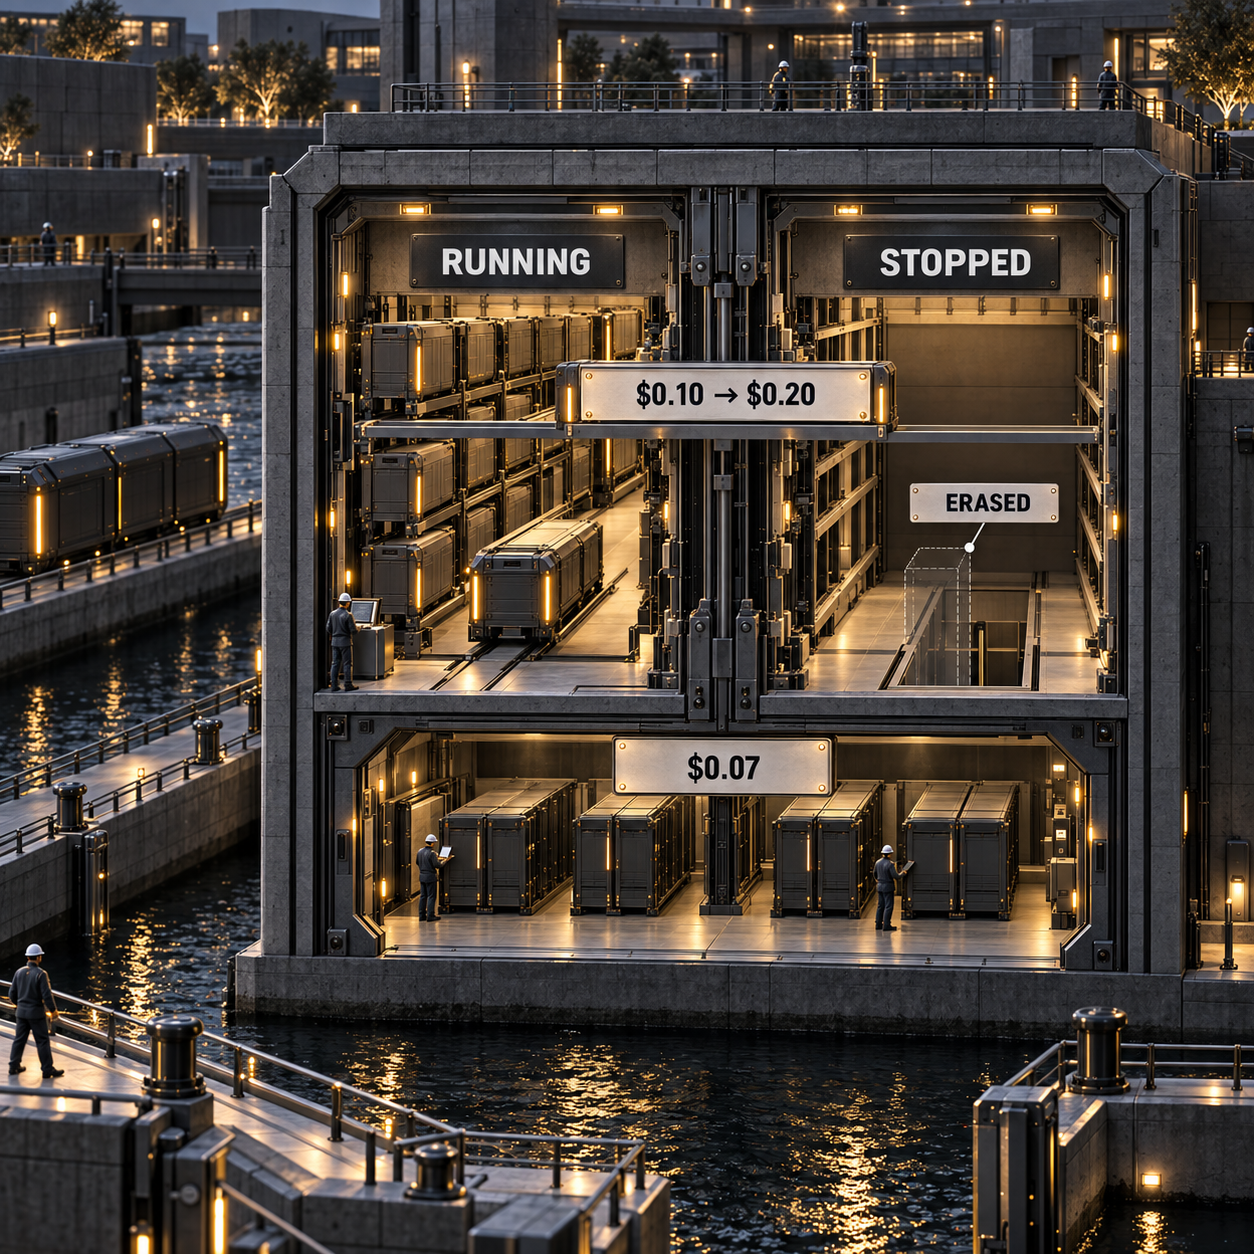
- Container Disk: $0.10/GB/month während des Betriebs. Im gestoppten Zustand fallen keine Kosten an, weil die Daten gelöscht werden.
- Volume Disk: $0.10/GB/month während des Betriebs und $0.20/GB/month im gestoppten Zustand. Ein aufbewahrtes Volume mit 100GB verteuert sich nach dem Stoppen damit von $10 auf $20 pro Monat.
- Standard Network Volume: $0.07/GB/month unter 1TB und $0.05/GB/month über 1TB – unabhängig davon, ob die Recheninstanz läuft oder gestoppt ist.
- High-Performance Network Storage: Die Hauptpreisseite nennt $0.14/GB/month, während laut Speicherdokumentation der genaue Tarif vom Rechenzentrum abhängt. Maßgeblich ist die Konsole.
Die Runpod-Speicherkosten beeinflussen auch die Platzierung. Network Volumes stehen Pods nur in der Secure Cloud zur Verfügung. Sie müssen bei der Bereitstellung ausgewählt werden und lassen sich später nicht anfügen oder trennen, ohne den Pod zu löschen. Bei Serverless ist ein Volume an ein Rechenzentrum gebunden, was die GPU-Verfügbarkeit einschränken kann. Mehrere Volumes können die Platzierung auffächern, werden laut Runpod aber nicht automatisch synchronisiert.
Für Modellgewichte, die elastische Worker gemeinsam nutzen, kann ein Network Volume wiederholte Downloads vermeiden. Für ein kurzlebiges Experiment kann eine Container Disk günstiger sein. Muss ein gestoppter Pod seinen lokalen Arbeitsbereich behalten, wird die Volume Disk zur teuren Überraschung.
Runpod-Alternativen: eine bezahlte H100-Stunde vergleichbar machen
Alternativen sollten zunächst anhand derselben bezahlten Beschleunigerzeit verglichen werden, bevor Plattformfunktionen in die Entscheidung einfließen. Bei 100 bezahlten H100-GPU-Stunden ergeben die aktuellen Anbietertarife folgende Rechenkosten:
- Runpod Secure Cloud Pod: $289 für H100 PCIe.
- Lambda: $329 für eine H100-PCIe-Instanz mit einer GPU. Die Instanzseite von Lambda weist für diese Konfiguration eine 1TiB SSD aus und nennt zusätzlich gegebenenfalls anfallende Sales Tax, VAT oder GST.
- Modal: $394.92 an H100-SXM5-GPU-Kosten bei $0.001097 pro Sekunde, vor den separat berechneten CPU- und Speicherkosten. Modal Starter enthält ein monatliches Gratisguthaben von $30.
- Runpod Serverless: $479, wenn alle 100 Worker-Stunden abrechenbar sind.
- AWS: $519.10 für einen H100 p5.4xlarge Capacity Block in US East, ausgehend von $5.191 pro Beschleunigerstunde. AWS berechnet die Reservierungsgebühr im Voraus; es handelt sich daher nicht um ein On-Demand-Äquivalent zu Serverless.
Diese Normierung ist bewusst eng gefasst. Modal nutzt H100 SXM5, die Tabellenwerte von Runpod und Lambda basieren auf H100 PCIe, und AWS verkauft einen zeitlich geplanten Capacity Block. Auch gebündelte CPU-, Arbeitsspeicher- und Speicherleistungen sowie Orchestrierung und Verfügbarkeit unterscheiden sich. Die Liste beantwortet die Frage nach dem Beschleunigertarif, ohne die Dienste als austauschbar darzustellen.
Runpod vs. Vast.ai
Ein fester Vergleich mit Vast.ai lässt sich nicht auf einen dauerhaft gültigen H100-Preis reduzieren. Vast.ai erklärt, dass sich die Marktplatzpreise mit Angebot und Nachfrage ändern, die Live-Tabelle stündlich aktualisiert wird, das günstigste mietbare Angebot als „from“-Preis gilt und zusätzlich ein Median ausgewiesen wird. Runpod veröffentlicht dagegen einen Katalogpreis und unterteilt seine Kapazitäten in Community und Secure.
Vast.ai passt, wenn Live-Angebote abgefragt, nach Zuverlässigkeit gefiltert und Workloads bei schwankendem Angebot verschoben werden können. Runpod passt, wenn ein stabiler veröffentlichter Preis, eine Secure-Stufe und der Weg vom Pod zu Serverless wichtiger sind als das punktuell günstigste Angebot.
Ist die eigentliche Alternative eine verwaltete Inferenz-API, gehört neben der GPU-Zeit auch der Betriebsaufwand in den Vergleich. Die Preisanalyse zu Together AI liefert einen nützlichen Gegenpol zur selbst betriebenen GPU.
Welche Option passt zu welchem Einsatz?
Secure Cloud Pods eignen sich für KI-Agenten mit Kundenkontakt oder Dienste zur Dokumentenverarbeitung, die eine GPU über weite Teile des Tages sinnvoll auslasten. Der Pod-Tarif ist niedriger, die Speicherplatzierung klarer und ein warmes Modell vermeidet wiederholte Starts. Die Schwachstelle ist ungenutzte Kapazität: Jede ruhige Minute kostet.
Serverless Flex passt zu Features mit langen Ruhephasen, kampagnenbedingten Lastspitzen, geplanten Batches oder unsicherem Traffic zum Marktstart. Das Modell kann auf null skalieren, doch Start-, Wiederholungs- und Leerlaufsekunden müssen unter dem Schnittpunkt bleiben. Problematisch wird wiederholt anfallende Worker-Laufzeit, vor allem wenn ein großes Modell langsam lädt oder Autoscaling zu aggressiv auffächert.
Active Worker sind erst sinnvoll, wenn Latenzanforderungen und gemessener Traffic ein Gespräch mit dem Vertrieb rechtfertigen. Sie laufen 24/7. Ohne schriftliches Angebot gibt es keinen verlässlichen Rabatt für die Kalkulation.
Community Cloud Pods sind für Experimente, Evaluierung und neu startbare Batch-Jobs gedacht. Für regulierte Daten oder einen Produktivendpunkt, dessen Verfügbarkeit Teil des Leistungsversprechens ist, sollten sie nicht eingesetzt werden.
Instant oder Reserved Clusters sind für echte Multi-GPU-Workloads vorgesehen, nicht als Standardupgrade für Inferenz. Instant Clusters veröffentlichen Preise für A100 und H200 und skalieren auf bis zu 64 GPUs; für mehrere andere GPU-Typen sowie sämtliche Laufzeiten von Reserved Clusters ist ein Vertriebsangebot erforderlich.
Vor der Hardwarewahl sollten das Modell und die Betriebsverantwortung geklärt sein. Der Leitfaden zu Open-Weight-Modellen für private Agenten hilft bei der Modellgröße, während verwaltete und selbst betriebene Coding-Agenten im Vergleich die betrieblichen Abwägungen einordnet.
- Sekundengenaue Abrechnung für Pods und Serverless, ohne Gebühren für Ingress oder Egress.
- Ein Weg von günstigen Pods über auf null skalierende Inferenz bis zu Multi-GPU-Clustern.
- Veröffentlichte Katalogpreise für Consumer-, Rechenzentrums- und Blackwell-GPUs.
- Secure- und Community-Kapazitäten ermöglichen unterschiedliche Risikobudgets für neu startbare und produktive Workloads.
- Dieselbe offizielle H100-Seite enthält im Secure-Cloud-FAQ einen veralteten Preis.
- Rabatte für Active Worker gibt es nur auf Anfrage; ein zentraler Produktivtarif lässt sich deshalb nicht öffentlich kalkulieren.
- Eine Volume Disk kostet bei gestopptem Pod doppelt so viel.
- Die Platzierung von Network Volumes kann die GPU-Verfügbarkeit für Serverless einschränken, und Volumes werden nicht automatisch synchronisiert.
- Verfügbarkeit und endgültige Regionalpreise müssen weiterhin in der Konsole geprüft werden.
Der nächste Schritt für Montag: Annahmen durch Daten aus einer repräsentativen Woche ersetzen.
Workload klar abgrenzen
Ein Modell, eine GPU-Klasse, eine Cloud-Stufe und eine Region festlegen. Keine Community H100 mit einer Secure H100 vergleichen und nicht den Durchsatz von H100 und A100 vermischen.
Jede abrechenbare Phase protokollieren
Zeitstempel für Worker-Start, Betriebsbereitschaft des Modells, Request-Start, Request-Ende und Worker-Stopp erfassen. Die Worker-Zahl und fehlgeschlagene Versuche gemeinsam mit erfolgreichen Requests dokumentieren.
Speicherzustände getrennt erfassen
Container-, Volume- und Netzwerkspeicher in GB auflisten. Laufende und gestoppte Zeiträume separat kalkulieren, statt sämtliche aufbewahrten Daten pauschal als „Speicher“ zu bezeichnen.
Schnittpunkt anwenden
Start-, Ausführungs-, Wiederholungs- und Leerlaufsekunden aller Worker addieren. Die Summe mit 60.33% des Secure-Pod-Fensters vergleichen und anschließend $2.89 sowie $4.79 durch die tatsächlich verfügbaren Konsolen- und Angebotspreise ersetzen.
FAQ zu Runpod-Preisen
Was ist günstiger als Runpod?
Vast.ai oder ein anderer Marktplatz kann ein niedrigeres Live-Angebot haben; außerdem liegt der aktuelle H100-GPU-Tarif von Modal unter einem vollständig abgerechneten H100-Serverless-Worker von Runpod. Auch Runpod Community Cloud kann Secure Cloud unterbieten. Ob die Gesamtrechnung wirklich günstiger ist, hängt jedoch von Worker-Leerlauf, Speicher, Zuverlässigkeit und enthaltenen Leistungen ab.
Lohnt sich Runpod?
Runpod lohnt sich, wenn ein eigener Container, ein eigenes Modell und eine eigene GPU mit sekundengenauer Abrechnung benötigt werden. Weniger passend ist es, wenn eine verwaltete Modell-API günstiger ist als der Eigenbetrieb von Images, Skalierung, Monitoring und Wiederholungslogik oder wenn bestehende Cloud-Bindungen wichtiger sind als der reine GPU-Preis.
Ist Runpod besser als AWS?
In diesem normierten Beispiel mit einer einzelnen H100 ist Runpod einfacher und günstiger: $2.89 pro Secure-Pod-Stunde gegenüber $5.191 pro H100-Beschleunigerstunde für einen AWS p5.4xlarge Capacity Block in US East. AWS kann trotzdem die bessere Systementscheidung sein, wenn der Workload auf dessen Netzwerk, Datendienste, Governance oder bereits zugesagte Ausgaben angewiesen ist.
Ist Runpod kostenlos?
Auf der Live-Preisseite ist kein allgemeines kostenloses Kontingent für Rechenleistung ausgewiesen. Das Konto wird aufgeladen und Ressourcen werden nach Verbrauch berechnet. Berechtigte Start-ups und einige Partnerprogramme können Guthaben erhalten; diese Programme sind jedoch an Voraussetzungen geknüpft und kein dauerhaftes Gratisangebot.
Wie teuer ist Runpod?
Im hier verwendeten aktuellen Pod-Katalog reicht die Spanne von $0.27/hour für RTX A5000 bis $7.89/hour für B300. Serverless reicht von $0.58/hour für die 16GB-Klasse bis $9.98/hour für B300. Hinzu kommen Speicher und das zeitliche Nutzungsmuster der Worker.
Wo lässt sich eine GPU am günstigsten mieten?
In der aktuell veröffentlichten Pod-Tabelle von Runpod hat RTX A5000 mit $0.27/hour den niedrigsten gelisteten Tarif. Auf einem Marktplatz kann vorübergehend ein günstigeres Angebot erscheinen, doch Verfügbarkeit, Zuverlässigkeit des Hosts, Bandbreite und Speicher können die scheinbare Ersparnis aufheben.
Kann sich das Mieten einer GPU rentieren?
Das ist möglich, lässt sich aber nicht allein am Mietpreis ablesen. Der Rohertrag pro erfolgreichem Ergebnis muss die Kosten für Rechenleistung, Speicher, fehlgeschlagene Versuche, Leerlaufkapazität, Monitoring und Entwicklung übersteigen. Die Kostenrechnung pro erfolgreichem Request sollte dafür mit den eigenen Umsätzen und Protokollen gefüllt werden.
Welche GPU ist derzeit am günstigsten?
Im Live-Katalog von Runpod ist RTX A5000 mit $0.27/hour aufgeführt. Welche GPU tatsächlich am günstigsten bereitgestellt werden kann, hängt jedoch vom aktuellen Bestand in der gewählten Stufe und Region ab. Das Angebot sollte unmittelbar vor dem Start in der Konsole bestätigt werden.
Was kostet es, eine NVIDIA GPU zu mieten?
Im hier verwendeten aktuellen Pod-Katalog von Runpod reicht die Spanne von $0.27 bis $7.89 pro GPU-Stunde. Eine Secure Cloud H100 PCIe kostet $2.89/hour, H100 Serverless dagegen $4.79 pro abrechenbarer Worker-Stunde.
Wie funktionieren kostenlose Runpod-Guthaben?
Laut Runpod Startup Program erhalten zugelassene Starter-Mitglieder einmalig $1,000 Guthaben. Growth-Mitglieder zahlen $50,000 im Voraus und erhalten einen Bonus von $25,000, insgesamt also $75,000 im Rahmen einer Vereinbarung über 12 Monate ohne erneute Aufladung des Guthabens.
Bietet Runpod einen Studierendenrabatt?
Auf den am 25. September 2026 geprüften Seiten zu Live-Preisen, Dokumentation und Startup Program war kein öffentliches Rabattangebot speziell für Studierende zu finden. Statt von einem Bildungstarif auszugehen, sollten Studierende mit den Self-Service-Preisen kalkulieren oder sich für ein passendes Guthabenprogramm bewerben.
Welche Erstattungsregeln gelten bei Runpod?
Laut den Geschäftsbedingungen von Runpod sind Servicegebühren grundsätzlich nicht erstattungsfähig; bei gekündigten Abonnements gibt es für die laufende Periode keine anteilige Rückzahlung. Auch Pod Savings Plans sind ausdrücklich von der Erstattung ausgeschlossen.
Haben sich die Runpod-Preise geändert?
Der aktuelle Preis für H100 Serverless beträgt $4.79/hour. In älteren veröffentlichten Inhalten stehen noch $4.18, und Runpods eigene Preistabelle vom 10. August nennt $4.55. In dieser Prüfung wurde jedoch kein offizielles Änderungsprotokoll mit einem genauen Gültigkeitsdatum gefunden. Maßgeblich ist der datierte Live-Tarif.
Checkliste für den KI-Workflow-Audit im Unternehmen und den Operator-Newsletter anfordern.
- Zuletzt aktualisiert
- 25. Sept. 2026
- Kategorie
- Build
Diese Seite in Google bevorzugen


Markieren Sie omidsaffari.com als bevorzugte Quelle, und Google hebt die Seite für Sie in Top Stories, AI Overviews und AI Mode hervor.

Vercel Sandbox Drives: Persistente Workspaces richtig nutzen
Vercel Sandbox Drives speichern Agenten-Workspaces über Neustarts hinweg. So funktionieren Mounts, Snapshots, Regionen, Kosten und der Ein-Writer-Zugriff.25. Sept. 2026Build
Firecrawl Alternative: 7 Tools im Kostenvergleich
Sieben Firecrawl-Alternativen im Vergleich: Kosten, Markdown- und JSON-Ausgabe, Migrationsaufwand und Preis je nutzbarer Seite für KI-Pipelines.25. Sept. 2026Build
CodeRabbit Alternative: 7 Tools für automatisierte Code-Reviews
Sieben CodeRabbit-Alternativen im Vergleich: Kosten, Git-Hosts, Datenschutz und Self-Hosting für Teams, die ihren KI-Code-Reviewer gezielt ersetzen.25. Sept. 2026Build
CodeRabbit Alternative: Wann Greptile die bessere Wahl ist
Greptile oder CodeRabbit? Der Vergleich zeigt Preise, Prüflimits, Git-Plattformen und reale Teamkosten – plus einen belastbaren Testplan vor dem Kauf.25. Sept. 2026Build
Perplexity Windows App: Portable Computer lokal nutzen
Portable Computer in der Perplexity Windows App einrichten: AMD-PC prüfen, Dateiaufgaben lokal testen und Kosten sowie Cloud-Freigaben kontrollieren.25. Sept. 2026Build
AgentRun im Test: KI-Workflow-Automatisierung mit klaren Grenzen
AgentRun im Praxistest: Wie der TypeScript-Interpreter KI-Workflows strukturiert, Agentenaufrufe begrenzt – und wann eine einfache Funktion besser ist.24. Sept. 2026Build
Perplexity Suchmaschine: Fast Search oder Web?
Perplexity Suchmaschine im Vergleich: Fast Search oder Web? Preise, Tempo, Quellenabdeckung und die passende API-Einstellung für KI-Agenten.24. Sept. 2026Build