Runpod pricing: guia de custos de Pods e Serverless em 2026
Veja quanto custa a Runpod, compare Pods e Serverless, entenda o ponto de equilíbrio e estime gastos com GPU, armazenamento e requisições na prática.


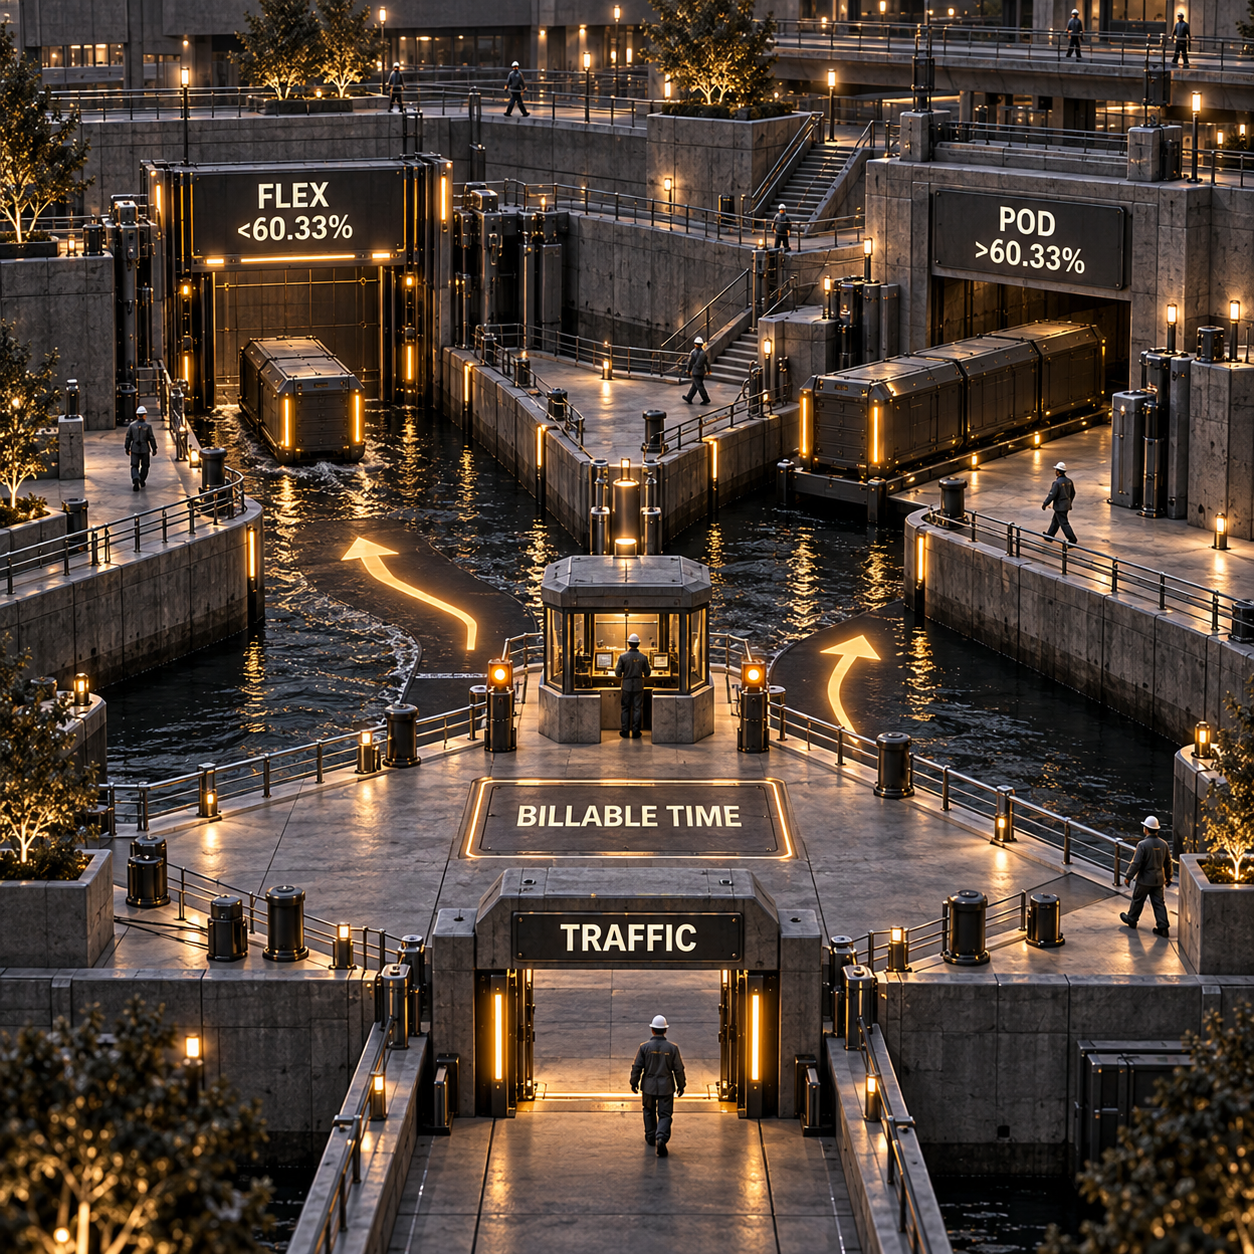
Na Runpod, o Runpod pricing para uma H100 de produção começa em $2.89 por hora em um Secure Cloud Pod ou $4.79 por hora faturável de worker no Serverless, antes do armazenamento. O Serverless só leva vantagem enquanto a soma de inicialização, execução, novas tentativas e tempo ocioso ficar abaixo de 60.33% da janela em que o Pod permaneceria ligado; acima disso, vale manter a GPU.
Runpod pricing: preços em resumo
A Runpod oferece infraestrutura cobrada por uso, não um plano SaaS mensal. Na prática, a escolha é entre pagar por um Pod dedicado durante todo o período em que ele estiver ligado, pagar pelos workers Serverless apenas enquanto estiverem ativos ou contratar capacidade sob cotação para uma carga contínua.
Os preços abaixo foram conferidos na página de preços da Runpod em 25 de setembro de 2026. A página traz a data de 13 de setembro de 2026. A disponibilidade e o valor final para cada GPU, modalidade de nuvem e região ainda são definidos pelo console.
A Runpod não oferece o botão convencional para alternar entre cobrança mensal e anual. Pods são sob demanda, o Pod Savings Plan antecipa o pagamento de 3 ou 6 meses, e os Reserved Clusters divulgam prazos de até 12 meses ou mais, mas exigem cotação. Também não existe uma linha tradicional de excedente: computação e armazenamento continuam sendo medidos até que a carga pare, o saldo chegue a zero ou entre em ação o limite padrão de gastos da conta, de $80/hora. Segundo a Runpod, o suporte pode aumentar esse limite.
Preços de GPU da Runpod para Pods
As tarifas de Pod favorecem instâncias dedicadas quando o modelo precisa permanecer na GPU por períodos longos e previsíveis. Você controla o contêiner e mantém uma GPU dedicada enquanto o Pod está ligado; em contrapartida, os minutos sem atividade também entram na conta.
O catálogo atual de Pods publica estas tarifas por hora, todas cobradas por segundo:
- 80GB ou mais: B300 $7.89, B200 $6.79, H200 $4.59, RTX Pro 6000 $2.09, H100 NVL $3.19, H100 PCIe $2.89, H100 SXM $3.49, A100 PCIe $1.59 e A100 SXM $1.59.
- 48GB: Pro 6000 MIG $1.09, L40S $1.09, RTX 6000 Ada $0.84, A40 $0.49, L40 $0.82 e RTX A6000 $0.53.
- 24GB a 32GB: RTX 5090 $0.99, Pro 6000 MIG 24GB $0.59, L4 $0.49, RTX 3090 $0.50, RTX 4090 $0.74 e RTX A5000 $0.27.
Esses são preços de catálogo, não uma garantia de que cada placa estará disponível em todos os locais. Antes de fechar o orçamento, selecione GPU, modalidade de nuvem e região no console.
Community Cloud ou Secure Cloud
Secure Cloud é a opção padrão para produção. A Runpod a descreve como hardware single-tenant em data centers T3/T4 e a recomenda para produção ou dados regulados. Já a Community Cloud reúne capacidade de terceiros previamente avaliados e funciona melhor como um pool mais barato para experimentos e tarefas que podem ser retomadas.
Para a H100 PCIe, o comparativo atual da H100 mostra $1.99/hora na Community Cloud e $2.89/hora na Secure Cloud. A diferença de $0.90 economiza $90 ao longo de 100 horas de GPU, mas não é um desconto sem contrapartida. Um agente voltado ao cliente e com compromisso de entrega não deve abrir mão da modalidade de produção apenas para poupar $0.90 por hora.
Há uma inconsistência na página do fornecedor que merece atenção. O título e o quadro comparativo da página atual da H100 coincidem com a página principal de preços e indicam $2.89/hora para Secure Cloud, mas uma FAQ mais abaixo na mesma página ainda informa $2.39/hora. Considere $2.89 até que o console mostre outro valor.
Os Savings Plans são a modalidade de compromisso para Pods. Eles exigem pagamento antecipado de 3 ou 6 meses, cobrem apenas a computação da GPU, não incluem armazenamento, têm datas fixas de vencimento e não são reembolsáveis. Se um Pod for interrompido, o plano pode ser transferido para a próxima implantação do mesmo tipo de GPU. Isso ajuda uma frota estável, mas não combina com uma equipe que ainda muda de placa ou cujo padrão de tráfego continua variando.
Runpod Serverless: pague pelo tempo do worker, não por requisição
O Serverless só custa menos que um Pod sempre ligado quando os workers passam tempo suficiente em escala zero. A fatura acompanha a vida útil do worker, não as chamadas de API concluídas com sucesso. Por isso, cold starts, carregamento do modelo, tentativas com falha e timeout de ociosidade precisam entrar no orçamento.
A Runpod oferece dois tipos de worker:
- Workers Flex reduzem a escala a zero e usam a tarifa publicada por segundo.
- Workers Active permanecem ligados 24/7 para manter tráfego constante e baixa latência. A documentação de cobrança da Runpod diz que há descontos disponíveis mediante consulta comercial, sem prometer um percentual fixo.
Não projete o H100 Flex a $4.18/hora nem presuma que todo worker Active receba 30% de desconto. A tarifa atual do H100 Flex é de $4.79/hora, e o preço Active depende da cotação. Um percentual fixo antigo pode fazer a arquitetura errada parecer mais barata antes mesmo da primeira requisição.
Tabela de preços de GPU do Runpod Serverless
O catálogo atual do Flex tem 13 faixas de preço:
- Memória alta: B300 $9.98/hora, B200 $8.64, H200 $5.93, RTX 6000 Pro $3.49, H100 $4.79 e A100 $2.72.
- 48GB e 32GB: L40/L40S/6000 Ada/MIG 48GB $1.75, A6000/A40 $1.22, RTX 5090 $1.58 e RTX PRO 4500 Blackwell $1.15.
- 24GB e 16GB: RTX 4090 $1.10, L4/A5000/3090/MIG 24GB $0.69 e A4000/A4500/RTX 4000/RTX 2000 $0.58.
A faixa é determinada pela GPU do worker, não pelo nome do modelo ou pela requisição. Um worker de 24GB que atende uma chamada pequena continua sendo um worker de $0.69/hora enquanto estiver ativo. Uma H100 que processa uma requisição com falha continua consumindo os segundos em que operou.
O relógio de cobrança tem três partes:
- Inicialização: iniciar o contêiner e carregar o modelo na memória da GPU.
- Execução: processar a requisição, inclusive o trabalho que posteriormente falhar.
- Timeout de ociosidade: manter o worker ativo depois da conclusão para aguardar uma possível nova requisição. O padrão documentado é de 5 segundos.
O número de workers multiplica as três fases. Cada worker que carrega o modelo acrescenta seu próprio tempo de inicialização antes da execução. O autoscaling pode economizar capacidade ociosa, mas uma expansão agressiva também pode repetir o custo de inicialização em vários workers.
Planilha de custos da Runpod: 100 horas, 730 horas e requisições bem-sucedidas
Este modelo de custos da Runpod é reproduzível, não uma afirmação sobre throughput medido. Antes de aprovar os gastos de produção, substitua cada premissa pelos logs salvos de cobrança e requisições.
O caso-base com data definida considera:
- GPU: uma NVIDIA H100.
- Pod: H100 PCIe na Secure Cloud a $2.89/hora.
- Serverless: um worker H100 Flex a $4.79/hora.
- Região: premissa de US; foi usada a tarifa do catálogo global, e a região escolhida no console precisa ser conferida quanto a estoque e preço.
- Armazenamento: um volume de rede padrão de 100GB mantido por um mês a $7.
- Modelo de requisições: 20 segundos de inicialização por janela de tráfego, 2 segundos de execução por tentativa, timeout de ociosidade documentado de 5 segundos, 2% de tentativas com falha e 100 requisições bem-sucedidas por janela.
- Referência de requisições do Pod: um Pod de produção mantido ligado ao longo do mês de 730 horas para poder responder a qualquer momento.
As linhas de requisições deixam claro o efeito do formato do tráfego. Elas não afirmam que uma H100 precisa de 2 segundos para o seu modelo. O que dizem é: se a carga exigir 2 segundos por tentativa e chegar em grupos de 100, então mil requisições bem-sucedidas terão esse custo.
Para 1,000 sucessos, divida por 98% de sucesso e arredonde para cima: são 1,021 tentativas. O worker passa 200 segundos inicializando ao longo de 10 janelas, 2,042 segundos executando e 50 segundos ocioso. Total: 2,292 segundos faturáveis, ou $3.05 de computação na H100.
Para 10,000 sucessos, o mesmo método resulta em 10,205 tentativas, 2,000 segundos de inicialização, 20,410 segundos de execução e 500 segundos de ociosidade. Total: 22,910 segundos faturáveis, ou $30.48 de computação.
O armazenamento continua separado. Somar o volume de rede padrão de 100GB resulta em $10.05 e $37.48 no mês, mas esse volume também pode atender a outro tráfego. Não o esconda dentro de uma tarifa inventada por requisição.
Sensibilidade: a cadência do tráfego muda o resultado
Uma imagem-base mais rápida e um padrão de tráfego mais aquecido podem reduzir o custo de computação. Com 5 segundos de inicialização, 1 segundo de execução, nenhuma falha, um período ocioso de 5 segundos e 100 sucessos por janela, a computação estimada é de $1.46 para 1,000 sucessos e $14.64 para 10,000.
O padrão oposto sai caro. Se cada tentativa chegar depois da escala zero e provocar seus próprios 20 segundos de inicialização, 2 segundos de execução e 5 segundos ociosos, a estimativa de computação sobe para $36.68 por 1,000 sucessos e $366.61 por 10,000.
Essa amplitude explica por que o número bruto de requisições é uma unidade de cobrança inadequada. Ele só se torna útil quando associado aos segundos efetivos de worker, à taxa de falhas e à concorrência.
O ponto de equilíbrio entre Pods e Serverless está nos segundos faturáveis
O ponto de equilíbrio apenas da computação para a H100 do caso-base é exato: divida a tarifa de $2.89 do Secure Pod pela tarifa de $4.79 do Serverless. O resultado é 60.33%.
Para qualquer janela de observação:
Serverless wins when billable worker seconds < window seconds × 2.89 / 4.79.
Em uma janela de serviço de 100 horas, o Serverless precisa ficar abaixo de 60.33 horas faturáveis de worker para superar o Pod de $289. Em um mês de 730 horas, deve permanecer abaixo de 440.44 horas faturáveis de worker para custar menos que $2,109.70. Quando o armazenamento é idêntico, ele se anula na comparação; escolhas diferentes de armazenamento, não.
A Community Cloud altera a conta, não o risco. A $1.99/hora para uma H100 PCIe, seu ponto de equilíbrio somente de computação contra o Serverless de $4.79 é de 41.54%, ou 303.28 horas faturáveis em um mês de 730 horas. Esse limite mais baixo importa para tarefas que podem ser retomadas. Não é motivo para mover tráfego sensível de clientes para capacidade de terceiros.
Uma cotação de worker Active pode mudar esse limite novamente. Até que a Runpod informe o preço por escrito, não existe um número honesto para usar. Presumir 30% fixos não equivale a uma cotação.
Preços de armazenamento da Runpod: parar não significa deixar de pagar
A documentação de armazenamento para Pods da Runpod descreve três comportamentos padrão. Confundi-los pode fazer um Pod parado gerar uma conta de armazenamento ainda maior.
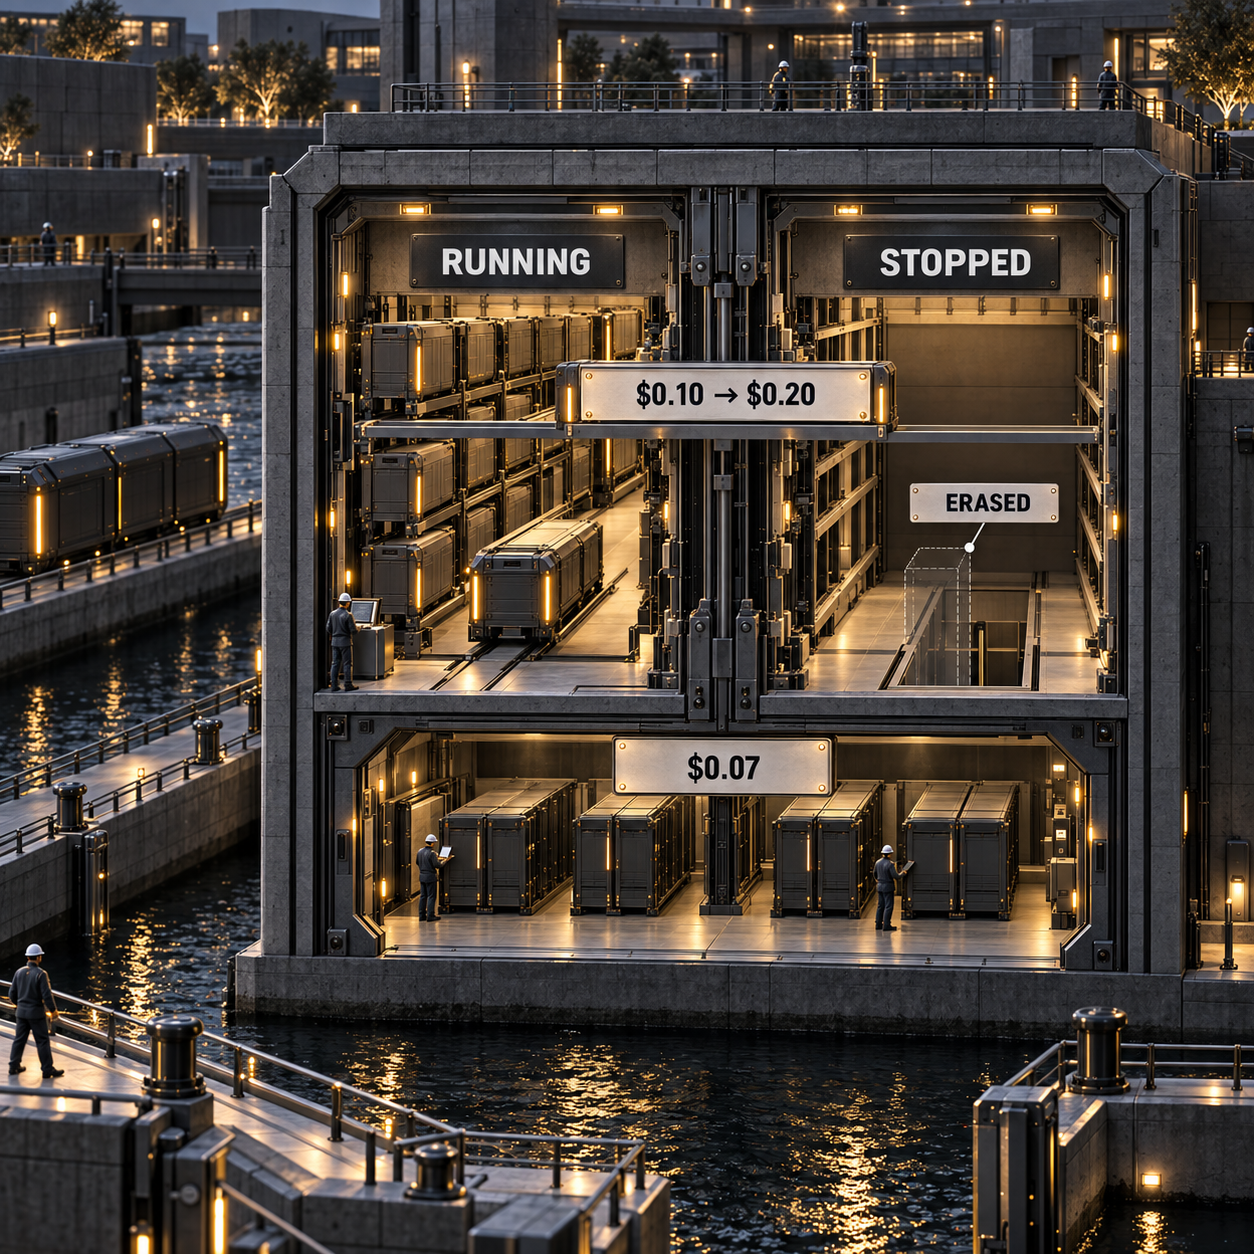
- Disco do contêiner: $0.10/GB/mês enquanto estiver em execução. Não há cobrança quando o Pod para, pois os dados são apagados.
- Disco de volume: $0.10/GB/mês em execução e $0.20/GB/mês quando parado. Portanto, um volume retido de 100GB passa de $10 para $20 por mês depois que o Pod é interrompido.
- Volume de rede padrão: $0.07/GB/mês abaixo de 1TB e $0.05/GB/mês acima de 1TB, esteja a computação ativa ou parada.
- Armazenamento de rede de alta performance: a página principal de preços lista $0.14/GB/mês, enquanto a documentação de armazenamento afirma que o valor exato varia por data center. Considere o console como fonte final.
O custo de armazenamento da Runpod também influencia a alocação. Os volumes de rede estão disponíveis para Pods apenas na Secure Cloud. Eles precisam ser escolhidos durante a implantação e não podem ser anexados ou removidos depois sem excluir o Pod. No Serverless, o volume fica vinculado a um data center, o que pode reduzir a disponibilidade de GPUs. Vários volumes podem ampliar as opções de alocação, mas a Runpod informa que eles não são sincronizados automaticamente.
Para pesos de modelos compartilhados por workers elásticos, um volume de rede pode evitar downloads repetidos. Em um experimento descartável, o disco do contêiner pode sair mais barato. Se um Pod parado precisar preservar o workspace local, o disco de volume será a surpresa cara.
Alternativas à Runpod: normalize uma hora paga de H100
Antes de colocar os recursos das plataformas na decisão, compare as alternativas pelo mesmo tempo pago de acelerador. Para 100 horas pagas de GPU H100, as tarifas atuais dos fornecedores resultam nestes custos de computação:
- Runpod Secure Cloud Pod: $289 pela H100 PCIe.
- Lambda: $329 por uma instância H100 PCIe com uma GPU. A página de instâncias da Lambda inclui SSD de 1TiB nessa configuração e informa que impostos sobre vendas, VAT ou GST aplicáveis são cobrados à parte.
- Modal: $394.92 em cobrança de GPU H100 SXM5, a $0.001097 por segundo, antes das cobranças separadas de CPU e memória. O Modal Starter inclui $30 por mês em créditos gratuitos.
- Runpod Serverless: $479 se todas as 100 horas de worker forem faturáveis.
- AWS: $519.10 por um Capacity Block H100 p5.4xlarge em US East, com base em $5.191 por hora de acelerador. A AWS cobra a reserva antecipadamente, portanto essa não é uma alternativa Serverless sob demanda.
Essa normalização é propositalmente restrita. A Modal usa H100 SXM5; as linhas da Runpod e da Lambda usam H100 PCIe; a AWS vende um Capacity Block agendado; e CPU, memória, armazenamento, orquestração e disponibilidade incluídos variam. A lista responde à pergunta sobre a tarifa do acelerador sem fingir que os serviços são intercambiáveis.
Runpod vs. Vast.ai
Uma comparação fixa com a Vast.ai não pode ser resumida a um único preço duradouro para H100. A Vast.ai afirma que os valores do marketplace mudam conforme oferta e demanda, atualiza a tabela ao vivo a cada hora, chama a oferta disponível mais barata de tarifa “a partir de” e publica uma mediana separada. A Runpod divulga preços de catálogo e separa a capacidade entre as modalidades Community e Secure.
Escolha a Vast.ai se for possível consultar ofertas ao vivo, filtrar confiabilidade e mover a carga quando a oferta mudar. Prefira a Runpod quando uma tarifa publicada estável, uma modalidade Secure e o caminho de Pod para Serverless forem mais importantes do que encontrar o menor anúncio em um determinado momento.
Se a alternativa real for uma API de inferência gerenciada, compare também o trabalho operacional, não apenas o tempo de GPU. A análise de preços da Together AI serve como contraponto útil à conta de uma GPU autogerenciada.
Qual opção escolher em cada cenário
Escolha Secure Cloud Pods para um agente de IA voltado ao cliente ou um serviço de processamento de documentos que mantenha uma GPU útil durante a maior parte do dia. A tarifa do Pod é menor, a alocação do armazenamento é mais clara e um modelo aquecido evita novas inicializações. O ponto fraco é a capacidade ociosa: cada minuto de silêncio é cobrado.
Escolha Serverless Flex para um recurso com longos períodos sem atividade, campanhas em picos, lotes agendados ou tráfego de lançamento incerto. Ele pode reduzir a escala a zero, mas os segundos de inicialização, novas tentativas e ociosidade precisam ficar abaixo do ponto de equilíbrio. O ponto fraco é repetir o ciclo de vida do worker, especialmente quando um modelo grande demora para carregar ou o autoscaling se espalha de forma agressiva.
Escolha workers Active somente depois que os requisitos de latência e o tráfego medido justificarem uma conversa comercial. Eles permanecem ligados 24/7. Sem cotação por escrito, não há desconto confiável para incluir no modelo.
Escolha Community Cloud Pods para experimentos, avaliação e processamento em lote que possa ser reiniciado. Evite-os para dados regulados ou um endpoint de produção cuja disponibilidade faça parte da promessa do produto.
Escolha Instant ou Reserved Clusters quando a carga realmente exigir várias GPUs, e não como upgrade padrão de inferência. Instant Clusters publicam preços para A100 e H200 e escalam até 64 GPUs; vários outros tipos de GPU e todos os prazos de Reserved Cluster exigem contato comercial.
Antes de escolher o hardware, defina o modelo e a decisão de propriedade. O guia de modelos abertos para agentes privados ajuda a dimensionar o modelo, enquanto o comparativo entre agentes de programação gerenciados e autogerenciados enquadra o custo operacional.
- Cobrança por segundo em Pods e Serverless, sem tarifa de entrada ou saída de dados.
- Um caminho que vai de Pods econômicos à inferência com escala zero e a clusters multi-GPU.
- Tarifas de catálogo publicadas para GPUs de consumo, data center e Blackwell.
- As capacidades Secure e Community permitem aplicar orçamentos de risco diferentes a tarefas reiniciáveis e cargas de produção.
- A mesma página oficial da H100 contém um preço desatualizado de Secure Cloud na FAQ.
- Os descontos para workers Active são fornecidos apenas por cotação; por isso, uma tarifa central de produção não pode ser modelada publicamente.
- O disco de volume custa o dobro quando um Pod está parado.
- A alocação de volumes de rede pode restringir a disponibilidade de GPUs no Serverless, e os volumes não são sincronizados automaticamente.
- Disponibilidade e preço regional final ainda precisam ser verificados no console.
Sua tarefa para segunda-feira é trocar as premissas por evidências de uma semana representativa.
Defina os limites da carga
Escolha um modelo, uma classe de GPU, uma modalidade de nuvem e uma região. Não compare uma H100 Community com uma H100 Secure nem misture throughput de H100 e A100.
Registre cada fase faturável
Capture os horários de início do worker, modelo pronto, início da requisição, fim da requisição e parada do worker. Registre o número de workers e as tentativas com falha ao lado das requisições bem-sucedidas.
Separe os estados de armazenamento
Liste, em GB, o armazenamento de contêiner, volume e rede. Calcule separadamente os períodos em execução e parado, em vez de chamar todos os dados retidos apenas de “armazenamento”.
Aplique o ponto de equilíbrio
Some os segundos de inicialização, execução, novas tentativas e ociosidade dos workers. Compare o total com 60.33% da janela do Secure Pod; depois, substitua $2.89 e $4.79 pelos valores do console e das cotações que você realmente puder contratar.
FAQ sobre preços da Runpod
O que custa menos que a Runpod?
A Vast.ai ou outro marketplace pode exibir uma oferta ao vivo mais barata, e a cobrança atual de GPU H100 da Modal é menor do que a do H100 Serverless da Runpod quando totalmente faturado. A Runpod Community Cloud também pode custar menos que a Secure Cloud. Ainda assim, a conta final depende do tempo ocioso do worker, do armazenamento, da confiabilidade e do que está incluído no serviço.
A Runpod vale a pena?
A Runpod vale a pena quando você precisa do próprio contêiner, modelo e GPU com cobrança por segundo. Não é a melhor escolha quando uma API de modelo gerenciada custa menos do que operar imagens, escalabilidade, monitoramento e novas tentativas por conta própria, ou quando compromissos existentes com outro provedor de nuvem pesam mais que o preço de tabela da GPU.
A Runpod é melhor que a AWS?
Neste exemplo normalizado com uma única H100, a Runpod é mais simples e barata: $2.89 por hora de Secure Pod, contra $5.191 por hora de acelerador H100 em um Capacity Block p5.4xlarge da AWS em US East. A AWS ainda pode ser a melhor escolha de sistema quando a carga depende de sua rede, serviços de dados, governança ou gastos já comprometidos.
A Runpod é grátis?
A página de preços ao vivo não mostra uma camada geral de computação gratuita. Você adiciona saldo e paga pelos recursos medidos. Startups elegíveis e alguns programas de parceiros podem receber créditos, mas são programas condicionais, não um plano gratuito permanente.
Quanto custa a Runpod?
O catálogo de Pods publicado e usado aqui vai de $0.27/hora para RTX A5000 a $7.89/hora para B300. O Serverless varia de $0.58/hora na classe de 16GB a $9.98/hora para B300. Armazenamento e padrão de tempo dos workers são cobrados além disso.
Qual é a opção mais barata para aluguel de GPU?
Na tabela atual de Pods publicada pela Runpod, a RTX A5000 tem a menor tarifa listada, de $0.27/hora. Um marketplace pode mostrar uma oferta temporária ainda menor, mas disponibilidade, confiabilidade do host, banda e armazenamento podem anular a economia aparente.
Alugar uma GPU é lucrativo?
Pode ser, mas a tarifa de aluguel não basta para responder. A margem bruta por resultado bem-sucedido precisa superar computação, armazenamento, tentativas com falha, capacidade ociosa, monitoramento e engenharia. Use a planilha de requisições bem-sucedidas com a receita e os logs observados no seu caso.
Qual é a GPU mais barata disponível agora?
O catálogo ao vivo da Runpod lista a RTX A5000 por $0.27/hora, mas a GPU implantável mais barata depende do estoque atual na modalidade e região selecionadas. Confirme a oferta no console imediatamente antes de iniciar.
Quanto custa alugar uma GPU NVIDIA?
No catálogo atual de Pods da Runpod, a faixa usada aqui vai de $0.27 a $7.89 por hora de GPU. Uma H100 PCIe na Secure Cloud custa $2.89/hora, enquanto a H100 Serverless custa $4.79 por hora faturável de worker.
Como funcionam os créditos gratuitos da Runpod?
O Runpod Startup Program informa que membros Starter aceitos recebem $1,000 em créditos concedidos uma única vez. Membros Growth assumem um compromisso antecipado de $50,000 e recebem um bônus de $25,000 para chegar a $75,000 em um contrato de 12 meses sem recarga de créditos.
A Runpod oferece desconto para estudantes?
Nenhum desconto público específico para estudantes apareceu nas páginas de preços, documentação ou Startup Program consultadas em 25 de setembro de 2026. Estudantes devem considerar as tarifas de autosserviço ou se inscrever em um programa de créditos elegível, em vez de presumir que exista um preço educacional.
Qual é a política de reembolso da Runpod?
Os termos da Runpod dizem que as tarifas de serviço geralmente não são reembolsáveis e que assinaturas canceladas não recebem reembolso proporcional pelo período vigente. Os Pod Savings Plans também são explicitamente não reembolsáveis.
Os preços da Runpod mudaram?
O preço atual do H100 Serverless é de $4.79/hora. Materiais publicados anteriormente ainda mostram $4.18, e a tabela da própria Runpod de 10 de agosto mostra $4.55, mas nenhum histórico oficial encontrado nesta verificação indica uma data exata para a mudança. Use a tarifa ao vivo com data definida.
Receba o checklist de auditoria de workflows de IA para empresas e a newsletter para operadores.
- Última atualização
- 25 de set. de 2026
- Categoria
- Build
Prefira este site no Google


Marque omidsaffari.com como fonte preferida e o Google destaca o site para você em Top Stories, AI Overviews e AI Mode.

Vercel Sandbox: como usar Drives persistentes
Aprenda a criar e montar um Drive no Vercel Sandbox, preservar o workspace entre execuções e lidar com limites de escrita, snapshots e região.25 de set. de 2026Build
7 ferramentas de web scraping para substituir o Firecrawl
Compare ferramentas de web scraping para pipelines de IA por rastreamento, saída em Markdown e JSON, esforço de migração e custo por página útil.25 de set. de 2026Build
Alternativas ao CodeRabbit: qual escolher para sua equipe?
Compare alternativas ao CodeRabbit por preço, suporte a provedores Git, privacidade e cobrança, de serviços gerenciados a opções self-hosted.25 de set. de 2026Build
Greptile vs CodeRabbit: qual review de código com IA vale mais?
Greptile vs CodeRabbit: compare preços, créditos, limites, plataformas e profundidade da revisão de código com IA antes de escolher para sua equipe.25 de set. de 2026Build
Como usar Perplexity Portable Computer no Windows com AMD
Veja como usar Perplexity Portable Computer em um PC Windows com AMD, validar os requisitos, limitar o acesso a pastas e automatizar tarefas locais.25 de set. de 2026Build
AgentRun na prática: vale a pena para orquestração de agentes de IA?
O AgentRun organiza workflows de agentes de IA com estado tipado, chamadas limitadas e escalonamento explícito. Veja testes, custos e quando adotar.24 de set. de 2026Build
Perplexity Search API: Fast Search ou busca web?
Compare Fast Search e a busca web padrão da Perplexity em preço, latência e cobertura para escolher o melhor modo da API em cada consulta do seu agente.24 de set. de 2026Build