Runpod 价格详解:Pods 与 Serverless 怎么选
Runpod 价格到底怎么计算?本文对比 Secure Cloud Pods、Serverless Flex、Active workers 与存储费率,用 100 小时、730 小时和请求量场景拆解 H100 成本,并给出 60.33% 的盈亏平衡线,帮助你按真实 worker 时长选择方案。


Runpod 价格中,生产环境使用 H100 的起点是 Secure Cloud Pod 每小时 $2.89;选择 Serverless,则按 worker 可计费时长计算,每小时 $4.79,存储费用另计。只有当启动、执行、重试和空闲时间之和低于 Pod 运行窗口的 60.33% 时,Serverless 才更划算;超过这条线,就应保留 GPU 常驻。
Runpod 价格速览
Runpod 不是按月订阅的 SaaS,而是按用量计费的基础设施。真正要做的选择是:Pod 运行期间持续为独占资源付费、只为存活中的 Serverless worker 付费,还是为长期稳定负载购买询价容量。
下表价格已于 2026 年 9 月 25 日对照 Runpod 实时价格页核验;该页面标注的日期为 2026 年 9 月 13 日。具体 GPU、云层级和区域是否有货,以及最终费率,仍以控制台为准。
Runpod 没有常见的月付/年付切换。Pods 按需使用;Pod Savings Plan 需预付 3 或 6 个月;Reserved Clusters 公布了 12 个月及更长期限,但必须询价。它也没有传统意义上的“超额费”一栏:工作负载停止、余额归零,或触发账户默认的全局 $80/hour 支出上限前,计算与存储都会继续计费。Runpod 表示,支持团队可以调高该上限。
Runpod GPU 价格:Pods 如何计费
当模型需要长期、可预测地驻留在 GPU 上时,Pod 费率更有优势。Pod 运行期间,你掌控容器并独占 GPU;代价是没有任务的安静时段也照常计费。
当前 Pod 目录公布了以下小时费率,全部按秒结算:
- **80GB 及以上:**B300 $7.89、B200 $6.79、H200 $4.59、RTX Pro 6000 $2.09、H100 NVL $3.19、H100 PCIe $2.89、H100 SXM $3.49、A100 PCIe $1.59、A100 SXM $1.59。
- **48GB:**Pro 6000 MIG $1.09、L40S $1.09、RTX 6000 Ada $0.84、A40 $0.49、L40 $0.82、RTX A6000 $0.53。
- **24GB 至 32GB:**RTX 5090 $0.99、Pro 6000 MIG 24GB $0.59、L4 $0.49、RTX 3090 $0.50、RTX 4090 $0.74、RTX A5000 $0.27。
这些是目录价格,不代表每个地区都有对应显卡。预算定稿前,应在控制台中选定 GPU、云层级和区域并确认供给。
Community Cloud 还是 Secure Cloud
生产环境默认应优先考虑 Secure Cloud。Runpod 将其描述为位于 T3/T4 数据中心的单租户硬件,并定位于生产业务或受监管数据。Community Cloud 使用经过审核的第三方容量,更适合作为低价资源池,用于实验和可恢复任务。
以 H100 PCIe 为例,实时 H100 对比区显示,Community Cloud 每小时 $1.99,Secure Cloud 每小时 $2.89。每小时相差 $0.90,累计 100 GPU-hours 可省 $90,但这并非没有代价的折扣。对于承诺交付的客户侧 AI agent,不应仅为每小时省 $0.90 就放弃生产层级。
供应商页面还有一处需要留意的不一致:当前 H100 页面标题和对比区都与主价格页一致,Secure Cloud 为每小时 $2.89;但同一页面下方的 FAQ 仍写着每小时 $2.39。在控制台显示其他价格之前,应按 $2.89 预算。
Savings Plans 是 Pod 的承诺用量方案。费用需提前支付 3 或 6 个月,只覆盖 GPU 计算,不含存储;方案有固定到期日,且不退款。停止一个 Pod 后,方案可转到下一次部署的同类型 GPU 上。对稳定集群来说这很实用,但如果团队仍在更换显卡或流量形态,它并不合适。
Runpod Serverless 价格:按 worker 时长,而非请求数付费
只有 worker 有足够时间缩容到零时,Serverless 才会比全天运行的 Pod 便宜。账单跟随 worker 的生命周期,而不是成功 API 调用次数,因此冷启动、模型加载、失败尝试和空闲超时都必须计入预算。
Runpod 提供两类 worker:
- Flex workers 可缩容到零,使用公开的按秒费率。
- Active workers 保持 24/7 运行,用于稳定流量和低延迟场景。Runpod 计费文档写明可向销售咨询折扣,但没有承诺固定比例。
不要按每小时 $4.18 为 H100 Flex 做预算,也不要假设每个 Active worker 都能打 30% 折。当前 H100 Flex 费率是每小时 $4.79,Active 费率取决于报价。沿用过时的固定折扣,会让错误的架构在收到第一条请求前就显得更便宜。
Runpod Serverless GPU 费率表
当前 Flex 目录包含 13 个价格档位:
- **大显存:**B300 $9.98/hour、B200 $8.64、H200 $5.93、RTX 6000 Pro $3.49、H100 $4.79、A100 $2.72。
- **48GB 和 32GB:**L40/L40S/6000 Ada/MIG 48GB $1.75、A6000/A40 $1.22、RTX 5090 $1.58、RTX PRO 4500 Blackwell $1.15。
- **24GB 和 16GB:**RTX 4090 $1.10、L4/A5000/3090/MIG 24GB $0.69、A4000/A4500/RTX 4000/RTX 2000 $0.58。
价格档位取决于 worker 使用的 GPU,而不是模型名称或请求大小。24GB worker 即使只处理一条很小的请求,在其存活期间仍按每小时 $0.69 计费;H100 上的请求即使失败,实际运行的秒数照样收费。
可计费时钟由三部分组成:
- **启动:**初始化容器,并把模型载入 GPU 显存。
- **执行:**处理请求,包括最终失败的工作。
- **空闲超时:**任务结束后让 worker 继续存活,以等待下一条请求。文档给出的默认值是 5 秒。
worker 数量会同时放大这三个阶段。每个加载模型的 worker 都会在开始执行前产生自己的启动时间。自动扩缩容可以减少闲置容量,但过于激进的扩容也可能让多个 worker 重复支付启动成本。
Runpod 成本测算:100 小时、730 小时与成功请求
这套 Runpod 成本模型可以复算,但它并不声称测得了实际吞吐量。批准生产预算前,请用保存下来的账单和请求日志替换每一项假设。
这个带日期基准的假设如下:
- **GPU:**一块 NVIDIA H100。
- **Pod:**Secure Cloud H100 PCIe,每小时 $2.89。
- **Serverless:**一个 H100 Flex worker,每小时 $4.79。
- **区域:**假设在 US;计算采用全球目录费率,但仍须在所选控制台区域核对库存与价格。
- **存储:**一个 100GB 标准 network volume,保留一个月,费用 $7。
- **请求模型:**每个流量窗口启动 20 秒,每次尝试执行 2 秒,采用文档规定的 5 秒空闲超时,失败尝试占 2%,每个窗口有 100 条成功请求。
- **Pod 请求基准:**一个生产 Pod 在 730 小时的整月内保持运行,以便随时响应。
请求场景揭示的是流量形态对成本的影响,并不是说你的模型在 H100 上一定需要 2 秒。它表达的是:如果每次尝试需要 2 秒,而且请求以每组 100 条的方式到达,那么一千条成功请求会产生表中的成本。
对 1,000 条成功请求,用成功数除以 98% 并向上取整,可得 1,021 次尝试。10 个窗口合计启动 200 秒,执行 2,042 秒,空闲 50 秒,总计 2,292 个可计费秒,即 H100 计算费用 $3.05。
对 10,000 条成功请求,同样的方法得到 10,205 次尝试、2,000 秒启动、20,410 秒执行和 500 秒空闲。总计 22,910 个可计费秒,计算费用为 $30.48。
存储需单独计算。加上 100GB 标准 network volume 后,当月总额分别是 $10.05 和 $37.48,但这个 volume 也可能服务其他流量。不要把它硬塞进一个虚构的单请求费率。
敏感性分析:请求节奏会改变答案
更快的基础镜像和更连续的流量可以降低计算费用。若启动 5 秒、执行 1 秒、没有失败、空闲 5 秒,且每个窗口有 100 条成功请求,模型得出的计算费用是:1,000 条成功请求 $1.46,10,000 条成功请求 $14.64。
相反的流量形态会很贵。假设每次尝试都发生在缩容到零之后,并分别触发 20 秒启动、2 秒执行和 5 秒空闲,则模型中的计算费用升至:1,000 条成功请求 $36.68,10,000 条成功请求 $366.61。
这段区间说明,请求数本身并不是合适的原始计费单位。只有结合实测的 worker-seconds、失败率和并发量,请求数才有决策价值。
Pods 与 Serverless 的盈亏平衡点取决于可计费秒数
基准 H100 的纯计算盈亏平衡点可以精确算出:用 Secure Pod 的 $2.89 费率除以 Serverless 的 $4.79 费率,结果为 60.33%。
对任意观察窗口:
Serverless wins when billable worker seconds < window seconds × 2.89 / 4.79.
在 100 小时的服务窗口里,Serverless 必须低于 60.33 个可计费 worker-hours,才会比 $289 的 Pod 便宜。在 730 小时的月份里,它必须低于 440.44 个可计费 worker-hours,才能击败 $2,109.70。若存储配置完全相同,比较时可以抵消;存储选择不同则不能。
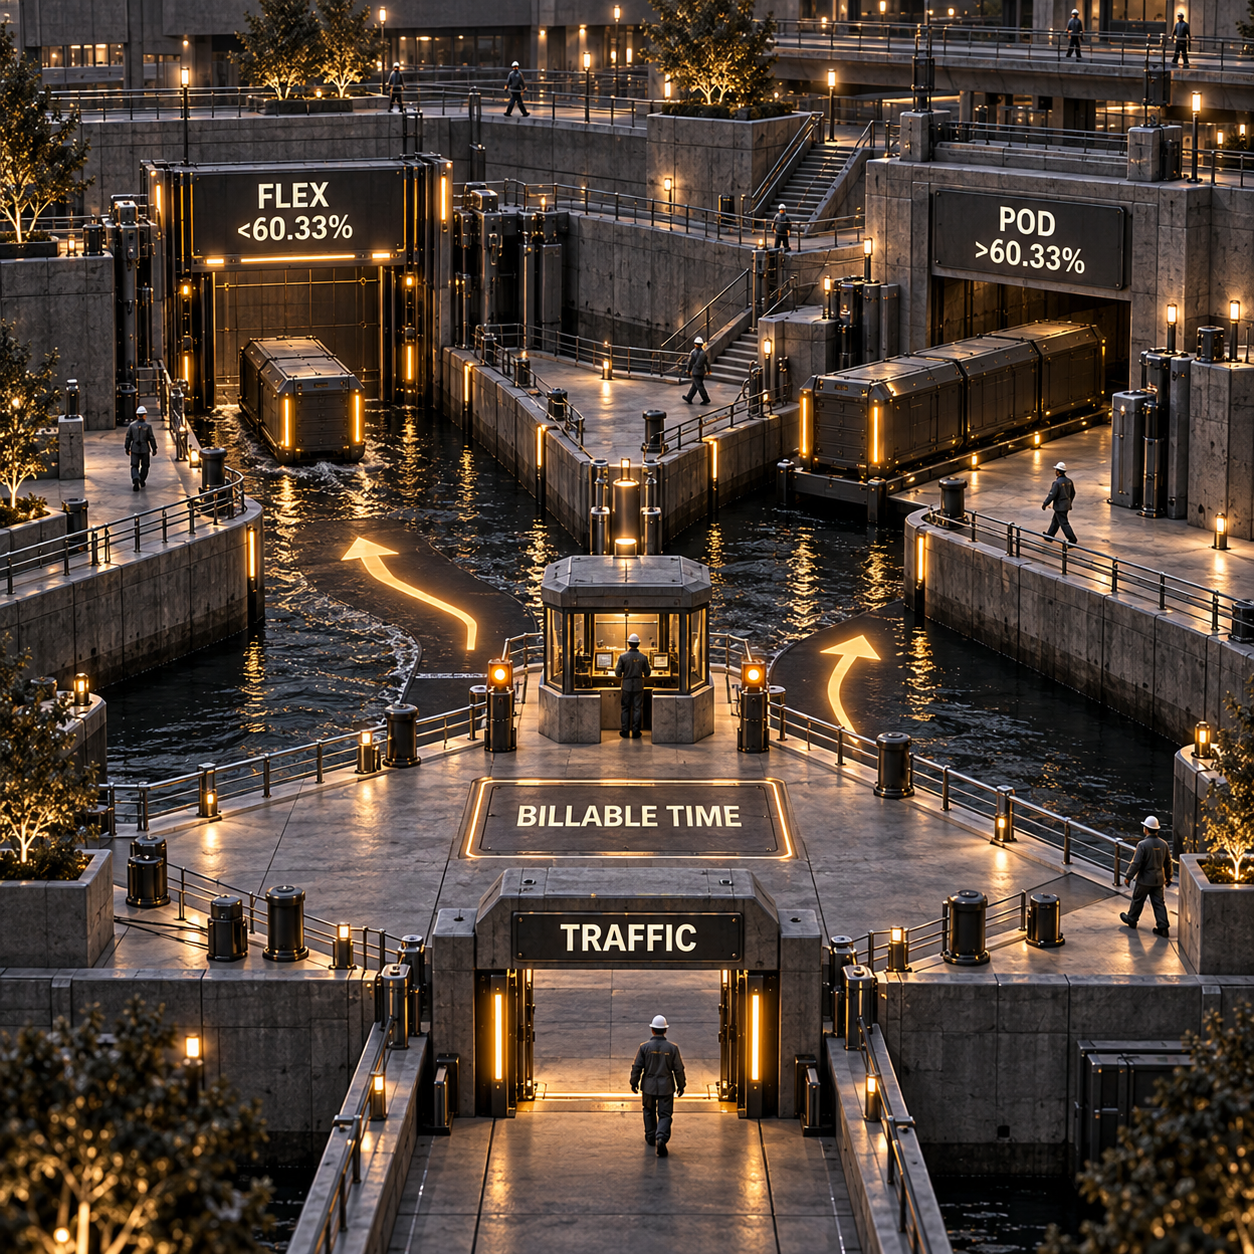
Community Cloud 改变的是算式,而不是风险。H100 PCIe 每小时 $1.99,与 $4.79 的 Serverless 相比,纯计算交叉点为 41.54%,也就是 730 小时月份中的 303.28 个可计费小时。这条更低的界线适用于可重启任务,却不构成把敏感客户流量迁到第三方容量的理由。
Active worker 的实际报价会再次移动这条线。在 Runpod 以书面形式给出费率前,没有任何诚实的数字可填入模型;固定按 30% 折扣计算并不等于报价。
Runpod 存储价格:停止计算不等于免费
Runpod 的 Pod 存储文档列出了三种标准行为。混淆它们,可能让已停止的 Pod 反而产生更高的存储账单。
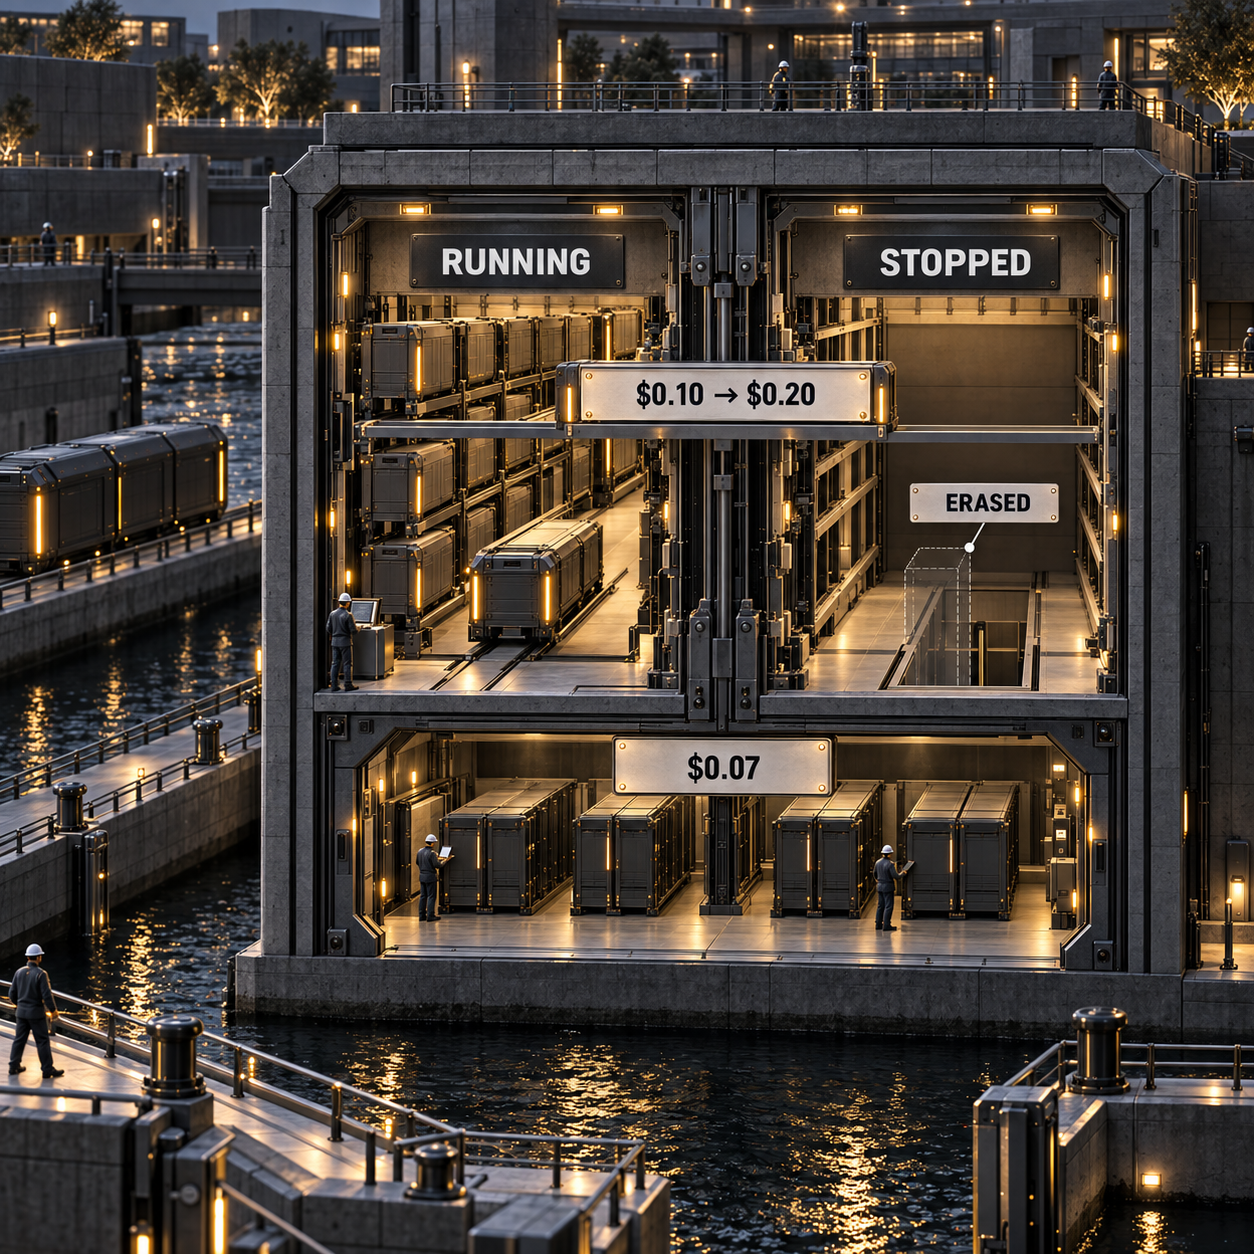
- **Container disk:**运行时 $0.10/GB/month。停止后数据会被清除,因此不再计费。
- **Volume disk:**运行时 $0.10/GB/month,停止时 $0.20/GB/month。因此,保留的 100GB volume 在 Pod 停止后会从每月 $10 上升到 $20。
- **Standard network volume:**低于 1TB 时 $0.07/GB/month,高于 1TB 时 $0.05/GB/month,无论计算资源正在运行还是已停止,费率不变。
- **High-performance network storage:**主价格页列出 $0.14/GB/month,而存储文档称准确费率因数据中心而异。最终以控制台为准。
Runpod 存储成本也会影响资源放置。Network volumes仅供 Secure Cloud 中的 Pods 使用;必须在部署时选定,之后若不删除 Pod,就无法挂载或卸载。用于 Serverless 时,volume 会绑定到某个数据中心,可能缩小可选 GPU 范围。部署多个 volumes 可以分散放置,但 Runpod 表示它们不会自动同步。
如果弹性 workers 需要共享模型权重,network volume 可以避免重复下载。对于一次性实验,container disk 可能更便宜。如果停止 Pod 后还要保留本地工作区,volume disk 则是容易被忽视的高成本项。
Runpod 替代方案:统一比较一个付费 H100 小时
在讨论平台功能之前,应先把各家方案统一到相同的付费加速器时长上。按 100 个付费 H100 GPU-hours 计算,当前供应商费率对应的计算费用如下:
- **Runpod Secure Cloud Pod:**H100 PCIe 为 $289。
- **Lambda:**单 GPU H100 PCIe 实例为 $329。Lambda 实例页显示该配置包含 1TiB SSD,并注明适用的销售税、VAT 或 GST 需另付。
- **Modal:**H100 SXM5 GPU 按每秒 $0.001097 计费,合计 $394.92,另收 CPU 和内存费用。Modal Starter每月包含 $30 免费额度。
- **Runpod Serverless:**若 100 个 worker-hours 全部可计费,总额为 $479。
- **AWS:**US East 的一块 H100 p5.4xlarge Capacity Block 为 $519.10,依据是每 accelerator-hour $5.191。AWS 会预先收取预留费用,所以它并不是按需 Serverless 的等价方案。
这个统一口径刻意保持在很窄的范围。Modal 使用 H100 SXM5,Runpod 和 Lambda 使用 H100 PCIe,AWS 销售的是预定时段的 Capacity Block;各家的 CPU、内存、存储、编排能力和可用性也不相同。上述列表只回答加速器费率问题,并不假装这些服务可以互换。
Runpod 与 Vast.ai 怎么选
Vast.ai 的 H100 无法归结为一个长期有效的固定价格。Vast.ai 说明,其 marketplace 价格会随供需变化,实时表格每小时更新;可租用的最低报价标为“from”费率,中位数则另行统计。Runpod 使用公开目录费率,并将容量分为 Community 和 Secure 两个层级。
如果你能实时查询报价、筛选可靠性,并在供应变化时迁移任务,可以选择 Vast.ai。若稳定的公开费率、Secure 层级,以及从 Pod 迁移到 Serverless 的路径,比捕捉某一时刻的最低价更重要,Runpod 更合适。
如果真正的替代方案是托管式推理 API,就不能只比较 GPU 时间,还要计算运维工作。Together AI 价格拆解可作为自托管 GPU 账单的另一项参照。
不同工作负载该选哪一种
面向客户的 AI agent 或文档处理服务,如果一块 GPU 在一天的大部分时间都有有效负载,应选择 Secure Cloud Pods。Pod 费率更低,存储放置方式更明确,模型保持热态也能避免反复启动。它的短板是闲置容量:每一分钟安静期都要付费。
有长时间空档、活动式突发流量、定时批处理,或上线初期流量不确定的功能,应选择 Serverless Flex。它可以缩容到零,但启动、重试和空闲秒数必须低于交叉点。它的短板是 worker 生命周期可能反复产生,尤其是大模型加载缓慢或自动扩容铺开得过于激进时。
只有在延迟要求和实测流量足以支撑销售洽谈时,才选择 Active workers。它们保持 24/7 运行;没有书面报价,就无法可靠地估算折扣。
实验、评估和可重启批处理适合 Community Cloud Pods。受监管数据,或可用性属于产品承诺的生产 endpoint,不应使用这一层级。
真正需要多 GPU 的任务才应选择 Instant 或 Reserved Clusters,不要把它们当作默认的推理升级。Instant Clusters 公布了 A100 和 H200 的价格,最多可扩展至 64 块 GPU;另外几种 GPU 类型,以及所有 Reserved Cluster 期限,都需要联系销售。
选硬件前,先确定模型和所有权方案。私有 agent 模型指南可帮助判断模型规格,托管式与自托管 coding agents则梳理了运维层面的取舍。
- Pods 和 Serverless 均按秒计费,不收 ingress 或 egress 费用。
- 从低价 Pods 到可缩容至零的推理,再到多 GPU clusters,迁移路径完整。
- 消费级、数据中心级和 Blackwell GPUs 均有公开目录费率。
- Secure 与 Community 两类容量,可让可重启任务和生产任务采用不同的风险预算。
- 同一个官方 H100 页面仍保留着过时的 Secure Cloud FAQ 价格。
- Active worker 折扣仅提供报价,因此无法公开建立核心生产费率模型。
- Pod 停止后,volume disk 费用会翻倍。
- Network volume 的放置会缩小 Serverless 可用 GPU 的范围,而且 volumes 不会自动同步。
- 最终可用性与区域价格仍需在控制台核实。
周一要做的事,是用一个有代表性的一周数据替换假设。
固定工作负载边界
确定一种模型、GPU 档位、云层级和区域。不要拿 Community H100 与 Secure H100 比较,也不要混用 H100 与 A100 的吞吐量。
记录每个可计费阶段
采集 worker 启动、模型就绪、请求开始、请求结束和 worker 停止的时间戳,并在成功请求旁记录 worker 数量与失败尝试。
拆分不同存储状态
分别列出 container、volume 和 network storage 的 GB 数量。运行期和停止期要单独计价,不要把所有保留数据笼统归为“存储”。
套用交叉点
汇总启动、执行、重试和空闲的 worker-seconds,与 Secure Pod 窗口的 60.33% 比较;随后把 $2.89 和 $4.79 替换为控制台与报价中真正可以买到的费率。
Runpod 价格常见问题
有哪些服务比 Runpod 更便宜?
Vast.ai 等 marketplace 可能出现更低的实时报价;按当前费率,Modal 的 H100 GPU 费用也低于全时计费的 Runpod H100 Serverless。Runpod Community Cloud 同样可能比 Secure Cloud 便宜。但最终账单是否更低,还取决于 worker 空闲时间、存储、可靠性和服务所含内容。
Runpod 值得用吗?
如果需要自有容器、模型和 GPU,同时希望按秒计费,Runpod 值得考虑。若托管模型 API 的成本低于自行维护镜像、扩缩容、监控和重试,或现有云服务承诺比 GPU 标价更重要,则不应选择它。
Runpod 比 AWS 更好吗?
在本文统一口径的单 H100 示例中,Runpod 更简单也更便宜:Secure Pod 每小时 $2.89,而 US East 的 AWS p5.4xlarge Capacity Block 每 H100 accelerator-hour 为 $5.191。如果工作负载依赖 AWS 的网络、数据服务、治理能力或既有承诺支出,AWS 仍可能是更好的系统选择。
Runpod 免费吗?
实时价格页没有显示适用于所有人的免费计算层级。用户需要充值,并为计量资源付费。符合条件的初创公司和部分合作伙伴计划可以获得 credits,但这些属于有条件的项目,并非永久免费方案。
Runpod 费用有多高?
本文采用的当前 Pod 公开目录中,价格从 RTX A5000 每小时 $0.27 到 B300 每小时 $7.89。Serverless 则从 16GB 档位每小时 $0.58 到 B300 每小时 $9.98,此外还要叠加存储和 worker 时长模式带来的费用。
最便宜的 GPU 租用方案是什么?
在 Runpod 当前公开的 Pod 表中,RTX A5000 费率最低,为每小时 $0.27。marketplace 可能短暂出现更低报价,但可用性、主机可靠性、带宽和存储都可能让表面上的节省消失。
租用 GPU 能赚钱吗?
有可能,但仅凭租用费率无法回答。每次成功结果的毛利润,必须高于计算、存储、失败尝试、闲置容量、监控和工程成本。请把成功请求测算表与实际收入及日志结合使用。
现在最便宜的 GPU 是哪一款?
Runpod 实时目录中,RTX A5000 的价格最低,为每小时 $0.27;但实际能部署的最低价 GPU,取决于所选层级和区域的实时库存。启动前应立即在控制台确认报价。
租用一块 NVIDIA GPU 要多少钱?
按本文采用的 Runpod 当前 Pod 目录,价格范围是每 GPU-hour $0.27 至 $7.89。Secure Cloud H100 PCIe 每小时 $2.89,H100 Serverless 则按可计费 worker-hour 收取 $4.79。
Runpod 免费 credits 如何使用?
Runpod Startup Program说明,通过审核的 Starter 成员可获得一次性 $1,000 credits。Growth 成员预先承诺 $50,000,可获得 $25,000 奖励;在 12 个月协议期内总额为 $75,000,credits 不会重新补充。
Runpod 有学生折扣吗?
在 2026 年 9 月 25 日核查的实时价格页、文档和 Startup Program 页面中,没有发现公开的学生专属折扣。学生应按自助费率做预算,或申请符合条件的 credits 项目,而不是默认存在教育优惠价。
Runpod 的退款政策是什么?
Runpod 条款写明,服务费通常不予退还;取消订阅后,当前期限也不会按比例退款。Pod Savings Plans 同样明确不退款。
Runpod 价格发生过变化吗?
当前 H100 Serverless 价格为每小时 $4.79。较早发布的资料仍显示 $4.18,而 Runpod 自己在 8 月 10 日发布的费率表写的是 $4.55;但本次核验没有在官方变更日志中找到准确生效日期。应采用带核验日期的实时费率。
- 最近更新
- 2026年9月25日
- 分类
- Build
在 Google 中优先显示本站


把 omidsaffari.com 设为优先来源,Google 会在 Top Stories、AI Overviews 和 AI Mode 中为您优先展示。

Vercel Sandbox Drive 实战:让 AI 编程工作区跨沙箱持久化
用 Vercel Sandbox Drive 把代码、依赖缓存和任务笔记保存在可跨沙箱挂载的持久工作区中。本指南通过 TypeScript 示例,讲清 Drive 的创建与挂载、单写入者与快照读取规则、区域限制,以及存储、读写与计算费用,并给出四项上线前验证方法,帮助 AI 编程代理减少重复安装和工作区重建时间。2026年9月25日Build
Firecrawl 替代方案怎么选:7 款网页抓取工具成本对比
Firecrawl 替代方案指南:对比 Apify、Crawl4AI、ScrapFly、Jina Reader 等 7 款网页抓取工具,按验收通过页面核算价格与运维工时,并拆解 URL 发现、JavaScript 渲染、Markdown/JSON 输出边界和迁移验收方法,帮助小团队避开只看请求单价的选型误区。2026年9月25日Build
AI code review 工具怎么选:7 款 CodeRabbit 替代方案
对比 7 款 CodeRabbit 替代方案,按 5 名 PR 作者、每月 300 次审查统一核算 Greptile、cubic、Qodo、PR-Agent、Kodus、Cursor Bugbot 与 GitHub Copilot 的成本,并从 Git 托管平台、数据边界、部署方式和计费单位判断团队是否值得迁移。2026年9月25日Build
Greptile 与 CodeRabbit:代码审查工具怎么选
Greptile 与 CodeRabbit 都是 AI 代码审查工具,但同为每位作者每月 $30,计费逻辑却截然不同。本文逐项对比积分、滚动限额、平台支持、运行时验证和五人团队成本,并给出可复核的选型与试用方法,帮你判断常规吞吐量该选 CodeRabbit,何时值得为 Greptile 的审查深度付费。2026年9月25日Build
Perplexity Portable Computer 使用指南:AMD Windows 本地运行全流程
AMD Windows 电脑如何本地运行 Perplexity Portable Computer?详解 Ryzen AI Max 硬件门槛、模型下载、文件夹权限、对账测试和定时任务设置,说明哪些步骤会转入云端、消耗 Computer credits,以及如何用已知异常验收结果,避免把系统内存误当成 GPU 可用内存。2026年9月25日Build
AgentRun 评测:AI 智能体工作流何时值得引入
AgentRun 值得用于 AI 智能体工作流吗?本文实测 beta.4 的分支控制、schema 校验、升级机制、集成成本与定价,并与 TypeScript、LangGraph.js 和 Temporal 对比。结合 4 个客服案例、31 项测试及 31 行函数,说明适用团队、关键限制,以及何时该继续使用普通代码。2026年9月24日Build
Perplexity API Fast Search 对比默认 Web:该怎么选?
Perplexity API 的 Fast Search 每 1,000 次成功请求仅需 $1,默认 web 为 $5。本文对比两种模式的延迟、检索质量、覆盖能力与真实成本,并给出按查询风险路由、用证据门槛自动升级的落地方法,帮助 Agent 团队判断哪些任务该追求速度,哪些研究必须保留更广的来源覆盖。2026年9月24日Build