Agenti AI con GPT-6.1 Sol: configurazione, costi e Codex
Come configurare agenti AI con GPT-6.1 Sol, Codex e Responses API: effort, strumenti, costi reali e criteri per capire quando passare ad Astra.



Gli agenti AI basati su GPT-6.1 Sol sono adatti al lavoro serio e ripetibile: troppo impegnativo per un modello leggero, ma troppo frequente per affidarlo sempre e alla cieca ad Astra. La configurazione concreta è semplice: usare gpt-6.1-sol sulla Responses API, partire da medium, rendere disponibili soltanto gli strumenti necessari e promuovere il modello solo dopo il superamento di criteri di accettazione prestabiliti. Per questa guida, una nuova esecuzione di Codex ha creato una piccola utility JavaScript, scritto quattro test e li ha superati tutti, per un costo API equivalente, calcolato sui soli token, di $0.02816.
La scelta in un minuto
GPT-6.1 Sol è disponibile per gli agenti via API, Codex e i piani a pagamento di ChatGPT Work. Non è ancora presente nella Chat ordinaria; inoltre, la modalità Ultrafast per questo modello è stata annunciata, ma non è ancora attiva.
Il prezzo Standard dell'API è di $2 per milione di token di input e $10 per milione di token di output. Per GPT-6 Astra è rispettivamente di $10 e $50. L'annuncio di lancio di OpenAI conferma le modalità di distribuzione del prodotto. Per un confronto più completo su accesso e limiti di utilizzo, si veda GPT-6.1 Sol vs GPT-6 Sol; qui l'attenzione resta sulla configurazione e sulle scelte operative.
Che cos'è davvero GPT-6.1 Sol
Si può pensare alla famiglia GPT-6 come a una squadra operativa. Astra è lo specialista da riservare ai casi più difficili e controversi. GPT-6.1 Sol è l'operatore senior a cui affidare con continuità attività complesse e ricorrenti. GPT-6 Sol resta invece l'opzione di compatibilità per un'integrazione meno recente degli strumenti. Questa distinzione è più utile che considerare il nuovo modello una soluzione predefinita universale.
GPT-6.1 Sol accetta testo e immagini, restituisce testo e offre una finestra di contesto da 1,050,000 token, con un massimo di 128,000 token in output. Per un agente, il vero valore è nell'insieme di strumenti disponibili. Con Responses supporta web search, file search, image generation, code interpreter, hosted shell, apply patch, skills, computer use, MCP, tool search e funzioni personalizzate. La guida agli strumenti di Responses spiega come l'API possa mantenere il modello in un ciclo agentico mentre decide quale strumento autorizzato chiamare di volta in volta.
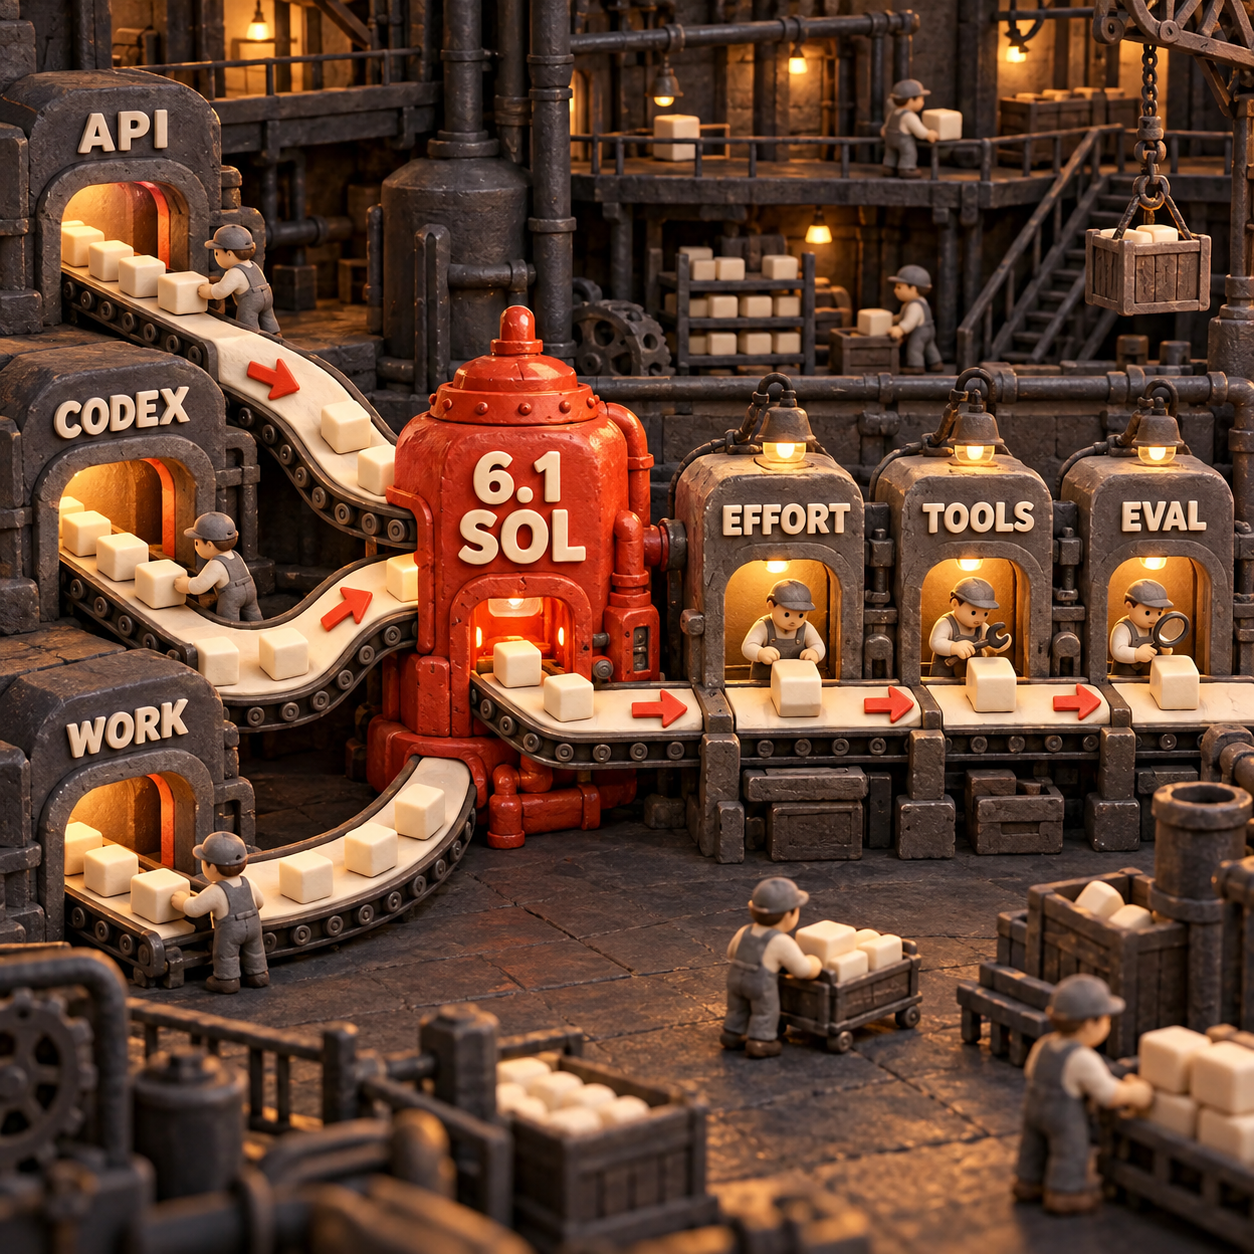
Il vincolo è altrettanto importante: GPT-6.1 Sol può usare gli strumenti soltanto tramite Responses. Chat Completions accetta ancora una richiesta semplice, ma non una richiesta che preveda chiamate agli strumenti. Se l'agente attuale richiama funzioni tramite Chat Completions, cambiare soltanto l'ID del modello non equivale a eseguire una migrazione.
Come configurare gli agenti AI sulla Responses API
Si parte da un singolo percorso e da un singolo criterio di accettazione. Non ha senso esporre ogni strumento solo perché compare nella pagina del modello. Un agente di ricerca può avere bisogno di web search e file search. Uno che lavora su un repository può richiedere shell e accesso alle patch. Un agente operativo potrebbe invece aver bisogno di due funzioni e di una regola che imponga l'approvazione.
Questa è la richiesta JavaScript minima davvero utile:
import OpenAI from "openai";

const client = new OpenAI();

const response = await client.responses.create({
  model: "gpt-6.1-sol",
  reasoning: { effort: "medium" },
  tools: [{ type: "web_search" }],
  input: "Find today's source for our target metric, cite it, and return one sentence."
});

console.log(response.output_text);
L'ID identifica Sol. L'oggetto reasoning stabilisce quante risorse il modello può dedicare al ragionamento. L'array tools concede una capacità, ma non impartisce l'ordine di usarla. Il prompt deve comunque definire un risultato, i requisiti relativi alle prove e una condizione di arresto.
Per un agente esistente basato su Chat Completions, la migrazione comporta tre interventi: inviare la richiesta a Responses, interpretare gli elementi tipizzati di output e decidere come prosegue lo stato della conversazione. La guida alla migrazione di Astra verso Responses approfondisce questi aspetti tecnici.
Fissare cinque attività reali
Selezionare esempi già accettati del workflow, includendo un caso di errore. Conservare prompt, input, autorizzazioni e criteri di riuscita.
Partire da medium
Usare prima l'effort predefinito. Modificare una sola variabile alla volta, così da non confondere un miglioramento dovuto al modello con uno causato dal prompt o dagli strumenti.
Concedere solo gli strumenti necessari
Esporre esclusivamente ricerca, file, funzioni, shell o controlli del computer richiesti da quel percorso. Mantenere le operazioni di scrittura dietro policy esplicite e confini di approvazione.
Registrare il costo dei risultati accettati
Rilevare input nuovi, input nella cache, output, tentativi, costi degli strumenti e superamento o meno del controllo finale. Un'esecuzione economica che fallisce non è un risparmio.
Instradare in base alle prove
Mantenere Sol dove supera i controlli. Passare ad Astra soltanto i casi difficili residui. Lasciare su GPT-6 Sol i percorsi incompatibili finché non viene aggiornato il client che li invoca.
Scegliere il reasoning effort in base al lavoro
medium è il punto di partenza corretto per la maggior parte del lavoro agentico. GPT-6.1 Sol accetta anche low, high, xhigh e max. Rifiuta none e minimal: un percorso esistente che usa una di queste impostazioni richiede quindi test mirati su comportamento e latenza. La guida al reasoning effort di OpenAI segue la stessa progressione, dall'esecuzione efficiente al massimo livello di ragionamento.
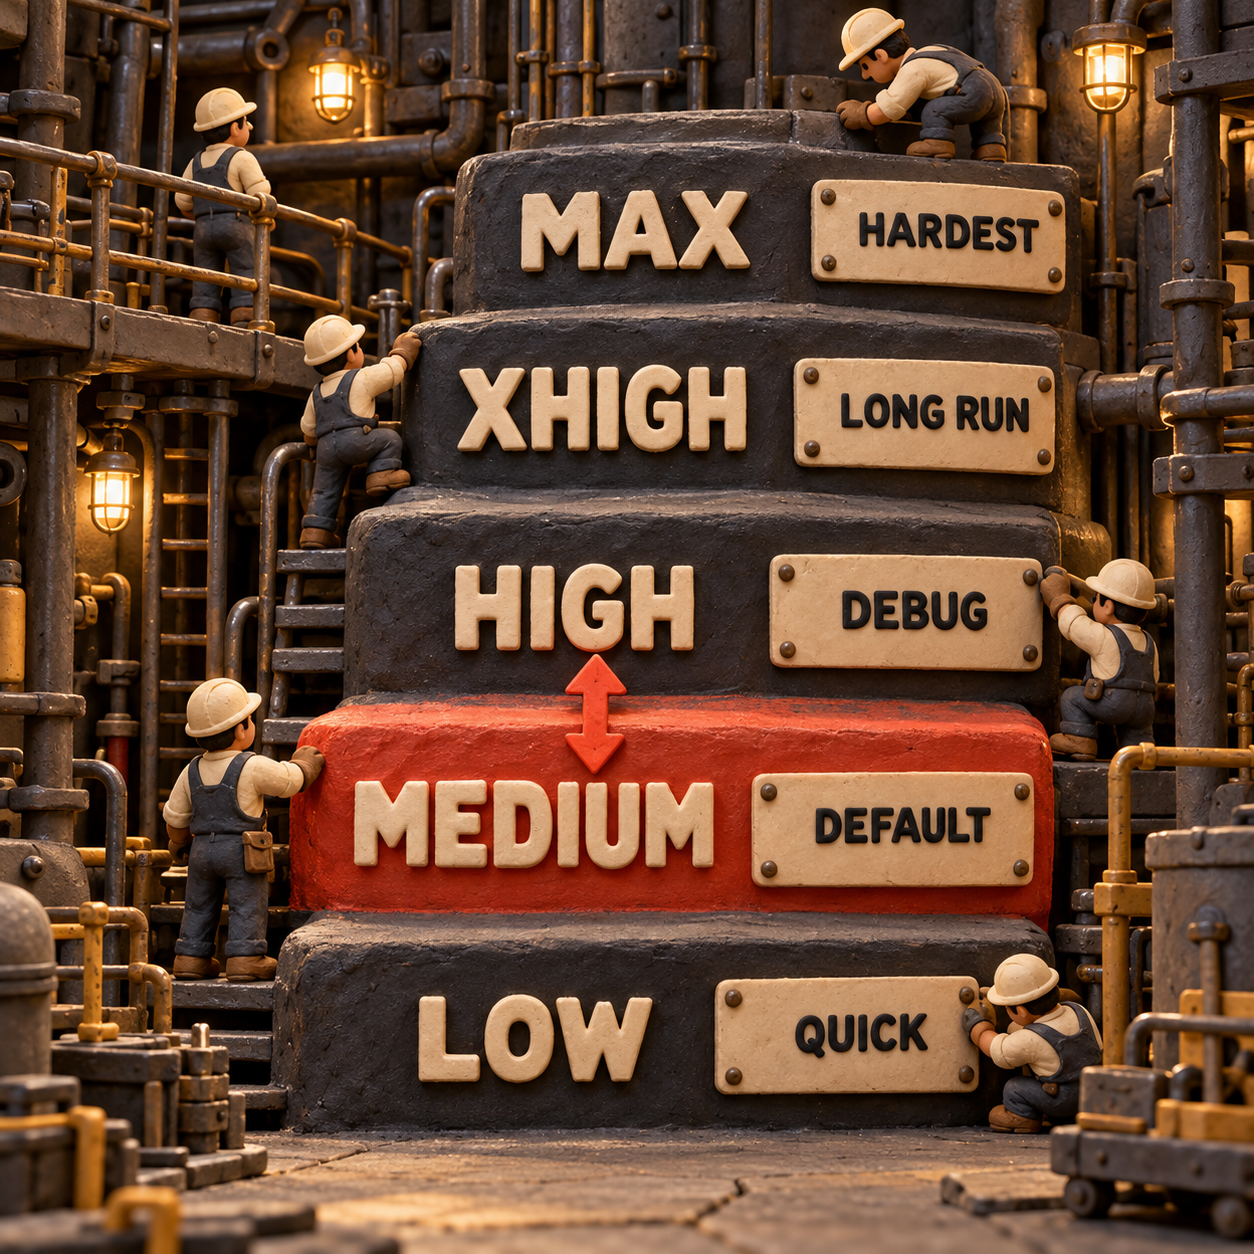
Tre nomi simili indicano controlli differenti. max è un livello di reasoning effort dell'API. Ultra in Codex è una modalità multi-agent che distribuisce il lavoro tra più subagenti. Ultrafast è una modalità ad alta velocità, il cui supporto per GPT-6.1 Sol è ancora in arrivo. Non si deve definire un budget o un piano di lancio per Ultrafast come se fosse già disponibile.
Un'attività reale con GPT-6.1 Sol e il suo costo in token
Una piccola esecuzione rivela più sull'economia d'uso di quanto faccia un prezzo di listino. GPT-6.1 Sol con effort low ha ricevuto in Codex questo incarico: creare una funzione JavaScript slugify senza dipendenze, aggiungere esattamente quattro casi node:test per spazi iniziali e finali, spazi bianchi, punteggiatura e combinazioni di maiuscole e minuscole, eseguire i test e correggere qualsiasi errore.
Il modello ha creato slugify.js e slugify.test.js, quindi ha eseguito node --test slugify.test.js. Il risultato: 4 test superati e 0 falliti. Il consumo registrato è stato di 57,578 token di input, di cui 48,640 nella cache, più 542 token di output. Di conseguenza, soltanto 8,938 token di input sono stati fatturati alla tariffa per input nuovi.
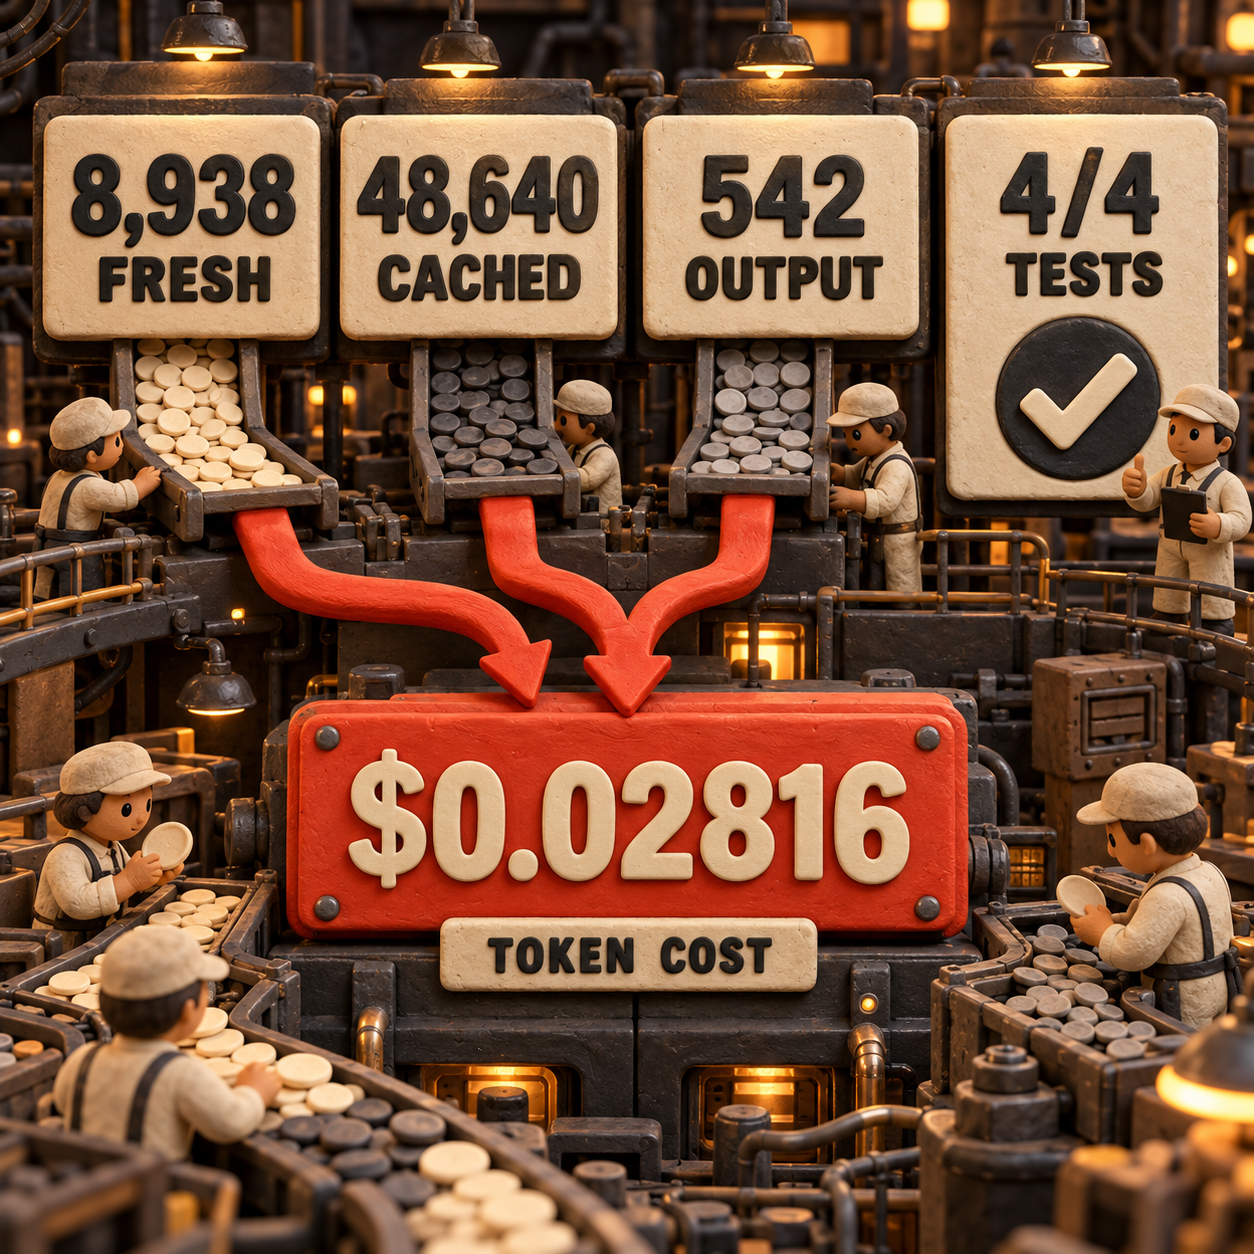
Si è trattato di una vera esecuzione di Codex, che ha quindi utilizzato l'accesso del piano anziché generare una fattura API. Il valore di $0.02816 corrisponde esattamente a quel mix di token, calcolato con le tariffe Standard pubblicate per GPT-6.1 Sol. Non comprende eventuali costi per strumenti hosted a pagamento. Su 10,000 esecuzioni identiche, lo stesso mix costerebbe $281.60 in token del modello. Mantenendo invariato il mix, con le tariffe di Astra il costo sarebbe di $1,651.20. Quest'ultimo confronto è un calcolo tariffario, non l'affermazione che Astra consumerebbe lo stesso numero di token.
La conclusione non è che ogni piccola patch costi tre centesimi. È che il runtime dell'agente, le definizioni degli strumenti, le istruzioni e la cronologia possono pesare più della richiesta visibile. Occorre misurare l'intera esecuzione accettata, inclusi il contesto nella cache e i nuovi tentativi.
Sette lavori in cui Sol offre il massimo valore
I vantaggi maggiori arrivano per i team che gestiscono attività difficili e ricorrenti. Ecco la classifica in base al probabile valore operativo:
Sol non elimina la necessità di progettare le approvazioni, predisporre controlli deterministici o garantire osservabilità. Offre a questi sistemi un operatore più capace, con una tariffa per token inferiore rispetto ad Astra.
Tre prodotti che vale la pena costruire
1. Un banco di prova per migrare i coding agent a Sol
È l'opportunità più solida. Circa 8,100 ricerche mensili negli Stati Uniti riguardano ai powered coding agent e mostrano un intento commerciale. Ai team non serve un'altra classifica generica dei modelli: serve sapere se le attività sui loro repository superano i controlli con gpt-6-sol, gpt-6.1-sol e Astra usando gli stessi prompt, strumenti e criteri.
La versione minima vendibile è una CLI abbinata a un'azione CI. Il team fornisce cinque fixture JSON, un comando di verifica e l'elenco degli strumenti consentiti. Il banco di prova esegue ciascun modello, registra risultati accettati, latenza, token nuovi e nella cache, tentativi e costo, quindi restituisce una decisione sulla promozione. Il limite è che i runner di valutazione generici sono facili da copiare. La difesa competitiva risiede nella libreria di fixture pratiche per la programmazione, nelle integrazioni e nelle diagnosi utili degli errori.
2. Un router di effort e costi per agenti operativi
Circa 1,000 ricerche mensili negli Stati Uniti riguardano ai workflow automation, con intento commerciale e un CPC di $37.80. È un mercato che cerca lavoro portato a termine, non un'altra chat. Un router potrebbe inviare i casi circoscritti a low, il normale lavoro in più passaggi a medium, gli errori complessi a high e soltanto i casi irrisolti residui ad Astra.
Per un MVP servono una coda, tre policy di effort, una funzione di accettazione e una dashboard di spesa. Il prodotto può essere proposto a team operativi che già pagano per più automazioni. Il rischio è un falso senso di sicurezza: un router economico che classifica male un singolo caso rilevante può annullare tutti i risparmi. Fin dal primo giorno servono fixture riproducibili e un override manuale.
3. Un livello di accettazione per agenti documentali
ai document analysis registra circa 1,000 ricerche mensili negli Stati Uniti e un CPC di $10.44. Il prodotto non è l'ennesima schermata per caricare e riassumere file. È un livello di verifica che controlla se l'agente documentale ha trovato tutti i campi richiesti, conservato le citazioni, riconciliato i totali e segnalato le incertezze.
La versione minima supporta un singolo pacchetto ricorrente, per esempio contratti di fornitori o PDF finanziari mensili, con schema fisso e coda delle eccezioni. GPT-6.1 Sol gestisce l'analisi ripetitiva; Astra riceve soltanto i casi contestati o incompleti. Il limite è la specificità del dominio. Un prodotto orizzontale e troppo ampio apparirà generico, mentre un pacchetto ristretto con controlli credibili può conquistare fiducia.
Quando conviene tenere GPT-6 Sol o pagare per Astra
GPT-6 Sol resta la scelta giusta quando il vincolo è la compatibilità. Accetta ancora il reasoning none e può chiamare funzioni tramite Chat Completions quando reasoning_effort è none. GPT-6.1 Sol non può farlo. Un percorso stabile che dipende da questi comportamenti deve prima migrare il proprio endpoint API e superare i test di regressione, poi cambiare modello.
Conviene pagare per GPT-6 Astra quando il risultato migliore conta più della spesa in token. OpenAI lo presenta come il modello più capace per le attività più impegnative di ragionamento, programmazione, computer use, ricerca e creazione di documenti. Va riservato alla coda ambigua e di alto valore in cui una valutazione prestabilita dimostra un miglioramento concreto. Alle tariffe Standard, Astra costa $10 per l'input e $50 per l'output per milione di token, contro $2 e $10 per GPT-6.1 Sol.
GPT-6.1 Sol copre l'ampia fascia intermedia: lavoro serio e ripetibile basato su Responses, con un criterio di successo misurabile. Le valutazioni di lancio di OpenAI riportano risultati migliori rispetto a GPT-6 Sol in diversi carichi di lavoro complessi, ma restano valutazioni condotte dal fornitore. Il vero gate di rilascio è il tasso di risultati accettati nei propri test.
I limiti che cambiano la configurazione
GPT-6.1 Sol non sostituisce ogni percorso. Non offre effort none o minimal, chiamate agli strumenti tramite Chat Completions, fine-tuning, input audio o video, né accesso alla Chat ordinaria al lancio. Gli strumenti a pagamento hanno costi aggiuntivi. Inoltre, una richiesta con più di 272,000 token di input fa sì che l'intera richiesta passi alle tariffe superiori per il contesto lungo: una finestra da 1,050,000 token non va quindi considerata spazio di lavoro gratuito.
L'altro limite da dichiarare con chiarezza riguarda Ultrafast. OpenAI ha annunciato una generazione di token fino a 8x più veloce rispetto alla modalità standard in Codex, ma l'ha descritta come una funzione in arrivo. Finché non compare nell'account e nel client utilizzati, bisogna basare i piani su Standard o Fast e misurare la latenza realmente ottenuta.
Cosa fare lunedì
Selezionare cinque lavori completati di recente dall'agente attuale: un successo semplice, due attività normali, un'attività che usa intensamente gli strumenti e un errore noto. Eseguire le stesse fixture con GPT-6.1 Sol a medium, senza modificare prompt o autorizzazioni. Registrare superamento o fallimento, tempo trascorso, input nuovo, input nella cache, output, tentativi e costi degli strumenti.
Poi instradare il lavoro, senza proclamare un vincitore. Spostare su low le attività circoscritte se continuano a superare i controlli. Provare high soltanto sugli errori che richiedono più ragionamento. Mantenere su GPT-6 Sol i client vincolati dalla compatibilità. Inviare ad Astra i casi residui più costosi solo quando il miglioramento del tasso di accettazione ne giustifica il prezzo. In questo modo si ottiene una decisione di produzione già questa settimana, non una semplice opinione sul modello.
Domande frequenti
Che cos'è GPT-6.1 Sol?
GPT-6.1 Sol è il modello OpenAI a costo inferiore per attività complesse di programmazione, computer use e lavoro professionale. Il suo ID API è gpt-6.1-sol e le chiamate agli strumenti passano dalla Responses API.
Che cosa sono gli agenti AI per la programmazione?
Gli agenti AI per la programmazione possono esaminare un repository, modificare file, eseguire comandi e test e restituire un risultato entro le autorizzazioni definite. L'unità di valore è un risultato testato, non il solo codice generato.
ChatGPT ha un agente di programmazione?
Sì. Codex è l'agente di programmazione di OpenAI e GPT-6.1 Sol è disponibile nel suo rollout per i piani a pagamento. Il modello è presente anche in ChatGPT Work, ma non è ancora disponibile nella Chat ordinaria.
GPT-6 Sol costa meno?
Non per input nuovo o output: entrambi i modelli Sol indicano $2 per l'input e $10 per l'output per milione di token Standard. GPT-6.1 Sol ha la tariffa inferiore per l'input nella cache. Il confronto completo tra i modelli Sol approfondisce differenze di prezzo e compatibilità.
Per progettare, testare e mettere in produzione uno di questi percorsi agentici per la propria azienda, consultare i sistemi AI per la produzione.
- Ultimo aggiornamento
- 30 set 2026
- Categoria
- AI
Preferisca questo sito su Google


Segni omidsaffari.com come fonte preferita e Google lo mette in evidenza per lei in Top Stories, AI Overviews e AI Mode.
GPT-6.1 Sol o GPT-6 Sol: prezzi, benchmark e migrazione
GPT-6.1 Sol dimezza il costo dell’input in cache, ma cambia compatibilità. Confronta prezzi, benchmark e migrazione prima di sostituire GPT-6 Sol.30 set 2026AI
Claude Sonnet 5.5: guida pratica per iniziare e usarlo bene
Scopri come usare Claude Sonnet 5.5 con l'effort giusto, costi reali, workflow verificabili e una migrazione API sicura per attività di produzione.28 set 2026AI
Jev o GLM-5.3-Flash: quale scegliere per il routing AI?
Confronto tra Jev e GLM-5.3-Flash su costi, accuratezza, latenza, immagini e portabilità, con un test pratico per scegliere il workflow giusto.27 set 2026AI
Claude Opus 5.5: vale il passaggio da Opus 5?
Claude Opus 5.5 costa meno, ma cinque modifiche API possono davvero bloccare la migrazione. Prezzi, benchmark e percorso di test rispetto a Opus 5.23 set 2026AI
Quale modello GPT-6 scegliere: Sol o Luna?
Confronta GPT-6 Sol e Luna per prezzi API, qualità nel coding e costi di revisione. Scopri quando conviene partire da Luna e quando passare a Sol.23 set 2026AI
GPT-6 Luna gratis: dove usarlo e quanto costa davvero
GPT-6 Luna è gratis nell’app desktop per gli utenti Free e Go. Scopri dove funziona, quali piani lo includono e quanto costa davvero usare l’API.22 set 2026AI
MiMo AI V2.6: dalla prova in Studio alla prima API
Scopri come provare MiMo AI V2.6 in Studio, configurare chiavi e API corrette e portare in produzione un primo flusso di lavoro verificabile.22 set 2026AI