Agente de IA: o custo mensal de planos, plataformas e APIs
Compare assinaturas, plataformas no-code e APIs para um agente de IA, com três orçamentos mensais e os custos de uso, revisão humana e manutenção.
Para um agente de IA que prepara respostas a 1,000 e-mails de suporte por mês, os orçamentos de software calculados abaixo ficam em $82 com um serviço pronto, no equivalente a $25.50 por mês com uma plataforma hospedada cobrada anualmente e em $10.50 com um fluxo próprio via API. Todas as opções ainda exigem revisão humana, uma caixa de entrada e alguém responsável quando algo falha. O número que ajuda a decidir é o custo mensal por resposta aprovada.
Agente de IA: três formas de pagar pelo mesmo trabalho
Um agente de IA usa um modelo para executar uma tarefa e realizar ações nas suas ferramentas. No suporte, isso pode significar ler um e-mail, encontrar a política aplicável e preparar uma resposta. Contratar apenas o modelo não inclui a conexão com a caixa de entrada, o processo de aprovação nem o serviço de suporte completo.
A conta depende de quanto desse sistema você contrata:
- Um agente pronto: você paga por um assistente configurado, geralmente por assinatura ou por usuário. Cada licença corresponde a uma conta de usuário paga. A assinatura também pode ter franquias de uso.
- Uma plataforma no-code: você conecta as etapas e paga por créditos, tarefas ou execuções de fluxo. Uma execução é uma rodada completa do fluxo; um crédito é a unidade que o fornecedor usa para medir o trabalho cobrado.
- Um fluxo próprio via API: seu software chama um modelo por uma API, a interface usada por programas para solicitar trabalho. Você paga pelos tokens, os fragmentos de texto que o modelo lê e gera, além da hospedagem e de eventuais ferramentas pagas.
São três formas de contratar o mesmo trabalho, cada uma com suas responsabilidades. Quem fundou uma empresa pode contratar a criação de rascunhos na caixa de entrada. Quem gerencia operações pode montar o fluxo. Uma equipe de backend pode assumir o software que executa tudo.
Os preços deste artigo foram conferidos nas páginas dos fornecedores em 7 de outubro de 2026. Os valores em dólares são USD. As tarifas anuais estão identificadas, e os totais calculados são projeções com premissas explícitas, não testes de desempenho. Registre as horas de configuração separadamente da despesa recorrente.
Preços atuais dos fornecedores e o que cada um cobra
As linhas dos modelos usam tarifas comuns, sem cache, descontos por processamento em lote ou adicionais de velocidade. Modelos diferentes podem consumir quantidades diferentes de tokens e produzir respostas de qualidade diferente para o mesmo e-mail. Uma tarifa menor só vale a pena quando as respostas atendem ao padrão do seu suporte.
As outras linhas exigem o mesmo cuidado. O preço de entrada do Lindy não garante 1,000 respostas: a criação de rascunhos faz parte de uma faixa ampla de 2 a 250 créditos para tarefas do dia a dia, e o envio de um e-mail exige aprovação. Cada usuário ativo adicional exige outra licença paga. Regras de uso e aprovação do Lindy.
Os créditos do Gumloop cobrem mais do que texto. Pelas regras atuais de cobrança por uso, cada crédito vale $0.005; cada chamada bem-sucedida de conector custa pelo menos 1 crédito; e cada minuto de sessão ativa custa 5 créditos, antes da taxa padrão de orquestração de 8%. Como o Gumloop contabiliza os créditos.
Usar sua própria chave de modelo mantém as cobranças por ferramentas e computação e altera a taxa do agente para 16% pela política atual de cobrança por uso; contas mais antigas podem seguir regras anteriores. Essa taxa considera quanto a execução inteira teria custado, incluindo o uso do modelo transferido para o seu fornecedor. Não a calcule apenas sobre o valor restante das ferramentas.
Quanto custa um agente de IA para responder a 1,000 e-mails por mês?
Vamos definir o trabalho. Uma pequena empresa recebe 1,000 e-mails de suporte distintos que podem ser respondidos com base na política que ela já tem. O fluxo prepara as respostas, e uma pessoa revisa e envia as que foram aprovadas.
Reserve 100 tentativas adicionais de rascunho, chegando a 1,100 tentativas no total. Essa é uma margem de planejamento de 10%, não uma afirmação sobre a taxa de novas tentativas de qualquer produto. Os exemplos não incluem anexos, buscas na internet ou enriquecimento de dados pago; a caixa de entrada existente fica fora do novo subtotal de software.
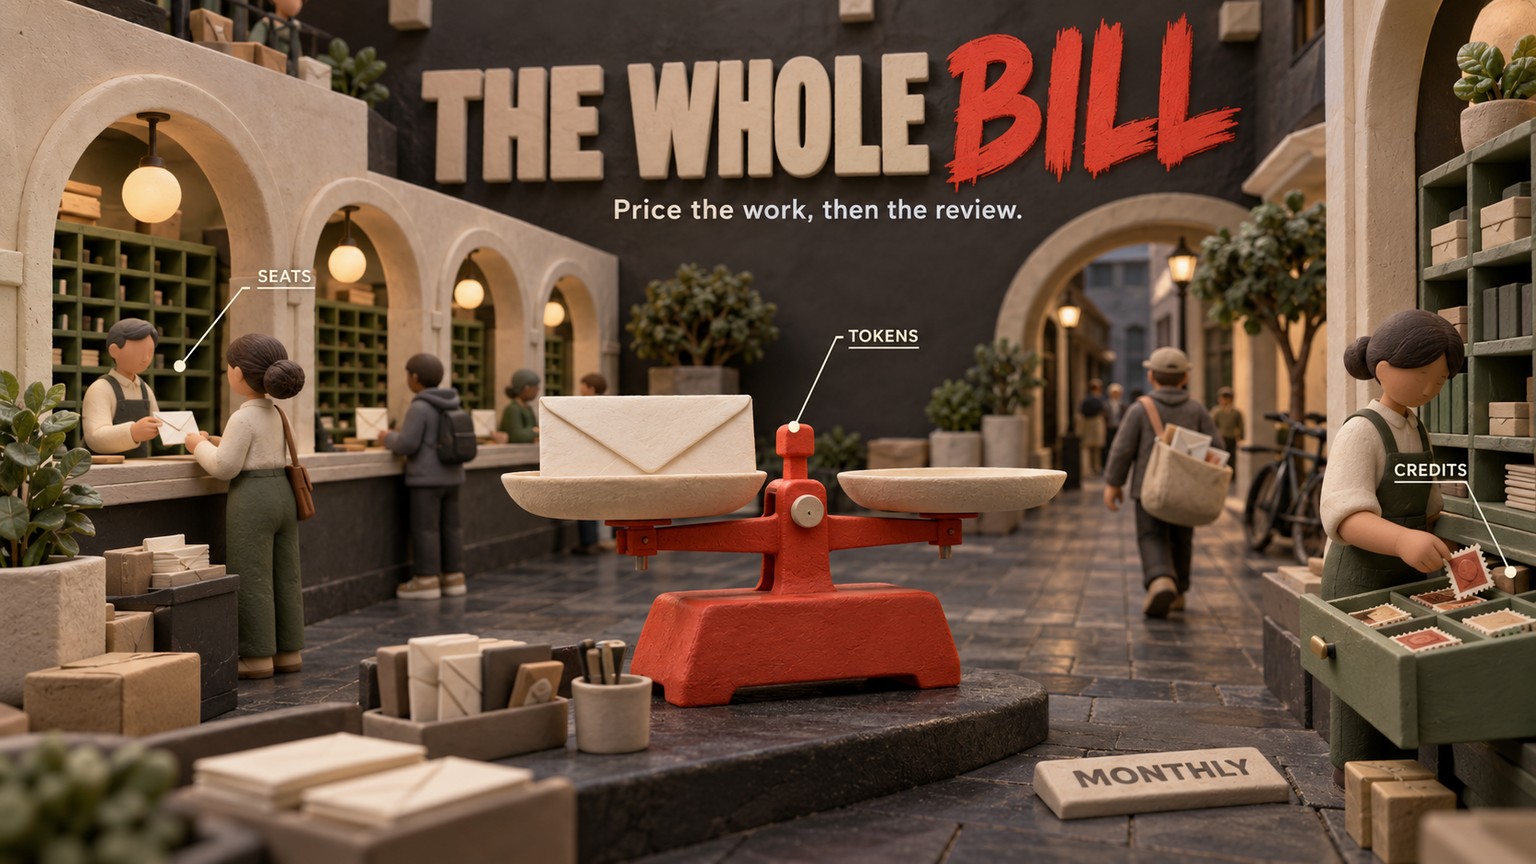
As projeções para a plataforma de criação e para a API consideram 3,000 tokens de entrada e 400 tokens de saída cobrados por tentativa completa. Essas quantidades cobrem uma única chamada ao modelo; um fluxo com várias chamadas precisa somar o consumo de todas elas. O serviço pronto define o próprio consumo interno de modelos, por isso o que importa é a unidade de cobrança por tarefa que ele publica.
Opção 1: $82/mês no Marblism para organizar e redigir e-mails
Quem fundou uma empresa SaaS e usa a Eva do Marblism paga a partir de uma franquia compartilhada de horas. São valores fixos por tarefa, não um cronômetro que mede por quanto tempo a IA executa: organizar um e-mail novo consome 20 segundos, e preparar um rascunho de resposta consome 5 minutos. Valores por tarefa e faixas de capacidade do Marblism.
Para este trabalho:
- Organizar 1,000 e-mails novos: 1,000 × 20 segundos = 5.56 horas.
- Solicitar 1,100 rascunhos de resposta, incluindo as tentativas extras: 1,100 × 5 minutos = 91.67 horas.
- Total de trabalho contabilizado: 97.22 horas.
Isso cabe no plano de 100 horas por $82, com cobrança mensal. Não cabe no plano básico de 50 horas por $44. Na opção anual, o plano de 100 horas custa $45/mês, com cobrança anual. Os outros trabalhos de IA da conta inteira usam essa mesma franquia.
A Eva prepara os rascunhos na sua caixa de entrada; uma pessoa revisa e clica em enviar. Portanto, esse orçamento cobre a preparação assistida de respostas de suporte, e a aprovação continua sendo sua responsabilidade. Como a Eva trabalha com respostas.
Há também um detalhe que pode estourar a capacidade. O Marblism contabiliza separadamente cada ação de integração com aplicativo ou execução de automação como 25 segundos. Se a configuração acrescentar uma dessas ações a cada tentativa, serão mais 7.64 horas, elevando o total a 104.86 horas. Você precisaria do plano de 150 horas por $120/mês. A estimativa de $82 cobre apenas as funções nativas de organização e criação de rascunhos; confira o detalhamento de uso antes de acrescentar outras ações.
Opção 2: n8n com Claude sai pelo equivalente a $25.50/mês
Quem gerencia operações de e-commerce pode conectar os e-mails de suporte recebidos, a política aplicável e uma chamada ao modelo, depois salvar um rascunho para revisão. A integração do n8n com o Gmail permite ler mensagens e criar rascunhos, e a integração com a Anthropic permite usar sua própria chave de API. Operações do Gmail, credenciais da Anthropic.
Considere uma configuração que gere uma execução completa do fluxo por tentativa. As 1,100 execuções cabem na franquia de 2,500 execuções do Starter. Cada etapa dentro de uma execução não conta como outra execução, mas as execuções extras disparadas também precisam caber na cota. Como o n8n define uma execução e cobra pelo plano.
Com sua própria chave da Anthropic, a conta do modelo é separada:
1,100 × 3,000 = 3.3 milhões de tokens de entrada.
1,100 × 400 = 0.44 milhão de tokens de saída.
Pelas tarifas verificadas do Haiku, 3.3 × $1 + 0.44 × $5 = $5.50. Some o equivalente a $20/mês do plano anual, e o orçamento de software chega ao equivalente a $25.50/mês. O Starter já inclui hospedagem pelo n8n, por isso este exemplo não acrescenta outra assinatura de hospedagem.
Também é preciso distinguir os dois saldos de créditos do n8n. Os créditos do Assistant pagam pela ajuda para criar fluxos e resolver problemas. Os créditos do Gateway pagam pelos modelos chamados durante a execução dos fluxos. Este exemplo usa sua própria chave da Anthropic em vez de créditos do Gateway. A franquia do Assistant não cobre essa conta do modelo. Os dois sistemas de créditos.
Opção 3: $10.50/mês com fluxo próprio via API do Claude e hospedagem
Uma equipe de backend pode executar o mesmo fluxo de escopo definido em sua própria aplicação: receber o e-mail, fornecer a política, solicitar um rascunho e salvá-lo para revisão humana. Com as mesmas quantidades de tokens previstas, o Haiku continua custando $5.50/mês.
Para dar um valor concreto à hospedagem, o Cloudflare Workers Paid parte de $5 por conta por mês, incluindo 10 milhões de requisições e 30 milhões de milissegundos de CPU. O exemplo pressupõe que a aplicação e seu pequeno repositório de dados fiquem dentro das franquias incluídas. Preços do Workers e dos serviços de dados incluídos.
O subtotal de software é $5.50 + $5 = $10.50/mês. Isso pressupõe uma caixa de entrada existente, nenhuma ferramenta paga opcional e nenhum outro trabalho consumindo a franquia da conta. O Workers também tem um plano Free; é preciso conferir separadamente se os limites atendem à sua implementação.
Mantendo as quantidades de tokens constantes, o Sonnet custaria $11 em tokens, ou $16 com essa hospedagem. O GPT-6 Luna custaria $0.55 em tokens, ou $5.55 com hospedagem. São comparações de tarifas, não evidências de que os três modelos lidam igualmente bem com os seus e-mails.
O baixo subtotal da API vem com a responsabilidade de cuidar do sistema: sua equipe mantém a conexão com a caixa de entrada, o armazenamento dos rascunhos, o tratamento de erros e o comportamento do modelo. O guia de preços da API do Claude aprofunda tarifas de modelos, cache e processamento em lote para quando você já tiver medido a carga de trabalho.
Como estimar os tokens de uma tarefa?
Comece por tudo o que o modelo recebe, não apenas pelo e-mail do cliente. Instruções, mensagens anteriores, trechos da política, descrições de ferramentas e resultados dessas ferramentas podem compor os tokens de entrada. Cada chamada posterior ao modelo pode processar parte desse material novamente. Como o Claude contabiliza tokens no uso de ferramentas.
Para uma planilha inicial, suponha que as instruções usem 800 tokens, o e-mail e o histórico da conversa usem 400, e a política aplicável use 1,800. Isso dá 3,000 tokens de entrada. Considere 400 tokens de saída cobrados para o rascunho. São premissas de planejamento a serem substituídas por medições, não quantidades típicas prometidas por um fornecedor.
Conte toda a entrada para o modelo escolhido
Envie a requisição completa ao endpoint de contagem de tokens do modelo. O contador do Claude é gratuito e específico para cada modelo, mas fornece uma estimativa; requisições que usam a maioria das ferramentas hospedadas ou conexões com ferramentas externas precisam dos dados reais de uso retornados na resposta. Um atalho baseado em contagem de palavras não determina a conta. Contagem de tokens do Claude.
Meça a tarefa até o fim
Processe e-mails representativos na sua configuração real. Registre a entrada e a saída cobradas em todas as chamadas ao modelo, incluindo rascunhos extras e novas tentativas. Se ativar o cache, registre esse uso separadamente. Em uma plataforma que cobra por créditos, consulte o detalhamento completo da tarefa: no Gumloop, a contagem de créditos no cabeçalho do chat abre o painel de detalhes. Detalhamento de custos do Gumloop.
Multiplique pelas tentativas e some a despesa fixa
Custo por tentativa = (tokens de entrada × tarifa de entrada + tokens de saída × tarifa de saída) ÷ 1,000,000. Custo mensal de tokens = esse custo × tentativas mensais. Depois, some a taxa da plataforma ou da hospedagem e as ferramentas cobradas separadamente.
No Haiku, (3,000 × $1 + 400 × $5) ÷ 1,000,000 = $0.005 por tentativa. Com 1,100 tentativas, chegamos aos $5.50 usados acima. Se uma tarefa precisar de várias chamadas, some os custos delas antes de multiplicar pelo número de tarefas mensais; não calcule apenas o custo do rascunho final.
Quais custos costumam ficar fora da conta?
Revisão humana e correções. Com a premissa de 30 segundos por e-mail aprovado, revisar 1,000 respostas leva 500 minutos, ou 8.33 horas. Com um minuto por resposta, são 16.67 horas. Multiplique as horas medidas de revisão, correção e encaminhamento pelo custo completo da sua hora de trabalho, incluindo encargos. Compare com o tempo que a mesma fila de atendimento consumia antes.
Novas tentativas e decisões extras. Os exemplos reservam 100 tentativas adicionais. Seu agente também pode classificar a solicitação, buscar informações e conferir o rascunho em chamadas separadas ao modelo. Inclua essas chamadas e o trabalho que falhou na conta mensal, mesmo quando só a resposta aprovada conta como resultado.
Chamadas de ferramentas. Uma conta baixa de tokens não inclui todas as ferramentas. A busca na web do Claude custa $10 por 1,000 buscas, mais os tokens dos resultados. Uma busca por tentativa neste exemplo acrescentaria $11 em taxas de busca, além de mais tokens de entrada. Um agente de suporte que responde com base na sua própria política pode não precisar de nenhuma. Preço das buscas do Claude.
Dados e outras APIs. Confira os serviços de e-mail, helpdesk, CRM, banco de dados, armazenamento de documentos e enriquecimento de dados usados pelo fluxo. Um conector incluído oferece a conexão; ele não paga automaticamente a assinatura ou a conta de uso do serviço conectado. Deixe visíveis os custos existentes e os novos para calcular tanto o orçamento operacional total quanto o gasto adicional criado pelo agente.
Manutenção e capacidade. Alguém ainda precisa corrigir credenciais que pararam de funcionar, documentos de política desatualizados e mudanças de comportamento. Registre o tempo dessa pessoa. As franquias das assinaturas também têm limites: outros trabalhos podem consumir as mesmas horas ou os mesmos créditos e exigir um plano maior.
Para agentes de helpdesk cobrados por resoluções concluídas, o guia de suporte ao cliente com solução própria ou contratada aborda essa outra decisão de compra. Avalie os custos e benefícios desse projeto separadamente da projeção de software recorrente apresentada aqui.
O que medir nos primeiros 30 dias?
- Resultados: e-mails recebidos, respostas aprovadas, chamados reabertos e casos encaminhados a uma pessoa.
- Cada unidade de cobrança: usuários pagos, horas, créditos, execuções, tokens de entrada e saída e chamadas de ferramentas cobradas.
- Trabalho extra: tentativas por resposta aprovada, correções e execuções repetidas.
- Tempo humano: revisão, encaminhamentos e manutenção, em comparação com o fluxo anterior.
- Outras cobranças: hospedagem, armazenamento, APIs conectadas e o próximo plano com mais capacidade.
- Custo por resposta aprovada: todos os custos de software, ferramentas e trabalho humano atribuíveis ao serviço, divididos pelo número de respostas aprovadas. Acompanhe o custo por resolução separadamente se você mede chamados encerrados.
Escolha uma forma de contratação que consiga manter
Quem fundou uma empresa SaaS e quer rascunhos na caixa de entrada ainda nesta semana pode começar com um assistente pronto. Antes de contratar, confira se a franquia cobre toda a fila e defina quem vai revisar. A vantagem é ter um ambiente pronto para trabalhar; o número a acompanhar é o de respostas aprovadas por mês pago.
Quem gerencia operações de e-commerce e precisa combinar e-mails, políticas e dados de pedidos pode usar uma plataforma de criação. Teste o fluxo completo em um piloto e consulte o detalhamento de execuções ou créditos. Inclua as consultas pagas a dados de pedidos antes de comparar a conta com a de um serviço mais simples de criação de rascunhos.
Uma liderança de backend com alguém disponível para manter o fluxo pode optar pela API. Comece com uma tarefa de suporte de escopo definido e avalie o modelo de menor custo que atenda ao seu padrão de resposta. A economia de tokens só ajuda se o tempo contínuo de engenharia e revisão couber no orçamento.
O mesmo método vale para outras áreas. Uma liderança de vendas deve contar cada mensagem de acompanhamento e cada ação de enriquecimento de dados, não apenas os leads contatados. Quem trabalha em operações financeiras deve contar as consultas a dados, as chamadas ao modelo e a revisão de cada relatório programado, depois comparar o relatório aprovado com o tempo de trabalho manual que ele substitui.
Espere para ampliar o uso autônomo se você ainda não consegue definir o que é um resultado correto ou quem trata as exceções. Se o fluxo atual, baseado em regras, já executa a tarefa de forma confiável, acrescentar um modelo cria uma nova conta sem um retorno comprovado.
Receba mais análises práticas de ferramentas e orçamentos na newsletter.
- Última atualização
- 7 de out. de 2026
- Categoria
- Explained
Prefira este site no Google


Marque omidsaffari.com como fonte preferida e o Google destaca o site para você em Top Stories, AI Overviews e AI Mode.

Converter áudio em texto com Grok 2.0 custa $0.10/h no modo batch
Entenda como converter áudio em texto com Grok Voice Transcribe 2.0, por que o batch segue em $0.10 por hora e como evitar mudanças silenciosas na API.20 de set. de 2026Explained
Automação de navegador: como investigar falhas no Cloudflare Browser Run
O novo painel Inspect do Cloudflare Browser Run reúne logs, rede e DOM final para diagnosticar falhas antes de executar a automação de navegador novamente.19 de set. de 2026Explained
Design system privado no v0: componentes reais desde o protótipo
Veja como conectar um design system privado ao v0 com NPM_TOKEN ou NPM_RC, proteger credenciais e reduzir retrabalho na passagem para produção.19 de set. de 2026Explained
Claude Code preço: como a versão 2.1.278 corta cobranças do modo automático
Veja quando o Claude Code 2.1.278 deixa de cobrar o classificador do modo automático, como validar a sessão e por que gateways ainda podem gerar custos.19 de set. de 2026Explained
Deploy Vercel com Turbo: mais velocidade só quando importa
Aprenda a acelerar um deploy Vercel urgente com Turbo sem mudar a configuração do projeto e calcule quanto o tempo economizado acrescenta à fatura.18 de set. de 2026Explained
ChatGPT Word elimina o copia e cola entre aplicativos
O ChatGPT Word cria rascunhos, resume e revisa textos sem sair do documento. Veja como instalar, controlar custos e evitar mudanças sem revisão.18 de set. de 2026Explained
Google Antigravity: migre os jobs locais até 5 de outubro
Mantenha os jobs do Google Antigravity ativos após 5 de outubro: veja quais integrações exigem novo adaptador e quais só precisam trocar o ID do agente.18 de set. de 2026Explained