Agente AI: tre modelli di costo e i conti da fare
Quanto costa un agente AI per 1,000 email al mese? Confronta servizi pronti, piattaforme no-code e API, con esempi di budget e spese spesso trascurate.
Per un agente AI che prepara risposte a 1,000 email di assistenza al mese, gli esempi qui sotto prevedono una spesa software di $82 per un servizio pronto all’uso, di $25.50 al mese come costo equivalente per una piattaforma di creazione con hosting e fatturazione annuale, e di $10.50 per un workflow sviluppato con le API. In tutti i casi servono anche una verifica umana, una casella email e qualcuno che intervenga quando qualcosa non funziona. Il dato da valutare è il costo mensile di una risposta approvata.
Agente AI: tre modi per pagare lo stesso lavoro
Un agente AI usa un modello per svolgere un compito e compiere azioni negli strumenti aziendali. Nell’assistenza clienti, per esempio, può leggere un’email, trovare le condizioni pertinenti e preparare una risposta. Acquistare l’accesso al modello non include il collegamento alla casella email, il processo di approvazione o un servizio di assistenza completo.
La spesa dipende da quanta parte del sistema si acquista già pronta:
- Un agente pronto all’uso: si paga un assistente già configurato, di solito con un abbonamento o una licenza per utente. Ogni licenza corrisponde a un account a pagamento. L’abbonamento può comunque prevedere limiti di utilizzo.
- Una piattaforma no-code: si collegano autonomamente le varie fasi e si paga in base a crediti, attività o esecuzioni dei workflow. Un’esecuzione è un ciclo completo; un credito è l’unità con cui il fornitore misura il lavoro a consumo.
- Un workflow sviluppato con le API: il proprio software richiama un modello tramite un’API, l’interfaccia con cui i programmi inviano richieste. Si pagano i token, cioè le porzioni di testo che il modello legge e genera, oltre all’hosting e agli eventuali strumenti a pagamento.
Sono tre modi per acquistare lo stesso lavoro, ciascuno con responsabilità diverse. Un fondatore può acquistare un servizio che prepara bozze nella casella email. Un responsabile operativo può comporre il workflow. Un team backend può gestire il software che lo esegue.
I prezzi riportati sono stati verificati sui siti dei fornitori il 7 ottobre 2026. Tutti gli importi in dollari sono in USD. Le tariffe annuali sono indicate come tali e i totali degli esempi sono previsioni basate sulle ipotesi dichiarate, non risultati di test delle prestazioni. Le ore di configurazione vanno registrate separatamente dai costi ricorrenti.
Quanto costa un agente AI? Le tariffe e le unità di fatturazione
Le righe dedicate ai modelli riportano le tariffe ordinarie, senza caching, sconti per l’elaborazione in batch o maggiorazioni per la velocità. La stessa email può produrre conteggi di token e risposte di qualità diversa a seconda del modello. Una tariffa più bassa conviene solo se le risposte soddisfano lo standard di assistenza richiesto.
Anche le altre righe vanno lette con attenzione. Il prezzo di ingresso di Lindy non garantisce 1,000 risposte: la preparazione delle bozze rientra nell’ampia fascia di 2–250 crediti prevista per le attività quotidiane, e l’invio di un’email richiede un’approvazione. Ogni utente attivo aggiunto comporta un’altra licenza a pagamento. Regole di Lindy su utilizzo e approvazioni.
I crediti di Gumloop non coprono soltanto il testo. Le attuali regole di fatturazione a consumo attribuiscono a un credito il valore di $0.005, addebitano almeno 1 credito per ogni chiamata riuscita a un connettore e 5 crediti per ogni minuto di sessione attiva, prima della commissione ordinaria di orchestrazione dell’8%. Come Gumloop conteggia tutti i crediti.
Usare una propria chiave API per il modello non elimina i costi degli strumenti e della capacità di calcolo. Secondo le attuali regole a consumo, inoltre, la commissione per l’agente passa al 16%; gli account meno recenti possono seguire regole precedenti. La base di calcolo è quanto sarebbe costata l’intera esecuzione, compreso l’utilizzo del modello spostato sul proprio fornitore. La commissione non va quindi calcolata soltanto sui costi residui degli strumenti.
Lo stesso compito: rispondere a 1,000 email di assistenza al mese
Partiamo da un caso concreto. Una piccola impresa riceve 1,000 email di assistenza distinte, alle quali si può rispondere usando le condizioni già in vigore. Il workflow prepara le risposte; una persona le controlla e invia quelle approvate.
Prevediamo 100 tentativi aggiuntivi di preparazione delle bozze, per un totale di 1,100 tentativi. Il margine del 10% serve a pianificare la spesa: non descrive la frequenza dei tentativi ripetuti di alcun prodotto. Gli esempi escludono allegati, ricerche sul web e arricchimento dei dati a pagamento; il costo della casella email esistente resta fuori dal subtotale del nuovo software.
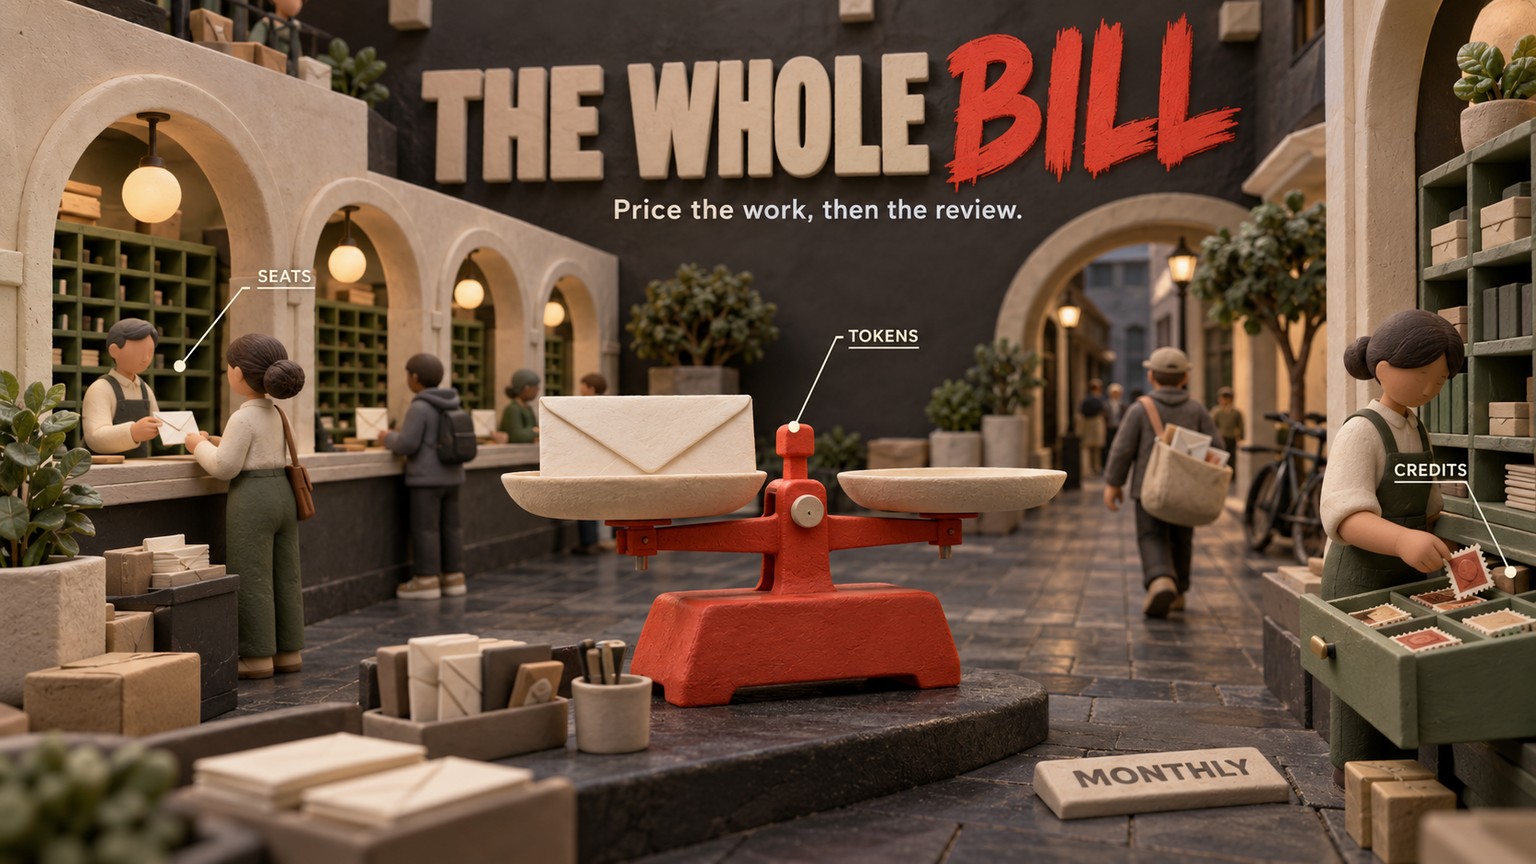
Le previsioni per la piattaforma di creazione e per le API ipotizzano 3,000 token di input e 400 token di output fatturati per ogni tentativo completo. Questi conteggi coprono una sola chiamata al modello: se il workflow ne effettua diverse, bisogna sommarne i consumi. Il servizio pronto all’uso gestisce internamente l’utilizzo del modello, quindi conta l’unità di consumo pubblicata per le sue attività.
Opzione 1: $82/mese con Marblism per preparare le bozze con le funzioni native
Un fondatore SaaS che usa Eva di Marblism attinge a un monte ore condiviso. Ogni attività ha un valore fisso: non si cronometra il tempo durante il quale l’AI lavora. Smistare una nuova email consuma 20 secondi; preparare una bozza di risposta consuma 5 minuti. Valori delle attività e fasce di capacità di Marblism.
Per questo compito:
- Smistare 1,000 nuove email: 1,000 × 20 secondi = 5.56 ore.
- Richiedere 1,100 bozze di risposta, compresi i tentativi aggiuntivi: 1,100 × 5 minuti = 91.67 ore.
- Lavoro totale conteggiato: 97.22 ore.
Il totale rientra nel piano da 100 ore a $82 con fatturazione mensile. Il piano base da 50 ore a $44 non basta. Con l’opzione annuale, la fascia da 100 ore costa $45/mese, con fatturazione annuale. Le altre attività AI dell’intero account consumano lo stesso monte ore.
Eva prepara le bozze nella casella email; una persona le controlla e preme il pulsante di invio. Questo budget copre quindi risposte di assistenza preparate con l’aiuto dell’AI, mentre l’approvazione resta a carico dell’azienda. Come Eva gestisce le risposte.
C’è anche un limite di capacità a cui fare attenzione. Marblism conteggia separatamente un’azione tramite integrazione con un’app o un’esecuzione di automazione: 25 secondi ciascuna. Se la configurazione aggiunge una di queste azioni a ogni tentativo, servono altre 7.64 ore, per un totale di 104.86 ore. Occorre allora la fascia da 150 ore a $120/mese. La stima di $82 copre solo lo smistamento e la preparazione delle bozze con le funzioni native: prima di aggiungere altre azioni, va verificato il dettaglio dei consumi.
Opzione 2: n8n e Claude per un costo mensile equivalente di $25.50
Un responsabile operativo ecommerce può collegare le email di assistenza in arrivo, le condizioni pertinenti e una chiamata al modello, quindi salvare una bozza da verificare. L’integrazione Gmail di n8n permette di leggere i messaggi e creare bozze; l’integrazione con Anthropic consente di usare una propria chiave API. Operazioni disponibili per Gmail, credenziali Anthropic.
Ipotizziamo che la configurazione generi un’esecuzione completa del workflow per ogni tentativo. 1,100 esecuzioni rientrano nelle 2,500 incluse in Starter. I singoli passaggi di un’esecuzione non vengono conteggiati come esecuzioni aggiuntive, ma le ulteriori esecuzioni attivate devono comunque rientrare nel limite del piano. Come n8n definisce le esecuzioni e che cosa include il piano.
Con una propria chiave Anthropic, il modello viene fatturato separatamente:
1,100 × 3,000 = 3.3 milioni di token di input.
1,100 × 400 = 0.44 milioni di token di output.
Alle tariffe verificate di Haiku, il calcolo è 3.3 × $1 + 0.44 × $5 = $5.50. Aggiungendo il costo equivalente di $20/mese del piano annuale, il budget software arriva a $25.50/mese come costo equivalente. Starter include l’hosting gestito da n8n, quindi questo esempio non aggiunge un abbonamento separato per l’hosting.
È anche necessario distinguere i due saldi di crediti di n8n. Gli Assistant credits pagano l’aiuto per creare i workflow e risolverne i problemi. I Gateway credits pagano i modelli richiamati durante l’esecuzione dei workflow. Questo esempio usa una propria chiave Anthropic invece dei Gateway credits. I crediti inclusi per Assistant non coprono quella fattura del modello. I due sistemi di crediti.
Opzione 3: workflow con le API di Claude e hosting per $10.50/mese
Un team backend può eseguire lo stesso workflow, con un perimetro definito, nella propria applicazione: ricevere l’email, fornire le condizioni, richiedere una bozza e salvarla per la verifica umana. Con gli stessi consumi ipotizzati di token, Haiku costa ancora $5.50/mese.
Per dare un valore concreto all’hosting, Cloudflare Workers Paid parte da $5 per account al mese e include 10 milioni di richieste e 30 milioni di millisecondi CPU. L’esempio presuppone che l’applicazione e il suo piccolo archivio dati restino entro le soglie incluse. Prezzi di Workers e dei servizi dati inclusi.
Il subtotale software è $5.50 + $5 = $10.50/mese. Si presume di avere già una casella email, di non usare strumenti opzionali a pagamento e di non avere altre attività che consumino la quota dell’account. Workers offre anche un piano Free; per capire se i suoi limiti sono adatti all’implementazione serve una verifica separata.
A parità di token, Sonnet costerebbe $11 in token, oppure $16 includendo quella voce di hosting. GPT-6 Luna costerebbe $0.55 in token, oppure $5.55 con l’hosting. Sono confronti tra tariffe: non dimostrano che tutti e tre i modelli gestiscano le email con la stessa qualità.
Il basso subtotale delle API comporta responsabilità di gestione: il team deve mantenere il collegamento alla casella email, l’archiviazione delle bozze, la gestione degli errori e il comportamento del modello. La guida ai prezzi delle API di Claude approfondisce tariffe dei modelli, caching ed elaborazione in batch, da valutare dopo aver misurato il carico di lavoro.
Come stimare i token necessari per un’attività
Il punto di partenza è tutto ciò che il modello riceve, non soltanto l’email del cliente. Istruzioni, messaggi precedenti, estratti delle condizioni, descrizioni degli strumenti e risultati delle loro chiamate possono contribuire ai token di input. Le chiamate successive al modello possono elaborare nuovamente parte di quel materiale. Come Claude conteggia i token per l’uso degli strumenti.
Per un primo foglio di calcolo, ipotizziamo 800 token per le istruzioni, 400 per l’email e la conversazione, e 1,800 per le condizioni pertinenti. Il totale è di 3,000 token di input. Per la bozza, ipotizziamo 400 token di output fatturati. Sono valori di pianificazione da sostituire con misurazioni, non consumi tipici garantiti da un fornitore.
Conteggiare l’input completo per il modello scelto
Invia la richiesta completa all’endpoint di conteggio dei token del modello. Il contatore di Claude è gratuito e specifico per ciascun modello, ma restituisce una stima; per le richieste che usano la maggior parte degli strumenti con hosting gestito o collegamenti a strumenti esterni, occorre invece rilevare l’utilizzo effettivo dalla risposta. Una scorciatoia basata sul numero di parole non permette di determinare la fattura. Conteggio dei token di Claude.
Misurare l’attività dall’inizio alla fine
Elabora email rappresentative con la configurazione reale. Registra input e output fatturati per tutte le chiamate al modello, comprese le bozze aggiuntive e i tentativi ripetuti. Se abiliti la cache, registrane separatamente l’utilizzo. In una piattaforma basata sui crediti, consulta il dettaglio completo dell’attività: in Gumloop, il conteggio dei crediti nell’intestazione della chat apre il pannello dei dettagli. Dettaglio dei costi in Gumloop.
Moltiplicare per i tentativi e aggiungere i costi fissi
Costo per tentativo = (token di input × tariffa di input + token di output × tariffa di output) ÷ 1,000,000. Costo mensile dei token = quel costo × tentativi mensili. Aggiungi poi il canone della piattaforma o dell’hosting e gli strumenti conteggiati separatamente.
Per Haiku, (3,000 × $1 + 400 × $5) ÷ 1,000,000 = $0.005 per tentativo. Con 1,100 tentativi si ottengono i $5.50 usati sopra. Se un’attività richiede più chiamate, somma i loro costi prima di moltiplicare per il numero mensile di attività; il calcolo non deve fermarsi alla bozza finale.
Le spese che spesso sfuggono al calcolo
Verifica umana e correzioni. Ipotizzando 30 secondi per email approvata, controllare 1,000 risposte richiede 500 minuti, cioè 8.33 ore. Con un minuto per risposta, si arriva a 16.67 ore. Moltiplica le ore misurate per verifica, correzioni e passaggi di consegne per il costo orario complessivo del personale, compresi gli oneri legati al rapporto di lavoro. Confronta il risultato con il tempo prima necessario per gestire la stessa coda.
Tentativi ripetuti e decisioni aggiuntive. Gli esempi prevedono 100 tentativi extra. L’agente potrebbe anche classificare la richiesta, recuperare informazioni e controllare la propria bozza con chiamate separate al modello. Nel costo mensile vanno incluse queste chiamate e il lavoro non riuscito, anche quando si considera come risultato soltanto la risposta approvata.
Chiamate agli strumenti. Una fattura bassa per i token non comprende tutti gli strumenti. La ricerca web di Claude costa $10 per 1,000 ricerche, oltre ai token dei risultati. Una ricerca per ogni tentativo dell’esempio aggiungerebbe $11 di costi di ricerca e altri token di input. Un agente di assistenza che risponde usando le condizioni aziendali potrebbe non averne bisogno. Prezzi della ricerca di Claude.
Dati e altre API. Verifica i servizi usati dal workflow: casella email, helpdesk, CRM, database, archiviazione dei documenti e arricchimento dei dati. Un connettore incluso permette il collegamento, ma non paga automaticamente l’abbonamento o i consumi del servizio collegato. Tieni visibili sia i costi esistenti sia quelli nuovi, per calcolare il budget operativo totale e la spesa aggiuntiva generata dall’agente.
Manutenzione e capacità. Qualcuno deve comunque correggere credenziali non più valide, aggiornare documenti con condizioni obsolete e intervenire quando il comportamento cambia. Registra il tempo che dedica a questi compiti. Anche le quote condivise degli abbonamenti hanno dei limiti: altre attività possono consumare le stesse ore o gli stessi crediti e rendere necessario un piano superiore.
Per gli agenti helpdesk fatturati in base ai casi risolti, la guida alla scelta tra sviluppo interno e servizio in abbonamento per l’assistenza clienti affronta quella specifica decisione di acquisto. La valutazione economica di quel progetto va tenuta distinta dalla previsione dei costi software ricorrenti presentata qui.
Che cosa misurare nei primi 30 giorni
- Risultati: email ricevute, risposte approvate, problemi riaperti e casi passati a una persona.
- Tutte le unità di consumo: utenti a pagamento, ore, crediti, esecuzioni, token di input/output e chiamate agli strumenti fatturabili.
- Lavoro aggiuntivo: tentativi per risposta approvata, correzioni ed esecuzioni ripetute.
- Tempo del personale: verifica, passaggi di consegne e manutenzione, confrontati con il workflow precedente.
- Altre spese: hosting, archiviazione, API collegate e fascia di capacità successiva.
- Costo per risposta approvata: tutti i costi attribuibili di software, strumenti e personale, divisi per il numero di risposte approvate. Se si misurano i problemi chiusi, il costo per risoluzione va monitorato separatamente.
Scegliere un modello di costo che si riesca a gestire
Un fondatore SaaS che vuole trovare bozze nella casella email già questa settimana può partire da un assistente pronto all’uso. Prima dell’acquisto, deve verificare che la quota inclusa copra l’intera coda e assegnare la verifica a una persona. Il vantaggio è un ambiente di lavoro già pronto; il dato da monitorare è il numero di risposte approvate per ogni mese pagato.
Un responsabile operativo ecommerce che deve combinare email, condizioni e dati degli ordini può usare una piattaforma di creazione. Conviene provare l’intero workflow e leggere il dettaglio delle esecuzioni o dei crediti. Prima di confrontare la spesa con un servizio più semplice che prepara soltanto bozze, vanno aggiunti gli eventuali costi delle interrogazioni ai dati degli ordini.
Un responsabile backend con qualcuno disponibile a mantenere il workflow può scegliere le API. Il punto di partenza è un compito di assistenza con un perimetro definito, valutando il modello meno costoso che rispetti lo standard richiesto per le risposte. Il risparmio sui token aiuta solo se il tempo continuativo di sviluppo e verifica rientra nel budget.
Lo stesso metodo si applica ad altri ruoli. Un responsabile commerciale deve contare ogni messaggio di follow-up e ogni operazione di arricchimento dei dati, non soltanto i potenziali clienti contattati. Un addetto dell’area finanziaria deve conteggiare i recuperi di dati, le chiamate al modello e la verifica per ogni report programmato, poi confrontare il report approvato con il tempo del lavoro manuale che sostituisce.
Prima di estendere l’autonomia dell’agente a molte attività, occorre saper definire un risultato corretto e indicare chi gestisce le eccezioni. Se il workflow esistente basato su regole svolge già il compito in modo affidabile, un modello introduce una nuova spesa senza un beneficio ancora dimostrato.
La newsletter propone altre analisi pratiche di strumenti e budget.
- Ultimo aggiornamento
- 7 ott 2026
- Categoria
- Explained
Preferisca questo sito su Google


Segni omidsaffari.com come fonte preferita e Google lo mette in evidenza per lei in Top Stories, AI Overviews e AI Mode.

Trascrizione audio con Grok Voice 2.0: costi fermi, nuovo default
La trascrizione audio con Grok Voice Transcribe 2.0 mantiene i prezzi, ma cambia il modello predefinito: test, costi e passaggi per migrare senza sorprese.20 set 2026Explained
Cloudflare Browser Run: analizzare un job fallito prima di rieseguirlo
Scopri come ispezionare log, richieste di rete, file HAR e DOM finale di un job Cloudflare Browser Run fallito prima di avviare un nuovo tentativo.19 set 2026Explained
v0 collega i prototipi al design system privato del team
v0 installa librerie di componenti private con NPM_TOKEN o NPM_RC. Come usare il design system reale senza esporre le credenziali al modello.19 set 2026Explained
Claude Code Enterprise: l’Auto Mode taglia i costi del classificatore
Claude Code Enterprise 2.1.278 può spostare sul server i controlli dell’Auto Mode. Ecco quando spariscono i costi separati del classificatore.19 set 2026Explained
Vercel pricing: quanto costa Turbo per un solo deployment
Vercel pricing e Turbo: costi, requisiti e tre metodi per accelerare un solo deployment urgente senza modificare le impostazioni del progetto.18 set 2026Explained
ChatGPT Word: scrivere e revisionare senza cambiare app
ChatGPT Word porta bozze, sintesi e revisioni nella barra laterale di Word. Ecco requisiti, limiti, costi d’uso e un flusso di lavoro concreto.18 set 2026Explained
Google Antigravity: come migrare i job API entro il 5 ottobre
Scopri quali job di Google Antigravity richiedono un nuovo adapter, quali necessitano solo del nuovo ID agente e come migrare entro il 5 ottobre.18 set 2026Explained