Agent IA : le vrai budget, du service clé en main à l’API
Quel budget prévoir pour un agent IA ? Comparez services clé en main, n8n et API, avec trois budgets détaillés et les frais à intégrer pour vos e-mails.
Pour un agent IA qui prépare les réponses à 1,000 e-mails d’assistance par mois, les budgets logiciels calculés ci-dessous sont de $82 pour un service clé en main, de $25.50 en équivalent mensuel pour un outil de création hébergé facturé à l’année, et de $10.50 pour votre propre workflow via API. Dans les trois cas, il faut encore une validation humaine, une boîte de réception et une personne responsable en cas de problème. Le chiffre à suivre est le coût mensuel par réponse validée.
Agent IA : trois façons de payer, trois niveaux de responsabilité
Un agent IA s’appuie sur un modèle pour accomplir une tâche et agir dans vos outils. Pour l’assistance client, il peut lire un e-mail, retrouver les règles applicables et préparer une réponse. Acheter l’accès au modèle ne fournit ni la connexion à la boîte de réception, ni le circuit de validation, ni un service d’assistance prêt à fonctionner.
La facture dépend de la part du système que vous achetez :
- Un agent clé en main : vous payez un assistant prêt à l’emploi, généralement par abonnement ou par siège. Un siège correspond à un compte utilisateur payant. L’abonnement peut aussi comporter des quotas d’utilisation.
- Un outil de création no-code : vous reliez vous-même les étapes et payez en crédits, en tâches ou en exécutions de workflow. Une exécution correspond à un passage complet dans le workflow ; le crédit est l’unité choisie par le fournisseur pour facturer le travail effectué.
- Votre propre workflow via API : votre logiciel appelle un modèle par une API, l’interface qui permet à des programmes de lui demander un travail. Vous payez les tokens, ces fragments de texte que le modèle lit et génère, ainsi que l’hébergement et les éventuels outils payants.
Il s’agit de trois façons d’acheter le même travail, avec des responsabilités différentes. Un fondateur peut acheter la préparation de brouillons dans sa boîte de réception. Un responsable des opérations peut assembler le workflow. Une équipe backend peut prendre en charge le logiciel qui le fait tourner.
Les prix présentés ici ont été vérifiés sur les pages des fournisseurs le 7 octobre 2026. Les montants en dollars sont en USD. Les tarifs annuels sont signalés comme tels, et les totaux calculés sont des prévisions fondées sur des hypothèses explicites, pas des tests de performance. Comptabilisez les heures de mise en place séparément de la facture récurrente.
Quels sont les prix des fournisseurs, et que facturent-ils ?
Les lignes consacrées aux modèles utilisent les tarifs ordinaires, sans cache, remise sur le traitement par lots ni supplément de vitesse. Sur un même e-mail, les modèles peuvent consommer des nombres de tokens différents et produire des réponses de qualité différente. Un tarif plus bas n’a d’intérêt que si les réponses respectent votre niveau d’exigence pour l’assistance client.
Les autres lignes demandent la même vigilance. Le tarif d’entrée de Lindy ne garantit pas 1,000 réponses : la préparation de brouillons s’inscrit dans une large fourchette de 2 à 250 crédits pour les tâches courantes, et l’envoi d’un e-mail nécessite une approbation. Chaque utilisateur actif supplémentaire ajoute un siège payant. Règles d’utilisation et d’approbation de Lindy.
Les crédits de Gumloop ne couvrent pas seulement le texte. Les règles actuelles de facturation à l’usage fixent la valeur d’un crédit à $0.005, facturent au moins 1 crédit par appel de connecteur réussi et 5 crédits par minute de session active, avant les frais d’orchestration habituels de 8%. Détail complet du décompte des crédits Gumloop.
Si vous utilisez votre propre clé de modèle, les frais d’outils et de calcul restent dus, et les frais de l’agent passent à 16% selon la politique actuelle de facturation à l’usage ; les anciens comptes peuvent relever de règles antérieures. Ces frais sont calculés sur ce qu’aurait coûté l’exécution complète, y compris l’utilisation du modèle désormais facturée par votre fournisseur. Ne les calculez pas uniquement sur les frais d’outils restants.
Un même besoin : répondre à 1,000 e-mails d’assistance par mois
Prenons un cas concret. Une petite entreprise reçoit 1,000 e-mails d’assistance distincts auxquels ses règles existantes permettent de répondre. Le workflow prépare les réponses, puis une personne les vérifie et envoie celles qu’elle valide.
Prévoyez 100 tentatives supplémentaires de rédaction, soit 1,100 tentatives au total. Cette marge de 10% est une hypothèse budgétaire, pas une affirmation sur le taux de nouvelles tentatives d’un produit. Les exemples n’incluent ni pièces jointes, ni recherches sur Internet, ni enrichissement payant, et la boîte de réception existante reste hors du sous-total des nouveaux logiciels.
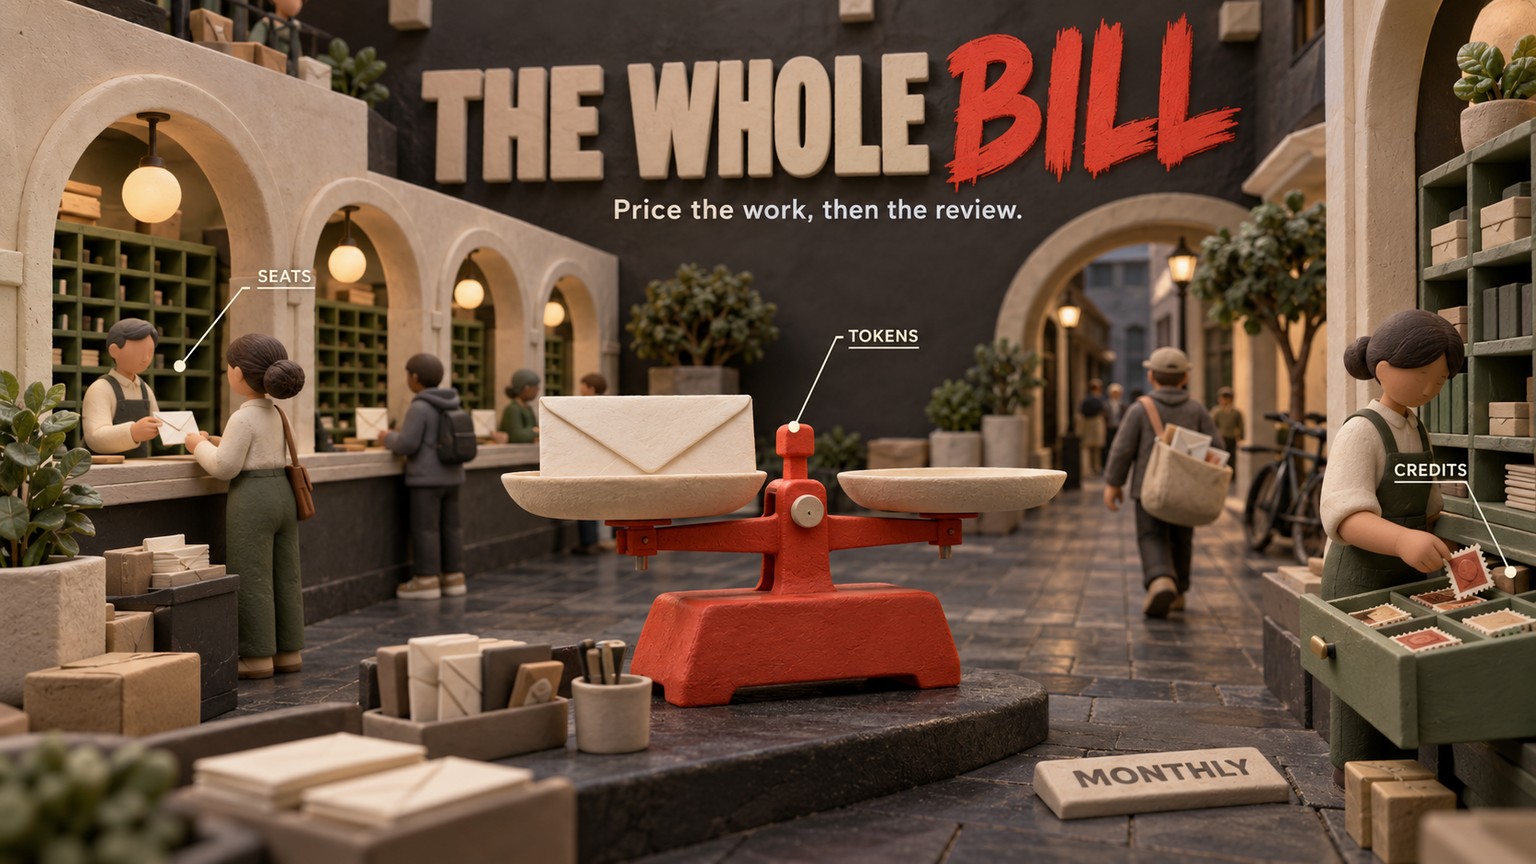
Les prévisions pour l’outil de création et l’API reposent sur 3,000 tokens d’entrée et 400 tokens de sortie facturés par tentative complète. Ces volumes correspondent à un seul appel de modèle ; si le workflow en effectue plusieurs, il faut additionner leur consommation. Le service clé en main décide lui-même de son utilisation interne du modèle : c’est donc son barème de tâches publié qui compte.
Option 1 : $82/mois avec Marblism pour trier les e-mails et préparer les brouillons
Un fondateur SaaS qui utilise Eva de Marblism consomme une réserve d’heures partagée. Il s’agit de valeurs fixes attribuées aux tâches, pas d’un chronomètre mesurant la durée réelle de fonctionnement de l’IA : trier un nouvel e-mail consomme 20 secondes, et préparer un brouillon de réponse consomme 5 minutes. Barème des tâches et paliers de capacité de Marblism.
Pour ce besoin :
- Trier 1,000 nouveaux e-mails : 1,000 × 20 secondes = 5.56 heures.
- Demander 1,100 brouillons de réponse, tentatives supplémentaires comprises : 1,100 × 5 minutes = 91.67 heures.
- Travail total décompté : 97.22 heures.
Ce volume tient dans le forfait de 100 heures à $82 avec facturation mensuelle. Le forfait de base de 50 heures à $44 ne suffit pas. Avec l’option annuelle, le palier de 100 heures revient à $45/mois, facturés à l’année. Les autres tâches IA du compte puisent dans la même réserve.
Eva prépare les brouillons dans votre boîte de réception ; une personne les vérifie et clique sur Envoyer. Ce budget finance donc une aide à la réponse aux demandes d’assistance, tandis que la validation reste à votre charge. Comment Eva gère les réponses.
Attention aussi au palier de capacité. Marblism décompte séparément 25 secondes pour une action via une intégration d’application ou une exécution d’automatisation. Si votre configuration ajoute une action de ce type à chaque tentative, cela représente 7.64 heures de plus, soit un total de 104.86 heures. Il faut alors passer au palier de 150 heures à $120/mois. L’estimation à $82 couvre uniquement le tri et la préparation de brouillons intégrés au service ; consultez le détail de l’utilisation avant d’ajouter d’autres actions.
Option 2 : n8n et Claude reviennent à $25.50/mois en équivalent mensuel
Un responsable des opérations e-commerce peut relier les e-mails d’assistance entrants, les règles applicables et un appel de modèle, puis enregistrer un brouillon à vérifier. L’intégration Gmail de n8n permet de lire les messages et de créer des brouillons, et son intégration Anthropic accepte votre propre clé API. Opérations Gmail, Identifiants Anthropic.
Supposons que la configuration déclenche une exécution complète du workflow par tentative. 1,100 exécutions tiennent dans le quota de 2,500 exécutions de Starter. Chaque étape d’un même passage ne compte pas comme une exécution supplémentaire, mais les passages déclenchés en plus doivent eux aussi tenir dans le quota. Définition d’une exécution et forfait n8n.
Avec votre propre clé Anthropic, le modèle est facturé séparément :
1,100 × 3,000 = 3.3 millions de tokens d’entrée.
1,100 × 400 = 0.44 million de tokens de sortie.
Aux tarifs vérifiés de Haiku, 3.3 × $1 + 0.44 × $5 = $5.50. Ajoutez les $20/mois en équivalent mensuel du forfait annuel : le budget logiciel atteint $25.50/mois en équivalent mensuel. n8n héberge Starter ; cet exemple n’ajoute donc aucun abonnement d’hébergement séparé.
Distinguez aussi les deux soldes de crédits de n8n. Les crédits Assistant financent l’aide à la création et au dépannage des workflows. Les crédits Gateway financent les modèles appelés pendant leur exécution. Cet exemple utilise votre propre clé Anthropic plutôt que des crédits Gateway. Un quota Assistant ne couvre donc pas cette facture de modèle. Les deux systèmes de crédits.
Option 3 : votre workflow via l’API Claude et son hébergement coûtent $10.50/mois
Une équipe backend peut exécuter le même workflow bien délimité dans sa propre application : recevoir l’e-mail, fournir les règles, demander un brouillon et l’enregistrer pour validation humaine. Avec les mêmes hypothèses de consommation de tokens, Haiku coûte toujours $5.50/mois.
Pour chiffrer l’hébergement, Cloudflare Workers Paid démarre à $5 par compte et par mois, avec 10 millions de requêtes et 30 millions de millisecondes CPU incluses. L’exemple suppose que l’application et son petit espace de stockage de données restent dans les quotas inclus. Tarifs de Workers et des services de données inclus.
Le sous-total logiciel est de $5.50 + $5 = $10.50/mois. Il suppose une boîte de réception existante, aucun outil payant facultatif et aucune autre tâche consommant le quota du compte. Workers propose aussi un forfait Free ; il faut vérifier séparément si ses limites conviennent à votre implémentation.
À consommation de tokens identique, Sonnet coûterait $11 en tokens, soit $16 avec cet hébergement. GPT-6 Luna coûterait $0.55 en tokens, soit $5.55 avec l’hébergement. Ces chiffres comparent les tarifs ; ils ne prouvent pas que les trois modèles traitent vos e-mails aussi bien.
Le faible sous-total de l’API s’accompagne de responsabilités : votre équipe entretient la connexion à la boîte de réception, le stockage des brouillons, la gestion des erreurs et le comportement du modèle. Le guide des tarifs de l’API Claude détaille les tarifs des modèles, le cache et le traitement par lots, à examiner une fois votre charge de travail mesurée.
Comment estimer le nombre de tokens par tâche ?
Partez de tout ce que reçoit le modèle, pas seulement de l’e-mail du client. Les instructions, les messages précédents, les extraits des règles, les descriptions d’outils et leurs résultats peuvent tous ajouter des tokens d’entrée. Chaque appel suivant du modèle peut traiter à nouveau une partie de ces éléments. Décompte des tokens liés aux outils dans Claude.
Pour un premier tableur, supposons que les instructions représentent 800 tokens, l’e-mail et le fil de discussion 400, et les règles pertinentes 1,800. Cela donne 3,000 tokens d’entrée. Prévoyez 400 tokens de sortie facturés pour le brouillon. Ce sont des hypothèses de planification à remplacer par des mesures, pas des volumes habituels garantis par un fournisseur.
Comptez l’entrée complète pour le modèle choisi
Envoyez la requête complète au point d’accès de comptage des tokens du modèle. Le compteur de Claude est gratuit et propre à chaque modèle, mais il fournit une estimation ; pour les requêtes utilisant la plupart des outils hébergés ou des connexions à des outils externes, il faut plutôt relever l’utilisation dans la réponse réelle. Un raccourci fondé sur le nombre de mots ne permet pas d’établir la facture. Comptage des tokens avec Claude.
Mesurez la tâche complète
Faites passer des e-mails représentatifs dans votre configuration réelle. Relevez les tokens d’entrée et de sortie facturés sur l’ensemble des appels de modèle, y compris les brouillons supplémentaires et les nouvelles tentatives. Si vous activez le cache, relevez son utilisation à part. Dans un outil facturé en crédits, consultez le détail de la tâche complète : le compteur de crédits dans l’en-tête du chat Gumloop ouvre le panneau de détail. Détail des coûts dans Gumloop.
Multipliez par les tentatives, puis ajoutez les frais fixes
Coût par tentative = (tokens d’entrée × tarif d’entrée + tokens de sortie × tarif de sortie) ÷ 1,000,000. Coût mensuel des tokens = ce coût × nombre de tentatives mensuelles. Ajoutez ensuite les frais de plateforme ou d’hébergement et les outils facturés séparément.
Pour Haiku, (3,000 × $1 + 400 × $5) ÷ 1,000,000 = $0.005 par tentative. Avec 1,100 tentatives, on retrouve les $5.50 utilisés plus haut. Si une tâche nécessite plusieurs appels, additionnez leurs coûts avant de multiplier par le nombre de tâches mensuelles ; ne chiffrez pas uniquement le brouillon final.
Quels coûts oublie-t-on dans le budget ?
La validation humaine et les corrections. Avec une hypothèse de 30 secondes par e-mail validé, vérifier 1,000 réponses prend 500 minutes, soit 8.33 heures. À raison d’une minute par réponse, cela représente 16.67 heures. Multipliez les heures mesurées de vérification, de correction et de transfert à une personne par votre propre coût horaire chargé, frais liés à l’emploi compris. Comparez ce total au temps que prenait auparavant le traitement de la même file de demandes.
Les nouvelles tentatives et les décisions supplémentaires. Les exemples prévoient 100 tentatives supplémentaires. Votre agent peut aussi classer la demande, récupérer des informations et vérifier son brouillon via des appels de modèle distincts. Comptez ces appels et le travail qui échoue dans la facture mensuelle, même si vous ne retenez comme résultat que la réponse validée.
Les appels d’outils. Une faible facture de tokens ne couvre pas tous les outils. La recherche Web de Claude coûte $10 pour 1,000 recherches, auxquels s’ajoutent les tokens des résultats. Une recherche par tentative dans cet exemple ajouterait $11 de frais de recherche, ainsi que des tokens d’entrée supplémentaires. Un agent d’assistance qui répond à partir de vos propres règles peut n’avoir besoin d’aucune recherche. Tarifs de la recherche avec Claude.
Les données et les autres API. Vérifiez les services utilisés par le workflow : messagerie, helpdesk, CRM, base de données, stockage de documents et enrichissement. Un connecteur inclus fournit une connexion ; il ne paie pas automatiquement l’abonnement ni l’utilisation du service connecté. Faites apparaître les coûts existants et les nouveaux coûts pour calculer à la fois le budget total de fonctionnement et la dépense supplémentaire créée par cet agent.
La maintenance et la capacité. Il faut toujours quelqu’un pour réparer les accès qui ne fonctionnent plus, actualiser les documents de règles devenus obsolètes et corriger les changements de comportement. Suivez le temps que cette personne y consacre. Les réserves des abonnements ont aussi des limites : d’autres tâches peuvent consommer les mêmes heures ou crédits et vous obliger à passer à un palier supérieur.
Pour les agents de helpdesk facturés à la résolution, le guide sur le coût d’un service client développé en interne ou acheté traite cette décision d’achat distincte. Gardez les calculs économiques de ce projet séparés de la prévision des frais logiciels récurrents présentée ici.
Que mesurer pendant les 30 premiers jours ?
- Les résultats : e-mails reçus, réponses validées, demandes rouvertes et cas transférés à une personne.
- Toutes les unités facturées : utilisateurs payants, heures, crédits, exécutions, tokens d’entrée et de sortie, et appels d’outils facturables.
- Le travail supplémentaire : tentatives par réponse validée, corrections et exécutions répétées.
- Le temps humain : vérification, transferts et maintenance, comparés au workflow précédent.
- Les autres frais : hébergement, stockage, API connectées et prochain palier de capacité.
- Le coût par réponse validée : l’ensemble des coûts de logiciels, d’outils et de travail humain attribuables à cette activité, divisé par le nombre de réponses validées. Suivez séparément le coût par résolution si vous mesurez les demandes clôturées.
Choisissez un mode de facturation que vous pouvez gérer
Un fondateur SaaS qui veut des brouillons dans sa boîte de réception dès cette semaine peut commencer par un assistant clé en main. Vérifiez que le quota couvre l’ensemble de la file de demandes et désignez la personne chargée de la validation avant l’achat. L’intérêt est de disposer d’un environnement de travail prêt à l’emploi ; le chiffre à suivre est le nombre de réponses validées par mois payé.
Un responsable des opérations e-commerce qui doit combiner e-mails, règles et données de commande peut utiliser un outil de création de workflows. Testez le workflow complet et consultez le détail de ses exécutions ou de ses crédits. Intégrez les consultations payantes des données de commande avant de comparer sa facture à celle d’un service plus simple de préparation de brouillons.
Un responsable backend qui dispose d’une personne pour entretenir le workflow peut choisir l’API. Commencez par une tâche d’assistance bien délimitée et évaluez le modèle le moins cher qui respecte vos exigences de réponse. Les économies de tokens ne sont utiles que si le temps de développement continu et de vérification reste dans le budget.
La méthode s’applique ailleurs. Un responsable commercial doit compter chaque message de relance et chaque action d’enrichissement, pas seulement les prospects contactés. Un responsable des opérations financières doit compter les récupérations de données, les appels de modèle et la vérification de chaque rapport programmé, puis comparer le rapport validé au temps de travail manuel qu’il remplace.
Attendez avant de déployer largement un système autonome si vous ne savez pas encore définir un résultat correct ou désigner qui gère les exceptions. Si votre workflow existant fondé sur des règles accomplit déjà la tâche de manière fiable, un modèle ajoute une nouvelle facture sans bénéfice établi.
Retrouvez d’autres analyses pratiques d’outils et de budgets dans la newsletter.
- Dernière mise à jour
- 7 oct. 2026
- Catégorie
- Explained
Préférez ce site dans Google


Marquez omidsaffari.com comme source préférée et Google le met en avant pour vous dans Top Stories, AI Overviews et AI Mode.

Transcription audio : Grok Voice Transcribe 2.0 garde ses tarifs, mais change de modèle par défaut
Grok Voice Transcribe 2.0 maintient la transcription audio à $0.10 par heure en batch et à $0.20 par heure en streaming, mais change de modèle par défaut.20 sept. 2026Explained
Débogage Cloudflare Browser Run : analysez l’échec avant de relancer
Cloudflare Browser Run permet désormais d’inspecter les logs, les requêtes réseau et le DOM après un échec, afin de corriger le problème avant toute relance.19 sept. 2026Explained
Design system privé : v0 réutilise enfin vos composants
v0 installe désormais vos packages npm privés. Découvrez comment connecter votre design system, protéger les identifiants et préparer la mise en production.19 sept. 2026Explained
Prix Claude Code : quand le mode auto évite le surcoût
Claude Code 2.1.278 supprime les frais du classificateur pour les sessions éligibles. Vérifiez /status et le repli de la passerelle avant de revoir le budget.19 sept. 2026Explained
Vercel pricing : Turbo à la carte pour un seul déploiement
Le Vercel pricing permet désormais d’activer Turbo sur un seul déploiement urgent, sans toucher au réglage du projet. Voici comment chiffrer le surcoût.18 sept. 2026Explained
ChatGPT Word : rédiger et réviser sans changer d’application
ChatGPT Word permet de rédiger, résumer et réviser un document depuis une barre latérale. Accès, coûts, limites et méthode pour le tester sur un vrai fichier.18 sept. 2026Explained
Google Antigravity : migrer les jobs locaux avant le 5 octobre
Préparez vos jobs Google Antigravity avant le 5 octobre : identifiez ceux qui exigent un nouvel adaptateur d’outils et ceux où changer l’ID suffit.18 sept. 2026Explained