Запрет обучения ИИ в Cloudflare: как сохранить индексацию
Настройте запрет обучения ИИ в Cloudflare, не закрывая сайт от поисковых роботов. Проверьте перенесённые параметры, robots.txt и активность краулеров.



Чтобы настроить запрет обучения ИИ в Cloudflare и при этом не мешать поисковым роботам, установите для Search значение Allow, а для Training — Disallow AI Training. Затем проверьте и перенесённые настройки, и файл robots.txt, который отдаёт Cloudflare. Это особенно важно сейчас: 15 сентября 2026 года Cloudflare изменил смысл параметра Block. Теперь он способен закрыть сайт не только для обучения, но и для поиска — если его посещают краулеры смешанного назначения, такие как Googlebot, Applebot и Bingbot.
Безопасный запрет обучения ИИ в Cloudflare: вся схема в одной таблице
Для большинства сайтов, зависящих от поиска, выбор прост: разрешить Search, запретить Training и отдельно решить, что разрешено Agents.
В пояснении Cloudflare от 15 сентября сказано прямо: если нужно запретить обучение и сохранить поиск, выбирайте Disallow AI Training. Не следуйте устаревшим инструкциям, которые советуют установить Training: Block. До изменения краулеры смешанного назначения не подпадали под такую блокировку. Теперь подпадают.
Эта настройка доступна на любом тарифе Cloudflare, поэтому покупать отдельное расширение не придётся. Вместо затрат на ещё один продукт для блокировки появляется другая задача: убедиться, что политика совпадает с фактическим поведением. Для сравнения: одна лицензия Screaming Frog SEO Spider в США стоит $279 в год, а специализированный сервис мониторинга robots.txt предлагает тариф за $129 в месяц. Cloudflare даёт сам механизм управления, но цикл проверок всё равно нужен.
Что на самом деле делает Disallow AI Training
Disallow выражает предпочтение и выборочно обеспечивает его соблюдение, а Block работает как запертая дверь.
Представьте краулер смешанного назначения как одну машину с двумя заданиями. Первое — «проиндексировать страницу для поиска». Второе — «использовать страницу для обучения модели». Если перекрыть путь машине, остановятся оба задания. Disallow AI Training позволяет оператору, соблюдающему требования, продолжить поисковую работу, но отклоняет использование для обучения.
Cloudflare делит автоматический трафик на три типа поведения:
- Search формирует поисковый индекс.
- Training обучает или дообучает модель.
- Agent посещает сайт по поручению человека — например, чтобы загрузить страницу для чата или управлять браузером.
Новый параметр Training указывает Bot Preference Sync публиковать соответствующие инструкции о запрете обучения в robots.txt. Краулеры смешанного назначения, отвечающие требованиям Cloudflare, сохраняют доступ для поиска. Краулеры Amazon, Anthropic, Meta и OpenAI, предназначенные только для обучения, блокируются, а отдельные поисковые краулеры этих компаний продолжают работать.
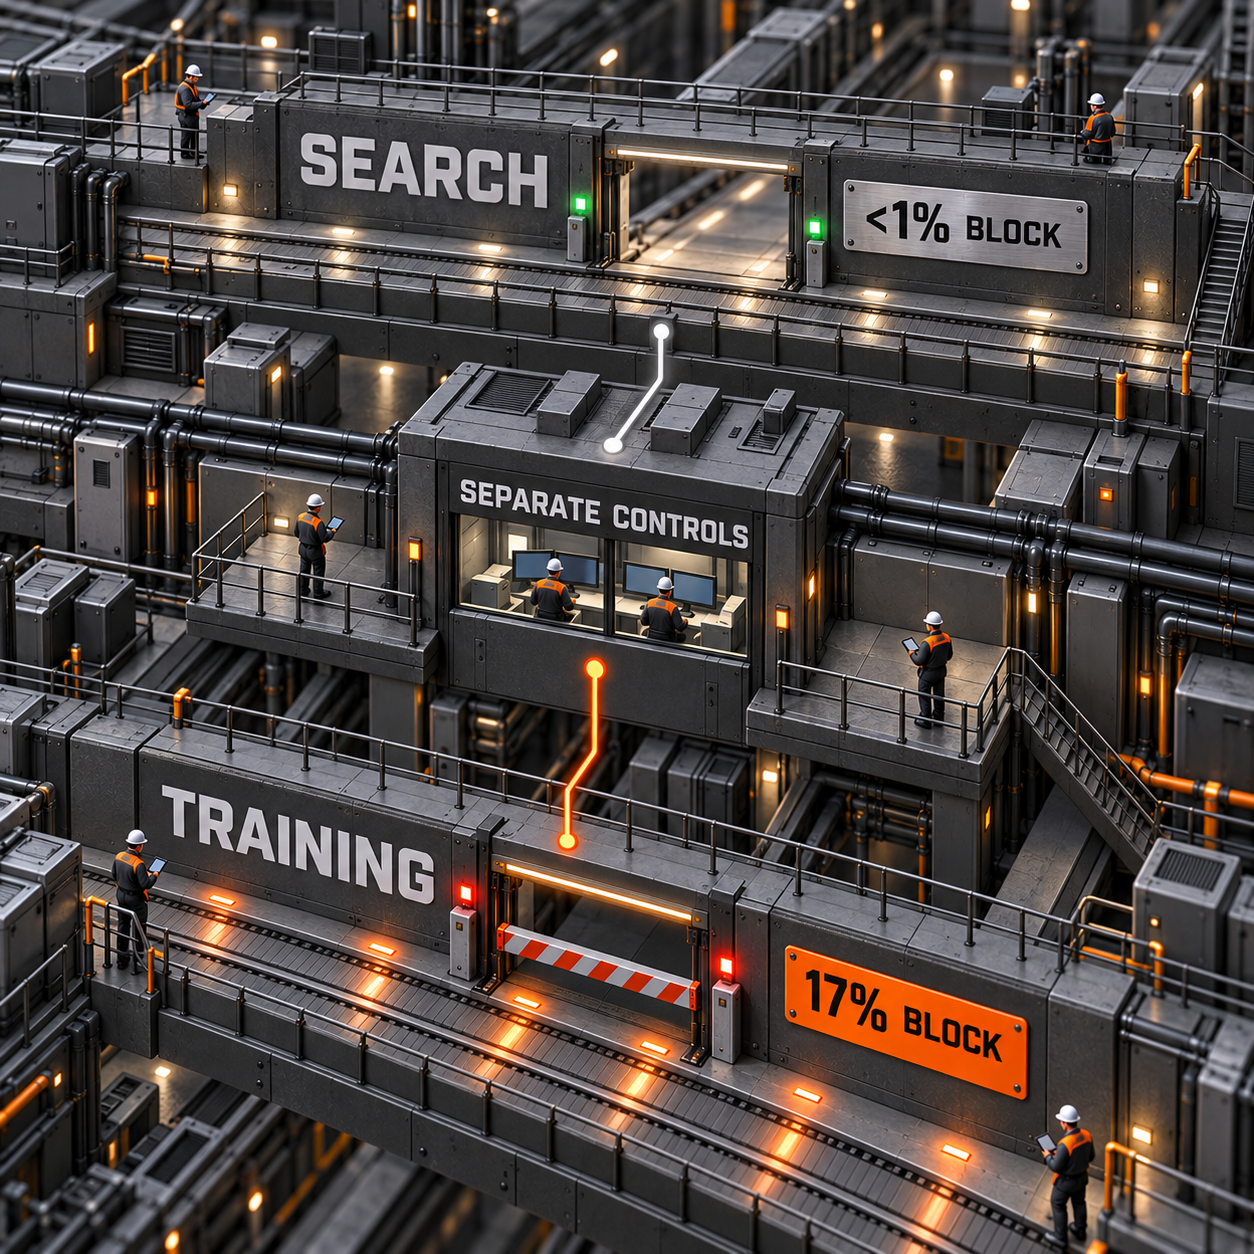
По данным Cloudflare, менее 1% сайтов блокируют поисковых роботов, тогда как 17% включают тот или иной механизм блокировки обучения. Этот разрыв и объясняет устройство продукта. Единый переключатель Block AI оказался слишком грубым инструментом для реальных задач владельцев сайтов.
Важно понимать разницу: инструкция robots.txt — не силовое поле. Сама по себе она не умеет распознать, кто сканирует сайт, определить цель сканирования или остановить краулер, который её игнорирует. Cloudflare сочетает опубликованное предпочтение с сетевой классификацией и блокировкой краулеров, которые не соответствуют требованиям режима Accountable.
Статус Accountable ещё не означает, что всё уже доступно
Метка Accountable у Cloudflare — это статус, подкреплённый планом развития, а не доказательство того, что все обещанные средства управления уже работают.
Чтобы получить этот статус, оператор должен выполнить или обязаться выполнить требования по отказу от обучения, отказу от ИИ-сводок, прозрачности на уровне URL и гарантии, что запрет обучения не повредит обычному поиску. Здесь важна именно формулировка.
- Google: Google-Extended можно запретить в robots.txt, и Google утверждает, что это решение не влияет на позиции в поиске. Также Google предлагает веб-мастерам настройку генеративного поиска и отчётность. Дополнительная прозрачность Google-Extended на уровне URL всё ещё описывалась как функция, которая появится в течение нескольких недель после анонса.
- Apple: Applebot-Extended поддерживает отказ от обучения через robots.txt. Apple также поддерживает
nosnippetдля ИИ-сводок и разметку платного контента. На момент анонса проверки на уровне URL не было; эту работу планировали на следующий год. - Microsoft: текущая схема Bing устроена иначе. Владельцы сайтов могут использовать
NOARCHIVEвместе с инструментами Bing Block URLs или Content Removal. Microsoft рассчитывает, что в начале 2027 года Bingbot начнёт соблюдать доменное предпочтение о запрете обучения в robots.txt. До этого момента параметр Cloudflare Disallow AI Training не передаёт такое предпочтение Bing автоматически через robots.txt.
Поэтому честное обещание уже, чем «один переключатель управляет любым использованием везде». Новая настройка делает выбор между поиском и обучением гораздо понятнее, но сегодня Bing всё ещё требует отдельной проверки.
Проверьте, как Cloudflare перенёс настройки
Большинство параметров переносится автоматически, однако названия и последствия изменились настолько, что результат стоит проверить вручную.
Если для домена прежде не использовались отдельные настройки Search, Training и Agent, Cloudflare преобразует старый параметр Block AI Bots по следующей схеме:
Если для домена уже были заданы раздельные параметры, практическое состояние Search и Agent сохраняется. Training: Allow остаётся Allow. И Training: Block, и Training: Block on pages with ads превращаются в Disallow AI Training.
Проверка после переноса выглядит так:
- Откройте домен в Cloudflare, перейдите в Security Settings, затем выберите Configure AI bot policies.
- До любых изменений зафиксируйте текущие значения Search, Training и Agent.
- Установите Search в Allow, если органическая видимость важна для сайта.
- Установите Training в Disallow AI Training, если хотите отказаться от обучения, но не исключать из поиска краулеры смешанного назначения, отвечающие требованиям.
- Выберите политику Agent независимо от остальных. Cloudflare не предлагает для Agents предпочтение Disallow, поскольку общепринятой интернет-директивы для него пока нет.
- Убедитесь, что Bot Preference Sync включён, если хотите, чтобы Cloudflare публиковал политику по категориям в robots.txt.
- Сохраните политику и проверьте публичный результат — одной надписи в панели управления недостаточно.
Для новых доменов с рекламой рекомендуемый пресет Cloudflare уже следует этой схеме: Preference Sync включён, Search разрешён, Training запрещён, а Agents блокируются на страницах с рекламой. На новых доменах без рекламной монетизации все три типа поведения изначально разрешены.
Как проверить доступ для поиска после изменения
Правильно выглядящий переключатель — лишь первая контрольная точка. Политику нужно проверить снаружи и на всех уровнях.
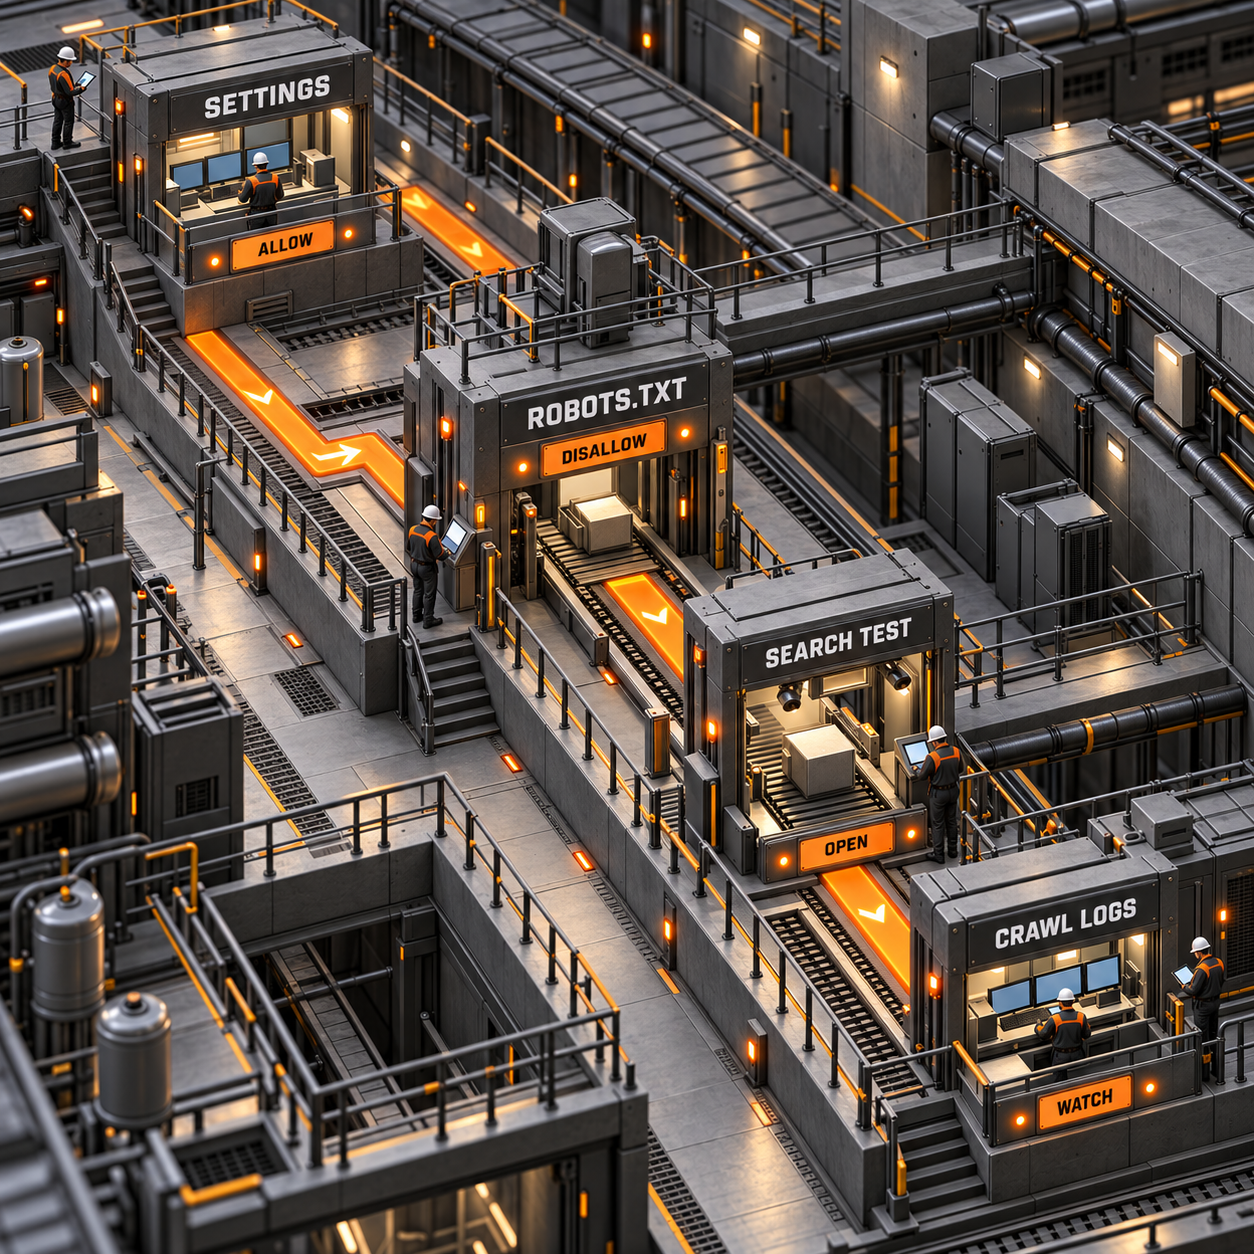
Проверка состоит из четырёх частей:
- Настройки: убедитесь, что Search имеет значение Allow, а Training — Disallow AI Training. Agent проверьте отдельно.
- robots.txt: загрузите актуальный файл
/robots.txtс публичного домена. Bot Preference Sync добавляет сгенерированные правила перед существующим файлом, поэтому исходные директивы Disallow сохраняются. Ищите конфликты в обеих частях. - Поведение поиска: проверьте типовые URL через инструменты и отчёты для веб-мастеров от поисковой системы. Не делайте вывод о поисковом доступе по одному слову «Disallow»: оно относится к обучающей идентичности или предпочтению, а не к традиционной поисковой задаче краулера смешанного назначения, соблюдающего требования.
- Активность краулеров: отслеживайте в AI Crawl Control запросы, соблюдение robots.txt и неожиданные блокировки. Cloudflare позволяет задавать действия для отдельных краулеров и записывает их активность, поэтому именно здесь удобнее всего обнаружить расхождение между замыслом политики и её реальным поведением.
Особого внимания требуют пользовательские правила. Bot Preference Sync отражает политику для всей категории, но не переносит сложные индивидуальные правила в сгенерированный файл. Если для одного краулера предусмотрено лицензионное исключение, действует логика по отдельным путям или настроено пользовательское правило WAF, эти уровни нужно сопоставить вручную. Когда общая политика для категории слишком груба, Cloudflare позволяет отключить Sync и поддерживать файл самостоятельно.
Кому больше всего выгодно новое разделение
Больше всего выиграет бизнес, который зарабатывает на визитах людей, но не хочет отдавать свой архив в обучающие наборы данных.
Пример с ритейлером показывает и ограничение: эти настройки действуют на уровне домена. Это не встроенная система согласия для каждой статьи. Для отдельных зон можно задать разные политики, но в пределах одной зоны действует единая позиция по Search, Training и Agent, если не добавить более точные правила самостоятельно.
Какой продукт стоит создать
Самая сильная идея — монитор регрессий политики краулеров, а не очередной генератор robots.txt.
1. Монитор регрессий политики краулеров
Создайте для агентств и команд с несколькими сайтами монитор, который считывает политику Cloudflare, загружает опубликованный robots.txt, проверяет доступ к типовым страницам из поиска и предупреждает, когда эти уровни расходятся.
Спрос заметен по смежным запросам: robots.txt generator получает около 1,000 поисковых запросов в месяц в США, а google indexing checker — около 110. Существующие инструменты подтверждают и наличие бюджета. Один сервис мониторинга robots.txt предлагает тариф для пяти доменов за $129 в месяц, а настольный монитор SEO-изменений стоит $179 единоразово.
Минимальной продаваемой версии нужны четыре функции: импорт зон Cloudflare, сравнение политики с robots.txt, проверки по расписанию и уведомление по электронной почте или в Slack с точным описанием изменения. Данные об активности краулеров и сведения из инструментов для веб-мастеров можно добавить после того, как базовый детектор расхождений заслужит доверие.
Главная сложность — доказательная сила. По конфигурации и наблюдаемым запросам видно, что сайт опубликовал и заблокировал. Но они не доказывают, что поставщик модели удалил уже собранные данные. Защитным преимуществом продукта должна стать надёжная доказательная база по множеству доменов, а не более красивый переключатель.
2. Аудитор миграции Cloudflare
Создайте узкоспециализированный аудит, который находит зоны с рискованными сочетаниями после миграции и формирует план исправлений для агентства, издательской группы или франчайзинговой сети.
Запрос cloudflare block ai bots получает около 50 поисковых запросов в месяц в США при CPC $13.19, а google indexing checker добавляет ещё 110 ежемесячных запросов вокруг главного риска. Спрос здесь ниже, чем в сегменте генераторов, однако цена платного клика показывает: те, кто ищет такое решение, уже столкнулись с реальной операционной проблемой.
MVP может считывать через API поля Search, Training, Agent и Bot Preference Sync, загружать публичный robots.txt и относить каждую зону к одной из категорий: безопасна для поиска, намеренно заблокирована или настроена противоречиво. На выходе нужен готовый для клиента пакет доказательств, где рядом показаны настройка и фактически опубликованный файл.
Главный риск — зависимость от платформы. Cloudflare может добавить такой же сводный отчёт, а спрос на проверку особенно растёт во время миграций. Более сильная бизнес-модель — использовать аудит как стартовый продукт, а затем продавать постоянный мониторинг регрессий в Cloudflare и у других edge-провайдеров.
Чего эта настройка не решает
Она создаёт более чёткую границу политики, но не даёт полного ответа на вопрос об использовании контента для ИИ.
- Она не удаляет материалы, собранные ранее. Cloudflare описывает предпочтения для краулеров и управление запросами, а не ретроактивное удаление.
- Она не гарантирует, что каждый оператор соблюдает robots.txt. Cloudflare добавляет сетевое принуждение для краулеров вне пути Accountable, но для краулеров смешанного назначения по-прежнему важно, чтобы оператор соблюдал предпочтение.
- Она не исключает сайт из всех ИИ-сводок. Управление сводками вынесено отдельно, а более широкое централизованное управление Cloudflare описывает как будущую возможность.
- Она не добавляет для Agents состояние Disallow.
- Она не переносит сложные пользовательские правила для отдельных краулеров в Bot Preference Sync.
- Она пока не выражает автоматически предпочтение Bing о запрете обучения через robots.txt. Текущие инструменты Bing
NOARCHIVEи средства для веб-мастеров нужно проверять отдельно. - Это не индексация файлов R2 через Cloudflare AI Search. У этого продукта другой сценарий работы.
Выбирайте Block, только если действительно хотите полностью закрыть доступ краулеру. Выбирайте Disallow AI Training, если поисковая видимость остаётся частью бизнес-модели. В этом и состоит весь смысл сентябрьского изменения.
Что сделать в понедельник
На следующей неделе выберите три типовых домена: один проект с рекламной моделью, один сайт, зависящий от поиска, и один домен с пользовательскими правилами для краулеров. Зафиксируйте перенесённые значения Search, Training и Agent, меняйте настройки только там, где бизнес-цель ясна, а затем приложите актуальный robots.txt и отчёт о краулерах к задаче на изменение. Если все три проверки пройдут, распространите такой же доказательный подход на весь портфель.
Как запретить обучение ИИ?
Для домена под управлением Cloudflare установите Training в Disallow AI Training, если хотите опубликовать предпочтение о запрете обучения и сохранить доступ для отвечающих требованиям краулеров смешанного назначения, работающих для поиска. Используйте Block, только если готовы к тому, что это затронет и поиск через такие краулеры.
Можно ли заблокировать весь ИИ-контент?
Можно блокировать категории краулеров или отдельных краулеров, но выражение «весь ИИ-контент» объединяет несколько разных задач. Cloudflare разделяет трафик Search, Training и Agent, чтобы можно было независимо разрешать разные виды автоматического использования. Блокировка Training не убирает сгенерированные ИИ-материалы из поисковых продуктов и не стирает уже собранные данные.
Как отключить ИИ-режим в поиске?
Настройка краулеров Cloudflare не отключает для пользователей поисковый интерфейс с ИИ. Она управляет доступом к вашему домену. Google и другие операторы предлагают отдельные настройки для генеративных сводок, тогда как обычная индексация и предпочтения по обучению остаются самостоятельными решениями.
Если вашему бизнесу нужен такой аудит политики краулеров и система мониторинга, изучите системы внедрения ИИ.
- Последнее обновление
- 16 сент. 2026 г.
- Категория
- Build
Сделать этот сайт предпочтительным в Google


Отметьте omidsaffari.com как предпочтительный источник — и Google будет поднимать его для вас в Top Stories, AI Overviews и AI Mode.
Голосовой ввод в Murmure: кому подойдёт офлайн-диктовка
Обзор Murmure 1.11.3: как работает локальный голосовой ввод, словарь и правила форматирования, кому подойдёт приложение и где его ограничения.14 сент. 2026 г.Build
FFmpeg API RenderIO: тарифы, лимиты и реальная стоимость
Разбираем тарифы FFmpeg API RenderIO: цену одной команды, переплату сверх лимита, ограничения времени и цепочек и переход на Growth или Business.14 сент. 2026 г.Build
Dictare: бесплатный голосовой ввод для программирования
Dictare — бесплатный локальный голосовой ввод для программирования. Отделяем цену программы от настройки речевых моделей, компьютера и тарифа ИИ-агента.13 сент. 2026 г.Build
Тестирование плагинов Claude Code: evals без самописного раннера
Разбираем нативные eval-тесты Claude Code: как сравнить поведение с плагином и без него, оценить дельту, ограничить расходы и поставить проверку в CI.12 сент. 2026 г.Build
Голосовой ИИ-агент Cloudflare: как найти причину задержки
Разбираем turnmetrics в Cloudflare: по этапам и исходам находим причину задержки или молчания голосового ИИ-агента — от транскрибации до TTS.12 сент. 2026 г.Build
Как добавить субтитры в видео через Rendi: вшиваем SRT
Разбираем, как добавить субтитры в видео через Rendi: отправить SRT и MP4 в API, настроить оформление, дождаться результата и проверить готовый файл.11 сент. 2026 г.Build
OpenAI Agents API или Agents SDK: что выбрать
Сравниваем OpenAI Agents API и Agents SDK: управление состоянием, развертывание, стоимость, ограничения и сценарии, в которых стоит выбрать каждый вариант.11 сент. 2026 г.Build