Cloudflare AIクローラー設定でAI学習を拒否し、検索流入を守る
Cloudflare AIクローラー設定で、検索流入を維持しながらAI学習だけを拒否する方法を解説。Search、Training、Agentの移行結果、robots.txt、Googlebot・Applebot・Bingbotへの影響、変更後に実施すべき4段階の検証手順まで、運用担当者向けに整理します。



Cloudflare AIクローラーの設定で検索クロールを止めず、AIモデルの学習だけを拒否するには、Search を Allow、Training を Disallow AI Training に設定し、移行後の設定と Cloudflare が配信する robots.txt の両方を確認します。Cloudflare が Block の意味を2026年9月15日に変更したため、この確認は今まで以上に重要です。現在の Block は、Googlebot、Applebot、Bingbot のような複数用途のクローラーについて、検索目的のサイトアクセスまで止める可能性があります。
Cloudflare AIクローラー設定:安全な組み合わせ
検索流入が重要なサイトなら、基本方針は明快です。Search は許可し、Training は拒否し、Agent は別の判断として設定します。
Cloudflare が9月15日に公開した説明は明確です。学習を拒否しながら検索は維持したい場合、選ぶべき設定は Disallow AI Training です。Training: Block を選ぶよう勧める古いガイドには従わないでください。変更前は複数用途のクローラーが Block の対象外でしたが、現在は対象に含まれます。
この制御機能は Cloudflare の全プランで利用できるため、上位プランを別途購入する必要はありません。費用の焦点は、別のブロック製品を買うことから、ポリシーと実際の挙動が一致しているか確かめることへ移ります。比較すると、米国での Screaming Frog SEO Spider は1シート年額$279、robots.txt 専用監視製品の一例には月額$129のプランがあります。制御そのものは Cloudflare が提供しますが、検証の仕組みは必要です。
Disallow AI Trainingは実際に何をするのか
Disallow は一部の強制措置を伴う意思表示であり、Block は扉を施錠する操作です。
複数用途のクローラーを、2枚の作業指示書を積んだ1台の配送車だと考えてみてください。一方には「検索用にこのページをインデックスする」、もう一方には「モデル学習にこのページを使う」とあります。車ごとブロックすれば、どちらの作業も止まります。Disallow AI Training なら、Accountable と認定された事業者に検索の作業は認めつつ、学習の作業だけを拒否できます。
Cloudflare は自動トラフィックの用途を3つに分けています。
- Search は検索インデックスを構築します。
- Training はモデルの学習またはファインチューニングを行います。
- Agent は、チャットによる取得やブラウザ操作エージェントなど、人に代わってアクセスします。
新しい Training オプションを設定すると、Bot Preference Sync が学習拒否の指示を robots.txt に反映します。Accountable と認定された複数用途のクローラーには、引き続き検索目的のアクセスが認められます。Amazon、Anthropic、Meta、OpenAI の学習専用クローラーは、それぞれの検索クローラーを巻き込まずにブロックされます。
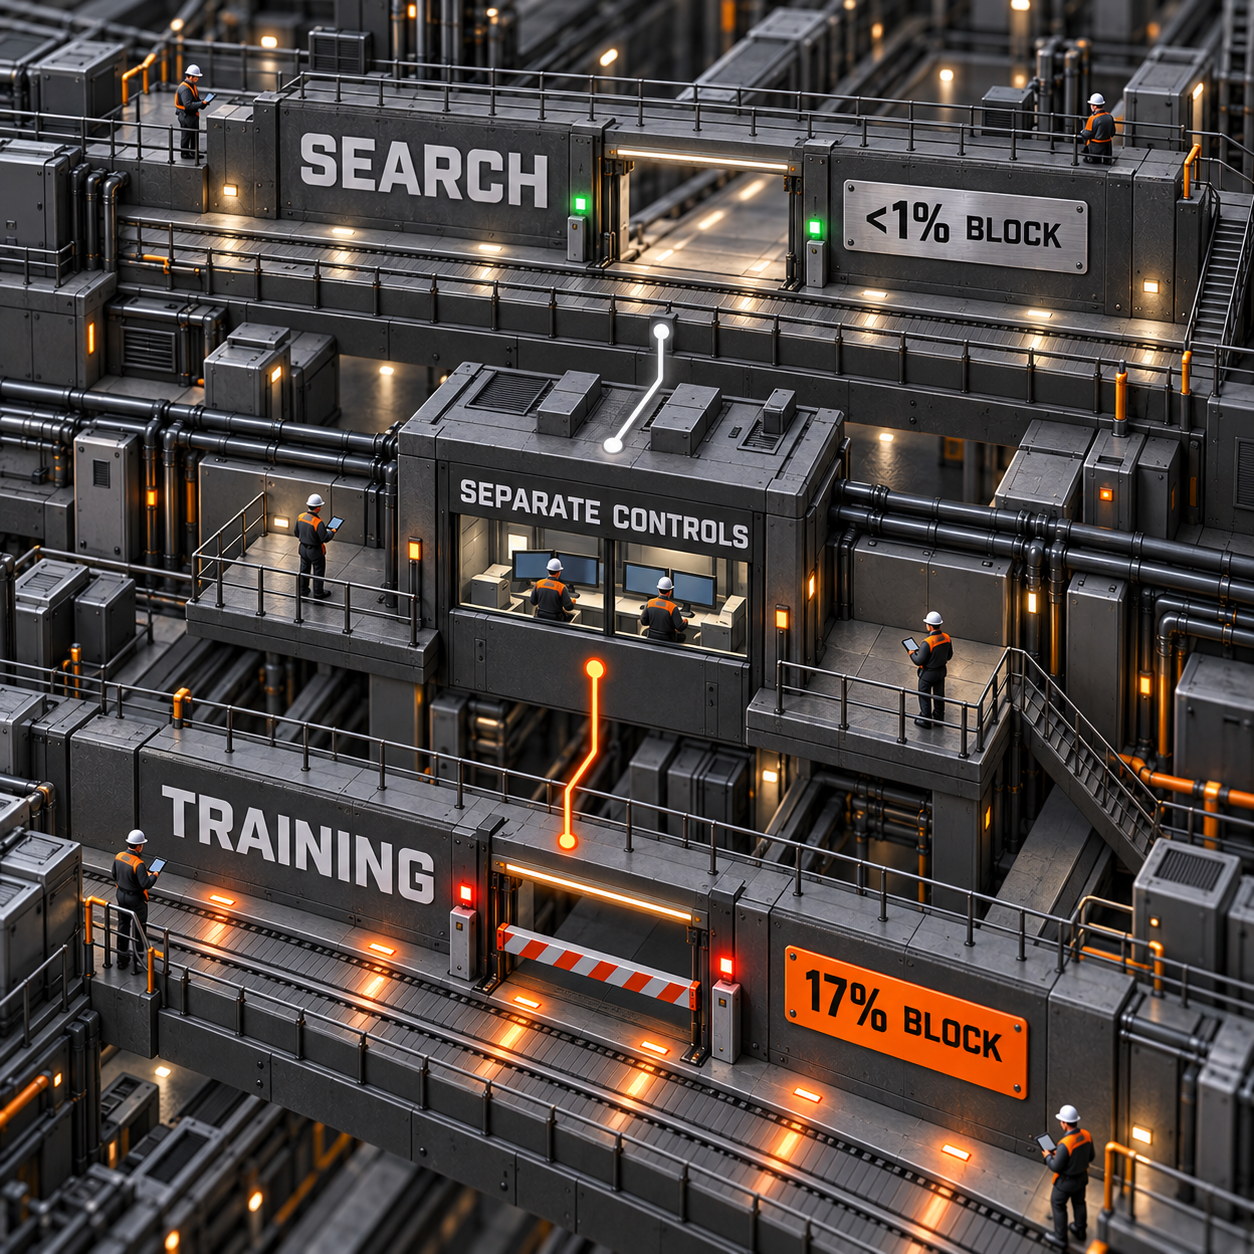
Cloudflare によると、Search ボットをブロックするサイトは1%未満である一方、Training をブロックする何らかの仕組みを有効にしているサイトは17%です。この差を見れば、製品設計の狙いが分かります。単一の Block AI スイッチでは、サイト運営者が本当に望む制御には大ざっぱすぎたのです。
ここには重要な違いがあります。robots.txt の指示は、見えない防壁ではありません。それだけでは、アクセス元が誰か、何を目的にクロールしているかを判定できず、指示を無視するクローラーも止められません。Cloudflare は、公開された意思表示をネットワーク上の分類と組み合わせ、Accountable の経路に該当しないクローラーをブロックします。
Accountableでも、すべてが今すぐ使えるとは限らない
Cloudflare の Accountable ラベルは、約束された制御機能がすべて実装済みである証明ではなく、ロードマップを伴うステータスとして捉えるべきです。
認定されるには、事業者が学習のオプトアウト、AI要約のオプトアウト、URL単位の可視性、学習を拒否しても従来型検索に悪影響を与えない保証について、要件を満たすか、対応を約束する必要があります。ここでは「約束」も含まれる点が重要です。
- Google: Google-Extended は robots.txt で拒否でき、Google はその選択が検索順位に影響しないと説明しています。また、生成検索向けのウェブマスター制御とレポートも提供しています。Google-Extended に関する追加のURL単位の透明性は、発表後の数週間で提供予定と説明されていました。
- Apple: Applebot-Extended は robots.txt による学習オプトアウトに対応しています。Apple はAI要約向けの
nosnippetとペイウォールのラベル付けにも対応しています。URL単位の確認機能は発表日時点では利用できず、翌年に向けた取り組みとされていました。 - Microsoft: Bing の現時点での対応は異なります。サイト運営者は
NOARCHIVEと、Bing の Block URLs または Content Removal ツールを組み合わせて利用できます。Microsoft は、Bingbot が robots.txt のドメイン単位の学習拒否設定に従う時期を2027年初頭としています。それまでは、Cloudflare の Disallow AI Training を設定しても、その意思表示が robots.txt を通じて Bing に自動送信されるわけではありません。
したがって、「1つのスイッチですべての用途をどこでも制御できる」というほど広い約束ではありません。新しい設定によって、検索と学習のどちらを認めるかは格段に安全に選べるようになりましたが、現時点の Bing には別途確認が必要です。
Cloudflareの移行結果を確認する
多くの設定は自動で引き継がれます。ただし、表示名と効果が大きく変わったため、移行後の状態は監査してください。
ドメインで Search、Training、Agent の詳細制御を一度も使っていなかった場合、Cloudflare は従来の Block AI Bots 設定を次のように移行します。
すでに詳細制御を使っていたドメインでは、Search と Agent の実質的な状態が維持されます。Training: Allow は Allow のままです。Training: Block と Training: Block on pages with ads は、どちらも Disallow AI Training に移行します。
移行後は、次の手順で確認します。
- Cloudflare で対象ドメインを開き、Security Settings、Configure AI bot policies の順に進みます。
- 変更する前に、現在の Search、Training、Agent の値を記録します。
- オーガニック検索からの流入が重要なら、Search を Allow に設定します。
- Accountable と認定された複数用途のクローラーを検索から排除せず、学習だけをオプトアウトしたい場合は、Training を Disallow AI Training に設定します。
- Agent のポリシーは、独立した判断として選びます。Agent には確立されたインターネット上の指示がまだないため、Cloudflare は Disallow という意思表示を用意していません。
- カテゴリ単位のポリシーを robots.txt に反映したい場合は、Bot Preference Sync が有効であることを確認します。
- ポリシーを保存したら、ダッシュボードの表示だけを証拠にせず、公開されている結果を調べます。
広告で収益化する新規ドメインでは、Cloudflare の推奨プリセットがすでにこの構成になっています。Preference Sync はオン、Search は許可、Training は拒否、Agent は広告掲載ページでブロックされます。広告収益化を行わない新規ドメインは、3つの用途がすべて許可された状態で始まります。
変更後も検索クロールできるか確認する
スイッチの表示が正しいだけでは、最初の確認を通過したにすぎません。外側から内側へ、実際のポリシーを検証します。
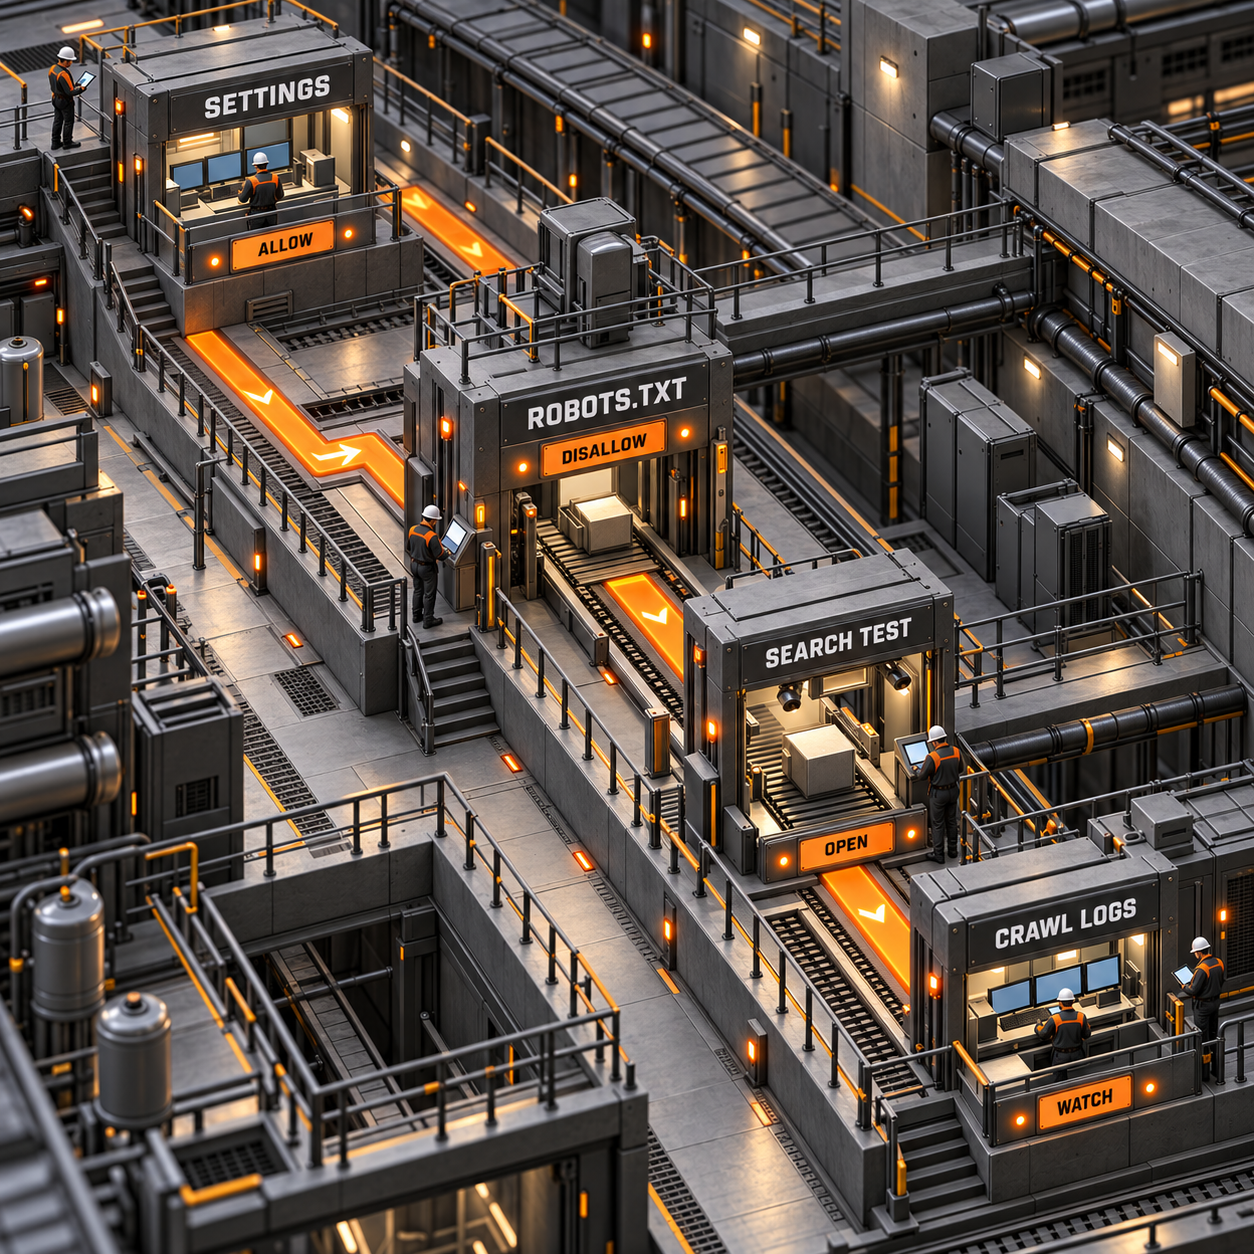
確認は次の4段階です。
- 設定: Search が Allow、Training が Disallow AI Training と表示されていることを確かめます。Agent は分けて確認します。
- robots.txt: 公開ドメインから実際の
/robots.txtを取得します。Bot Preference Sync は生成したルールを既存ファイルの先頭に追加するため、元からある Disallow 指示も残ります。両方のセクションに競合がないか確認してください。 - 検索の挙動: 検索事業者のウェブマスターツールとレポートを使い、代表的なURLを確認します。「Disallow」という単語だけを見て、検索アクセスまで拒否されたと判断してはいけません。これは Accountable と認定された複数用途のクローラーが担う従来型検索ではなく、学習用の識別子または意思表示に適用されます。
- クローラーの動作: AI Crawl Control でリクエスト、robots.txt の遵守状況、想定外のブロックを監視します。Cloudflare は個別クローラーへの処理を適用し、動作も記録できます。意図と違うポリシー挙動を見つける実用的な確認場所です。
カスタムルールには特に注意が必要です。Bot Preference Sync が反映するのはカテゴリ全体のポリシーであり、複雑な個別ルールを読み取って生成ファイルへ変換するものではありません。特定クローラーへのライセンス例外、パス固有のロジック、カスタムWAFルールがある場合は、各レイヤーを手作業で照合してください。カテゴリ単位のポリシーでは粗すぎるときは、Sync をオフにし、自分でファイルを管理することもできます。
新しい分離設定で最も恩恵を受けるのは誰か
最大の恩恵を受けるのは、人がページを訪れることで収益を得る一方、アーカイブ全体を学習データとして取り込まれたくない事業者です。
小売業者の例からは、制御の限界も分かります。設定はドメイン単位であり、記事ごとの同意管理機能ではありません。ゾーンを分ければ別々のポリシーを適用できますが、より細かなルールを自分で追加しない限り、1つのゾーンが持てる Search、Training、Agent の方針はそれぞれ1つです。
作る価値があるプロダクト
最も有望なのは、別の robots.txt 生成ツールではなく、クローラーポリシーのリグレッション監視です。
1. クローラーポリシーのリグレッション監視
代理店や複数サイトを運営するチーム向けに、Cloudflare のポリシーを読み取り、配信中の robots.txt を取得し、代表ページへの検索アクセスを確認して、各レイヤーのずれを通知する監視ツールを作ります。
この作業に対する需要は検索数にも表れています。robots.txt generator は米国で月間約 1,000件、google indexing checker は約 110件検索されています。既存ツールからは予算の存在も確認できます。robots.txt 監視製品の一例は5ドメインで月額$129、デスクトップ型SEO変更監視ツールの一例は買い切り$179です。
販売可能な最小構成に必要なのは、Cloudflare ゾーンのインポート、ポリシーと robots.txt の比較、定期チェック、変更内容を明記したメールまたは Slack 通知の4つです。クローラーの動作データとウェブマスター向けデータは、ずれの検出機能への信頼を得てから追加します。
難所は証明です。設定内容と観測したリクエストから、サイトが何を公開し、何をブロックしたかは示せます。しかし、モデル事業者がすでに収集したデータを削除したことまでは証明できません。優位性の源泉は、見た目のよいスイッチではなく、多数のドメインを横断する信頼性の高い証跡であるべきです。
2. Cloudflare移行監査ツール
移行後も危険な設定の組み合わせが残るゾーンを検出し、代理店、パブリッシャーグループ、フランチャイズ網向けに修正レポートを作る監査ツールです。
cloudflare block ai bots は米国で月間約50件検索され、CPCは$13.19です。検索への悪影響を心配する層では、google indexing checker にも月間110件の検索があります。生成ツール市場より需要は小さいものの、クリック単価の高さから、検索する人が実際の運用課題を抱えていることがうかがえます。
MVPでは、Search、Training、Agent、Bot Preference Sync のAPIフィールドを読み取り、公開中の robots.txt を取得し、各ゾーンを「検索に安全」「意図的にブロック」「設定が不整合」のいずれかに分類できます。設定と観測したファイルを並べた、顧客にそのまま提出できる証跡パックを出力します。
課題はプラットフォーム依存です。Cloudflare 自身が同じポートフォリオレポートを追加する可能性があり、需要も移行時期に集中します。監査を入口の商品にして、その後 Cloudflare や他のエッジプロバイダーを横断する継続的なリグレッション監視を販売する方が、事業としては強くなります。
この設定だけでは解決できないこと
これはポリシーの境界を明確にする仕組みであり、AIによるコンテンツ利用を完全に解決するものではありません。
- すでに収集されたコンテンツは消去されません。Cloudflare が提供するのはクローラーへの意思表示とリクエスト制御であり、過去にさかのぼる削除ではありません。
- すべての事業者が robots.txt に従う保証はありません。Cloudflare は Accountable の経路外にいるクローラーにネットワーク上の強制措置を加えますが、複数用途の経路では事業者が意思表示を守ることが前提です。
- すべてのAI要約をオプトアウトできるわけではありません。要約の制御は別であり、Cloudflare は要約を横断的に制御する仕組みを今後の取り組みとして説明しています。
- Agent に Disallow の状態を設定することはできません。
- クローラーごとの複雑なカスタムルールを Bot Preference Sync に変換することはできません。
- Bing 向けの学習拒否を robots.txt で自動的に表明する機能は、まだありません。Bing が現在提供している
NOARCHIVEとウェブマスター向け制御は別途確認してください。 - これは R2ファイルを改名せずにインデックスするCloudflare AI Search ではありません。別の製品、別のワークフローです。
クローラーを本当に締め出したいときは Block を選びます。検索による発見が事業モデルの一部なら、Disallow AI Training を選びます。9月の変更で最も重要なのは、この違いです。
次の月曜日にやること
来週、代表的なドメインを3つ選びます。広告収益型を1つ、検索流入型を1つ、カスタムクローラールールを持つものを1つです。移行後の Search、Training、Agent の値を記録し、事業目的が明確なサイトだけを変更します。そのうえで、実際の robots.txt とクローラーレポートを変更チケットと一緒に保存してください。この3つで問題がなければ、同じ証跡ベースの確認をポートフォリオ全体に展開します。
AI学習を無効にするには?
Cloudflare で管理するドメインでは、Accountable と認定された複数用途のクローラーに検索アクセスを残しながら学習拒否の意思を公開したい場合、Training を Disallow AI Training に設定します。複数用途のクローラーによる検索への影響も受け入れられる場合に限り、Block を使います。
AIコンテンツをすべてブロックする方法はある?
クローラーのカテゴリ単位または個別クローラーのブロックは可能ですが、「すべてのAIコンテンツ」には複数の異なる用途が混在しています。Cloudflare は自動アクセスを Search、Training、Agent に分け、許可する用途を選べるようにしています。Training をブロックしても、検索製品からAI生成コンテンツが消えるわけではなく、収集済みデータも削除されません。
検索のAIモードを無効にするには?
Cloudflare のクローラー設定は、利用者側のAI検索体験をオフにするものではありません。制御するのは、自分のドメインへのアクセスです。Google などの事業者は生成要約向けに別の制御を提供しており、従来型のインデックス作成と学習への意思表示も、それぞれ独立した判断です。
事業向けに、このようなクローラーポリシーの監査・監視基盤を構築したい方は、AIプロダクションシステムをご覧ください。
- 最終更新
- 2026年9月16日
- カテゴリー
- Build
Googleでこのサイトを優先する


omidsaffari.comを優先ソースに設定すると、GoogleがTop Stories・AI Overviews・AI Modeであなたのために優先表示します。

GitHub Copilot 料金ガイド(2026):プラン比較とAI Credits込みの月額
GitHub Copilotの料金は、月額の基本料金だけでは決まりません。FreeからPro、Pro+、Max、Business、Enterpriseまで、AI Creditsの付与額とモデル別の単価を比較。個人とチームの月額試算、アップグレードの損益分岐点、追加費用を抑える予算設定を確認できます。価格は米ドル表記。2026年10月6日Build
GitHub Copilot CLIの使い方:導入からテスト修正・PR作成まで
GitHub Copilot CLIのインストールから認証、リポジトリの把握、テスト修正、PR作成までを解説します。各プランのUSD建ての料金と共有AIクレジット、対応モデル、ツールの承認範囲、プロジェクト向けの指示ファイル、MCP設定を整理し、既存のCopilot契約でターミナルでの作業を始める判断材料を紹介します。2026年10月6日Build
スクレイピングツール8選:用途と実際の月額費用で選ぶ【2026年版】
スクレイピングツールは、AI向けのページ取得、ノーコードでの変更監視、大規模収集のどこを任せたいかで選びます。Firecrawl、Browse AI、Bright Data、Context.devなど8製品の料金と無料枠、JSON抽出の追加費用、実行上限を比較。運用担当と出力形式に合う選び方がわかります。2026年10月6日Build
AI メモリの設計入門:エージェントに何を記憶させ、どう使うか
AI メモリを導入する前に、何を残すべきかを見極めましょう。コンテキスト、セッション状態、長期ストア、ファイルとスキルの役割を整理し、Claude・OpenAI・Googleの標準機能と費用を解説します。履歴の再入力とのコスト比較や、古い事実、ユーザー間の情報漏えい、メモリポイズニングへの対策も紹介します。2026年10月5日Build
Pinecone 料金ガイド【2026年】:無料枠から1M〜100Mベクトルの月額まで
Pineconeの料金を2026年10月5日の情報で整理。無料のStarter、月額$20のBuilder、StandardとEnterpriseの最低利用料金に加え、1M・10M・100Mベクトルの試算を解説します。RAGやエージェントのメモリで費用を左右する検索範囲、書き込み、転送量、代替サービスまで確認できます。2026年10月5日Build
AI アプリ開発ツール比較:Lovableの代替候補と料金・移行の判断軸【2026年】
AI アプリ開発でLovableからの乗り換えを検討する方向けに、Replit、Emergent、Blink、Bolt.new、Base44、v0、Whackaを比較。月額料金だけでなく、クレジットの消費、バックエンドの対応範囲、コード出力とデータ移行、本番運用の費用まで確認し、用途に合う選択肢を見極めます。2026年10月5日Build
LangSmith料金を比較:チーム規模で選ぶLLM可観測性ツール6選【2026年】
LangSmith料金を軸に、Langfuse、Helicone、Arize Phoenix、Braintrust、Datadogを比較します。月100,000回の実行を同じ条件で試算し、チーム人数、課金単位、保持期間、セルフホストのライセンス、OpenTelemetry対応から本番運用に合うツールを選びます。2026年10月5日Build