منع تدريب الذكاء الاصطناعي في Cloudflare دون حجب البحث
اضبط Cloudflare لمنع تدريب الذكاء الاصطناعي مع إبقاء زواحف البحث فعّالة، ثم راجع الإعدادات المنقولة وملف robots.txt وتحقق من وصول محركات البحث.



لمنع تدريب الذكاء الاصطناعي مع إبقاء زواحف البحث عاملة، اضبط Search على Allow، واضبط Training على Disallow AI Training، ثم تحقّق من الإعدادات التي رُحّلت ومن ملف robots.txt الذي يقدّمه Cloudflare. تزداد أهمية ذلك الآن بعدما غيّرت Cloudflare معنى Block في 15 سبتمبر 2026. فقد أصبح Block قادرًا على منع الزواحف متعددة الاستخدامات مثل Googlebot وApplebot وBingbot من الوصول إلى موقعك لأغراض البحث أيضًا.
الإعداد الآمن في جدول واحد
الخيار المناسب لمعظم المواقع التي تعتمد على البحث واضح: اسمح لفئة Search، وارفض فئة Training، وحدّد بصورة مستقلة ما يمكن لفئة Agents فعله.
يوضح شرح Cloudflare المنشور في 15 سبتمبر الأمر صراحة: استخدم Disallow AI Training عندما تريد إيقاف التدريب مع الإبقاء على البحث. لا تتبع دليلًا قديمًا يطلب منك اختيار Training: Block. قبل التغيير، كانت الزواحف متعددة الاستخدامات مستثناة من ذلك الحظر، أما الآن فلم تعد كذلك.
عنصر التحكم متاح في جميع خطط Cloudflare، لذلك لا تحتاج إلى شراء ترقية منفصلة للميزة. وبدلًا من دفع ثمن منتج حظر آخر، تصبح المهمة هي التأكد من تطابق السياسة مع السلوك الفعلي. وللمقارنة، يبلغ سعر مقعد Screaming Frog SEO Spider في الولايات المتحدة $279 سنويًا، بينما يعلن أحد منتجات مراقبة robots.txt المتخصصة عن باقة بسعر $129 شهريًا. توفّر Cloudflare عنصر التحكم، لكنك ما زلت بحاجة إلى دورة تحقق.
كيف يعمل منع تدريب الذكاء الاصطناعي فعليًا
خيار Disallow تفضيل يُنفّذ بصورة انتقائية، أما Block فباب موصد.
تخيّل الزاحف متعدد الاستخدامات كشاحنة توصيل تحمل مهمتين. تقول الأولى: «افهرس هذه الصفحة للبحث». وتقول الثانية: «استخدم هذه الصفحة لتدريب نموذج». حظر الشاحنة يوقف المهمتين معًا، بينما يتيح Disallow AI Training للمشغّل الخاضع للمساءلة تنفيذ مهمة البحث ورفض مهمة التدريب.
تقسم Cloudflare الزيارات الآلية إلى ثلاثة سلوكيات:
- Search ينشئ فهرسًا للبحث.
- Training يدرّب نموذجًا أو يضبطه ضبطًا دقيقًا.
- Agent يزور الموقع نيابة عن شخص، مثل أداة تجلب صفحة لمحادثة أو وكيل يستخدم المتصفح.
يوجّه خيار Training الجديد Bot Preference Sync إلى نشر تعليمات عدم التدريب ذات الصلة في robots.txt. وتظل الزواحف متعددة الاستخدامات الخاضعة للمساءلة مؤهلة للوصول لأغراض البحث. أما زواحف التدريب فقط التابعة لـAmazon وAnthropic وMeta وOpenAI فتُحظر من دون أن تُحظر معها زواحف البحث المنفصلة التابعة لتلك الشركات.
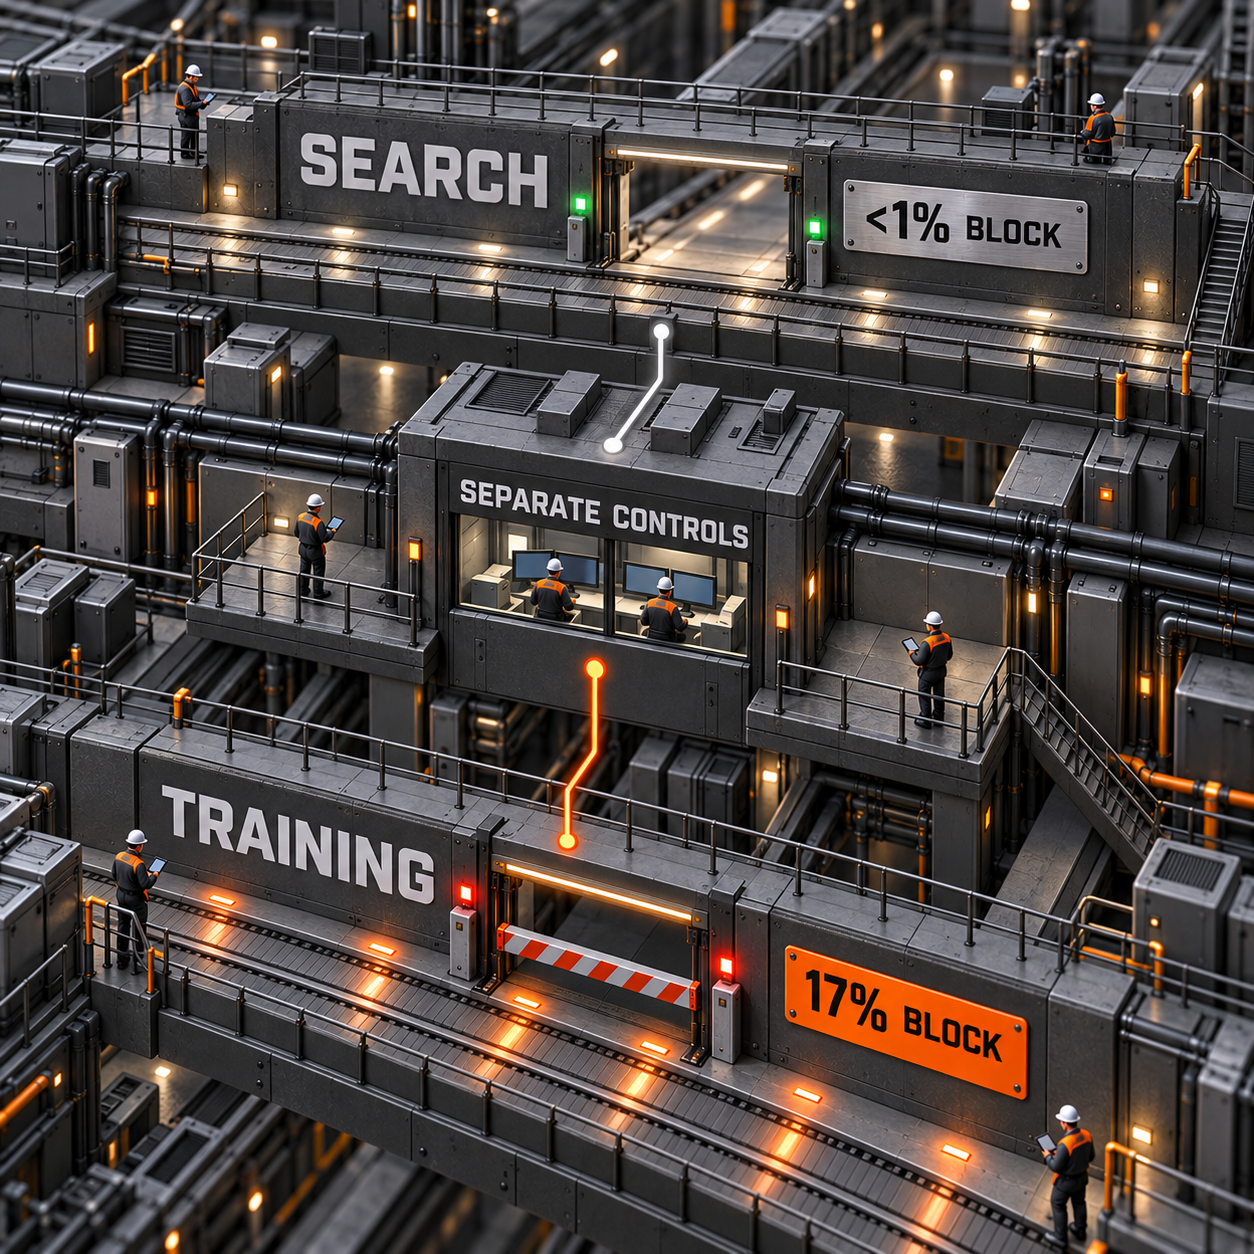
تفيد Cloudflare بأن أقل من 1% من مواقعها تحظر روبوتات Search، بينما يفعّل 17% منها آلية ما لحظر Training. هذه الفجوة تفسّر تصميم المنتج؛ فقد كان مفتاح Block AI واحدًا أداة فظة أكثر مما يلائم ما يريده مالكو المواقع فعليًا.
وهنا فارق مهم: تعليمة robots.txt ليست حقل قوة. فهي لا تستطيع وحدها معرفة هوية الزاحف أو سبب زحفه، ولا إيقاف زاحف يتجاهلها. لذلك تجمع Cloudflare بين التفضيل المنشور وبين التصنيف على مستوى الشبكة والحظر للزواحف التي لا تستوفي شروط المسار الخاضع للمساءلة.
صفة Accountable لا تعني دائمًا أن الميزة متاحة اليوم
تعامل مع تصنيف Accountable لدى Cloudflare بوصفه حالة مدعومة بخارطة طريق، لا دليلًا على أن كل عنصر تحكم موعود به متاح بالفعل.
للتأهل، يجب على المشغّل أن يستوفي متطلبات تشمل إتاحة الانسحاب من التدريب، والانسحاب من الملخصات التي ينشئها الذكاء الاصطناعي، والرؤية على مستوى عنوان URL، وضمان ألا يضر رفض التدريب بالبحث التقليدي، أو أن يلتزم بتحقيق تلك المتطلبات. ولهذه الصياغة أهميتها.
- Google: يمكن حظر Google-Extended في robots.txt، وتقول Google إن هذا الخيار لا يؤثر في ترتيب نتائج البحث. وتتيح Google أيضًا لمشرفي المواقع عنصر تحكم للبحث التوليدي وإعداد التقارير. أما الشفافية الإضافية لـGoogle-Extended على مستوى عنوان URL، فكانت لا تزال موصوفة بأنها ستصل في الأسابيع التالية للإعلان.
- Apple: يدعم Applebot-Extended الانسحاب من التدريب عبر robots.txt. كما تدعم Apple تعليمة
nosnippetلملخصات الذكاء الاصطناعي وتصنيف المحتوى المدفوع. ولم تكن المعاينة على مستوى عنوان URL متاحة يوم الإعلان، ووُصفت بأنها عمل مقرر للعام التالي. - Microsoft: يسلك Bing مسارًا مختلفًا حاليًا. يمكن لمالكي المواقع استخدام
NOARCHIVEإلى جانب أداتي Block URLs أو Content Removal في Bing. وتستهدف Microsoft مطلع 2027 كي يحترم Bingbot تفضيل عدم التدريب على مستوى النطاق في robots.txt. وحتى ذلك الحين، لا يرسل إعداد Disallow AI Training في Cloudflare هذا التفضيل تلقائيًا إلى Bing عبر robots.txt.
إذًا، الوعد الدقيق أضيق من القول إن «مفتاحًا واحدًا يتحكم في كل استخدام في كل مكان». يجعل الإعداد الجديد قرار المفاضلة الآمنة بين البحث والتدريب أوضح بكثير، لكن Bing لا يزال يحتاج اليوم إلى فحص منفصل.
راجع ما رحّلته Cloudflare
تنتقل معظم الإعدادات تلقائيًا، لكن المسميات والآثار تغيّرت بما يكفي لجعل تدقيق النتيجة ضروريًا.
إذا لم يكن النطاق قد استخدم من قبل عناصر التحكم التفصيلية Search وTraining وAgent، فإن Cloudflare ترحّل إعداد Block AI Bots القديم على النحو التالي:
إذا كان النطاق يستخدم عناصر التحكم التفصيلية بالفعل، تحتفظ فئتا Search وAgent بحالتهما العملية. ويبقى Training: Allow على Allow. أما Training: Block وTraining: Block on pages with ads فيتحولان كلاهما إلى Disallow AI Training.
نفّذ فحص الترحيل التالي:
- افتح النطاق في Cloudflare وانتقل إلى Security Settings، ثم Configure AI bot policies.
- دوّن القيم الحالية لـSearch وTraining وAgent قبل تغيير أي شيء.
- اضبط Search على Allow إذا كان الوصول العضوي مهمًا.
- اضبط Training على Disallow AI Training إذا أردت الانسحاب من التدريب من دون إبعاد الزواحف متعددة الاستخدامات الخاضعة للمساءلة عن البحث.
- اختر سياسة Agent وفق مقتضياتها المستقلة. لا توفّر Cloudflare تفضيل Disallow لفئة Agents لأنه لا توجد بعد تعليمة إنترنت راسخة لهذا الغرض.
- تأكد من تفعيل Bot Preference Sync إذا أردت أن تنشر Cloudflare سياسة الفئة في robots.txt.
- احفظ السياسة، ثم افحص النتيجة العامة بدل اعتبار تسمية لوحة التحكم دليلًا كافيًا.
بالنسبة إلى النطاقات الجديدة المدعومة بالإعلانات، يتبع الإعداد المسبق الذي توصي به Cloudflare هذا النمط بالفعل: تشغيل Preference Sync، والسماح لـSearch، ورفض Training، وحظر Agents في الصفحات التي تعرض إعلانات. أما النطاقات الجديدة التي لا تحقق دخلًا من الإعلانات، فتبدأ بالسماح بالسلوكيات الثلاثة كلها.
تحقّق من وصول البحث بعد التغيير
ظهور المفتاح على الإعداد الصحيح ليس سوى نقطة الفحص الأولى. اختبر السياسة من الخارج إلى الداخل.
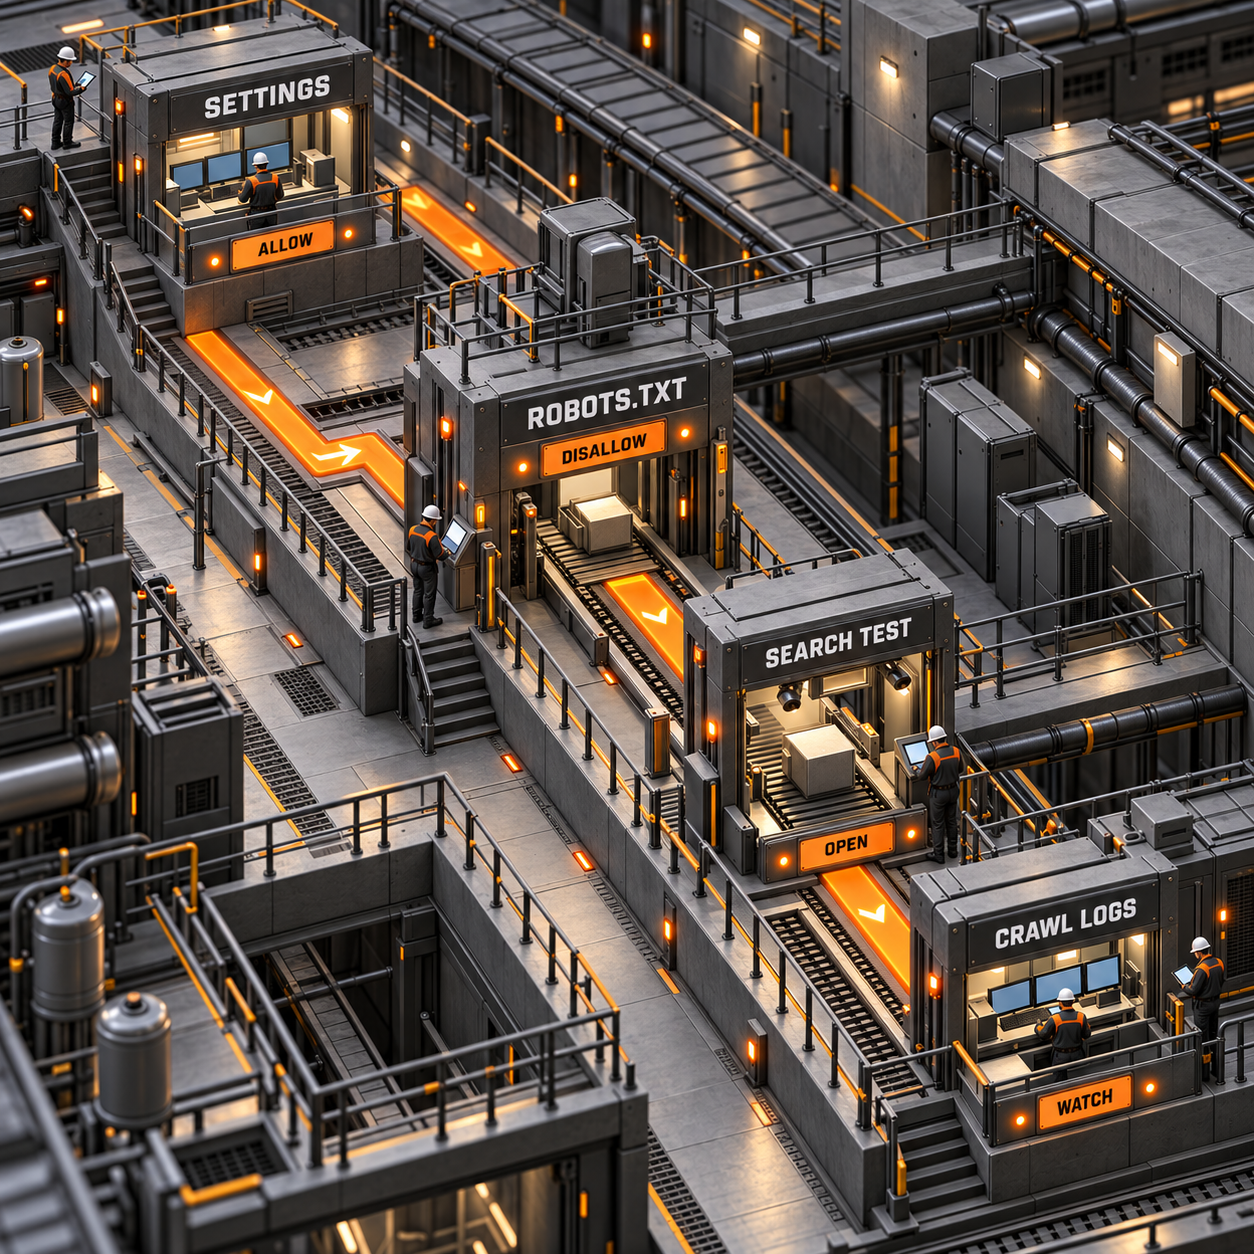
استخدم هذا الفحص المؤلف من أربعة أجزاء:
- الإعدادات: تأكد من أن Search يعرض Allow وأن Training يعرض Disallow AI Training. راجع Agent بصورة مستقلة.
- robots.txt: اجلب ملف
/robots.txtالحي من النطاق العام. يضيف Bot Preference Sync قواعده المُنشأة في مقدمة الملف الموجود، لذلك تبقى تعليمات Disallow الأصلية كما هي. ابحث عن أي تعارض بين القسمين. - سلوك البحث: استخدم أدوات مشرفي المواقع وتقارير مشغّل البحث لفحص عناوين URL ممثلة. لا تستنتج حالة وصول البحث من كلمة "Disallow" وحدها؛ فهي تنطبق على هوية التدريب أو تفضيله، لا على غرض البحث التقليدي للزاحف متعدد الاستخدامات الخاضع للمساءلة.
- نشاط الزواحف: راقب AI Crawl Control لمتابعة الطلبات والامتثال لـrobots.txt وعمليات الحظر غير المتوقعة. تستطيع Cloudflare تطبيق إجراءات على زواحف منفردة وتسجيل النشاط، ولذلك فهي المكان العملي لاكتشاف سياسة تتصرف على نحو مختلف عن مقصدك.
تستحق القواعد المخصصة عناية إضافية. يعكس Bot Preference Sync السياسة على مستوى الفئة، لكنه لا يحوّل القواعد الفردية المعقدة إلى الملف المُنشأ. إذا كان لديك استثناء ترخيص لزاحف بعينه، أو منطق خاص بمسار محدد، أو قاعدة WAF مخصصة، فقارن هذه الطبقات يدويًا. وتتيح Cloudflare تعطيل Sync وصيانة الملف بنفسك عندما تكون السياسة العامة للفئة أوسع من حاجتك.
من المستفيد الأكبر من الفصل الجديد؟
أكبر مستفيد هو كل نشاط يربح عندما يصل شخص إلى الصفحة، لكنه لا يريد أن يُمتص أرشيفه في بيانات التدريب.
يكشف مثال متجر التجزئة قيدًا آخر أيضًا: تعمل عناصر التحكم هذه على مستوى النطاق. فهي ليست نظام موافقة مدمجًا لكل مقالة. يمكن للنطاقات المنفصلة حمل سياسات مختلفة، لكن كل نطاق يحصل على وضع واحد لفئات Search وTraining وAgent، ما لم تضف بنفسك قواعد أكثر تحديدًا.
ما المنتج الجدير بالبناء؟
أقوى منتج هو مراقب تراجع لسياسات الزواحف، لا مولّد robots.txt آخر.
1. مراقب تراجع سياسات الزواحف
ابنِ أداة مراقبة للوكالات والفرق التي تدير عدة مواقع؛ تقرأ سياسة Cloudflare، وتجلب ملف robots.txt المقدّم، وتفحص وصول البحث إلى صفحات ممثلة، ثم ترسل تنبيهًا عندما تفقد هذه الطبقات اتساقها.
الطلب المحيط بهذه المهمة واضح: يحصل robots.txt generator على نحو 1,000 عملية بحث شهريًا في الولايات المتحدة، ويحصل google indexing checker على نحو 110. وتؤكد الأدوات القائمة وجود ميزانية أيضًا؛ إذ يطرح أحد منتجات مراقبة robots.txt باقة لخمسة نطاقات بسعر $129 شهريًا، بينما يبلغ سعر برنامج مكتبي لمراقبة تغييرات تحسين محركات البحث $179 دفعة واحدة.
تحتاج أصغر نسخة قابلة للبيع إلى أربعة عناصر: استيراد نطاقات Cloudflare، ومقارنة السياسة مع robots.txt، وفحوص مجدولة، وتنبيه عبر البريد الإلكتروني أو Slack يعرض التغيير بدقة. أضف نشاط الزواحف وبيانات مشرفي المواقع بعد إثبات موثوقية كاشف الانحراف الأساسي.
المعضلة هي الإثبات. يمكن للإعداد والطلبات المرصودة أن يبيّنا ما نشره الموقع وما حظره، لكنهما لا يثبتان أن مورّد نموذج حذف بيانات سبق أن جمعها. لذلك يجب أن يكون الحاجز التنافسي أدلة موثوقة عبر نطاقات كثيرة، لا مفتاحًا أجمل شكلًا.
2. مدقق ترحيل Cloudflare
ابنِ تدقيقًا مركزًا يعثر على النطاقات التي لا تزال تستخدم تركيبات خطرة بعد الترحيل، وينتج تقرير معالجة لوكالة أو مجموعة ناشرين أو شبكة امتياز.
يحصل cloudflare block ai bots على نحو 50 عملية بحث شهريًا في الولايات المتحدة مع تكلفة نقرة قدرها $13.19، بينما يضيف google indexing checker 110 عمليات بحث شهرية أخرى مرتبطة بالنتيجة التي يخشاها المستخدم. هذا الطلب أصغر من سوق أدوات الإنشاء، لكن سعر النقرة المدفوعة يوحي بأن الباحثين يواجهون مشكلة تشغيلية حاضرة.
يمكن للنسخة الأولية قراءة حقول API الخاصة بـSearch وTraining وAgent وBot Preference Sync، وجلب ملف robots.txt العام، وتصنيف كل نطاق بأنه آمن للبحث أو محظور عن قصد أو غير متسق. وصدّر حزمة أدلة جاهزة للعميل تعرض الإعداد والملف المرصود جنبًا إلى جنب.
المعضلة هنا هي مخاطر المنصة. يمكن لـCloudflare إضافة تقرير المجموعة نفسه، كما يبلغ الاحتياج ذروته حول فترات الترحيل. المشروع الأفضل هو استخدام التدقيق كمنتج تمهيدي، ثم بيع مراقبة مستمرة لتراجع السياسات عبر Cloudflare وغيرها من مزودي الحافة.
ما الذي لا يحلّه عنصر التحكم هذا؟
هذا حد أوضح للسياسة، لكنه ليس حلًا كاملًا لاستخدام المحتوى في الذكاء الاصطناعي.
- لا يمحو المواد التي جُمعت من قبل. تصف Cloudflare تفضيلات الزواحف وعناصر التحكم في الطلبات، لا الحذف بأثر رجعي.
- لا يضمن امتثال كل مشغّل لـrobots.txt. تضيف Cloudflare إنفاذًا على مستوى الشبكة للزواحف خارج المسار الخاضع للمساءلة، لكن المسار متعدد الاستخدامات يظل معتمدًا على احترام المشغّل للتفضيل.
- لا يستبعدك من كل ملخصات الذكاء الاصطناعي. عناصر تحكم الملخصات منفصلة، وتصف Cloudflare التحكم المركزي الأوسع في الملخصات بأنه عمل مستقبلي.
- لا يمنح Agents حالة Disallow.
- لا يحوّل القواعد المخصصة المعقدة لكل زاحف إلى Bot Preference Sync.
- لا يعبّر بعد تلقائيًا عن تفضيل عدم التدريب الخاص بـBing عبر robots.txt. افحص
NOARCHIVEوعناصر تحكم مشرفي المواقع الحالية في Bing بصورة مستقلة. - ليس هو فهرسة Cloudflare AI Search لملفات R2 من دون إعادة تسميتها. فذلك منتج وسير عمل منفصلان.
اختر Block عندما تريد فعلًا إبعاد الزاحف تمامًا. واختر Disallow AI Training عندما يظل اكتشاف المحتوى عبر البحث جزءًا من نموذج العمل. هذا الفارق هو جوهر تغيير سبتمبر.
خطوتك العملية ليوم الاثنين
اختر في الأسبوع المقبل ثلاثة نطاقات ممثلة: موقعًا يعتمد على الإعلانات، وموقعًا يقوده البحث، ونطاقًا لديه قواعد زحف مخصصة. دوّن قيم Search وTraining وAgent التي رُحّلت، ولا تغيّر سوى المواقع التي يتضح هدفها التجاري، ثم احفظ ملف robots.txt الحي وتقرير الزواحف إلى جانب تذكرة التغيير. إذا اجتازت النطاقات الثلاثة الاختبار، فطبّق الفحص نفسه القائم على الأدلة على المجموعة كلها.
كيف أوقف تدريب الذكاء الاصطناعي؟
في النطاق الذي تديره Cloudflare، اضبط Training على Disallow AI Training عندما تريد نشر تفضيل بعدم التدريب مع إبقاء الزواحف متعددة الاستخدامات الخاضعة للمساءلة متاحة للبحث. ولا تستخدم Block إلا إذا كنت تقبل أيضًا أثره في البحث بالنسبة إلى تلك الزواحف.
هل توجد طريقة لحظر كل محتوى الذكاء الاصطناعي؟
يمكنك حظر فئات الزواحف أو زواحف بعينها، لكن عبارة «كل محتوى الذكاء الاصطناعي» تخلط بين مهام مختلفة. تفصل Cloudflare زيارات Search وTraining وAgent لتختار الاستخدامات الآلية التي تسمح بها. ولا يؤدي حظر Training إلى إزالة المواد التي أنشأها الذكاء الاصطناعي من منتجات البحث أو محو البيانات التي جُمعت من قبل.
كيف أعطّل وضع الذكاء الاصطناعي في البحث؟
لا يعطّل إعداد الزواحف في Cloudflare تجربة بحث مدعومة بالذكاء الاصطناعي لدى المستخدمين؛ فهو يتحكم في الوصول إلى نطاقك. تتيح Google وغيرها من المشغّلين عناصر تحكم منفصلة للملخصات التوليدية، بينما تظل الفهرسة التقليدية وتفضيلات التدريب قرارين منفصلين.
إذا أردت بناء هذا النوع من تدقيق سياسات الزواحف وطبقة المراقبة لنشاطك، فاطّلع على أنظمة الذكاء الاصطناعي للإنتاج.
- آخر تحديث
- 16 سبتمبر 2026
- التصنيف
- Build
فضّل هذا الموقع في Google


اجعل omidsaffari.com مصدرًا مفضّلًا، وسيرفعه Google لك في Top Stories وAI Overviews وAI Mode.
الكتابة بالصوت مع Murmure: مراجعة عملية للخصوصية والدقة
مراجعة عملية لتطبيق Murmure للكتابة بالصوت بلا إنترنت: اختبرنا دقة Parakeet والقاموس وقواعد التنسيق، ونوضح الخصوصية والقيود والتكلفة ومن يناسبه.14 سبتمبر 2026Build
أسعار RenderIO: التكلفة الفعلية لواجهة FFmpeg API
دليل عملي لأسعار RenderIO يشرح رصيد الأوامر، وحدود التشغيل والتخزين، ونقاط الانتقال بين Starter وGrowth وBusiness، ويقارن تكلفة البدائل المتاحة.14 سبتمبر 2026Build
الكتابة بالصوت مع Dictare: هل هي مجانية فعلًا؟
دليل الكتابة بالصوت مع Dictare: اكتشف ماذا يشمل سعر $0، واحسب تكلفة وكيل البرمجة والجهاز والصيانة، وقارن بوضوح مع Spokenly وWispr Flow قبل الاختيار.13 سبتمبر 2026Build
اختبار إضافات Claude Code: من Evals إلى بوابة CI
دليل عملي لاختبار إضافات Claude Code عبر مقارنة A/B أصلية: أنشئ حالة سلوكية، واقرأ الدلتا والتكلفة، ثم حوّل الانحدار المقصود إلى بوابة موثوقة داخل CI.12 سبتمبر 2026Build
تشخيص زمن استجابة الوكيل الصوتي في Cloudflare
تعلّم تشخيص زمن استجابة الوكيل الصوتي في Cloudflare عبر توقيتات المراحل ونتائج الأدوار، وافصل بدقة بين مشكلات النسخ والنموذج وتوليد الصوت والمقاطعة.12 سبتمبر 2026Build
ترجمة الفيديو: دمج ملف SRT نهائيًا باستخدام Rendi
تعلّم ترجمة الفيديو بدمج ملف SRT داخل MP4 عبر Rendi، من إرسال مهمة FFmpeg وتنسيق النص إلى التحقق من اكتمال المعالجة ومراجعة الناتج قبل تشغيل الدفعات.11 سبتمبر 2026Build
OpenAI Agents: متى تختار Agents API ومتى تستخدم Agents SDK؟
مقارنة عملية بين OpenAI Agents API وAgents SDK من حيث ملكية الجلسات، والتحكم في وقت التشغيل، وتكاليف بيئة التنفيذ، وجهد الترحيل لاختيار المسار الأنسب.11 سبتمبر 2026Build