Claude Sonnet: precio frente a Haiku y cuál te conviene
Compara el precio de Claude Sonnet 5.5 y Haiku 5.5 para clasificar tickets, resumir documentos y programar, con tarifas de API y presupuestos mensuales.
Publicado el
 Por Omid Saffari

Al elegir Claude Sonnet, precio y tipo de tarea deben evaluarse juntos: usa Claude Haiku 5.5, el modelo pequeño de Anthropic, para clasificar y extraer información con un alcance bien definido; reserva Claude Sonnet 5.5, su modelo de propósito general más grande, para dirigir el trabajo de programación y tomar decisiones que exigen un criterio más amplio. En el escenario de clasificación de tickets descrito aquí, la factura mensual de tokens es de $16 con Haiku o $320 con Sonnet. Cuando el prompt supera los 100,000 tokens, la ventaja de precio de Haiku pasa de 20 veces a cuatro.
Precios y especificaciones verificados el 8 de octubre de 2026 en la documentación de precios de Anthropic, la descripción general de los modelos y claude.com/pricing. Los presupuestos son cálculos basados en supuestos explícitos de consumo de tokens, no pruebas de rendimiento. Los precios están en USD.
Claude Sonnet: precio frente a Haiku y qué modelo elegir
Elige Haiku si necesitas una respuesta acotada que puedas comprobar; elige Sonnet para dirigir un trabajo que requiere interpretar, coordinar y resolver fallos. La decisión depende de los resultados que cumplen tus criterios, la longitud del prompt, el contexto reutilizable y el costo de corregir un error.
- Si diriges una empresa y necesitas distribuir tickets de soporte: empieza con Haiku. Generar una etiqueta de una lista fija de destinos cuesta poco y es fácil evaluar el resultado con ejemplos ya etiquetados. Escala los casos sin resolver en lugar de pagar la tarifa del modelo más grande por cada ticket.
- Si eres CTO de una empresa mediana y debes resumir documentos extensos: Haiku gana en costo de tokens para extraer información fiel al original y generar resúmenes con requisitos precisos, siempre que conserve los datos que necesitan tus usuarios. Prueba Sonnet como siguiente opción cuando haya que conciliar pasajes contradictorios o explicar sus consecuencias. Ambos modelos admiten entradas largas; la capacidad, por sí sola, ya no decide cuál conviene.
- Si desarrollas por tu cuenta o diriges un equipo de ingeniería con un agente de programación: deja a Sonnet a cargo del cambio completo. Asigna a Haiku tareas pequeñas, como encontrar archivos relevantes, extraer mensajes de error o resumir un diff acotado. El ahorro viene de los agentes auxiliares; el coordinador sigue revisando las pruebas que aportan.
Para quien dirige las operaciones, la pregunta final es si la opción más barata añade trabajo de corrección. Ahorrar una fracción de centavo por ticket sirve cuando hay volumen. Añadir otra intervención humana puede consumir ese ahorro de inmediato.
La comparación de API que sigue utiliza Claude Haiku 5.5 y Claude Sonnet 5.5. MTok significa un millón de tokens, las unidades de texto que procesa un modelo. La entrada es el material que envías; la salida, el que genera.
Fuentes: tarifas vigentes y especificaciones de los modelos. Las escrituras en caché son categorías adicionales de entrada facturada; se explican más adelante.
Haiku vs Sonnet: las tarifas que componen la factura
Haiku cuesta menos por tokens nuevos en ambos tramos de longitud del prompt. Sonnet debe justificar su factura más alta con un resultado que cumpla los criterios, menos correcciones o un mejor flujo de trabajo completo.
Por cada 1,000 tokens nuevos, Haiku cuesta $0.00010 de entrada y $0.00050 de salida en el tramo corto, o $0.00050 de entrada y $0.00250 de salida en el largo. Sonnet cuesta $0.002 de entrada y $0.010 de salida. Estas cifras son las tarifas publicadas por MTok divididas entre 1,000; no representan el precio de una tarea terminada.
La distinción importa porque la salida puede dominar la factura. Un clasificador que devuelve una etiqueta y un agente que redacta una explicación larga consumen tokens de forma distinta. Del mismo modo, el historial y los resultados de herramientas de una sesión de programación pueden hacer que las solicitudes posteriores sean más grandes que la instrucción inicial.
El gráfico calcula el costo de los tres trabajos que se desarrollan más abajo. Cada par mantiene iguales los supuestos de consumo de tokens. En la comparación de programación, ambos flujos conservan un coordinador Sonnet, por lo que la barra más baja corresponde a una arquitectura híbrida, no a un agente que usa solo Haiku.
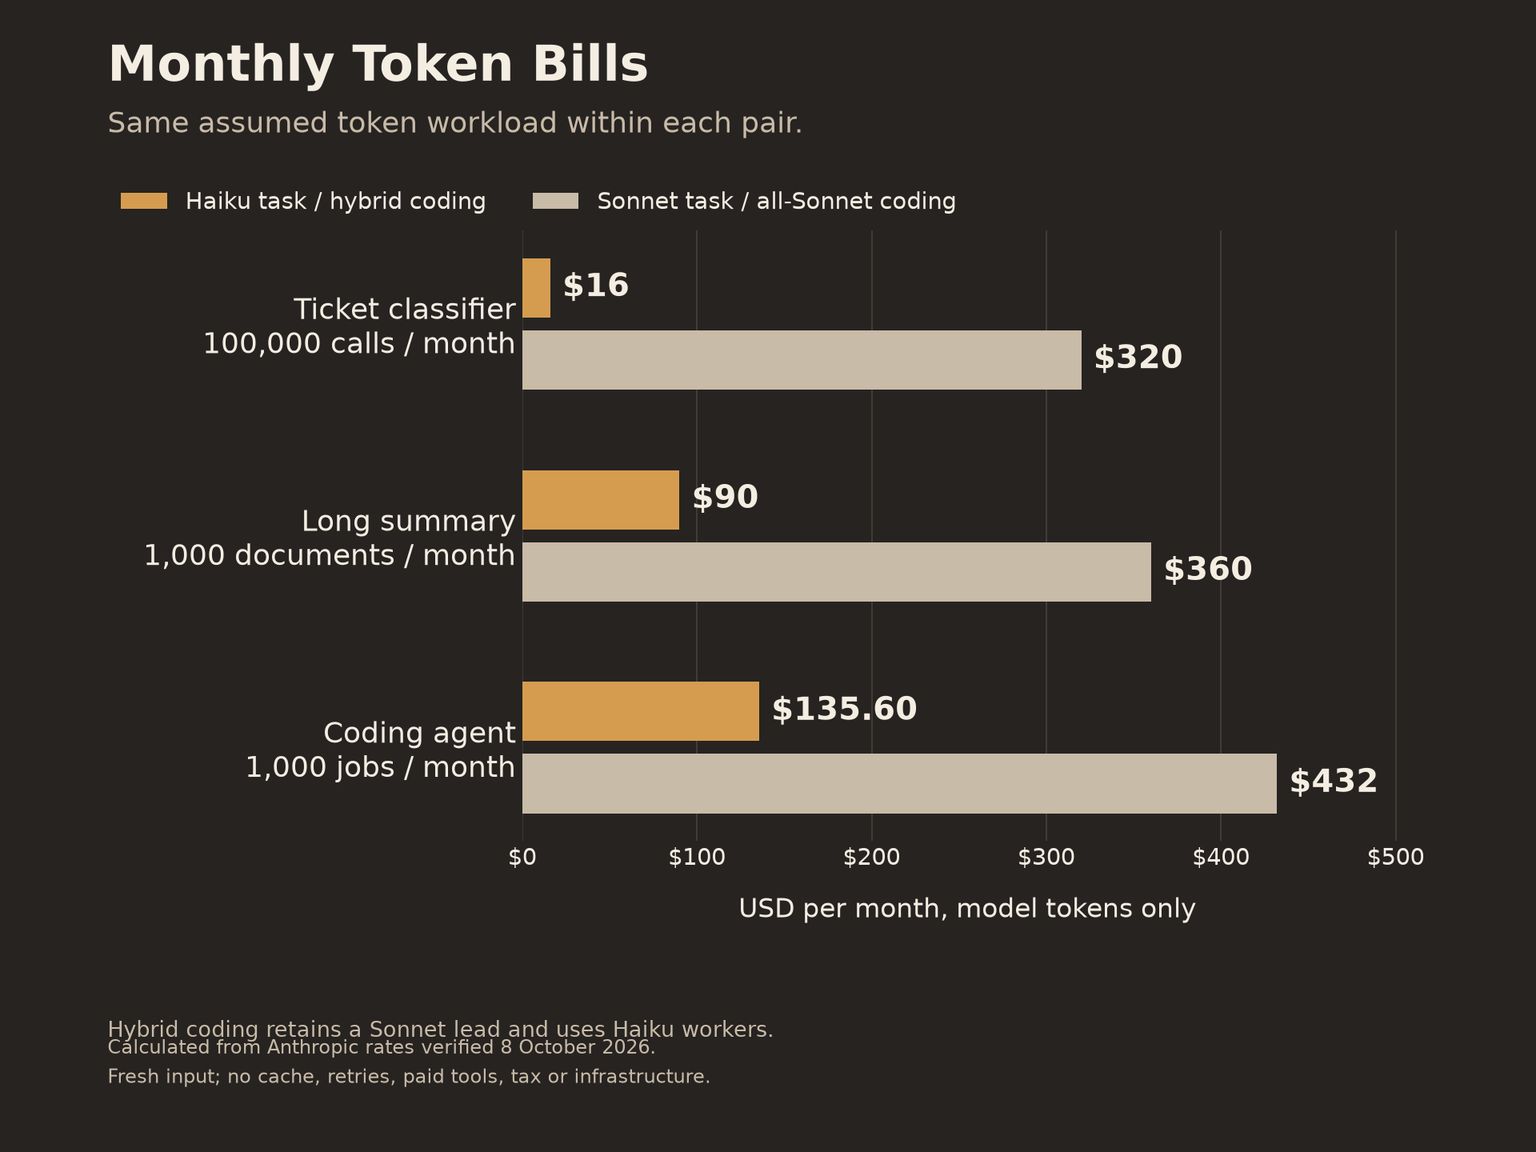
Los tres escenarios de referencia suponen las tarifas estándar de la API directa del proveedor, entrada nueva y ningún reintento ni herramienta de servidor con cargo independiente. Excluyen impuestos e infraestructura de la aplicación. Las cifras de salida representan el total de salida facturada que se supone en el presupuesto, no una estimación basada en la respuesta breve que ve el usuario. Sustituye estos supuestos por el consumo real de cada modelo antes de fijar un presupuesto de producción.
Para consultar toda la gama de modelos y otros conceptos de facturación, usa la guía de precios de la API de Claude.
Capacidad y razonamiento: mismos límites, distintos ajustes
Empatan en capacidad; Haiku gana en la etiqueta de velocidad relativa de Anthropic; el ajuste de razonamiento predeterminado es distinto. Las especificaciones de ninguno de los dos prueban que conservará los detalles necesarios de tus documentos o completará el cambio en tu repositorio.
¿Para qué sirve Claude Haiku 5.5?
Claude Haiku 5.5 es el candidato de menor tamaño para tareas frecuentes con requisitos muy precisos. Anthropic lo orienta a trabajos de gran volumen sensibles a la latencia, como la clasificación, la extracción y el enrutamiento; su descripción oficial es "For high-volume, latency-sensitive tasks such as classification, extraction, and routing." Sus tarifas para prompts cortos son de $0.10 de entrada / $0.50 de salida por MTok y suben a $0.50 / $2.50 para prompts más largos. Enfoque oficial, tarifas.
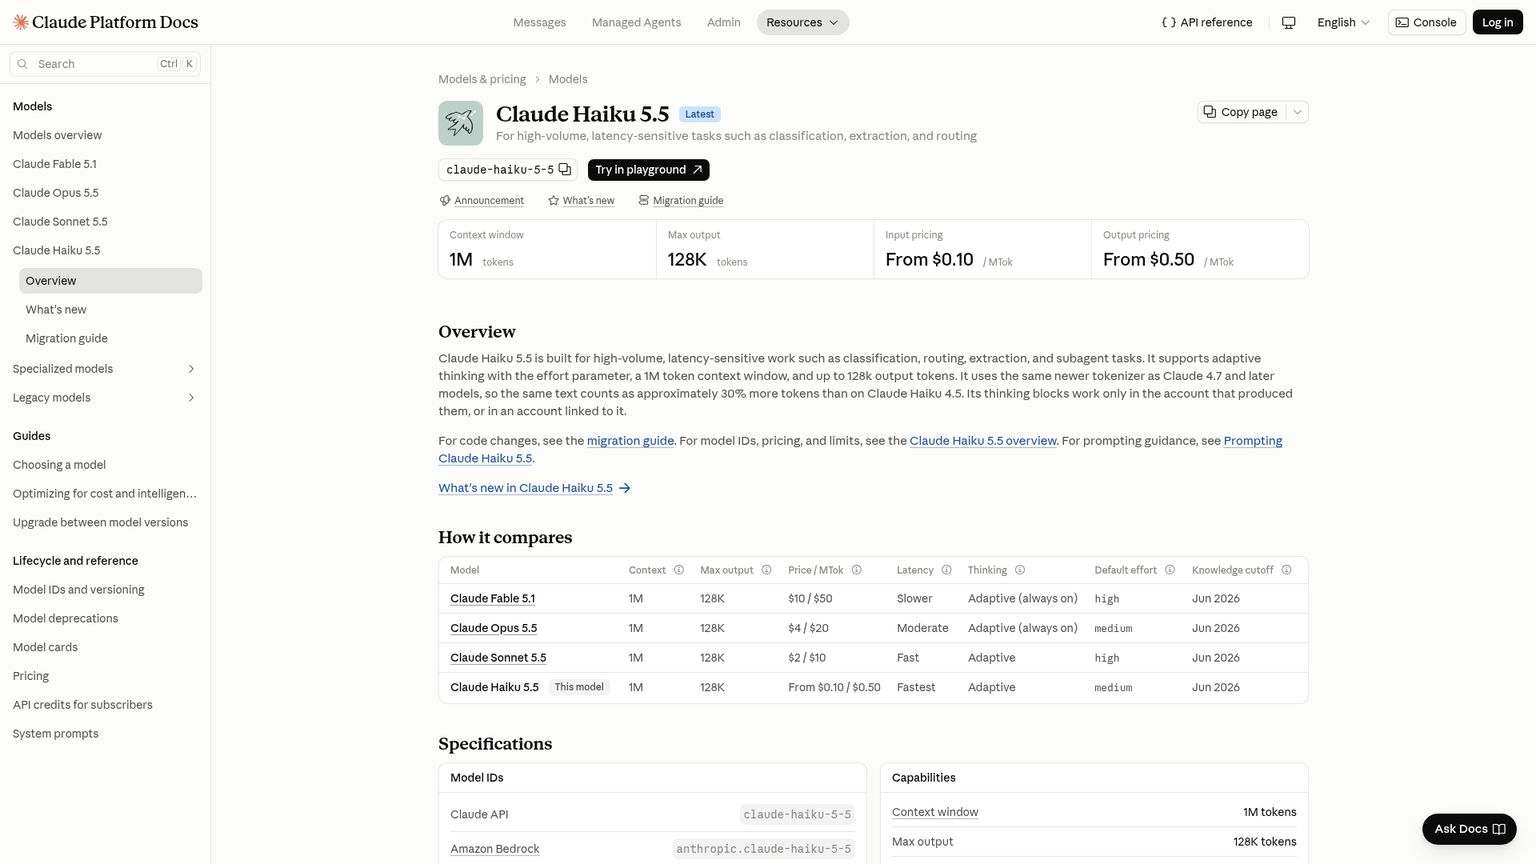
Elígelo para un clasificador de soporte con una lista fija de destinos, un extractor que devuelva campos definidos junto con los pasajes que los respaldan o un agente auxiliar que reúna pruebas para otro modelo. El límite práctico lo marca la comprobación del resultado: una respuesta que parece válida, pero llega a la cola equivocada, sigue siendo incorrecta. Descarta Haiku para una tarea si la evaluación ya muestra que corregir sus errores cuesta más de lo que ahorra su tarifa.
La guía de Claude Haiku 5.5 aborda la decisión de adoptar ese modelo. Esta comparación calcula el costo de Haiku y Sonnet para los mismos trabajos.
¿Para qué sirve Claude Sonnet 5.5?
Claude Sonnet 5.5 es el candidato de propósito general para trabajos que combinan velocidad con un criterio más amplio. Anthropic lo presenta como la mejor combinación de velocidad e inteligencia: "The best combination of speed and intelligence." Cuesta $2 de entrada / $10 de salida por MTok, con lecturas de caché a $0.10 para la entrada reutilizada que cumpla los requisitos. Enfoque oficial, tarifas.
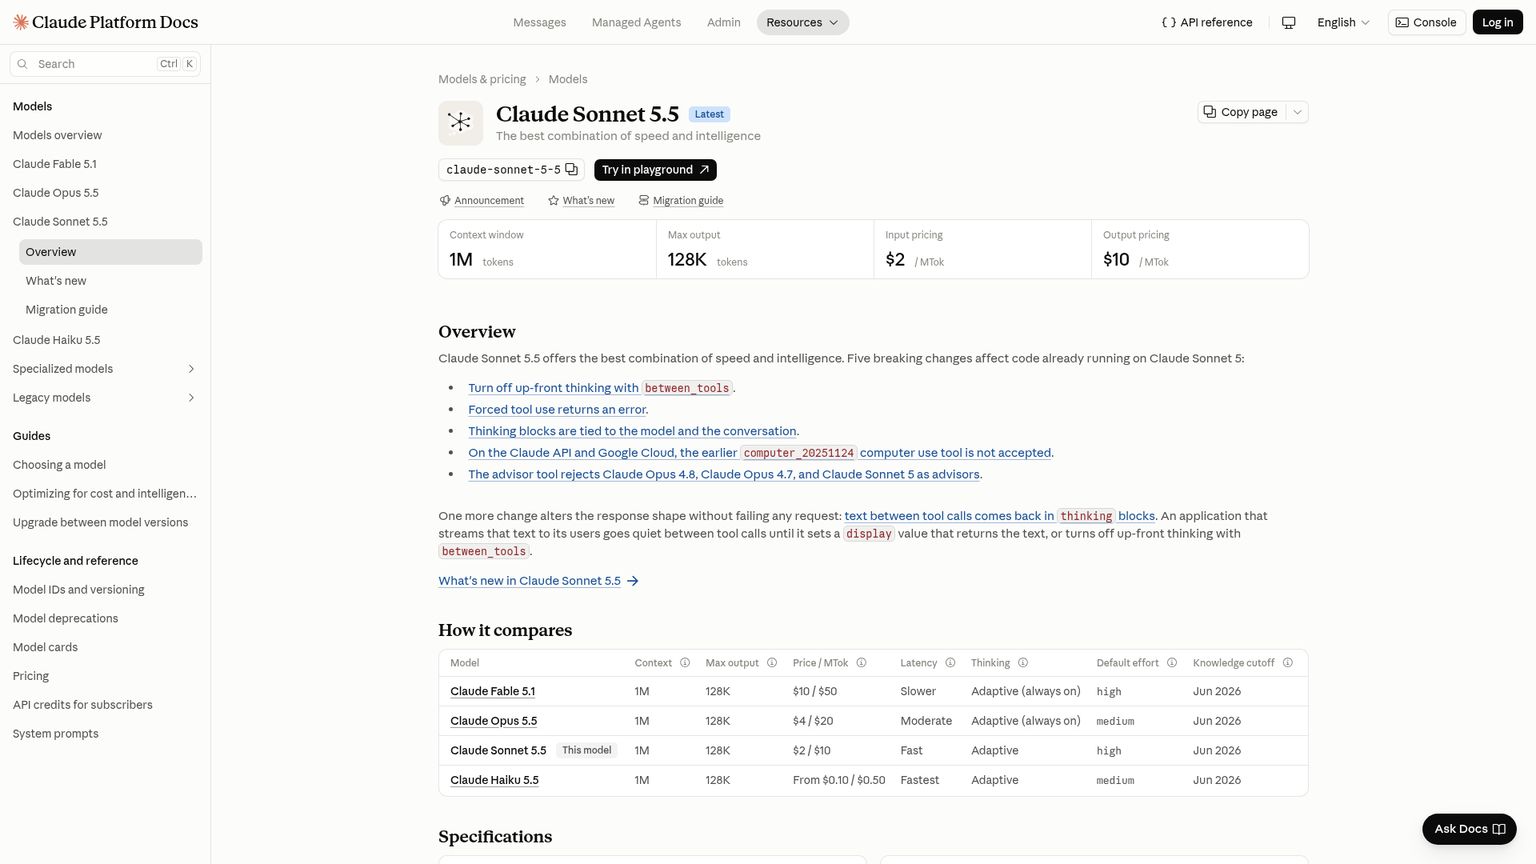
Dirigir un trabajo de programación implica decidir qué cambiar, integrar las pruebas disponibles y resolver los pasos que fallan. Dentro de esta selección de dos modelos, tiene sentido evaluar Sonnet primero para ese papel. Su desventaja es clara: la factura. Usarlo para cada etiqueta fácil de comprobar significa pagar la tarifa más alta, aporte o no algo su capacidad adicional. Resérvalo para los casos en los que los resultados que cumplen tus criterios justifiquen el sobrecosto.
¿Qué aportan los límites que comparten?
Ambos modelos tienen 1M de contexto, 128K de salida máxima y razonamiento adaptativo. El contexto es el espacio de trabajo disponible para una solicitud; la salida máxima limita la generación. El razonamiento adaptativo permite que el modelo ajuste cuánto razona. El esfuerzo predeterminado en la API de Haiku es medium y el de Sonnet, high. Ambos admiten imágenes como entrada y el uso de herramientas. Descripción general de los modelos.
Para un CTO que evalúa una colección extensa de políticas, el mismo límite de contexto elimina una diferencia de capacidad. Sigue siendo necesario comprobar las omisiones, las contradicciones y el respaldo de las fuentes. Además, el mayor esfuerzo predeterminado deja una variable sin controlar en el presupuesto si se comparan solo los nombres de los modelos, sin registrar los ajustes y el consumo facturado.
Estos son datos del proveedor y criterios editoriales de selección. Aquí no se afirma que haya un ganador medido en un benchmark. Una puntuación en una clasificación tampoco demostraría la tasa de error para tus categorías de tickets ni la calidad del cambio final en tu código.
Trabajo 1: clasificar tickets de soporte
Para etiquetas de cola que se comprueban, gana Haiku: $16 frente a $320 al mes en este escenario. Dale al modelo un conjunto acotado de opciones, valida la respuesta y deja las acciones con consecuencias sujetas a las reglas de tu aplicación.
Supongamos que una empresa SaaS procesa 100,000 tickets al mes. Cada clasificación consume 1,200 tokens de entrada nueva y 80 tokens de salida facturada, incluidas las instrucciones y el texto del ticket. Cada prompt se mantiene por debajo de 100,000 tokens. Se supone, por separado, el mismo consumo facturado para ambos modelos.
Eso suma 120 millones de tokens de entrada y 8 millones de tokens de salida al mes:
- Haiku: 120 × $0.10 + 8 × $0.50 = $12 + $4 = $16.
- Sonnet: 120 × $2 + 8 × $10 = $240 + $80 = $320.
El costo por 1,000 clasificaciones es de $0.16 con Haiku o $3.20 con Sonnet, calculado con las tarifas vigentes. El ahorro mensual en tokens es de $304.
Un contrato de clasificación útil define los destinos permitidos e incluye uno para los casos sin resolver. Valida que la respuesta use una etiqueta permitida y, después, evalúa si eligió la correcta con ejemplos cuya respuesta ya se conoce. La primera comprobación detecta un formato inválido; la segunda, una decisión plausible pero equivocada. Ninguna exige aceptar como prueba la confianza que el propio modelo dice tener.
Supongamos que el 10% de los tickets necesita una llamada adicional a Sonnet, con el mismo consumo de tokens previsto. El primer intento de Haiku también se paga: $16 + $32 = $48 al mes, un ahorro de $272 frente a usar Sonnet para todos los tickets. La tasa de escalamiento es un supuesto, no un resultado observado en este trabajo.
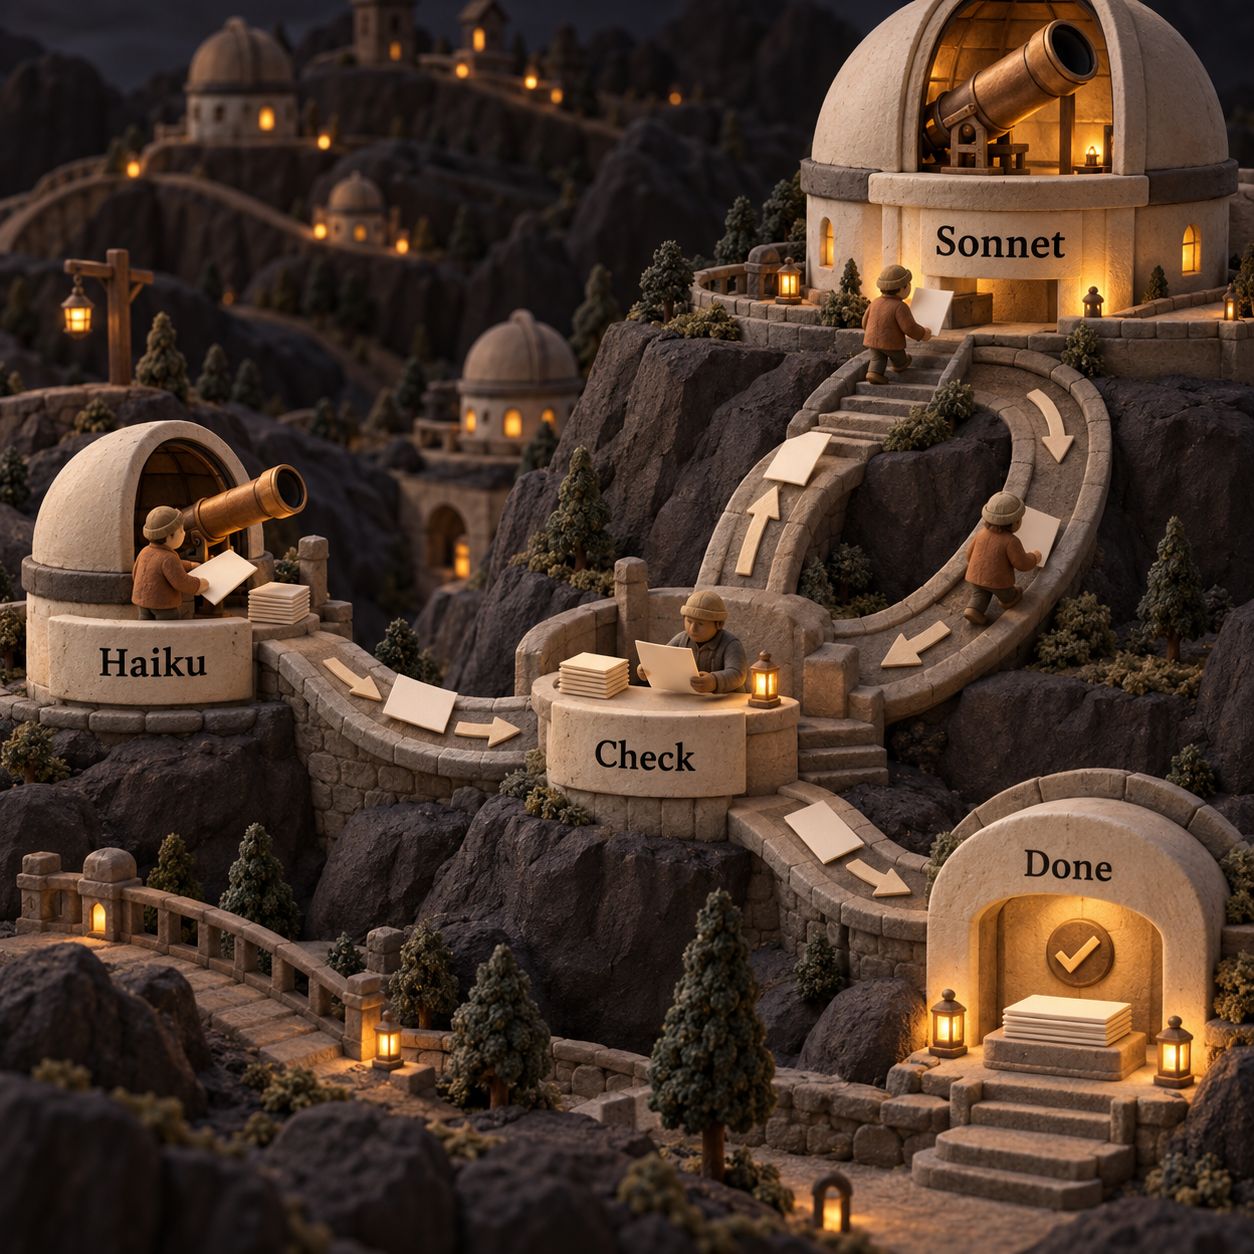
También existe un límite de escalamiento calculado solo con tokens. Si todos los casos empiezan con Haiku y una fracción e recibe después una llamada a Sonnet con el mismo consumo de tokens, el costo es H + e × S. Se iguala al costo de usar solo Sonnet cuando e = 1 - H/S: 95% de escalamiento para estas llamadas del tramo corto o 75% para llamadas equivalentes en el tramo largo de Haiku. Los prompts de escalamiento más grandes, los reintentos y la revisión humana pueden hacer que la opción más barata deje de serlo antes.
Trabajo 2: resumir un documento de más de 100K tokens
Para un resumen fiel que supera tus comprobaciones, Haiku gana en costo de tokens: aquí la diferencia es de cuatro veces. Conviene evaluar Sonnet cuando el resultado exige interpretar contradicciones o aplicar un criterio más amplio, además de reproducir los hechos respaldados por el documento.
Supongamos 1,000 documentos al mes, con 150,000 tokens de entrada nueva y 6,000 tokens de salida facturada por solicitud. La entrada incluye el documento y las instrucciones. Cada solicitud supera el umbral de prompt de Haiku, por lo que tanto la entrada como la salida se cobran en el tramo más alto.
Por documento:
- Haiku: 0.15 × $0.50 + 0.006 × $2.50 = $0.075 + $0.015 = $0.09.
- Sonnet: 0.15 × $2 + 0.006 × $10 = $0.30 + $0.06 = $0.36.
Los totales mensuales son $90 y $360, con un ahorro de $270, según las reglas de precios para contexto largo. En este trabajo no se aplica la afirmación de que Haiku cuesta una vigésima parte de Sonnet.
El umbral corresponde a cada prompt, no a una cuota mensual de la cuenta. Un prompt de exactamente 100,000 tokens reúne los requisitos para las tarifas más bajas de Haiku; uno más largo utiliza las tarifas más altas para esa solicitud. No apliques la tarifa de entrada más alta solo a los tokens que exceden el umbral ni mantengas la salida al precio del tramo corto.
Si preparas un informe interno de proyecto, define los datos que el resumen debe conservar: decisiones, responsables, plazos, excepciones y pasajes que los respaldan. Comprueba esos campos contra el documento. Si eres CTO y comparas requisitos incompatibles entre varios documentos, añade esos conflictos a la evaluación antes de elegir el modelo más barato.
Acortar la entrada puede conservar el tramo de menor precio si siguen cabiendo las pruebas necesarias. Dividir un documento sin criterio puede perder la relación que el resumen debe explicar. La unidad útil sigue siendo el resumen que cumple tus criterios, con cualquier pasada de corrección o síntesis incluida en su factura.
Caché: ¿cuándo puede Sonnet costar menos que Haiku sin caché?
Sonnet puede salir más barato que Haiku sin caché cuando domina el contexto reutilizado, pero Haiku sigue costando menos con el mismo patrón de caché. Una lectura de caché reutiliza entrada ya procesada. No reduce el precio de la respuesta nueva y almacenar el material reutilizable tiene un costo de escritura.
Las lecturas de caché de Sonnet cuestan $0.10 por MTok, lo mismo que la entrada nueva de Haiku en el tramo corto. Las de Haiku cuestan $0.01 en el tramo corto y $0.05 en el largo. Las tarifas de escritura con duración de cinco minutos son $2.50 para Sonnet o $0.125 / $0.625 para Haiku en sus tramos corto/largo. Precios de caché.
La comparación debe usar categorías de facturación equivalentes. Leer la entrada en caché de Sonnet a $0.10 y la entrada nueva larga de Haiku a $0.50 puede favorecer a Sonnet en la entrada, aunque su salida siga siendo más cara. Si ambos leen de caché, Haiku vuelve a tener la tarifa de entrada más baja.
Este es un punto de cruce que incluye la escritura, con el patrón de tokens del resumen extenso. Supongamos 149,000 tokens de prefijo reutilizable, 1,000 tokens de entrada nueva y 6,000 tokens de salida facturada por solicitud. El prefijo es el inicio del prompt que se mantiene sin cambios, como un documento y unas instrucciones comunes que se reutilizan en solicitudes distintas.
Supongamos una escritura en caché de cinco minutos seguida de 27 lecturas de caché exitosas dentro del mismo período de validez:
- Primera solicitud de Sonnet: 0.149 × $2.50 + 0.001 × $2 + 0.006 × $10 = $0.4345.
- Cada lectura posterior: 0.149 × $0.10 + 0.001 × $2 + 0.006 × $10 = $0.0769.
- En 28 solicitudes, el promedio es de aproximadamente $0.08967, apenas por debajo de los $0.09 por solicitud de Haiku sin caché.
Es un cruce aritmético sujeto a condiciones. Supone que el material compartido reúne los requisitos para almacenarse en caché y se reutiliza de verdad, sin más escrituras. No sirve para un presupuesto en el que cada documento es nuevo, las solicitudes llegan demasiado separadas o las instrucciones compartidas cambian constantemente.
Si Haiku utiliza el mismo patrón de caché, su primera solicitud del tramo largo cuesta $0.108625 y las lecturas posteriores, $0.02295. La comparación equivalente sigue favoreciendo a Haiku en tokens. La caché puede hacer asequible Sonnet cuando su criterio justifica el sobrecosto; no convierte al modelo más grande en la opción más barata para todos los casos.
Para un asistente de documentos que se usa de forma recurrente, mide las escrituras y las lecturas de caché por separado. Una previsión que cobra toda la entrada como si fueran lecturas omite el costo inicial y las partes del prompt que cambian. Incluye la salida generada en el cálculo, aunque el documento ya esté en caché.
Claude Haiku vs Sonnet para programar: deja a Sonnet como coordinador
Sonnet gana para dirigir la programación; Haiku, para tareas auxiliares acotadas y comprobadas. Un subagente es un modelo al que se asigna una tarea pequeña dentro de un trabajo mayor. Delega una parte cuyas pruebas pueda revisar el coordinador, en lugar de pedir al agente auxiliar que se haga cargo de un cambio abierto en el repositorio.
Supongamos 1,000 trabajos de programación al mes. Cada trabajo incluye:
- Un coordinador Sonnet que consume en total 30,000 tokens de entrada nueva y 6,000 tokens de salida facturada.
- Ocho agentes auxiliares, cada uno con un consumo total de 12,000 tokens de entrada nueva y 1,500 tokens de salida facturada.
Estos son supuestos de consumo total para las solicitudes de cada rol. Todos los prompts individuales se mantienen por debajo de 100,000 tokens. Incluye en esos totales las descripciones de herramientas, el historial, las pruebas de los agentes auxiliares y la revisión final del coordinador. Se supone el mismo consumo del coordinador para el flujo que usa solo Sonnet y para el híbrido; los tokens adicionales de transferencia de trabajo o los reintentos cambiarían la comparación.
Con las tarifas vigentes de la API, el coordinador cuesta $0.12 por trabajo. Un agente auxiliar Haiku cuesta $0.00195, por lo que ocho cuestan $0.01560. Un agente auxiliar Sonnet cuesta $0.039, por lo que ocho cuestan $0.312.
Híbrido: $0.12 + $0.01560 = $0.13560 por trabajo, o $135.60 al mes.
Sonnet en todos los roles: $0.12 + $0.312 = $0.432 por trabajo, o $432 al mes.
El ahorro calculado es de $296.40 al mes, o 68.6%. La factura total no se divide entre 20 porque se sigue pagando el coordinador Sonnet. Este escenario no demuestra una calidad de código equivalente ni una mejora de velocidad medida.
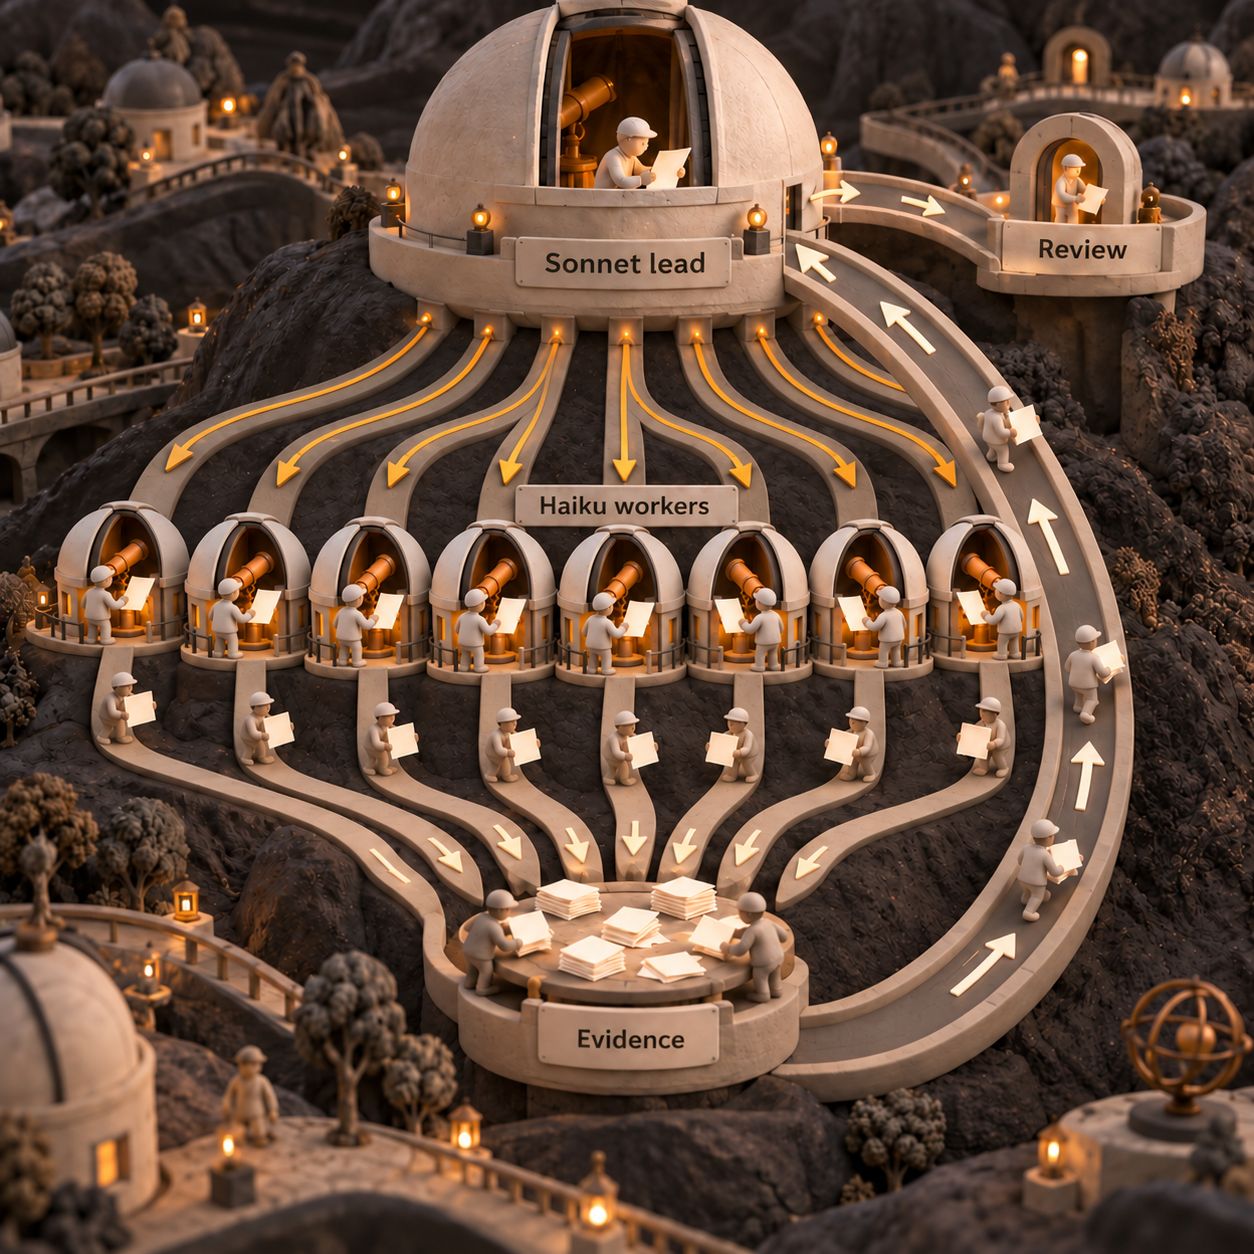
Un contrato apropiado para un agente auxiliar podría pedirle que encuentre archivos que hagan referencia a una función determinada, devuelva rutas y fragmentos relevantes e indique dónde hay incertidumbre. Otro podría resumir la salida de error de una comprobación fallida concreta. El coordinador utiliza esas pruebas para decidir qué cambiar. Es una recomendación de arquitectura de aplicaciones, no una afirmación de que este trabajo haya probado la implementación de subagentes de Claude Code.
La transferencia del trabajo es el posible punto de fallo. Un resumen breve puede omitir la excepción que necesitaba el coordinador; una afirmación sin comprobar puede convertir un agente barato en un cambio incorrecto y costoso. Conserva las referencias a las fuentes y entrega suficiente material original para que el coordinador verifique la respuesta del agente auxiliar. Cuenta cualquier trabajo repetido en el presupuesto híbrido.
Evita delegar cuando la supuesta tarea pequeña necesita casi el mismo contexto del repositorio que el coordinador o cuando revisar la entrega cuesta más que hacer la tarea directamente. Para un cambio con partes muy dependientes entre sí, usar Sonnet en todo el proceso puede producir el resultado válido más barato, pese a su mayor factura de tokens.
¿Cuándo pasar de Sonnet a Haiku, o de Haiku a Sonnet?
Cambia primero la tarea acotada y después compara el flujo completo. Mantenerte en la API de Claude puede conservar gran parte de la integración, pero cambiar el nombre del modelo no demuestra que la salida se comporte igual.
Los identificadores de modelo son claude-haiku-5-5 y claude-sonnet-5-5, incluidos en la descripción general de los modelos. Guarda una copia reproducible del prompt, las reglas de validación, las entradas representativas y las respuestas que cumplen los criterios. Registra el modelo, el esfuerzo, el consumo de tokens, la longitud del prompt, el uso de caché y los intentos por trabajo completado.
Pasar de Sonnet a Haiku tiene sentido para un clasificador o un agente auxiliar con un contrato claro. Comprueba el formato, el respaldo de los hechos y los fallos costosos antes de aumentar el tráfico. Conserva una forma sencilla de devolver esa tarea a Sonnet.
Pasar de Haiku a Sonnet tiene sentido cuando los costos de corrección o coordinación ya superan el ahorro. Mantén los mismos ejemplos para determinar si el modelo más grande resuelve los fallos que motivaron el cambio. Una respuesta más pulida no es prueba de que sea correcta.
Incluye también el trabajo de ingeniería en el presupuesto. Como ejemplo, una migración de cuatro horas a una tarifa supuesta de $100 por hora cuesta $400. Con el ahorro mensual de $304 en tokens del clasificador, la inversión se recupera en aproximadamente 1.3 meses, antes de contar la evaluación y los incidentes. Con solo 100 clasificaciones al mes, el mismo patrón de tokens ahorra $0.304 al mes. Ese ahorro ofrece pocos motivos económicos para rehacer un flujo que ya funciona.
No cambies únicamente por las tarifas si tu volumen de trabajo actual es pequeño, el resultado requiere un criterio más amplio o el reemplazo obliga a añadir otra etapa de revisión. Mantén portables los prompts, las pruebas y las comprobaciones para poder revertir la decisión si cambian las tarifas o las capacidades.
¿Qué modelos incluyen los planes de Claude?
Haiku y Sonnet figuran en los principales planes de Claude; el acceso por suscripción es una cuestión distinta de la factura de tokens de la API. Claude Opus y Claude Fable son otras familias de modelos de Anthropic. Aquí se mencionan para describir el acceso de los planes, sin ampliar esta comparación de costos entre dos modelos. La comparación de planes de claude.com, consultada el 8 de octubre de 2026, indica:
- Free: Haiku y Sonnet; Opus y Fable figuran como no disponibles.
- Pro: Haiku, Sonnet y Opus; Fable aparece como Usage credits (créditos de uso).
- Max 5x y Max 20x: Haiku, Sonnet y Opus; Fable figura con 50% de los límites semanales.
- Team: Haiku, Sonnet y Opus; Fable figura con 50% de los límites semanales en puestos premium.
- Enterprise, de autoservicio y con asistencia comercial: Haiku, Sonnet, Opus y Fable figuran como disponibles.
La tabla de planes enumera familias de modelos. No garantiza que todas las cuentas ofrezcan la misma versión 5.5 concreta ni los mismos ajustes de producto. La fila de contexto dice hasta 1M, varía según el modelo. Distingue esa afirmación de las especificaciones de la API anteriores.
Si eliges una función para un producto en producción, presupuesta el consumo medido de la API y los créditos que correspondan por separado del acceso interactivo por suscripción. Si eliges un modelo dentro de la aplicación, decide según la tarea y los límites de tu plan. Un ejemplo de tokens de API no permite prometer cuántos trabajos de programación incluirá una suscripción.
Preguntas frecuentes
Claude Sonnet vs Haiku: ¿cuál elegir?
Invertir el orden de los nombres no cambia la decisión. Evalúa Haiku para tareas acotadas con respuestas comprobables y Sonnet para dirigir el trabajo o resolver casos que requieren un criterio más amplio. Compara los resultados que cumplen tus criterios y todos los intentos facturados, no solo los nombres de los modelos.
Claude Haiku vs Sonnet vs Opus: ¿qué papel cumple cada uno?
Haiku es el candidato de bajo costo para grandes volúmenes de tareas acotadas; Sonnet, el candidato a coordinador en esta selección. Anthropic orienta Claude Opus 5.5 a trabajos prolongados de programación con agentes y tareas de conocimiento. Evalúalo si el coordinador sigue sin cumplir tus criterios; ese posicionamiento no es un resultado de calidad medido para tu aplicación. Descripción general de los modelos.
Claude Sonnet vs Opus vs Haiku: ¿cuál usar para programar?
Elige al coordinador por separado de los agentes auxiliares. Aquí se recomienda Sonnet como coordinador; Haiku es el candidato para tareas acotadas de recopilación de pruebas y Opus, otra opción de coordinador para trabajos más difíciles y prolongados. Evalúa el cambio final que cumple tus criterios e incluye en la factura la revisión, los reintentos y el consumo de las transferencias de trabajo.
Haiku 4.5 vs Sonnet 5: ¿sirve esta comparación?
Esa es una comparación de versiones anteriores. Los presupuestos y las especificaciones de esta página corresponden a Claude Haiku 5.5 y Claude Sonnet 5.5. No uses una tarifa ni un límite de contexto de una versión anterior de Haiku para decidir la comparación actual de 5.5.
¿Cuál es la diferencia de precio entre Claude Haiku y Sonnet?
Con el mismo número de tokens de entrada nueva y salida, Sonnet 5.5 cuesta 20 veces lo que Haiku 5.5 para prompts de hasta 100,000 tokens, o cuatro veces para prompts más largos. Las lecturas de caché tienen tarifas distintas y hay que incluir las escrituras pagadas. Precios vigentes.
¿Claude Haiku es suficiente para tareas empresariales?
Es un candidato razonable para empezar con clasificación, extracción y enrutamiento, las tareas que menciona Anthropic. Antes de adoptarlo, exige comprobaciones para los fallos que resultan costosos en tu caso. La diferencia de precio no demuestra que una tarea empresarial concreta supere ese umbral. Enfoque oficial.
¿Claude Haiku es más rápido que Sonnet?
Anthropic asigna a Haiku 5.5 la etiqueta Fastest y a Sonnet 5.5, Fast en su fila de latencia comparativa. Son etiquetas del proveedor. Este trabajo no midió el rendimiento de procesamiento, el tiempo de respuesta ni la velocidad de completar un trabajo. Descripción general de los modelos.
¿El descuento de la Batch API se aplica tanto a Haiku como a Sonnet?
Sí. Anthropic indica un descuento del 50% en los tokens de entrada y salida que reúnen los requisitos para ambos modelos. Batch es asíncrono, así que úsalo para trabajos que pueden esperar. Haiku sigue teniendo tramos separados para prompts cortos y largos. Precios de Batch.
Qué tarea cambiar esta semana
Migra un trabajo acotado después de que supere una comparación con criterios de evaluación. Quien dirige una empresa puede empezar por las etiquetas de tickets; un CTO, por un resumen de documentos con requisitos definidos; quien desarrolla, por un agente auxiliar que busque archivos mientras Sonnet sigue como coordinador.
Define los criterios de aceptación
Especifica la respuesta necesaria, las pruebas que la respaldan y los fallos que activan una revisión. Incluye ejemplos difíciles, además de los casos rutinarios que salen bien.
Calcula el costo del trabajo completo
Registra la entrada real de cada modelo, la salida facturada, las escrituras y lecturas de caché y los reintentos. Comprueba el umbral de Haiku por prompt e incluye la revisión del coordinador en un trabajo delegado.
Elige el flujo y conserva una forma de revertirlo
Adopta Haiku donde los resultados válidos y el costo de corregir conserven su ahorro. Mantén Sonnet o escala a él donde el modelo más grande justifique el sobrecosto. Revisa el presupuesto cuando cambien el prompt, el esfuerzo o la carga de trabajo.
Recibe la lista de verificación para configurar Claude Code y Codex y planifica la configuración de los agentes según los roles que elijas.
- Publicado
- Categoría
- AI
- Idioma
Claude Haiku 5.5: precios, ahorro y claves para migrar
Consulta los precios de Claude Haiku 5.5, calcula el costo de un millón de llamadas y descubre cuándo conviene migrar o mantener Sonnet en tu aplicación.8 oct 2026AI
Alternativas a Otter AI: cuál elegir según tu trabajo
Compara las alternativas a Otter AI por sus precios, límites gratuitos, transcripción sin bots e integración con CRM. Elige según lo que necesitas.8 oct 2026AI
Mistral Large 4: cuánto cuesta y cuándo conviene usarlo
Precios de Mistral Large 4, oferta de lanzamiento y pesos abiertos: qué dicen sus benchmarks y cuándo conviene probar la API o esperar al despliegue propio.7 oct 2026AI
Lindy AI como asistente de IA: análisis, precios y límites
Analizamos Lindy AI como asistente de IA: precios, créditos, correo, reuniones y límites de aprobación para decidir si encaja con el trabajo de tu empresa.7 oct 2026AI
Precios de Mistral (2026): cuánto cuestan la API y Vibe
Consulta los precios de Mistral: tarifas de API, planes de Vibe y Le Chat, límites gratuitos, alojamiento en la UE y un ejemplo de factura mensual.6 oct 2026AI
Skills de Claude: crea tu informe semanal de clientes
Crea skills de Claude para preparar informes semanales de clientes con datos validados. Guía paso a paso para instalarlas y compartirlas en tu equipo.6 oct 2026AI
Agentes de IA como empleados: qué delegar y cuánto cuestan
Qué tareas delegar a los agentes de IA, precios de seis herramientas y cómo evaluar una prueba de 30 días con revisión humana antes de ampliar sus permisos.6 oct 2026AI