Claude Haiku vs Sonnet: costi, differenze e quando usarli
Claude Haiku vs Sonnet: confronta prezzi API, classificazione dei ticket, riassunti lunghi e agenti per il codice con tre budget mensili e costi di cache.
Pubblicato il
 Di Omid Saffari

Claude Haiku vs Sonnet: la scelta dipende dal lavoro da svolgere. Claude Haiku 5.5, il modello di piccole dimensioni di Anthropic, è indicato per classificazioni ed estrazioni con un perimetro preciso; Claude Sonnet 5.5, il modello più grande e generalista, per coordinare il lavoro sul codice e prendere decisioni che richiedono una valutazione più ampia. Nello scenario di classificazione dei ticket descritto qui, la spesa mensile per i token è di $16 con Haiku o $320 con Sonnet. Oltre 100,000 token nel prompt, il vantaggio di prezzo di Haiku passa da un fattore 20 a un fattore quattro.
Prezzi e specifiche verificati l'8 ottobre 2026 sulla documentazione dei prezzi di Anthropic, sulla panoramica dei modelli e su claude.com/pricing. I budget derivano da scenari di calcolo con ipotesi esplicite sui token, non da test delle prestazioni. Tutti i prezzi sono in USD.
Claude Haiku vs Sonnet: quale conviene scegliere?
Haiku per risposte circoscritte e verificabili; Sonnet per il ruolo di coordinamento, che deve interpretare, organizzare il lavoro e gestire gli imprevisti. Contano i risultati che superano i controlli, la lunghezza dei prompt, il contesto riutilizzabile e il costo di correggere un errore.
- Un founder che smista i ticket di assistenza: partire da Haiku. Generare un'etichetta da un insieme fisso di code costa poco, e la scelta si può valutare facilmente su esempi già etichettati. I casi irrisolti passano al modello superiore, senza pagare la sua tariffa per ogni ticket.
- Un CTO di un'azienda di medie dimensioni che riassume documenti lunghi: Haiku vince sul budget dei token per estrazioni fedeli e riassunti con vincoli precisi, purché conservi i fatti necessari agli utenti. Sonnet è il candidato successivo quando occorre conciliare passaggi in conflitto o spiegarne le conseguenze. Entrambi i modelli accettano input lunghi: la sola capacità non basta più a decidere.
- Uno sviluppatore indipendente o un responsabile tecnico che usa un agente di programmazione: Sonnet mantiene la responsabilità della modifica complessiva. A Haiku si affidano compiti piccoli, come trovare i file pertinenti, estrarre messaggi di errore o riassumere un diff circoscritto. Il risparmio arriva dagli agenti esecutori; il coordinatore continua a verificare le evidenze che raccolgono.
Per chi ha esperienza nella gestione operativa, la domanda decisiva è se il percorso meno costoso aumenti il lavoro di correzione. Risparmiare una frazione di centesimo per ticket serve quando i volumi sono elevati. Un ulteriore passaggio a una persona può assorbire subito quel risparmio.
Il confronto API qui sotto riguarda Claude Haiku 5.5 e Claude Sonnet 5.5. MTok indica un milione di token, le porzioni di testo elaborate dal modello. L'input è il materiale inviato; l'output è quello generato.
Fonti: tariffe attuali e specifiche dei modelli. Le scritture in cache sono ulteriori categorie di input fatturato, illustrate più avanti.
Haiku vs Sonnet: prezzi e voci che compongono la spesa
Haiku costa meno per i token non in cache in entrambe le fasce di lunghezza del prompt. Sonnet deve giustificare la spesa maggiore con un risultato che supera i controlli, meno correzioni o un flusso di lavoro complessivamente migliore.
Su 1,000 token non in cache, Haiku costa $0.00010 per l'input e $0.00050 per l'output nella fascia breve, oppure $0.00050 per l'input e $0.00250 per l'output nella fascia lunga. Sonnet costa $0.002 per l'input e $0.010 per l'output. Si tratta delle tariffe pubblicate per MTok divise per 1,000, non del prezzo di un'attività completata.
La distinzione conta perché l'output può essere la voce principale della spesa. Un classificatore che restituisce un'etichetta e un agente che scrive una spiegazione lunga consumano token in proporzioni diverse. Allo stesso modo, la cronologia di una sessione di programmazione e i risultati degli strumenti possono rendere le richieste successive più lunghe dell'istruzione iniziale.
Il grafico mostra i costi delle tre attività sviluppate nei prossimi esempi. Ogni coppia mantiene invariati i conteggi di token ipotizzati. Nell'esempio di programmazione, Sonnet coordina il lavoro in entrambi i flussi: la barra più bassa rappresenta quindi una soluzione ibrida, non un agente basato interamente su Haiku.
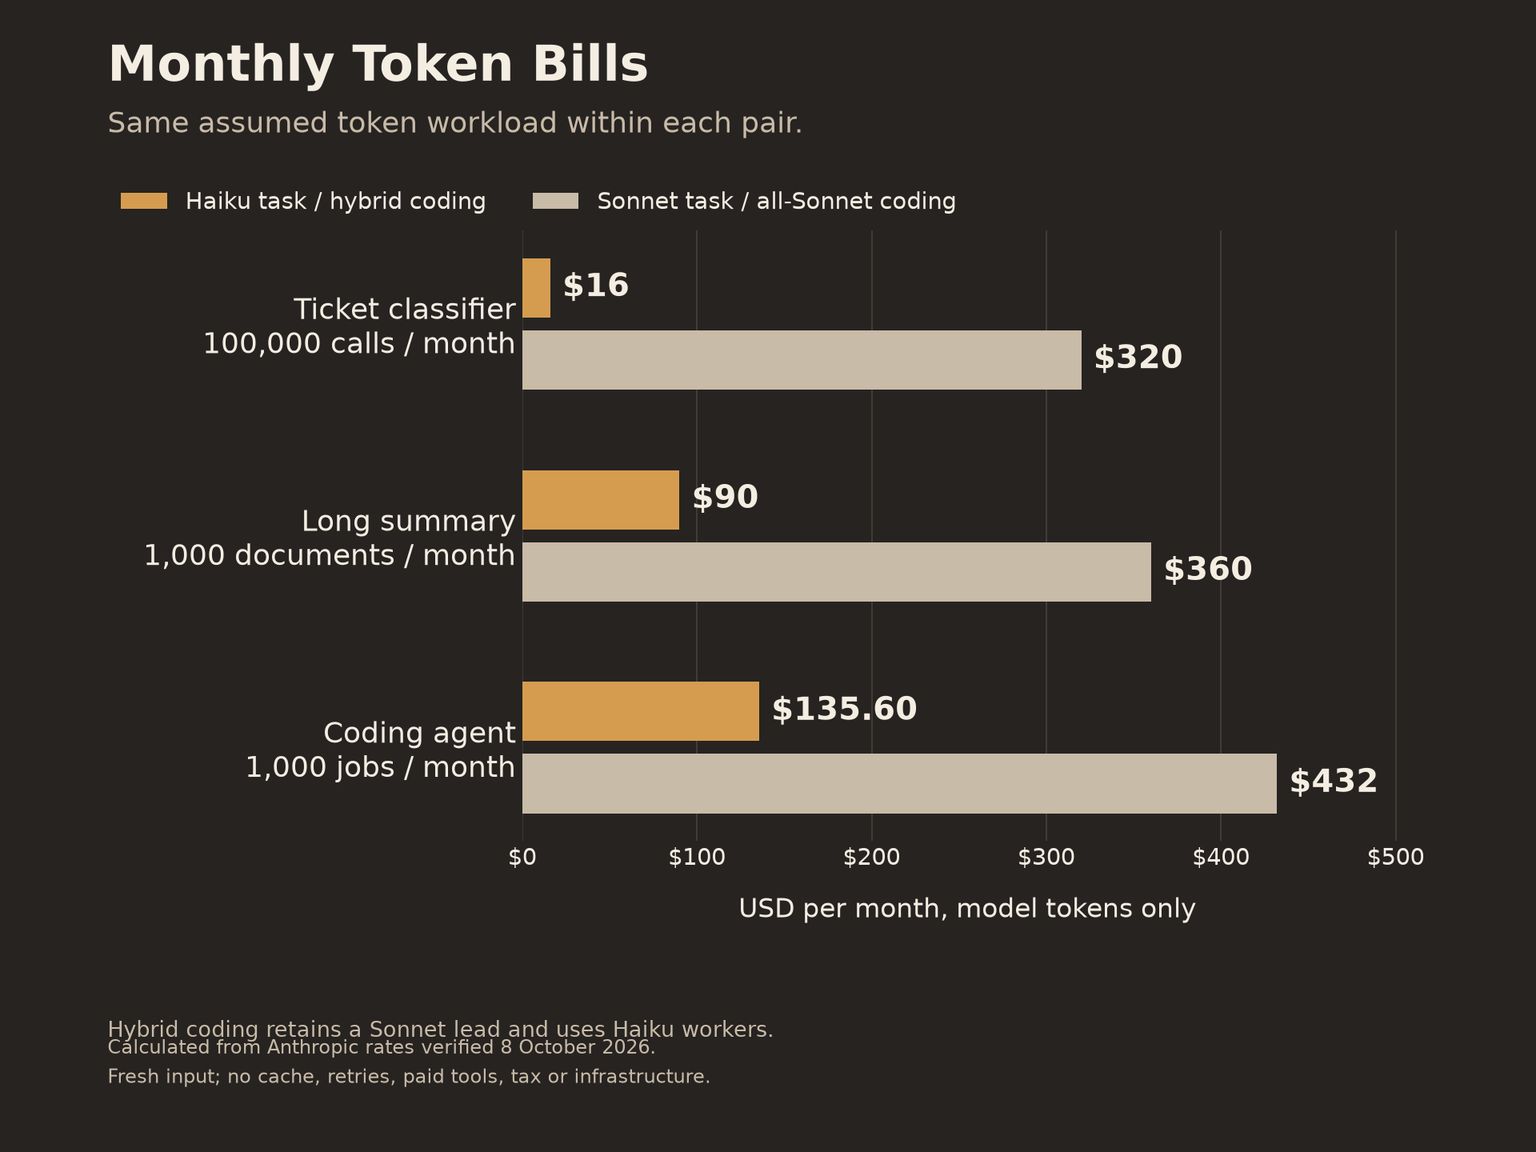
Tutti e tre gli scenari di base assumono le tariffe standard delle API dirette di Anthropic, input non in cache e nessun nuovo tentativo o strumento lato server fatturato separatamente. Sono escluse imposte e infrastruttura applicativa. I conteggi di output indicano l'output fatturato totale ipotizzato nel budget, non un conteggio dedotto dalla breve risposta visibile all'utente. Prima di fissare un budget di produzione, sostituire queste ipotesi con i consumi effettivi di ciascun modello.
Per il resto della gamma e le altre voci di fatturazione, consultare la guida ai prezzi delle API Claude.
Contesto e ragionamento: stessi limiti, impostazioni diverse
La capacità è identica; Haiku ha l'etichetta di velocità relativa migliore di Anthropic; cambia l'impostazione predefinita del ragionamento. Le specifiche di nessuno dei due modelli dimostrano che saprà conservare il dettaglio giusto nei documenti o completare la modifica al repository.
Per quali attività scegliere Claude Haiku 5.5?
Claude Haiku 5.5 è il candidato di piccole dimensioni per attività frequenti e definite con precisione. Anthropic ne descrive l'impiego così: "For high-volume, latency-sensitive tasks such as classification, extraction, and routing." Per i prompt brevi le tariffe sono $0.10 per l'input / $0.50 per l'output per MTok; per quelli più lunghi salgono a $0.50 / $2.50. Posizionamento ufficiale, tariffe.
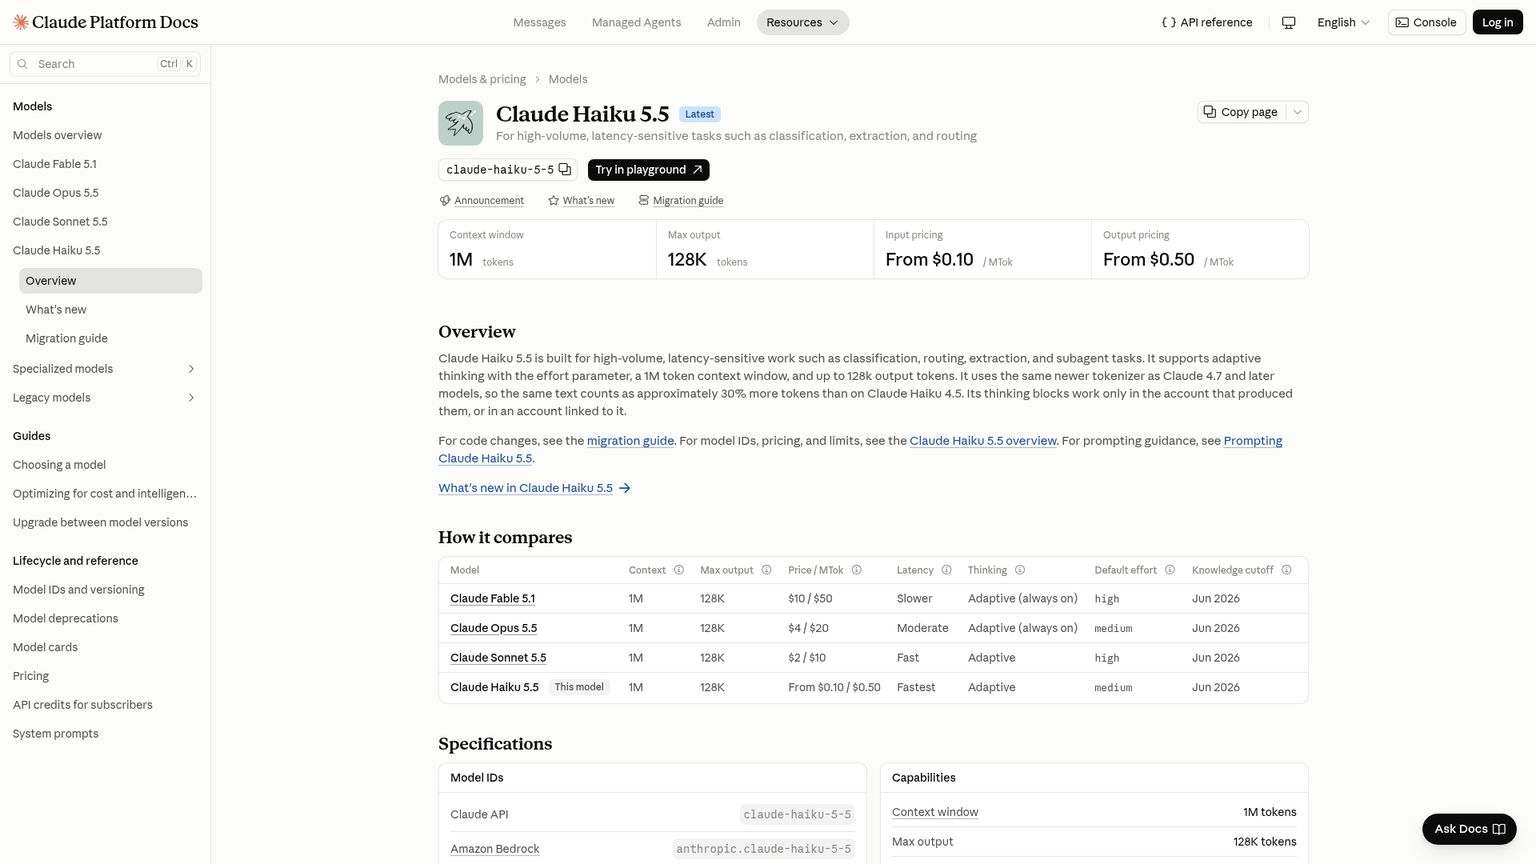
È adatto a un classificatore di assistenza con destinazioni prestabilite, a un estrattore che restituisce campi specifici con i passaggi che li supportano, o a un agente esecutore che raccoglie evidenze per un altro modello. Il limite pratico è il controllo di accettazione: una risposta che sembra valida ma finisce nella coda sbagliata resta sbagliata. Haiku va escluso quando la valutazione dell'attività mostra già che le correzioni richieste dai suoi errori costano più del risparmio sul prezzo.
La guida a Claude Haiku 5.5 aiuta a decidere se adottare quel modello. Qui il suo costo viene confrontato con Sonnet sulle stesse attività.
Per quali attività scegliere Claude Sonnet 5.5?
Claude Sonnet 5.5 è il candidato generalista per attività che combinano velocità e capacità di valutazione più ampie. Anthropic lo descrive come "The best combination of speed and intelligence." Costa $2 per l'input / $10 per l'output per MTok, con $0.10 per le letture dalla cache di input riutilizzato idoneo. Posizionamento ufficiale, tariffe.
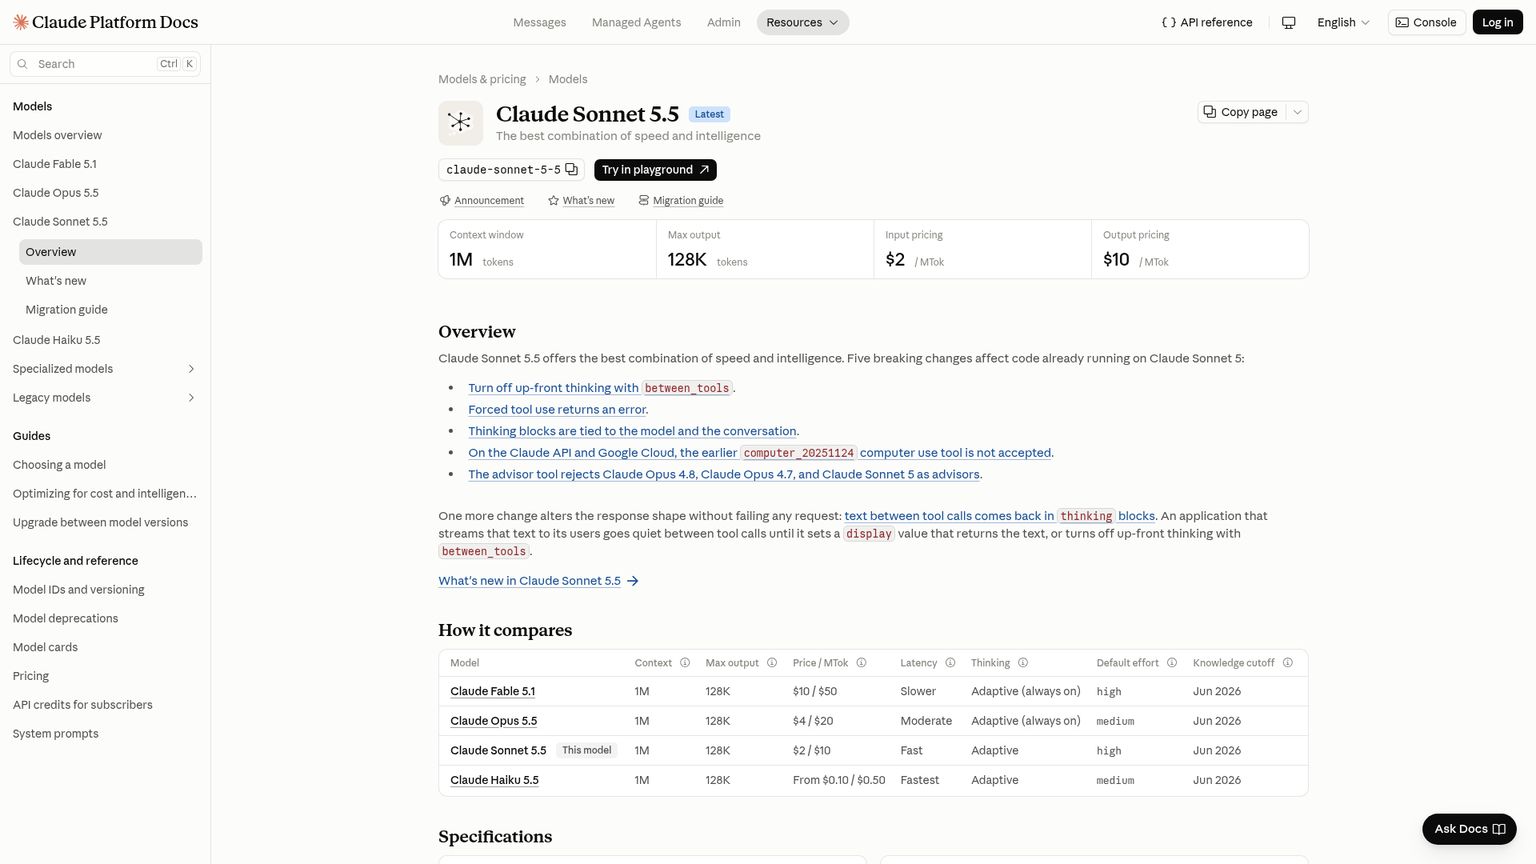
Coordinare il lavoro sul codice significa decidere cosa modificare, integrare le evidenze e gestire i passaggi falliti. In questo confronto tra due modelli, è un ruolo per cui ha senso valutare Sonnet per primo. Il suo svantaggio evidente è la spesa: usarlo per ogni etichetta facilmente verificabile significa pagare la tariffa più alta anche quando le capacità aggiuntive non servono. Va mantenuto dove i risultati accettabili giustificano il sovrapprezzo.
Cosa permettono davvero i limiti comuni?
Entrambi i modelli offrono 1M di contesto, 128K di output massimo e ragionamento adattivo. Il contesto è lo spazio di lavoro disponibile per una richiesta; l'output massimo pone un limite alla generazione. Il ragionamento adattivo consente al modello di regolare il proprio ragionamento. L'effort API predefinito di Haiku è medium, quello di Sonnet è high. Entrambi supportano input di immagini e uso di strumenti. Panoramica dei modelli.
Per un CTO che valuta un'ampia raccolta di policy, il limite di contesto comune elimina una differenza di capacità. Restano da controllare omissioni, contraddizioni e riscontri nelle fonti. Inoltre, l'effort predefinito più alto introduce una differenza non controllata nel budget se si confrontano solo i nomi dei modelli, senza registrare impostazioni e consumi fatturati.
Queste sono specifiche del fornitore e criteri editoriali di scelta. Qui non si attribuisce a nessun modello una vittoria misurata nei benchmark. Un punteggio in classifica non dimostrerebbe il tasso di errore sulle categorie dei propri ticket né la qualità della modifica finale al codice.
Attività 1: classificare i ticket di assistenza
Per etichette di coda verificate vince Haiku: $16 contro $320 al mese in questo scenario. Il modello deve scegliere entro un insieme circoscritto; la risposta va validata e le azioni con conseguenze devono restare soggette alle regole dell'applicazione.
Ipotizziamo che un'azienda SaaS gestisca 100,000 ticket al mese. Ogni classificazione usa 1,200 token di input non in cache e 80 token di output fatturato, comprese istruzioni e testo del ticket. Ogni prompt resta sotto 100,000 token. Per entrambi i modelli si ipotizzano, separatamente, gli stessi conteggi fatturati.
Il totale mensile è quindi di 120 milioni di token di input e 8 milioni di token di output:
- Haiku: 120 × $0.10 + 8 × $0.50 = $12 + $4 = $16.
- Sonnet: 120 × $2 + 8 × $10 = $240 + $80 = $320.
Il costo di 1,000 classificazioni è di $0.16 con Haiku o $3.20 con Sonnet, calcolato con le tariffe attuali. Il risparmio mensile sui token è di $304.
Un buon contratto di classificazione elenca le destinazioni consentite e ne include una per i casi irrisolti. Prima si verifica che la risposta usi un'etichetta ammessa, poi si valuta se abbia scelto quella corretta su esempi con risposta nota. Il primo controllo intercetta un formato non valido; il secondo una decisione plausibile ma sbagliata. Per nessuno dei due serve considerare come prova la sicurezza che il modello dichiara di avere.
Supponiamo che il 10% dei ticket richieda una chiamata aggiuntiva a Sonnet, con gli stessi conteggi di token ipotizzati. Anche il primo tentativo di Haiku si paga: $16 + $32 = $48 al mese, con un risparmio di $272 rispetto all'uso di Sonnet per ogni ticket. Il tasso di escalation è un'ipotesi, non un risultato osservato in questa analisi.
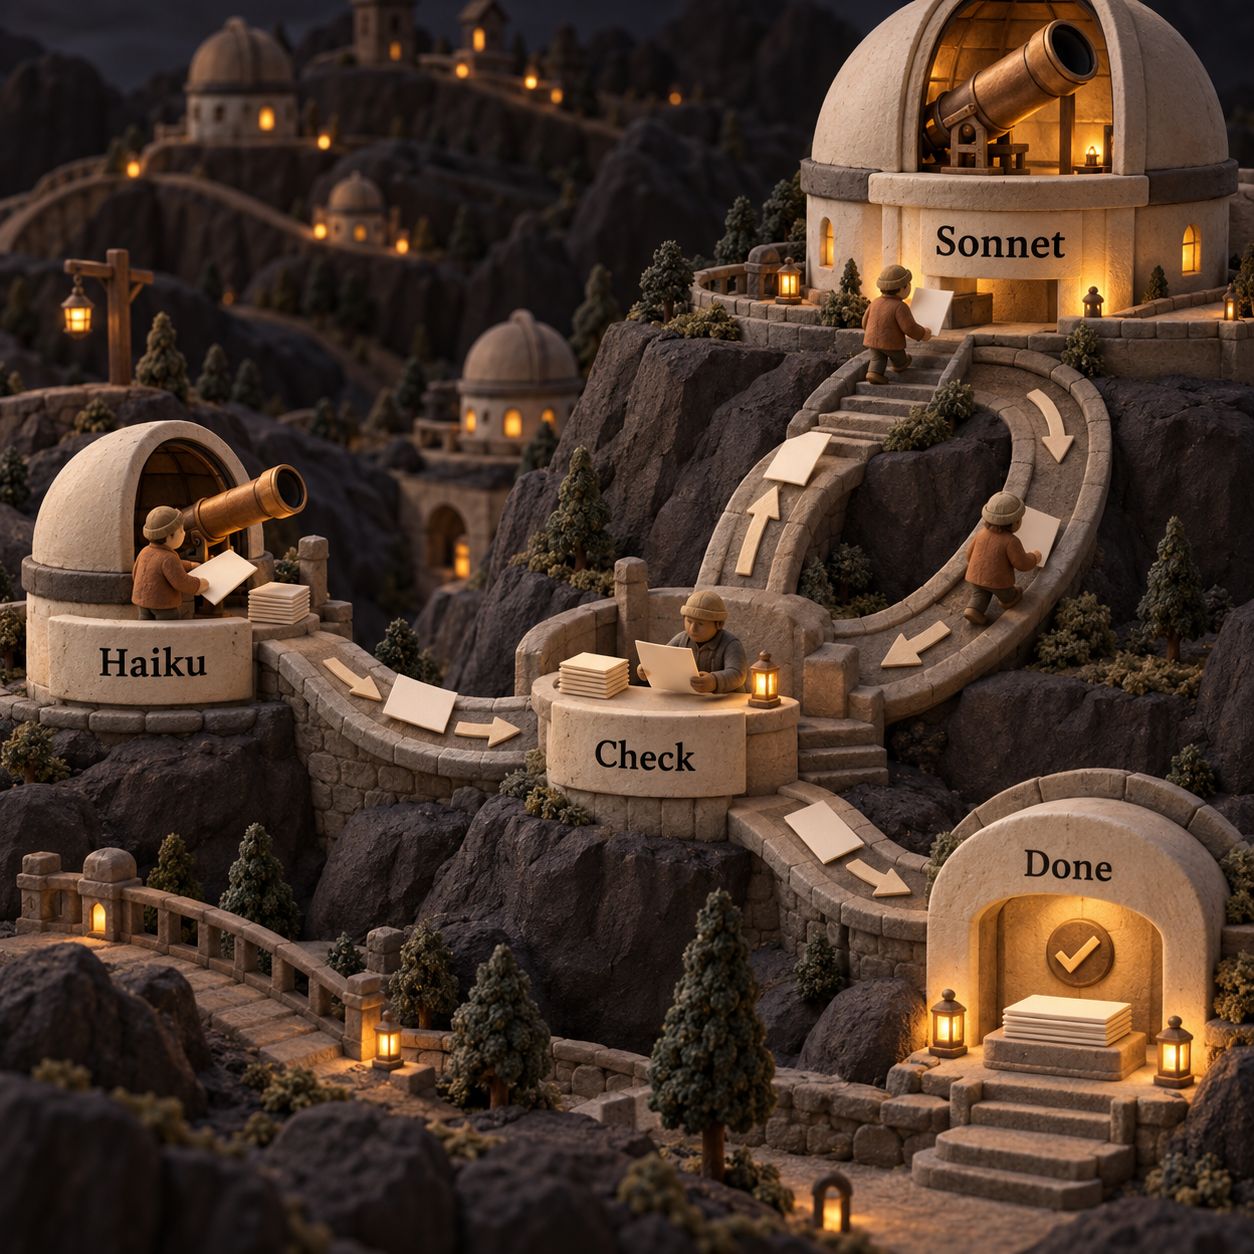
Esiste anche una soglia di escalation calcolata sui soli token. Se ogni caso parte da Haiku e una frazione e riceve poi una chiamata a Sonnet con lo stesso numero di token, il costo è H + e × S. Eguaglia il costo del solo Sonnet quando e = 1 - H/S: 95% di escalation per queste chiamate nella fascia breve, oppure 75% per chiamate equivalenti nella fascia lunga di Haiku. Prompt di escalation più lunghi, nuovi tentativi e revisione umana possono annullare prima il vantaggio del percorso meno costoso.
Attività 2: riassumere documenti lunghi, oltre 100K token
Per un riassunto fedele che supera i controlli, Haiku vince sul costo dei token: qui il divario è di quattro volte. Sonnet merita una valutazione quando il risultato richiesto deve interpretare conflitti o esprimere un giudizio più ampio, anziché riportare i fatti supportati dal documento.
Ipotizziamo 1,000 documenti al mese, con ogni richiesta che consuma 150,000 token di input non in cache e 6,000 token di output fatturato. L'input comprende documento e istruzioni. Ogni richiesta supera la soglia del prompt di Haiku: sia l'input sia l'output vengono quindi calcolati con la tariffa superiore.
Per documento:
- Haiku: 0.15 × $0.50 + 0.006 × $2.50 = $0.075 + $0.015 = $0.09.
- Sonnet: 0.15 × $2 + 0.006 × $10 = $0.30 + $0.06 = $0.36.
I totali mensili sono $90 e $360, con un risparmio di $270, secondo le regole tariffarie per il contesto lungo. In questa attività non vale l'affermazione secondo cui Haiku costa un ventesimo di Sonnet.
La soglia riguarda ogni singolo prompt, non una quota mensile dell'account. Un prompt di esattamente 100,000 token rientra nelle tariffe inferiori di Haiku; un prompt più lungo usa quelle superiori per l'intera richiesta. La tariffa maggiore dell'input non va applicata solo ai token eccedenti, né si deve lasciare l'output alla tariffa della fascia breve.
Per preparare una sintesi interna di progetto, occorre definire i fatti che il riassunto deve conservare: decisioni, responsabili, scadenze, eccezioni e passaggi a supporto. Questi campi vanno verificati sul documento. Un CTO che confronta requisiti incoerenti in documenti diversi deve includere anche i casi di conflitto nella valutazione, prima di scegliere il modello meno costoso.
Accorciare l'input può mantenere la fascia inferiore, purché vi rientrino ancora tutte le evidenze necessarie. Dividere un documento senza criterio può far perdere il legame che il riassunto dovrebbe spiegare. L'unità utile resta il riassunto che supera i controlli, includendo nel costo ogni passaggio di correzione o sintesi.
Quando Sonnet con la cache costa meno di Haiku senza cache?
Sonnet può costare meno di Haiku senza cache quando prevale il contesto riutilizzato, ma Haiku rimane più economico a parità di utilizzo della cache. Una lettura dalla cache riusa input già elaborato. Non riduce il prezzo della nuova risposta generata, e memorizzare il materiale riutilizzabile comporta un costo di scrittura.
Le letture dalla cache di Sonnet costano $0.10 per MTok, quanto l'input non in cache di Haiku nella fascia breve. Per Haiku costano $0.01 nella fascia breve e $0.05 in quella lunga. Le tariffe di scrittura con durata di cinque minuti sono $2.50 per Sonnet, oppure $0.125 / $0.625 per Haiku nelle fasce breve/lunga. Prezzi della cache.
Il confronto deve riguardare la stessa categoria di fatturazione. Leggere l'input in cache di Sonnet a $0.10 e l'input lungo non in cache di Haiku a $0.50 può favorire Sonnet sull'input, mentre il suo output continua a costare di più. Se entrambi leggono dalla cache, Haiku torna ad avere la tariffa inferiore per l'input.
Ecco un punto di sorpasso che include la scrittura, usando le proporzioni di token del riassunto lungo. Ipotizziamo 149,000 token di prefisso riutilizzabile, 1,000 nuovi token di input e 6,000 token di output fatturato per richiesta. Il prefisso è la parte iniziale del prompt che resta invariata, per esempio un documento con istruzioni comuni, riutilizzata in richieste diverse.
Ipotizziamo una scrittura in cache con durata di cinque minuti, seguita da 27 letture riuscite nello stesso periodo di validità della cache:
- Prima richiesta di Sonnet: 0.149 × $2.50 + 0.001 × $2 + 0.006 × $10 = $0.4345.
- Ogni lettura successiva: 0.149 × $0.10 + 0.001 × $2 + 0.006 × $10 = $0.0769.
- Su 28 richieste, la media è circa $0.08967, appena sotto i $0.09 per richiesta di Haiku senza cache.
È un sorpasso aritmetico subordinato a condizioni precise. Presuppone che il materiale condiviso sia idoneo alla cache e venga davvero riutilizzato, senza ulteriori scritture. Non è adatto a un budget in cui ogni documento è nuovo, le richieste arrivano troppo distanziate o le istruzioni comuni cambiano continuamente.
Con lo stesso schema di utilizzo della cache, la prima richiesta di Haiku nella fascia lunga costa $0.108625, e le letture successive $0.02295. Un confronto equo continua a favorire Haiku sui token. La cache può rendere Sonnet accessibile dove le sue capacità di valutazione giustificano un sovrapprezzo; non rende il modello più grande la scelta sempre meno costosa.
Per un assistente che lavora regolarmente sui documenti, misurare separatamente scritture e letture dalla cache. Una previsione che considera tutto l'input come letture dalla cache ignora il costo iniziale e le parti del prompt che cambiano. L'output generato deve restare nel calcolo anche quando il documento è già in cache.
Claude Haiku vs Sonnet per programmare: Sonnet coordina
Sonnet vince per il ruolo di coordinamento sul codice; Haiku per i compiti esecutivi circoscritti e verificati. Un subagente è un modello a cui viene assegnato un compito più piccolo all'interno dell'attività complessiva. Si delega una parte le cui evidenze possano essere controllate dal coordinatore, senza affidare all'esecutore la responsabilità di una modifica al repository priva di un perimetro preciso.
Ipotizziamo 1,000 attività di programmazione al mese. Ognuna comprende:
- Un coordinatore Sonnet con un consumo totale di 30,000 token di input non in cache e 6,000 token di output fatturato.
- Otto esecutori, ciascuno con un totale di 12,000 token di input non in cache e 1,500 token di output fatturato.
Sono ipotesi di consumo complessivo sulle richieste di ciascun ruolo. Ogni singolo prompt resta sotto 100,000 token. Nei totali devono rientrare descrizioni degli strumenti, cronologia, evidenze degli esecutori e revisione finale del coordinatore. Si assume che il coordinatore consumi la stessa quantità nei flussi interamente basati su Sonnet e in quelli ibridi; token aggiuntivi per il passaggio di consegne o nuovi tentativi cambierebbero il confronto.
Con le tariffe API attuali, il coordinatore costa $0.12 per attività. Un esecutore Haiku costa $0.00195: otto costano quindi $0.01560. Un esecutore Sonnet costa $0.039: otto costano $0.312.
Soluzione ibrida: $0.12 + $0.01560 = $0.13560 per attività, oppure $135.60 al mese.
Solo Sonnet: $0.12 + $0.312 = $0.432 per attività, oppure $432 al mese.
Il risparmio calcolato è di $296.40 al mese, pari al 68.6%. La spesa complessiva non si riduce di un fattore 20 perché il coordinatore Sonnet continua a essere pagato. Lo scenario non dimostra una qualità del codice equivalente né un aumento di velocità misurato.
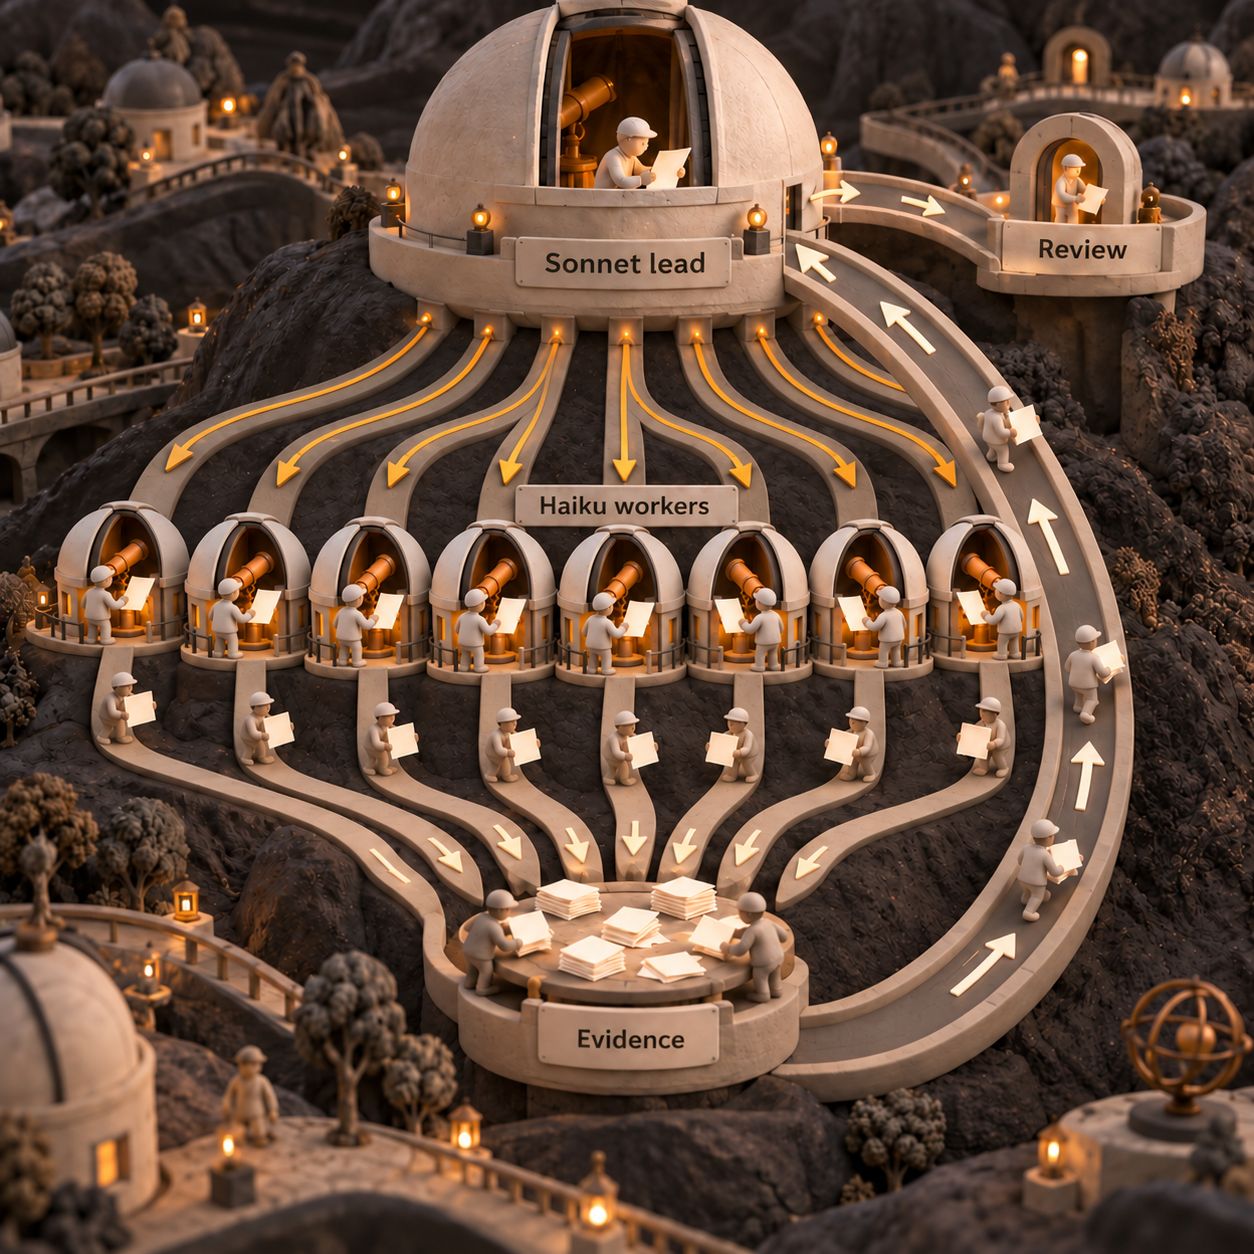
Un contratto adatto a un esecutore potrebbe chiedere di trovare i file che fanno riferimento a una funzione specifica, restituire i percorsi e gli estratti pertinenti e segnalare le incertezze. Un altro potrebbe chiedere di riassumere l'output di errore di un controllo fallito ben definito. Il coordinatore usa queste evidenze per decidere cosa modificare. È una raccomandazione sull'architettura applicativa, non un'affermazione secondo cui questa analisi abbia provato l'implementazione dei subagenti di Claude Code.
Il passaggio di consegne è il possibile punto debole. Un riassunto compatto può eliminare l'eccezione che serviva al coordinatore; un'affermazione non verificata può trasformare un esecutore economico in una modifica sbagliata e costosa. Conservare i riferimenti alle fonti e fornire al coordinatore abbastanza materiale originale per verificare la risposta dell'esecutore. Qualsiasi lavoro ripetuto va conteggiato nel budget ibrido.
La delega va evitata quando il compito apparentemente piccolo richiede quasi lo stesso contesto del repository necessario al coordinatore, oppure quando verificare il passaggio di consegne costa più che svolgere direttamente il compito. Per una modifica le cui parti sono strettamente legate, usare sempre Sonnet può produrre un risultato accettabile a un costo inferiore, nonostante la spesa maggiore per i token.
Passare da Sonnet a Haiku, o da Haiku a Sonnet
Si sposta prima il compito circoscritto, poi si confronta l'intero flusso completato. Restare nelle API Claude può preservare gran parte dell'integrazione, ma cambiare il nome del modello non dimostra che l'output si comporterà allo stesso modo.
Gli ID dei modelli sono claude-haiku-5-5 e claude-sonnet-5-5, riportati nella panoramica dei modelli. Conservare una copia riproducibile del prompt, delle regole di validazione, di input rappresentativi e delle risposte accettate. Registrare modello, effort, consumo di token, lunghezza del prompt, comportamento della cache e tentativi per attività completata.
Passare da Sonnet a Haiku ha senso per un classificatore o un esecutore con un contratto chiaro. Prima di aumentare il traffico, verificare formato, riscontri dei fatti e casi di errore costosi. Mantenere un modo semplice per riportare quel compito a Sonnet.
Passare da Haiku a Sonnet ha senso quando correzione o coordinamento costano già più del risparmio. Conservare gli stessi esempi per stabilire se il percorso con il modello più grande risolva gli errori che hanno motivato il cambio. Una risposta più curata non è di per sé una prova di correttezza.
Nel budget va incluso anche il lavoro tecnico. A titolo illustrativo, una migrazione di quattro ore a una tariffa ipotizzata di $100 all'ora costa $400. Con il risparmio mensile di $304 sui token del classificatore, servono circa 1.3 mesi per recuperare il costo, prima delle spese di valutazione e gestione degli incidenti. Con appena 100 classificazioni al mese, le stesse proporzioni di token fanno risparmiare $0.304 al mese. Il motivo economico per ricostruire un percorso già funzionante è quindi scarso.
Cambiare solo per le tariffe non conviene quando il volume di attività è basso, l'accettazione dipende da capacità di valutazione più ampie o il nuovo modello impone un'altra fase di revisione. Prompt, evidenze e controlli devono restare portabili, così la decisione rimane reversibile se in futuro cambiano prezzi o capacità.
Quali modelli sono inclusi nei piani Claude?
Haiku e Sonnet compaiono nei principali piani Claude; l'accesso in abbonamento è una questione distinta dalla fatturazione API per token. Claude Opus e Claude Fable sono altre famiglie di modelli nella gamma Anthropic. Qui servono a descrivere l'accesso nei piani, senza ampliare il confronto dei costi tra i due modelli. Il confronto dei piani su claude.com, verificato l'8 ottobre 2026, riporta:
- Free: Haiku e Sonnet; Opus e Fable risultano non disponibili.
- Pro: Haiku, Sonnet e Opus; per Fable è indicato crediti di utilizzo.
- Max 5x e Max 20x: Haiku, Sonnet e Opus; per Fable è indicato 50% dei limiti settimanali.
- Team: Haiku, Sonnet e Opus; per Fable è indicato 50% dei limiti settimanali per le licenze premium.
- Enterprise, con attivazione autonoma o tramite il team commerciale: Haiku, Sonnet, Opus e Fable risultano disponibili.
La tabella dei piani elenca famiglie di modelli. Non garantisce che ogni account offra la stessa versione specifica 5.5 o impostazioni di prodotto identiche. Alla voce contesto riporta fino a 1M, varia in base al modello. Questa indicazione va tenuta distinta dalle specifiche API illustrate sopra.
Chi sviluppa una funzionalità di produzione deve mettere a budget separatamente il consumo API a pagamento e gli eventuali crediti applicabili, rispetto all'accesso interattivo in abbonamento. Chi sceglie un modello nell'app deve invece valutare il compito e i limiti del piano. Un esempio basato sui token API non può promettere quante attività di programmazione siano incluse in un abbonamento.
Domande frequenti
Claude Sonnet vs Haiku: cambia qualcosa invertendo il confronto?
Invertire i nomi non cambia la scelta. Haiku va valutato per compiti circoscritti con risposte verificabili; Sonnet per il ruolo di coordinamento o i casi che richiedono una valutazione più ampia. Si confrontano i risultati accettabili e tutti i tentativi fatturati, non soltanto i nomi dei modelli.
Claude Haiku vs Sonnet vs Opus: quale ruolo assegnare a ciascuno?
Haiku è il candidato economico per volumi elevati di attività circoscritte; Sonnet è il candidato al coordinamento in questo confronto. Anthropic posiziona Claude Opus 5.5 per attività prolungate di programmazione con agenti e lavoro della conoscenza. Va valutato se il coordinatore continua a non raggiungere la soglia di accettazione; quel posizionamento non è un risultato misurato sulla qualità nella propria applicazione. Panoramica dei modelli.
Claude Sonnet, Opus o Haiku per programmare?
Il coordinatore va scelto separatamente dagli esecutori. Qui Sonnet è la raccomandazione per coordinare, Haiku il candidato per raccogliere evidenze entro un perimetro preciso e Opus un altro candidato al coordinamento per attività più difficili e prolungate. Si valuta la modifica finale accettata, includendo nella spesa revisione, nuovi tentativi e consumi del passaggio di consegne.
Haiku 4.5 vs Sonnet 5: a quali versioni si riferisce questa pagina?
È un confronto tra versioni precedenti. I budget e le specifiche di questa pagina riguardano Claude Haiku 5.5 e Claude Sonnet 5.5. Per decidere nel confronto attuale tra le versioni 5.5, non usare una vecchia tariffa o un vecchio limite di contesto di Haiku.
Claude Haiku vs Sonnet: quanto cambia il prezzo?
A parità di conteggi di input non in cache e output, Sonnet 5.5 costa 20 volte Haiku 5.5 con prompt fino a 100,000 token, oppure quattro volte con prompt più lunghi. Le letture dalla cache hanno tariffe diverse e le scritture a pagamento devono essere incluse. Prezzi attuali.
Claude Haiku è adeguato per le attività aziendali?
È un candidato iniziale sensato per classificazione, estrazione e smistamento, le attività indicate da Anthropic. Prima di adottarlo, servono controlli sui casi di errore più costosi. Il divario di prezzo non dimostra che una specifica attività aziendale raggiunga la soglia richiesta. Posizionamento ufficiale.
Claude Haiku è più veloce di Sonnet?
Nella voce di latenza comparativa, Anthropic assegna a Haiku 5.5 l'etichetta Fastest e a Sonnet 5.5 Fast. Sono etichette del fornitore. Questa analisi non ha misurato capacità di elaborazione, tempi di risposta o velocità di completamento delle attività. Panoramica dei modelli.
Lo sconto della Batch API vale sia per Haiku sia per Sonnet?
Sì. Anthropic indica uno sconto del 50% sui token di input e output idonei per entrambi i modelli. Batch è asincrono, quindi va usato per attività che possono attendere. Haiku mantiene fasce distinte per prompt brevi e lunghi. Prezzi Batch.
Da dove partire questa settimana?
Spostare un compito circoscritto dopo che ha superato un confronto con criteri di valutazione. Un founder può iniziare dalle etichette dei ticket; un CTO da un riassunto di documento con vincoli precisi; uno sviluppatore da un esecutore che trova file, mantenendo Sonnet come coordinatore.
Definire il contratto di accettazione
Specificare la risposta richiesta, le evidenze a supporto e gli errori che fanno scattare la revisione. Includere esempi difficili, non soltanto i casi ordinari che riescono bene.
Calcolare il costo dell'attività completa
Registrare per ciascun modello input effettivo, output fatturato, scritture in cache, letture e nuovi tentativi. Verificare la soglia di Haiku per ogni prompt e includere la revisione del coordinatore nelle attività delegate.
Scegliere il percorso e mantenere una via di ritorno
Adottare Haiku dove i criteri di accettazione e i costi di correzione ne preservano il risparmio. Mantenere Sonnet, o passargli i casi necessari, dove il percorso con il modello più grande giustifica il sovrapprezzo. Ricontrollare il budget quando cambiano prompt, effort o carico di lavoro.
Ricevi la checklist per configurare Claude Code e Codex e pianifica la configurazione degli agenti in base ai ruoli scelti.
- Pubblicato
- Categoria
- AI
- Lingua
Claude Haiku: quanto costa 5.5 e dove conviene usarlo
Claude Haiku 5.5: prezzi API, soglia dei 100K token e costi mensili a confronto con Haiku 4.5 e Sonnet 5.5. Scopri quali attività conviene spostare.8 ott 2026AI
Alternative a Otter AI: quale scegliere per riunioni e CRM
Confronta Granola, Krisp, MeetGeek, Circleback e Claap: prezzi, limiti gratuiti, appunti senza bot e integrazioni CRM per scegliere in base al lavoro.8 ott 2026AI
Mistral Large 4: quando conviene e quanto costa davvero
Quanto costa Mistral Large 4? Prezzi API, sconto di lancio, benchmark e limiti della preview: quando provarlo e quando aspettare i pesi per il self-hosting.7 ott 2026AI
Agenti AI: recensione di Lindy per email e riunioni
Recensione di Lindy AI per email e riunioni: prezzi, crediti, integrazioni e limiti delle approvazioni, con alternative per scegliere il servizio adatto.7 ott 2026AI
Mistral pricing: quanto costano API e Vibe nel 2026
Scopri i prezzi delle API Mistral, i piani Vibe e i limiti gratuiti. Confronta i costi, calcola una spesa mensile e valuta le opzioni di hosting in UE.6 ott 2026AI
Claude Skills: crea una skill per il report settimanale
Scopri come usare Claude Skills nelle app, in Claude Code e via API. Crea una skill per i report clienti settimanali, con calcoli verificati e revisione.6 ott 2026AI
Agenti AI in azienda: ruoli, costi e come iniziare
Scopri cosa possono fare gli agenti AI, i costi di sei strumenti e come avviare un progetto pilota di 30 giorni con controllo umano e risultati misurabili.6 ott 2026AI