Claude Sonnet ou Haiku : quel modèle choisir et à quel prix ?
Claude Sonnet ou Haiku pour trier des tickets, résumer de longs documents ou coder ? Comparez les tarifs API, le cache et trois budgets mensuels en USD.
Publié le
 Par Omid Saffari

Claude Sonnet ou Haiku : le choix dépend du travail à accomplir. Réservez Claude Haiku 5.5, le petit modèle d’Anthropic, aux tâches de classification et d’extraction bien délimitées ; confiez à Claude Sonnet 5.5, son modèle généraliste de plus grande taille, le pilotage du code et les décisions qui exigent une appréciation plus large. Pour le scénario de tri des tickets présenté ici, la facture mensuelle de tokens atteint $16 avec Haiku ou $320 avec Sonnet. Au-delà de 100,000 tokens dans le prompt, l’avantage tarifaire de Haiku passe d’un facteur 20 à un facteur quatre.
Tarifs et caractéristiques vérifiés le 8 octobre 2026 à partir de la documentation tarifaire d’Anthropic, de la présentation des modèles et de claude.com/pricing. Les budgets sont des scénarios calculés selon les hypothèses de tokens indiquées, pas des tests de performance. Les prix sont en USD.
Claude Sonnet ou Haiku : lequel choisir ?
Choisissez Haiku pour une réponse ciblée que vous pouvez vérifier ; Sonnet pour l’agent principal qui doit interpréter, coordonner et gérer les échecs. Le choix dépend des résultats effectivement validés, de la longueur du prompt, du contexte réutilisable et du coût d’une erreur à corriger.
- Vous dirigez une startup et devez orienter les tickets de support : commencez par Haiku. Produire une étiquette parmi une liste de files prédéfinies coûte peu, et sa pertinence se mesure facilement sur des exemples déjà annotés. Transmettez les cas non résolus à Sonnet plutôt que de payer le grand modèle pour chaque ticket.
- Vous êtes directeur technique d’une entreprise de taille intermédiaire et résumez de longs documents : Haiku l’emporte sur le budget de tokens pour l’extraction fidèle et les résumés à consignes précises, à condition de conserver les faits dont vos utilisateurs ont besoin. Évaluez ensuite Sonnet si le travail impose de rapprocher des passages contradictoires ou d’en expliquer les conséquences. Les deux modèles acceptent de longues entrées ; la capacité ne suffit donc plus à les départager.
- Vous développez seul ou pilotez une équipe avec un agent de programmation : gardez Sonnet à la tête de la modification d’ensemble. Confiez à Haiku de petites tâches : repérer les fichiers pertinents, extraire les messages d’échec ou résumer un diff bien délimité. L’économie vient des sous-agents, dont l’agent principal continue de vérifier les éléments fournis.
Pour un responsable expérimenté, la question finale est de savoir si le parcours moins cher augmente le travail de correction. Économiser une fraction de centime de dollar par ticket devient intéressant à grande échelle. Ajouter une intervention humaine peut absorber cette économie immédiatement.
La comparaison API ci-dessous porte sur Claude Haiku 5.5 et Claude Sonnet 5.5. MTok désigne un million de tokens, les fragments de texte traités par un modèle. L’entrée correspond au contenu envoyé ; la sortie, au contenu généré.
Sources : grille tarifaire en vigueur et caractéristiques des modèles. Les écritures dans le cache constituent des catégories d’entrée facturées séparément, détaillées plus bas.
Haiku ou Sonnet : quels tarifs composent la facture ?
Haiku est moins cher pour les tokens non mis en cache, aux deux paliers de longueur du prompt. Sonnet doit justifier son surcoût par un résultat validé, moins de corrections ou un workflow globalement meilleur.
Pour 1,000 tokens non mis en cache, Haiku coûte $0.00010 en entrée et $0.00050 en sortie au palier court, ou $0.00050 en entrée et $0.00250 en sortie au palier long. Sonnet coûte $0.002 en entrée et $0.010 en sortie. Ces montants correspondent aux tarifs publiés par MTok divisés par 1,000, pas au prix d’une tâche terminée.
La distinction compte, car la sortie peut représenter l’essentiel de la facture. Un classificateur qui renvoie une étiquette et un agent qui rédige une longue explication n’ont pas la même répartition de tokens. De même, l’historique d’une session de programmation et les résultats des outils peuvent rendre les requêtes suivantes plus volumineuses que l’instruction initiale.
Le graphique chiffre les trois tâches détaillées plus bas. Dans chaque paire, les nombres de tokens supposés restent identiques. Pour le code, les deux workflows conservent un agent principal Sonnet : la barre la moins élevée représente donc une architecture hybride, pas un agent entièrement sous Haiku.
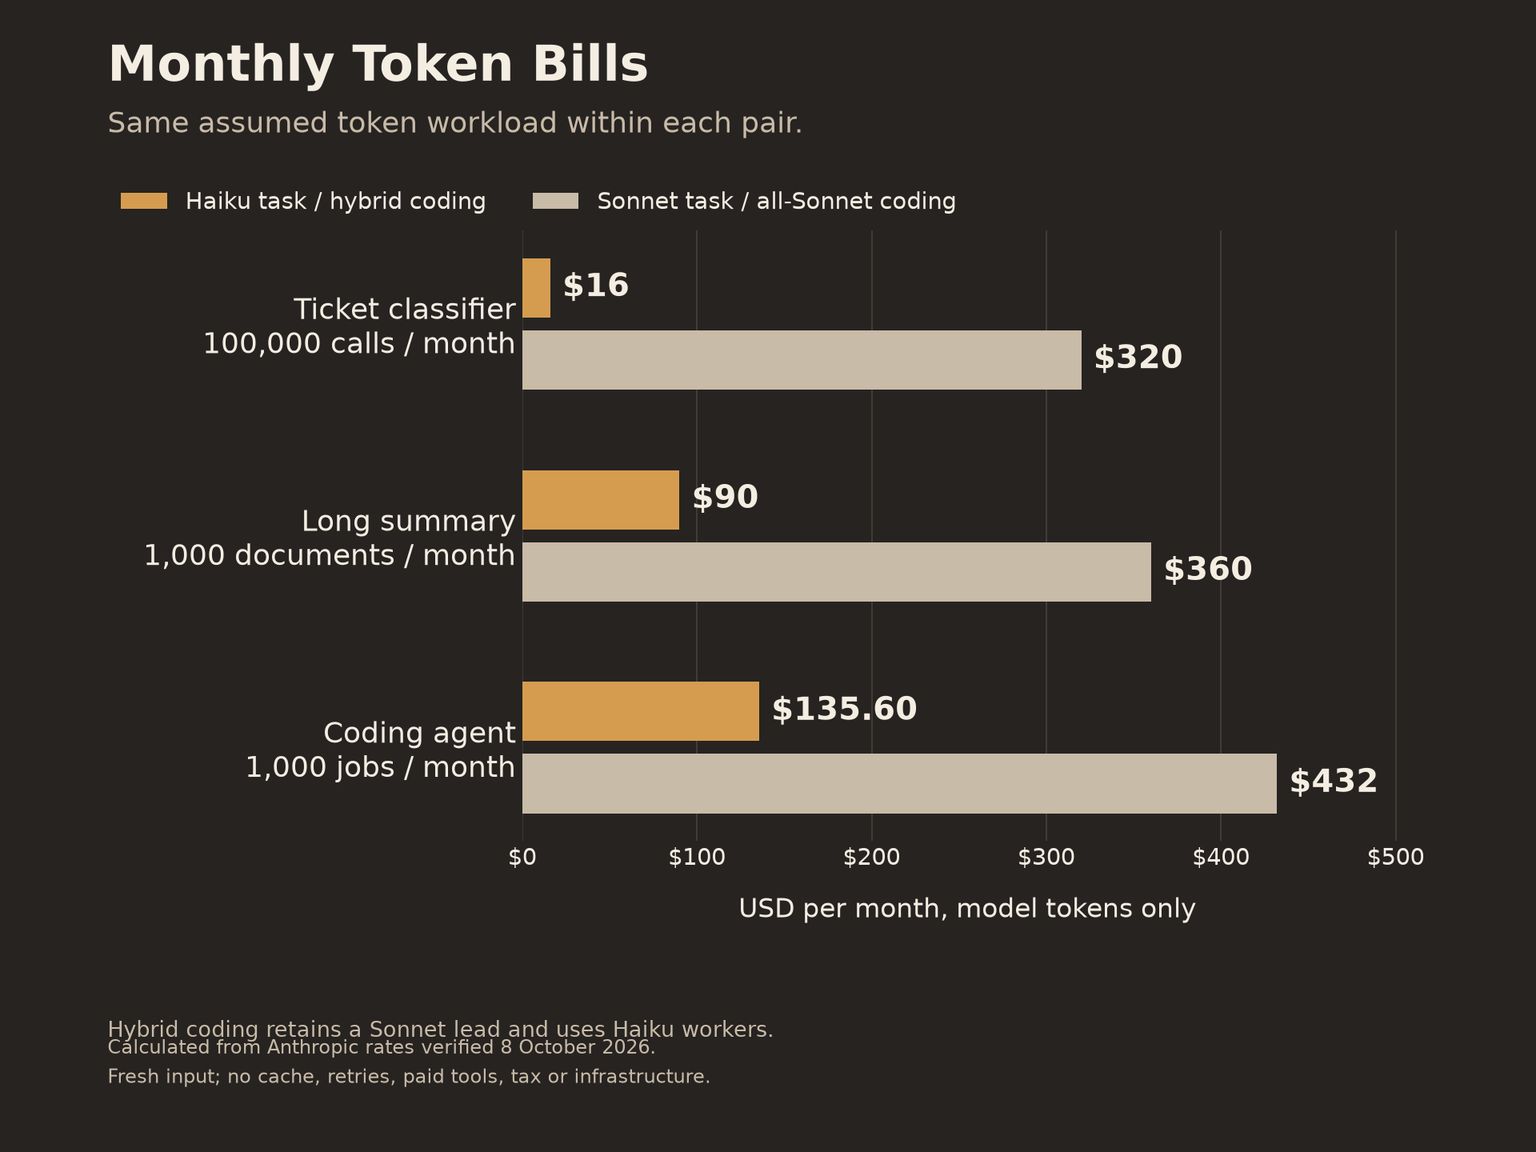
Les trois scénarios de référence supposent les tarifs standard de l’API directe d’Anthropic, des entrées non mises en cache, aucune nouvelle tentative et aucun outil exécuté côté serveur facturé séparément. Ils excluent les taxes et l’infrastructure applicative. Les nombres de tokens de sortie correspondent au total de sortie facturée supposé dans le budget, pas à une estimation tirée de la courte réponse visible par l’utilisateur. Remplacez ces hypothèses par la consommation réelle de chaque modèle avant de fixer un budget de production.
Pour l’ensemble de la gamme et les autres postes de facturation, consultez le guide des tarifs de l’API Claude.
Contexte et raisonnement : mêmes limites, réglages différents
Les capacités sont identiques ; Haiku obtient la meilleure indication de vitesse d’Anthropic ; le niveau de raisonnement par défaut diffère. Les caractéristiques d’un modèle ne prouvent pas qu’il préservera les détails utiles de vos documents ou mènera à bien une modification dans votre dépôt.
À quelles tâches destiner Claude Haiku 5.5 ?
Claude Haiku 5.5 est le petit modèle à envisager pour les tâches fréquentes définies avec précision. Anthropic le destine aux tâches à fort volume sensibles à la latence, comme la classification, l’extraction et le routage : "For high-volume, latency-sensitive tasks such as classification, extraction, and routing." Ses tarifs pour les prompts courts sont de $0.10 en entrée / $0.50 en sortie par MTok, et passent à $0.50 / $2.50 pour les prompts plus longs. Positionnement officiel, tarifs.
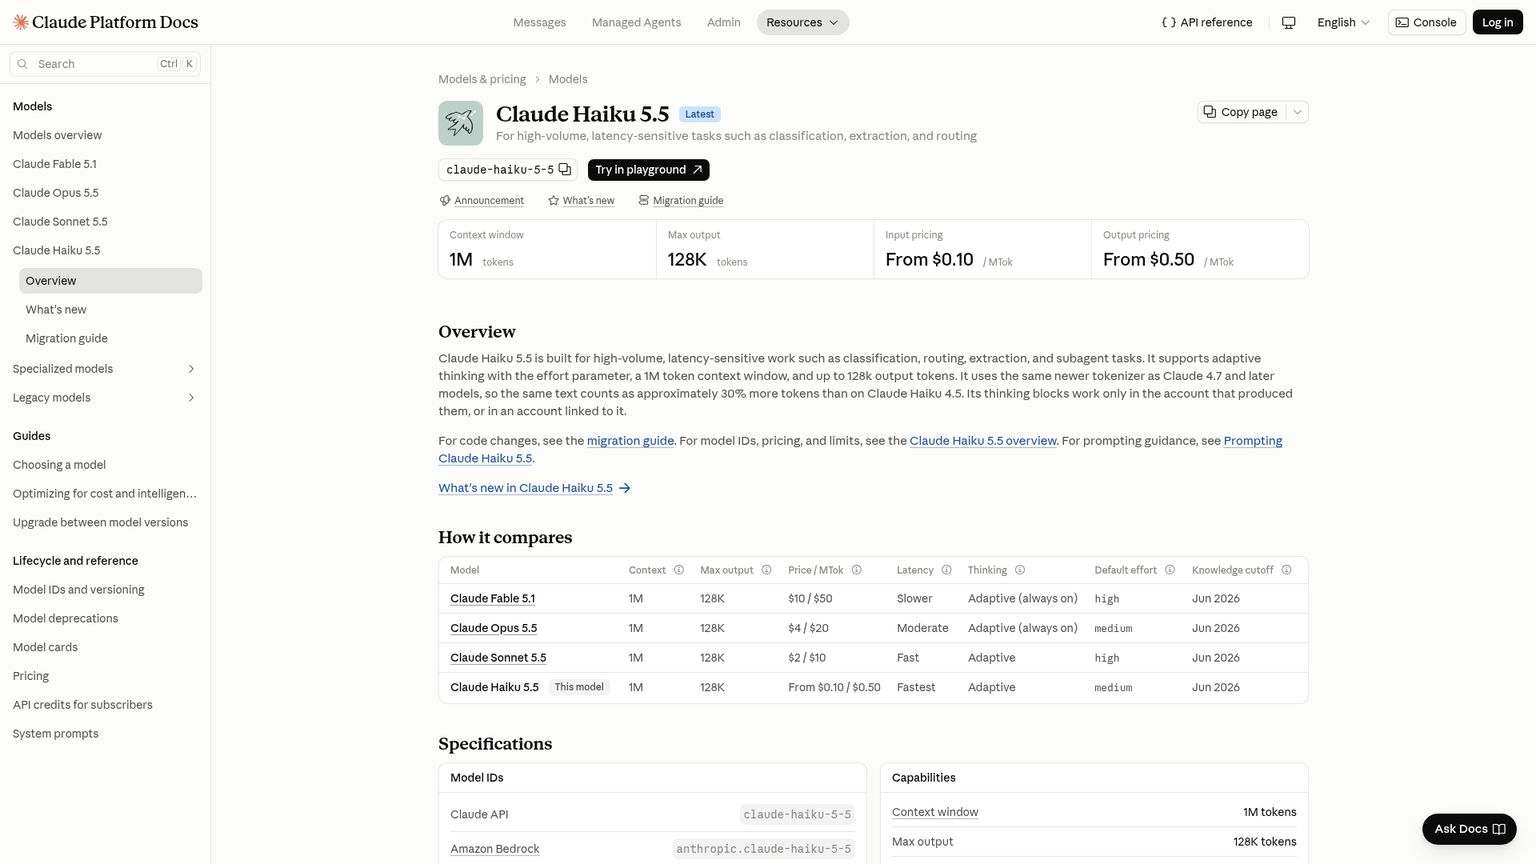
Choisissez-le pour classer les tickets de support vers une liste fixe de destinations, extraire des champs nommés accompagnés de passages justificatifs ou recueillir des éléments pour un autre modèle. La limite pratique reste la validation du résultat : une réponse qui semble correcte mais envoie le ticket dans la mauvaise file reste fausse. Écartez Haiku si votre évaluation montre déjà que la correction de ses erreurs coûte plus que l’économie réalisée.
Le guide de Claude Haiku 5.5 détaille la décision d’adopter ce modèle. Le présent comparatif chiffre Haiku et Sonnet sur les mêmes tâches.
À quelles tâches destiner Claude Sonnet 5.5 ?
Claude Sonnet 5.5 est le modèle généraliste à envisager pour conjuguer vitesse et capacité de jugement plus large. Anthropic revendique la meilleure combinaison de vitesse et d’intelligence : "The best combination of speed and intelligence." Il coûte $2 en entrée / $10 en sortie par MTok, avec des lectures du cache à $0.10 pour les entrées réutilisées admissibles. Positionnement officiel, tarifs.
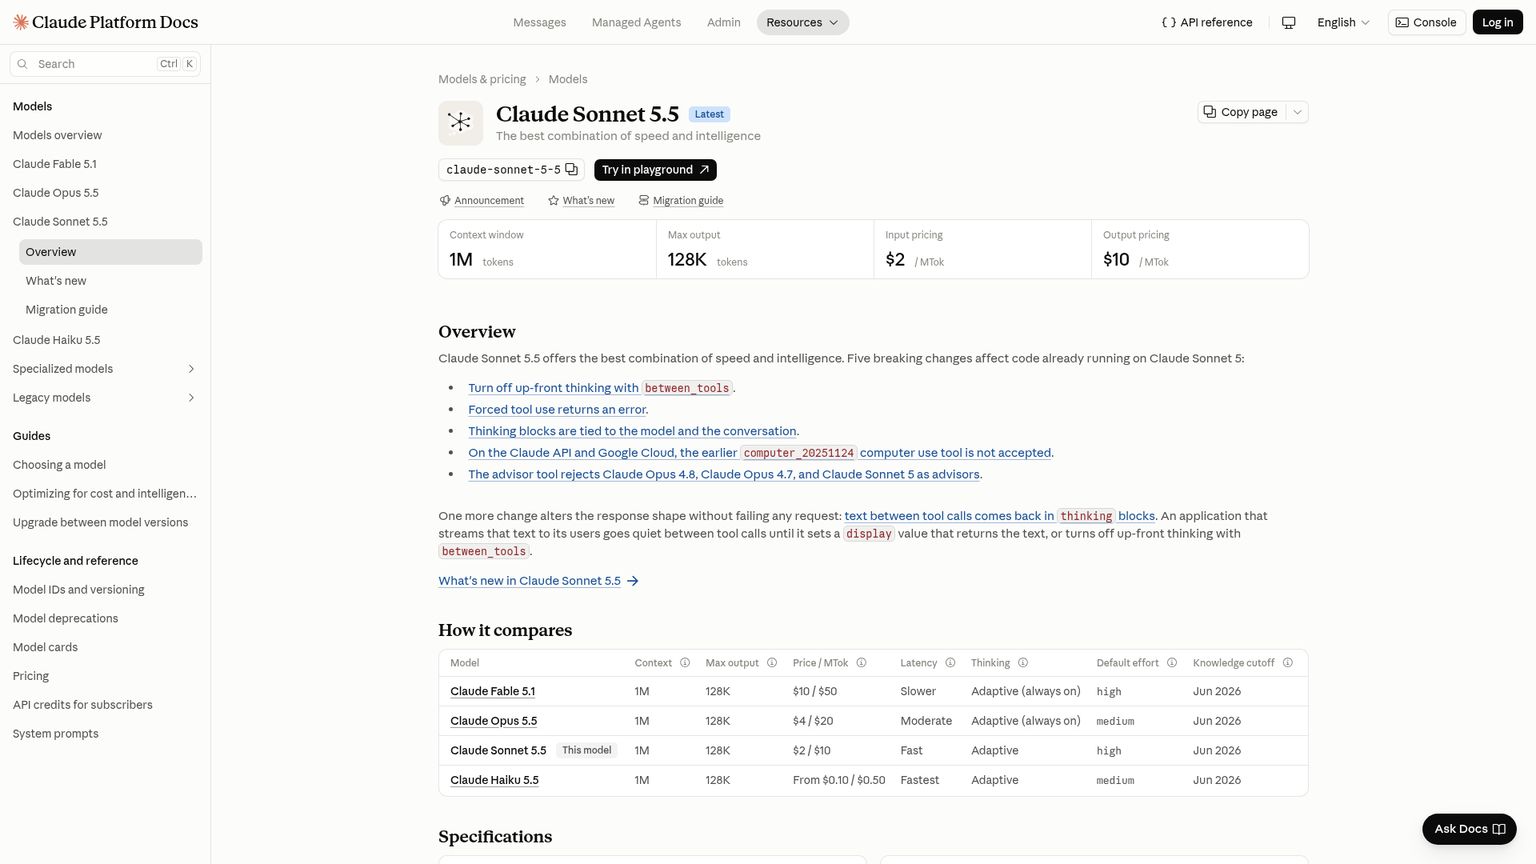
L’agent principal de programmation doit décider des modifications, intégrer les éléments recueillis et gérer les étapes qui échouent. Pour ce rôle, Sonnet est un premier candidat logique parmi les deux modèles étudiés. Son inconvénient est clair : la facture. L’utiliser pour chaque étiquette facile à vérifier impose le tarif supérieur, que ses capacités supplémentaires soient utiles ou non. Réservez-le aux tâches dont les résultats validés justifient ce supplément.
Que permettent réellement leurs limites communes ?
Les deux modèles offrent 1M de contexte, 128K de sortie maximale et un raisonnement adaptatif. Le contexte est l’espace de travail disponible pour une requête ; la sortie maximale plafonne la génération. Le raisonnement adaptatif permet au modèle d’ajuster sa réflexion. Le niveau d’effort API par défaut de Haiku est medium, celui de Sonnet high. Tous deux acceptent les images en entrée et l’usage d’outils. Présentation des modèles.
Pour un directeur technique qui évalue un vaste ensemble de politiques internes, cette limite de contexte commune élimine une différence de capacité. Elle ne dispense pas de vérifier les omissions, les contradictions et l’appui sur les sources. Le niveau d’effort par défaut plus élevé signifie aussi qu’une comparaison des seuls noms de modèles, sans consigner les réglages et la consommation facturée, laisse une différence non maîtrisée dans le budget.
Il s’agit de caractéristiques du fournisseur et de critères de choix éditoriaux. Aucun vainqueur mesuré par benchmark n’est annoncé ici. Un score dans un classement ne permettrait pas d’établir le taux d’erreur sur vos catégories de tickets ni la qualité de votre modification de code finale.
Cas 1 : classer les tickets de support
Pour des étiquettes de file vérifiées, Haiku l’emporte : $16 contre $320 par mois dans ce scénario. Donnez au modèle un choix délimité, validez sa réponse et soumettez les actions ayant des conséquences aux règles de votre application.
Supposons qu’une entreprise SaaS traite 100,000 tickets par mois. Chaque classification utilise 1,200 tokens d’entrée non mis en cache et 80 tokens de sortie facturés, instructions et texte du ticket compris. Chaque prompt reste sous 100,000 tokens. Les mêmes volumes facturés sont supposés pour chacun des deux modèles.
Cela représente 120 millions de tokens d’entrée et 8 millions de tokens de sortie par mois :
- Haiku : 120 × $0.10 + 8 × $0.50 = $12 + $4 = $16.
- Sonnet : 120 × $2 + 8 × $10 = $240 + $80 = $320.
Le coût de 1,000 classifications est de $0.16 avec Haiku ou $3.20 avec Sonnet, d’après les tarifs en vigueur. L’économie mensuelle de tokens atteint $304.
Une bonne spécification de classification définit les destinations autorisées, dont une pour les cas non résolus. Vérifiez que la réponse utilise une étiquette autorisée, puis mesurez si le modèle choisit la bonne sur des exemples dont la réponse est connue. Le premier contrôle détecte un format invalide ; le second, une décision plausible mais erronée. Aucun des deux ne nécessite de prendre la confiance déclarée par le modèle comme preuve.
Supposons que 10% des tickets nécessitent un appel supplémentaire à Sonnet, avec les mêmes nombres de tokens. La première tentative Haiku reste facturée : $16 + $32 = $48 par mois, soit $272 économisés par rapport à Sonnet pour chaque ticket. Ce taux d’escalade est une hypothèse, pas un résultat observé lors de ce travail.
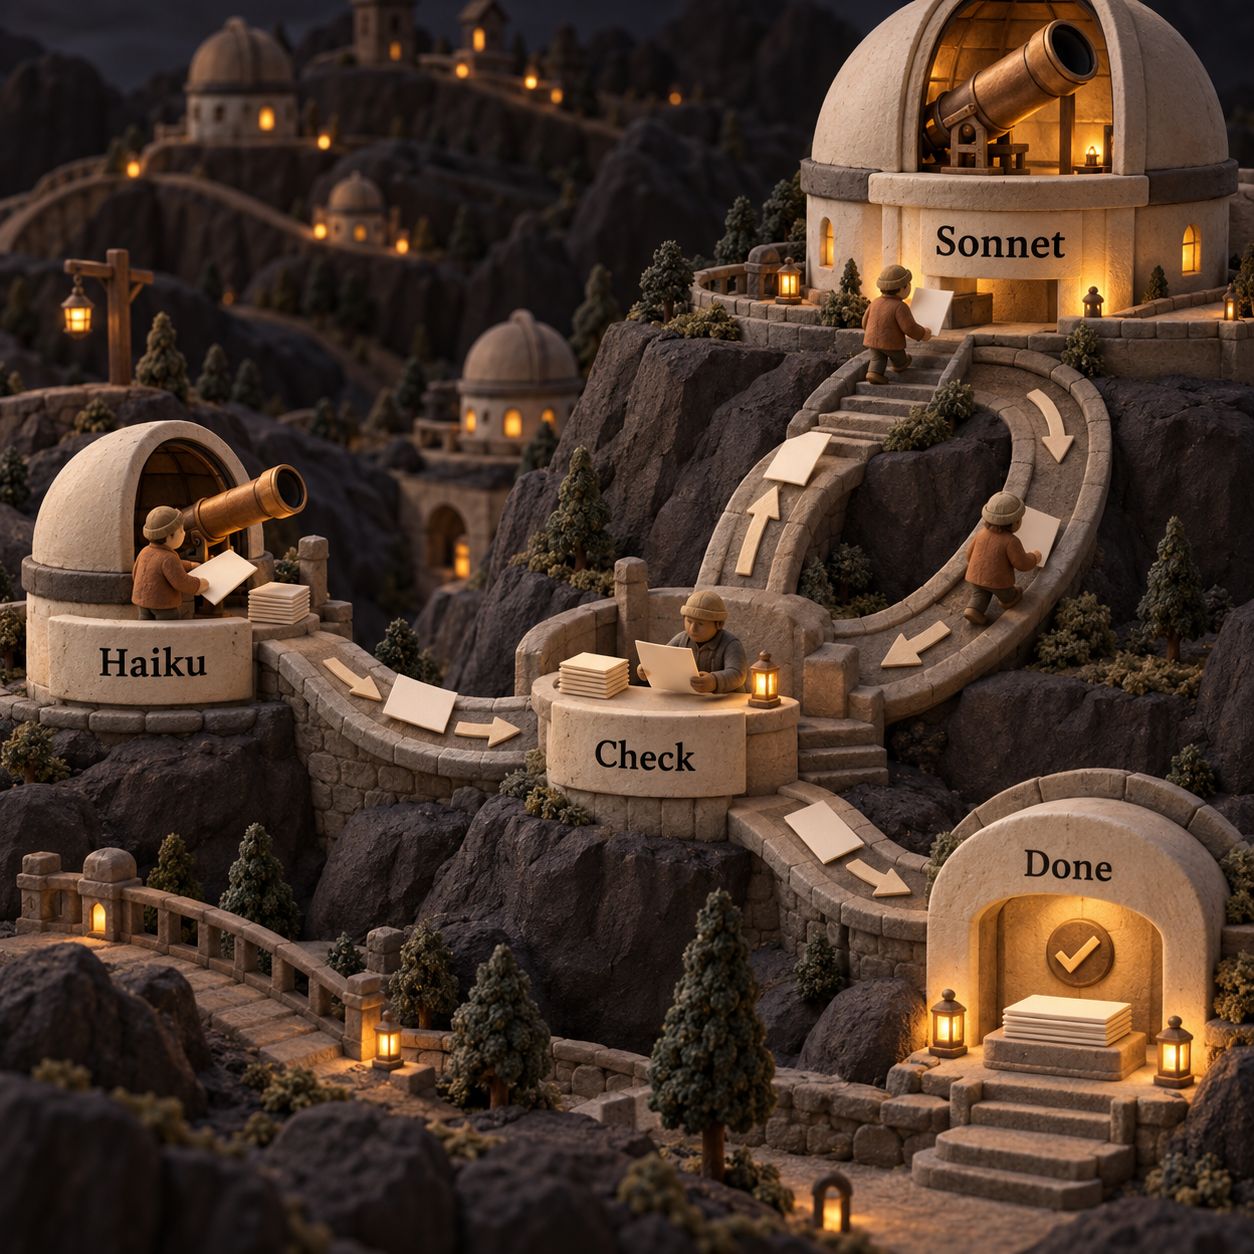
Il existe aussi un seuil d’escalade fondé uniquement sur les tokens. Si chaque cas commence avec Haiku et qu’une fraction e reçoit ensuite un appel Sonnet avec le même nombre de tokens, le coût est H + e × S. Il rejoint le coût de Sonnet seul à e = 1 - H/S : 95% d’escalade pour ces appels au palier court, ou 75% pour des appels comparables au palier long de Haiku. Des prompts d’escalade plus longs, des tentatives supplémentaires et une revue humaine peuvent faire perdre l’avantage tarifaire plus tôt.
Cas 2 : résumer un long document au-delà de 100K
Pour un résumé fidèle qui passe vos contrôles, Haiku l’emporte sur le coût des tokens, avec un écart d’un facteur quatre ici. Sonnet mérite une évaluation si le livrable impose d’interpréter des contradictions ou de porter un jugement plus large, plutôt que de restituer les faits étayés par le document.
Supposons 1,000 documents par mois, chaque requête consommant 150,000 tokens d’entrée non mis en cache et 6,000 tokens de sortie facturés. L’entrée comprend le document et les instructions. Chaque requête dépasse le seuil de prompt de Haiku : le tarif supérieur s’applique donc à l’entrée comme à la sortie.
Par document :
- Haiku : 0.15 × $0.50 + 0.006 × $2.50 = $0.075 + $0.015 = $0.09.
- Sonnet : 0.15 × $2 + 0.006 × $10 = $0.30 + $0.06 = $0.36.
Les totaux mensuels sont de $90 et $360, soit $270 d’économie, selon les règles tarifaires du contexte long. L’affirmation selon laquelle Haiku coûte un vingtième du prix de Sonnet ne s’applique pas à cette tâche.
Le seuil concerne chaque prompt, pas un quota mensuel du compte. Un prompt d’exactement 100,000 tokens bénéficie des tarifs inférieurs de Haiku ; un prompt plus long passe aux tarifs supérieurs pour cette requête. N’appliquez pas le tarif d’entrée supérieur aux seuls tokens excédentaires, et ne conservez pas le tarif court pour la sortie.
Pour préparer une note de projet interne, définissez les faits que le résumé doit préserver : décisions, responsables, échéances, exceptions et passages justificatifs. Vérifiez ces champs dans le document. Si vous êtes directeur technique et comparez des exigences contradictoires entre plusieurs documents, ajoutez ces cas à l’évaluation avant de choisir le modèle moins cher.
Réduire l’entrée peut permettre de rester au palier bas si les éléments nécessaires tiennent encore dans le prompt. Découper un document sans discernement peut faire perdre les liens que le résumé doit expliquer. L’unité utile reste le résumé validé, en intégrant à sa facture toute passe de correction ou de synthèse.
Cache : quand Sonnet coûte-t-il moins cher que Haiku sans cache ?
Sonnet peut coûter moins cher que Haiku sans cache lorsque le contexte réutilisé domine, mais Haiku reste moins cher à usage du cache identique. Une lecture du cache réutilise une entrée déjà traitée. Elle ne réduit pas le prix de la nouvelle réponse générée, et le stockage du contenu réutilisable entraîne un coût d’écriture.
Les lectures du cache de Sonnet coûtent $0.10 par MTok, soit le tarif d’entrée non mise en cache de Haiku au palier court. Pour Haiku, les lectures coûtent $0.01 au palier court et $0.05 au palier long. Les tarifs d’écriture avec une durée de cache de cinq minutes sont de $2.50 pour Sonnet, ou $0.125 / $0.625 pour Haiku aux paliers court/long. Tarification du cache.
La comparaison doit porter sur la même catégorie de facturation. Comparer l’entrée en cache de Sonnet à $0.10 avec l’entrée longue non mise en cache de Haiku à $0.50 peut avantager Sonnet sur l’entrée, alors que sa sortie coûte toujours plus cher. Si les deux lisent depuis le cache, Haiku retrouve le tarif d’entrée le plus bas.
Voici un seuil de bascule intégrant l’écriture, avec les volumes de tokens du résumé long. Supposons 149,000 tokens de préfixe réutilisable, 1,000 nouveaux tokens d’entrée et 6,000 tokens de sortie facturés par requête. Un préfixe est le début inchangé d’un prompt, par exemple un document et des instructions communes, réutilisé dans différentes requêtes.
Supposons une écriture dans un cache de cinq minutes, suivie de 27 lectures réussies pendant la même période de validité du cache :
- Première requête Sonnet : 0.149 × $2.50 + 0.001 × $2 + 0.006 × $10 = $0.4345.
- Chaque lecture suivante : 0.149 × $0.10 + 0.001 × $2 + 0.006 × $10 = $0.0769.
- Sur 28 requêtes, la moyenne est d’environ $0.08967, juste sous les $0.09 par requête de Haiku sans cache.
Ce seuil est un résultat arithmétique conditionnel. Il suppose que le contenu commun est admissible au cache et réellement réutilisé, sans autre écriture. Il ne convient pas à un budget où chaque document est nouveau, où les requêtes sont trop espacées ou où les instructions communes changent constamment.
Avec le même usage du cache, la première requête de Haiku au palier long coûte $0.108625, puis chaque lecture $0.02295. La comparaison équitable favorise donc toujours Haiku sur les tokens. Le cache peut rendre Sonnet abordable lorsque sa capacité de jugement justifie un supplément ; il ne fait pas du grand modèle le choix universellement moins cher.
Pour un assistant documentaire utilisé régulièrement, mesurez séparément les écritures et les lectures du cache. Une prévision qui facture toute l’entrée comme des lectures omet le coût initial et les parties variables du prompt. Gardez la sortie générée dans le calcul, même lorsque le document est déjà en cache.
Claude Haiku vs Sonnet pour coder : gardez Sonnet aux commandes
Sonnet est le choix pour l’agent principal de programmation ; Haiku, pour les sous-tâches délimitées et vérifiées. Un sous-agent est un modèle chargé d’une tâche plus petite au sein du travail d’ensemble. Déléguez une partie dont l’agent principal pourra examiner les éléments, plutôt que de confier au sous-agent une modification ouverte dans tout le dépôt.
Supposons 1,000 tâches de programmation par mois. Chaque tâche comprend :
- Un agent principal Sonnet totalisant 30,000 tokens d’entrée non mis en cache et 6,000 tokens de sortie facturés.
- Huit sous-agents, chacun totalisant 12,000 tokens d’entrée non mis en cache et 1,500 tokens de sortie facturés.
Ces hypothèses portent sur la consommation totale des requêtes de chaque rôle. Chaque prompt pris individuellement reste sous 100,000 tokens. Intégrez les descriptions des outils, l’historique, les éléments fournis par les sous-agents et la revue finale de l’agent principal dans ces totaux. La consommation de l’agent principal est supposée identique dans le workflow entièrement sous Sonnet et dans le workflow hybride ; des tokens supplémentaires de transmission ou des tentatives répétées modifieraient la comparaison.
Aux tarifs API en vigueur, l’agent principal coûte $0.12 par tâche. Un sous-agent Haiku coûte $0.00195, soit $0.01560 pour huit. Un sous-agent Sonnet coûte $0.039, soit $0.312 pour huit.
Hybride : $0.12 + $0.01560 = $0.13560 par tâche, ou $135.60 par mois.
Sonnet partout : $0.12 + $0.312 = $0.432 par tâche, ou $432 par mois.
L’économie calculée atteint $296.40 par mois, soit 68.6%. La facture totale n’est pas divisée par 20, car l’agent principal Sonnet reste facturé. Ce scénario n’établit ni une qualité de code équivalente ni une accélération mesurée.
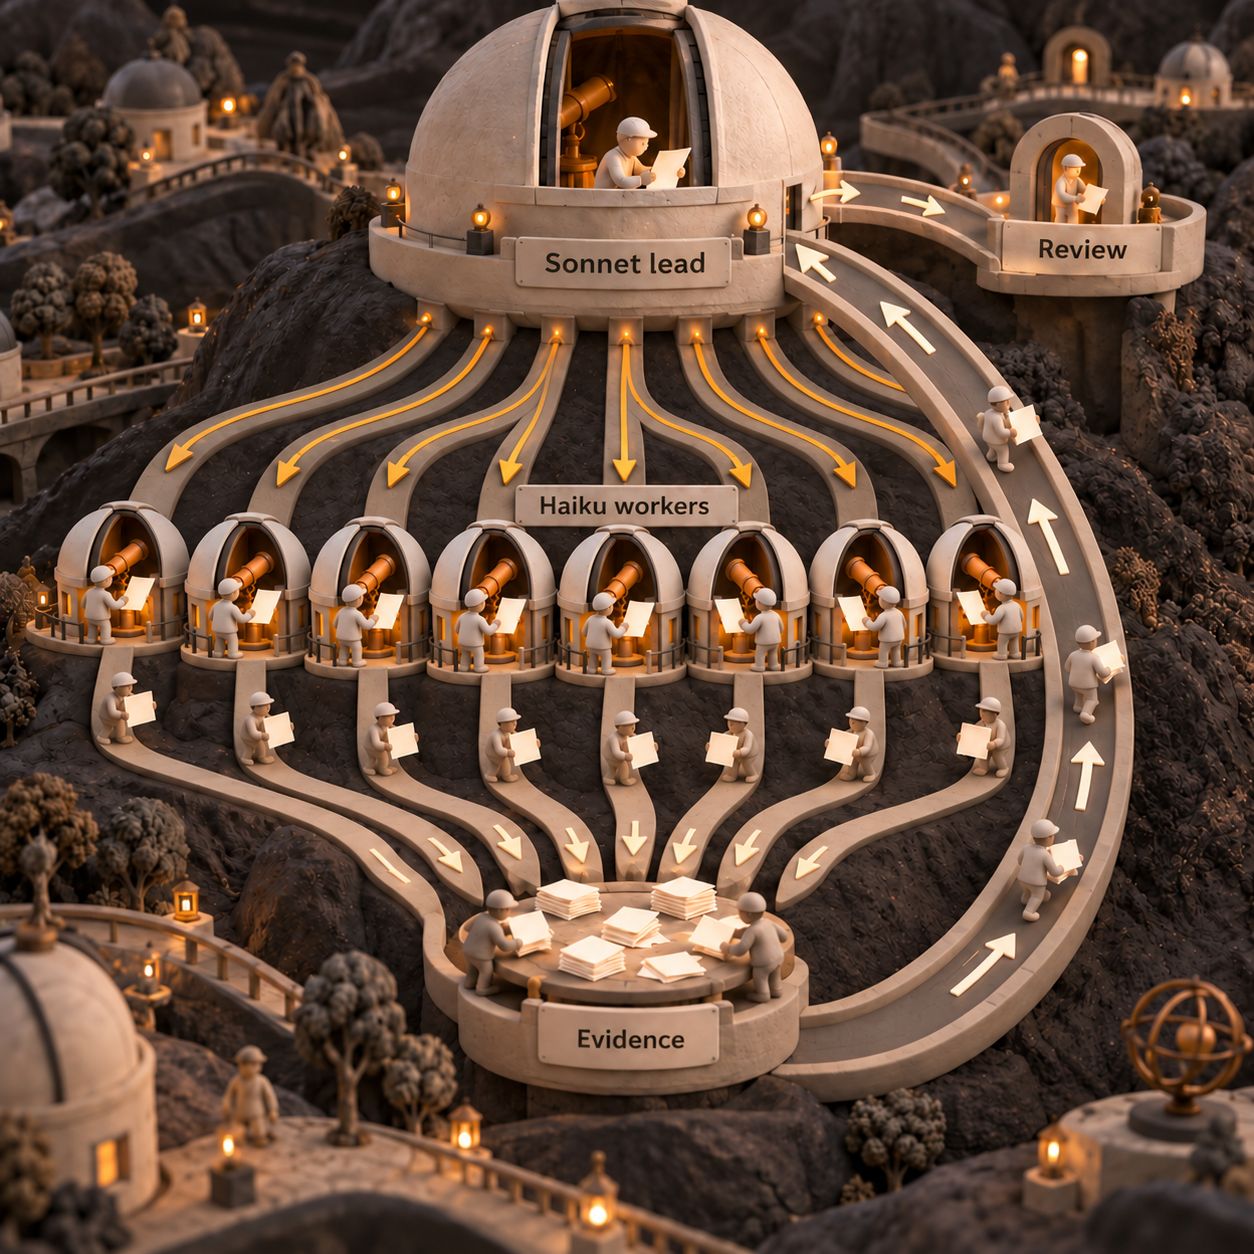
Une consigne adaptée à un sous-agent pourrait être : trouver les fichiers qui font référence à une fonction nommée, renvoyer leurs chemins et les extraits pertinents, et signaler les incertitudes. Une autre pourrait lui demander de résumer la sortie d’erreur d’un contrôle défaillant précis. L’agent principal s’appuie sur ces éléments pour décider des modifications. Il s’agit d’une recommandation d’architecture applicative, pas de l’affirmation que ce travail a testé l’implémentation des sous-agents de Claude Code.
La transmission constitue le point de défaillance potentiel. Un résumé compact peut supprimer l’exception dont l’agent principal avait besoin ; une affirmation non vérifiée peut transformer un sous-agent bon marché en modification erronée coûteuse. Conservez les références aux sources et transmettez assez de contenu original pour que l’agent principal vérifie la réponse du sous-agent. Comptez tout travail répété dans le budget hybride.
Évitez de déléguer si la petite tâche supposée exige presque autant de contexte du dépôt que celle de l’agent principal, ou si vérifier la transmission coûte plus que d’effectuer la tâche directement. Pour une modification dont les parties sont étroitement liées, rester entièrement sous Sonnet peut produire le résultat validé le moins cher malgré une facture de tokens plus élevée.
Passer de Sonnet à Haiku, ou de Haiku à Sonnet
Migrez d’abord la tâche ciblée, puis comparez le workflow complet. Rester dans l’API Claude peut préserver une grande partie de l’intégration, mais changer le nom du modèle ne prouve pas que les sorties se comporteront de la même manière.
Les identifiants des modèles sont claude-haiku-5-5 et claude-sonnet-5-5, indiqués dans la présentation des modèles. Gardez une copie reproductible du prompt, des règles de validation, des entrées représentatives et des réponses acceptées. Consignez le modèle, l’effort, la consommation de tokens, la longueur du prompt, le comportement du cache et le nombre de tentatives par tâche terminée.
Passer de Sonnet à Haiku est pertinent pour un classificateur ou un sous-agent dont les consignes sont claires. Vérifiez le format, l’appui factuel et les échecs coûteux avant d’augmenter le trafic. Gardez un moyen simple de réaffecter cette tâche à Sonnet.
Passer de Haiku à Sonnet est pertinent lorsque les coûts de correction ou de coordination dépassent déjà l’économie. Conservez les mêmes exemples pour établir si le parcours avec le grand modèle corrige les échecs à l’origine du changement. Une réponse plus soignée ne constitue pas une preuve d’exactitude.
Budgétez aussi le travail d’ingénierie. À titre d’illustration, une migration de quatre heures à un tarif supposé de $100 par heure coûte $400. Face aux $304 d’économie mensuelle de tokens du classificateur, il faut environ 1.3 mois pour amortir ce montant, avant les coûts d’évaluation et d’incident. Avec seulement 100 classifications par mois, les mêmes volumes de tokens permettent d’économiser $0.304 par mois. Cette économie justifie difficilement de reconstruire un parcours qui fonctionne.
Ne changez pas de modèle pour la seule grille tarifaire si votre volume de tâches est faible, si la validation exige une appréciation plus large ou si le remplacement impose une nouvelle étape de revue. Gardez les prompts, les éléments et les contrôles portables pour que la décision reste réversible en cas d’évolution future des tarifs ou des capacités.
Quels modèles sont inclus dans les offres Claude ?
Haiku et Sonnet figurent dans les principales offres Claude ; l’accès par abonnement est une question distincte de la facturation API au token. Claude Opus et Claude Fable sont d’autres familles de modèles de la gamme Anthropic. Elles apparaissent ici pour expliquer l’accès selon l’offre, sans élargir cette comparaison tarifaire entre deux modèles. Le comparatif des offres claude.com, vérifié le 8 octobre 2026, indique :
- Free : Haiku et Sonnet ; Opus et Fable sont indiqués comme indisponibles.
- Pro : Haiku, Sonnet et Opus ; Fable est indiqué avec des crédits d’utilisation.
- Max 5x et Max 20x : Haiku, Sonnet et Opus ; Fable est indiqué à 50% des limites hebdomadaires.
- Team : Haiku, Sonnet et Opus ; Fable est indiqué à 50% des limites hebdomadaires pour les sièges premium.
- Enterprise, en libre-service ou avec accompagnement commercial : Haiku, Sonnet, Opus et Fable sont indiqués comme disponibles.
Le tableau des offres nomme des familles de modèles. Il ne garantit pas que chaque compte propose la même version 5.5 précise ni des réglages de produit identiques. Sa ligne de contexte indique jusqu’à 1M, variable selon le modèle. Distinguez cette indication des caractéristiques API présentées plus haut.
Si vous développez une fonctionnalité destinée à la production, budgétez l’usage API facturé à la consommation et les crédits éventuels séparément de l’accès interactif par abonnement. Si vous choisissez un modèle dans l’application en tant qu’abonné, décidez selon la tâche et les limites de votre offre. Un exemple de tokens API ne peut pas promettre le nombre de tâches de programmation incluses dans un abonnement.
Questions fréquentes
Claude Sonnet ou Haiku : lequel choisir ?
Inverser l’ordre des noms ne change pas le choix. Évaluez Haiku pour les tâches ciblées dont les réponses sont vérifiables, et Sonnet pour l’agent principal ou les cas exigeant une appréciation plus large. Comparez les résultats validés et l’ensemble des tentatives facturées, plutôt que les seuls noms de modèles.
Claude Haiku, Sonnet ou Opus : quelles différences ?
Haiku est le candidat à bas coût pour un grand volume de tâches délimitées ; Sonnet est le candidat pour l’agent principal dans cette sélection. Anthropic destine Claude Opus 5.5 aux tâches de programmation agentique et de travail intellectuel de longue durée. Évaluez-le si l’agent principal n’atteint toujours pas vos critères de validation ; ce positionnement ne constitue pas un résultat de qualité mesuré pour votre application. Présentation des modèles.
Claude Sonnet, Opus ou Haiku : lequel utiliser pour coder ?
Choisissez l’agent principal séparément des sous-agents. Sonnet est recommandé ici pour le rôle principal, Haiku pour la collecte d’éléments bien délimitée, et Opus est un autre candidat pour piloter les travaux plus difficiles de longue durée. Évaluez la modification finale validée et intégrez à la facture la revue, les nouvelles tentatives et les tokens de transmission.
Haiku 4.5 ou Sonnet 5 : cette comparaison est-elle encore valable ?
Cette comparaison porte sur d’anciennes versions. Les budgets et les caractéristiques de cette page concernent Claude Haiku 5.5 et Claude Sonnet 5.5. N’utilisez pas un ancien tarif ou une ancienne limite de contexte de Haiku pour trancher la comparaison actuelle des versions 5.5.
Claude Haiku vs Sonnet : quelle différence de prix ?
À nombres identiques de tokens d’entrée non mis en cache et de sortie, Sonnet 5.5 coûte 20 fois plus que Haiku 5.5 pour les prompts allant jusqu’à 100,000 tokens, ou quatre fois plus pour les prompts plus longs. Les lectures du cache ont leurs propres tarifs, et les écritures payantes doivent être incluses. Tarifs en vigueur.
Claude Haiku suffit-il pour les tâches en entreprise ?
C’est un premier candidat pertinent pour la classification, l’extraction et le routage, les tâches citées par Anthropic. Avant de l’adopter, exigez des contrôles sur les échecs qui vous coûtent cher. L’écart de prix ne prouve pas qu’une tâche métier donnée atteindra ce niveau de validation. Positionnement officiel.
Claude Haiku est-il plus rapide que Sonnet ?
Dans sa ligne comparative de latence, Anthropic qualifie Haiku 5.5 de « Le plus rapide » et Sonnet 5.5 de « Rapide ». Ce sont des indications du fournisseur. Ce travail n’a mesuré ni le débit, ni le temps de réponse, ni la vitesse d’exécution d’une tâche complète. Présentation des modèles.
La remise de l’API Batch s’applique-t-elle à Haiku et à Sonnet ?
Oui. Anthropic annonce une remise de 50% sur les tokens d’entrée et de sortie admissibles pour les deux modèles. Batch est asynchrone : utilisez-le pour les travaux qui peuvent attendre. Haiku conserve ses paliers distincts pour les prompts courts et longs. Tarification Batch.
Quelle tâche faire évoluer cette semaine ?
Migrez une tâche délimitée après une comparaison évaluée selon vos critères. Un fondateur peut commencer par les étiquettes des tickets ; un directeur technique, par un résumé documentaire à consignes précises ; un développeur, par un sous-agent de recherche de fichiers, tout en gardant Sonnet comme agent principal.
Définissez les critères de validation
Précisez la réponse attendue, les éléments justificatifs et les échecs qui déclenchent une revue. Incluez des exemples difficiles, pas seulement les cas courants qui réussissent.
Chiffrez la tâche complète
Consignez pour chaque modèle l’entrée réelle, la sortie facturée, les écritures et lectures du cache, ainsi que les nouvelles tentatives. Vérifiez le seuil de Haiku pour chaque prompt et intégrez la revue de l’agent principal dans les tâches déléguées.
Choisissez le parcours et prévoyez un retour en arrière
Adoptez Haiku là où la validation et le coût des corrections préservent son économie. Gardez Sonnet, ou transmettez-lui les cas, lorsque le parcours avec le grand modèle justifie le supplément. Revérifiez le budget quand le prompt, l’effort ou la charge de travail change.
Recevez la checklist de configuration de Claude Code et Codex pour organiser vos agents selon les rôles choisis.
- Publié
- Catégorie
- AI
- Langue
Claude Haiku 5.5 : combien coûte-t-il et faut-il l’adopter ?
Claude Haiku 5.5 : tarifs API, seuil de 100K tokens et budget mensuel face à Haiku 4.5 et Sonnet 5.5. Identifiez les tâches à lui confier en priorité.8 oct. 2026AI
Compte rendu de réunion par IA : quelle alternative à Otter AI choisir ?
Comparez les alternatives à Otter AI pour vos comptes rendus de réunion par IA : tarifs, offres gratuites, enregistrement sans bot et intégrations CRM.8 oct. 2026AI
Mistral Large 4 : quel budget et quand passer à l’action ?
Mistral Large 4 : tarifs API, remise de lancement et benchmarks. Découvrez quand tester la preview hébergée et quand attendre les poids pour l’héberger.7 oct. 2026AI
Agent IA Lindy : avis, tarifs et limites en octobre 2026
Notre avis sur Lindy AI : tarifs en USD, coût des crédits, gestion des e-mails et des réunions, limites des intégrations et alternatives adaptées.7 oct. 2026AI
Mistral pricing : quel budget pour l’API et Vibe en 2026 ?
Prix de l’API Mistral, abonnements Vibe, limites gratuites et hébergement UE : comparez les offres et calculez votre facture mensuelle en dollars.6 oct. 2026AI
Claude Skills : construisez votre workflow de reporting client
Créez un skill Claude pour vos rapports clients hebdomadaires : calculs en Python, validation des données, installation et partage dans l’équipe.6 oct. 2026AI
Agent IA en entreprise : missions, tarifs et premiers pas
Comparez les missions et les prix des agents IA pour votre entreprise. Choisissez un rôle, gardez une validation humaine et mesurez un test de 30 jours.6 oct. 2026AI