Claude HaikuとSonnetの違い:料金差と仕事別の選び方
Claude HaikuとSonnetの違いを、API料金、入力容量、思考設定、用途別の費用から整理します。チケット分類、長文要約、コーディングの指揮役とワーカーで使い分ける基準に加え、100,000トークンの料金境界、キャッシュの書き込み、再試行と修正費用まで含めた判断方法を解説します。
公開日
 著者 Omid Saffari

Claude HaikuとSonnetの違いを見極めるには、まず任せる仕事を決めます。分類や情報抽出のように範囲を限定できる処理には、Anthropicの小型モデルClaude Haiku 5.5を使います。コード変更の全体を指揮する役割や、幅広い判断が必要な仕事には、汎用の大型モデルClaude Sonnet 5.5を選びます。本記事のサポートチケット分類の想定では、月間トークン料金はHaikuが$16、Sonnetが$320です。ただし、プロンプトが100,000トークンを超えると、両モデルの料金差は20倍から4倍に縮まります。
料金と仕様は2026年10月8日に確認しました。 確認先はAnthropicの料金ドキュメント、モデル一覧、claude.com/pricingです。費用例は明記したトークン数をもとにした試算であり、性能テストの結果ではありません。料金はすべてUSDで示します。
Claude HaikuとSonnetの違い:どんな仕事に使い分けますか?
答えの範囲が狭く、結果を検証できる仕事にはHaikuを選びます。解釈、調整、失敗からの立て直しを担う指揮役にはSonnetを選びます。 判断の軸は、合格基準を満たした成果、プロンプトの長さ、再利用できるコンテキスト、そして誤りを修正する費用です。
- サポートチケットを振り分ける創業者: まずHaikuを検討します。行き先が決まっているキューのラベルなら、生成費用を抑えやすく、正解ラベル付きの例で評価もしやすくなります。全チケットに大型モデルの料金を払うのではなく、判断できない案件を上位モデルに回します。
- 長い文書を要約する中堅企業のCTO: 元の内容に忠実な情報抽出や、要件を限定した要約では、必要な事実を維持できるならHaikuがトークン費用で有利です。矛盾する記述を突き合わせたり、その影響を説明したりする仕事では、次の候補としてSonnetを評価します。両モデルとも長い入力を扱えるため、入力容量だけでは選べません。
- コーディングエージェントを使う個人開発者やエンジニアリング責任者: 変更全体の指揮はSonnetに任せます。Haikuには、関連ファイルの探索、失敗メッセージの抽出、範囲を限定した差分の要約など、小さな仕事を割り当てます。ワーカーで費用を抑えつつ、指揮役がその根拠を確認します。
運用責任者が最後に確認すべきなのは、安い処理経路に変えることで修正作業が増えないか、という点です。チケットあたり1セント未満の節約でも、件数が多ければ効果があります。一方、人への引き継ぎが一度増えるだけで、その節約が消えることもあります。
以下のAPI比較は、Claude Haiku 5.5とClaude Sonnet 5.5を対象にしています。MTokは百万トークンを表します。トークンはモデルが処理するテキストの単位です。入力はモデルに送る内容、出力はモデルが生成する内容です。
出典:現行料金表、モデル仕様。キャッシュへの書き込みは別の入力料金区分として請求されます。詳しくは後述します。
HaikuとSonnetの料金差:請求額を決める単価
未キャッシュのトークン単価は、どちらのプロンプト料金帯でもHaikuが有利です。 Sonnetの高い料金を正当化するには、合格基準を満たす成果、修正の少なさ、ワークフロー全体の改善といった効果が必要です。
未キャッシュの1,000トークンあたりに換算すると、Haikuは短いプロンプトの料金帯で入力$0.00010、出力$0.00050、長いプロンプトの料金帯で入力$0.00050、出力$0.00250です。Sonnetは入力$0.002、出力$0.010です。これは公開されているMTok単価を1,000で割った値であり、仕事を完了するまでの費用ではありません。
この区別が重要なのは、出力が請求額の大きな部分を占める場合があるためです。ラベルだけを返す分類器と、長い説明を書くエージェントでは、入力と出力の比率が違います。また、コーディング中に会話履歴やツールの結果が増えると、後半のリクエストは最初の指示より大きくなることがあります。
下図は、このあと詳しく計算する三つの仕事の費用を示しています。それぞれの比較では、想定トークン数を同じにしています。コーディングの比較では両方の構成にSonnetの指揮役を残しているため、安い方の棒は全処理をHaikuに任せる構成ではなく、併用構成です。
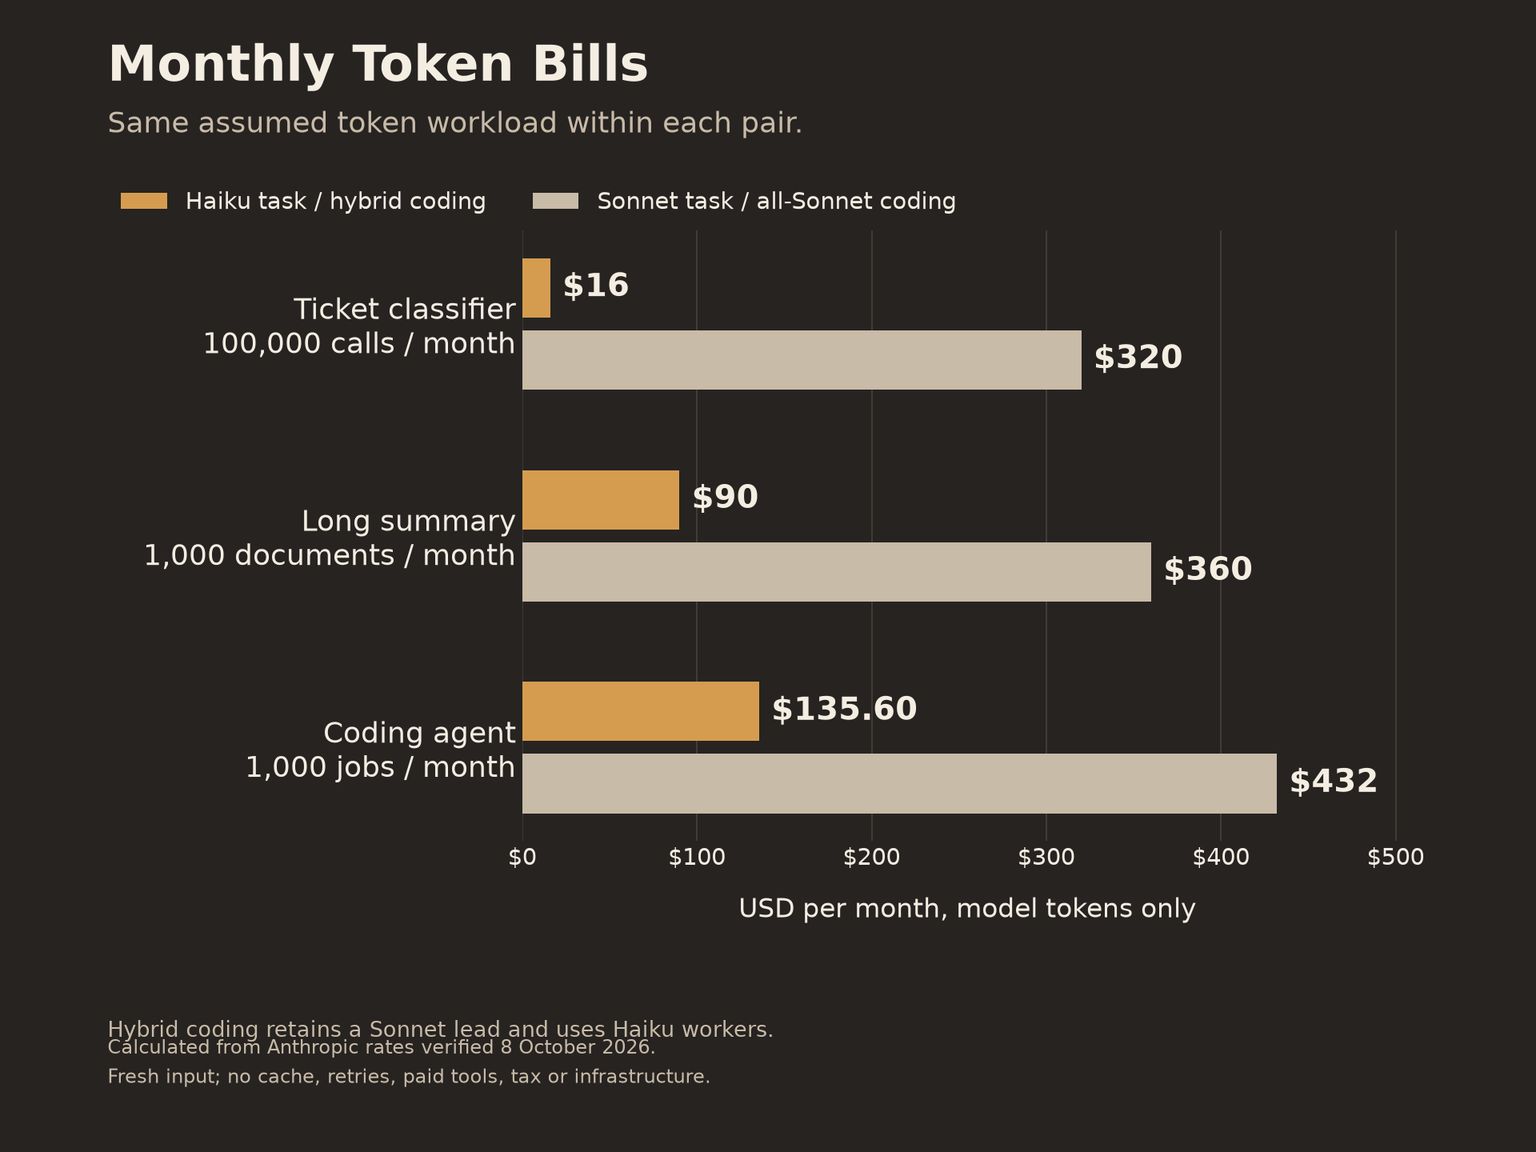
三つの基本シナリオはいずれも、Anthropicの標準API料金、未キャッシュの入力、再試行なし、別料金のサーバーツールなしを前提にしています。税金とアプリケーションのインフラ費用は含みません。出力トークン数は、ユーザーに見える短い回答から推測した数ではなく、予算計算で仮定した請求対象の出力総数です。本番予算を決める前に、これらの仮定を各モデルの実際の使用量に置き換えてください。
他のモデルや課金項目も確認したい場合は、Claude API料金ガイドを参照してください。
入力容量と思考機能:上限は同じでもデフォルトは違います
容量は同じです。Anthropicの相対的な速度区分ではHaikuが上で、推論のデフォルト設定も異なります。 ただし、どちらの仕様も、文書の重要な情報を正しく残せることや、リポジトリの変更を完了できることを保証するものではありません。
Claude Haiku 5.5はどんな用途に向いていますか?
Claude Haiku 5.5は、仕様を厳密に定められる処理を高頻度で実行する際の小型モデル候補です。Anthropicは用途を**「分類、抽出、ルーティングなど、処理量が多く、低遅延が求められるタスク向け」と説明しています。短いプロンプトの単価はMTokあたり入力$0.10 / 出力$0.50で、長いプロンプトでは$0.50 / $2.50**に上がります。公式の用途説明、料金。
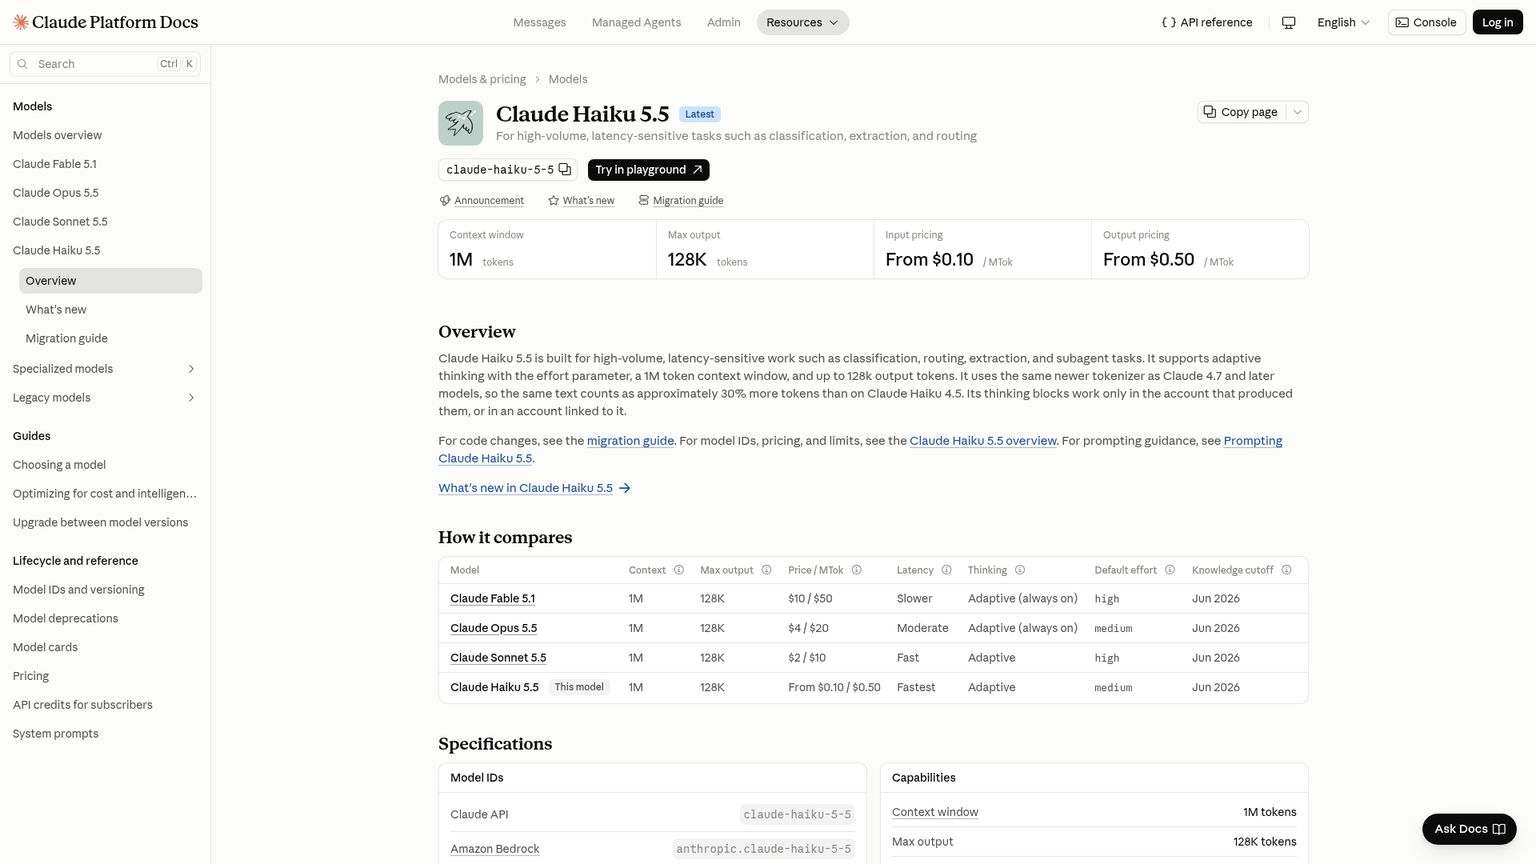
候補になるのは、行き先を固定したサポート分類器、指定フィールドと根拠となる文章を返す抽出処理、別のモデルのために根拠を集めるワーカーなどです。実務上の境目は、結果の合否を検証できるかどうかにあります。形式が正しく見えても、違うキューに送れば誤りです。評価の段階で、誤りの修正費用が料金の節約を上回るとわかっている仕事には、Haikuを選ぶべきではありません。
Haiku単体の導入判断はClaude Haiku 5.5ガイドで解説しています。本記事では、同じ仕事に使った場合のHaikuとSonnetの費用を比べます。
Claude Sonnet 5.5はどんな用途に向いていますか?
Claude Sonnet 5.5は、速度と幅広い判断力を両立させたい仕事の汎用モデル候補です。Anthropicは**「速度と知能の最良の組み合わせ」と説明しています。料金はMTokあたり入力$2 / 出力$10で、対象となる再利用入力のキャッシュヒットは$0.10**です。公式の用途説明、料金。
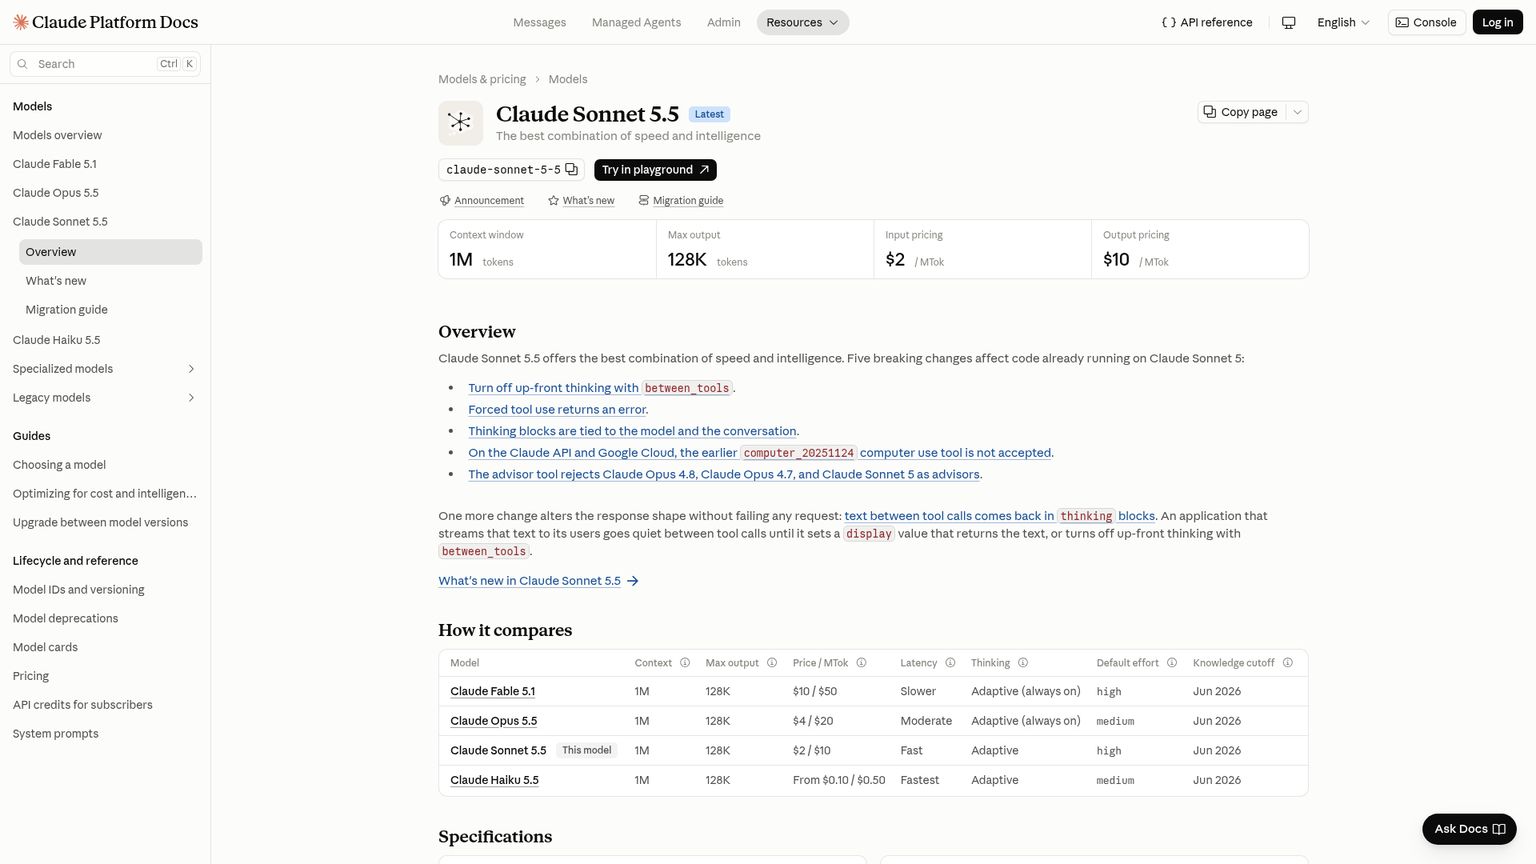
コーディングの指揮役は、何を変更するかを決め、集めた根拠を統合し、失敗した手順に対処する必要があります。この二つのモデルから選ぶなら、まずSonnetを評価するのが妥当です。率直な弱点は料金です。簡単に検証できるラベルの生成にまで毎回Sonnetを使うと、追加能力が役立つかどうかにかかわらず高い単価を払うことになります。合格基準を満たす成果によって追加費用を正当化できる仕事に使いましょう。
共通の上限から、何がわかりますか?
両モデルとも、コンテキスト1M、最大出力128K、適応型思考に対応しています。コンテキストはリクエストで使える作業領域、最大出力は生成できる量の上限です。適応型思考では、モデルが推論の量を調整します。APIのデフォルトeffortはHaikuがmedium、Sonnetがhighです。両方とも画像入力とツール利用に対応しています。モデル一覧。
大量の規程文書を評価するCTOにとって、コンテキスト上限が同じなら、容量の差を気にする必要はなくなります。それでも、情報の抜け、矛盾、出典による裏付けの確認は必要です。また、Sonnetはデフォルトeffortが高いため、設定と請求対象の使用量を記録せずにモデル名だけで比べると、予算比較に条件の違いが残ります。
ここで示しているのは、ベンダーの仕様と、編集部による選び方の指針です。実測ベンチマークの勝者を示しているわけではありません。ランキングのスコアだけでは、自社のチケット分類の誤り率や、最終的なコード変更の品質はわかりません。
用途1:サポートチケットの分類
検証できるキューのラベルなら、この想定ではHaikuが有利です。月額はHaikuの$16に対してSonnetは$320です。 モデルの選択肢を限定し、返された回答を検証します。影響の大きい操作は、アプリケーション側のルールを通して実行します。
SaaS企業が月に100,000件のチケットを処理すると仮定します。分類ごとに、指示とチケット本文を含む未キャッシュの入力1,200トークン、請求対象の出力80トークンを使います。各プロンプトは100,000トークン未満です。両モデルとも、同じ請求対象トークン数を使うと仮定します。
月間では入力120 MTok、出力8 MTokになります。
- Haiku: 120 × $0.10 + 8 × $0.50 = $12 + $4 = $16。
- Sonnet: 120 × $2 + 8 × $10 = $240 + $80 = $320。
現行料金から計算すると、分類1,000件あたりの費用はHaikuが$0.16、Sonnetが$3.20です。月間トークン料金の節約額は**$304**になります。
分類処理の仕様には、許可する行き先と、判断できない場合の行き先を明記します。まず回答が許可されたラベルかどうかを検証し、次に正解がわかっている例で、正しいラベルを選んだかを評価します。前者は形式上の不備を見つけ、後者はもっともらしく見える誤判断を見つけます。どちらも、モデル自身が述べる「自信」を正しさの証拠として受け入れる必要はありません。
チケットの10%で、Sonnetを追加で一度呼び出す必要があると仮定します。トークン数は同じ想定です。最初のHaiku処理にも料金は発生するため、月額は**$16 + $32 = $48となり、全チケットにSonnetを使う場合より$272**安くなります。このエスカレーション率は仮定であり、本記事の作成時に観測した結果ではありません。
トークン料金だけで見たエスカレーションの境目もあります。全案件をHaikuで開始し、そのうち割合eの案件に同じトークン数のSonnet呼び出しを追加すると、費用はH + e × Sです。Sonnetだけを使う場合と同額になるのはe = 1 - H/Sのときです。この短いプロンプトの例ではエスカレーション率95%、Haikuの長いプロンプトの料金帯でトークン数を揃えた場合は**75%**になります。引き継ぐプロンプトが大きくなったり、再試行や人によるレビューが加わったりすれば、より低い割合で安い経路の利点が失われます。
用途2:100Kを超える長文の要約
元の内容に忠実で、検証にも合格する要約なら、Haikuがトークン費用で有利です。この例の料金差は4倍です。 文書に裏付けられた事実を再現するだけでなく、矛盾の解釈や幅広い判断が必要な成果物では、Sonnetを評価する価値があります。
月に1,000文書を処理し、リクエストごとに未キャッシュの入力150,000トークン、請求対象の出力6,000トークンを使うと仮定します。入力には文書と指示が含まれます。すべてのリクエストがHaikuのプロンプトの境界を超えるため、入力・出力とも高い料金帯になります。
文書あたりの費用は次のとおりです。
- Haiku: 0.15 × $0.50 + 0.006 × $2.50 = $0.075 + $0.015 = $0.09。
- Sonnet: 0.15 × $2 + 0.006 × $10 = $0.30 + $0.06 = $0.36。
長いコンテキストの料金ルールに従うと、月額は**$90と$360**で、節約額は$270です。この仕事では「Sonnetの20分の1」という料金比較は当てはまりません。
料金帯の境界は、月間のアカウント利用枠ではなく、各プロンプトに適用されます。ちょうど100,000トークンのプロンプトならHaikuの安い単価が適用され、それを超えると、そのリクエストは高い単価になります。高い入力単価を超過分だけに適用したり、出力を短いプロンプトの単価のまま計算したりしないでください。
社内のプロジェクト概要を作成する担当者なら、決定事項、責任者、期限、例外、根拠となる文章など、要約に必ず残す事実を定めます。それらを原文と照合します。複数の文書にまたがる不整合な要件を比べるCTOなら、安いモデルを選ぶ前に、矛盾を扱う例も評価に含めます。
必要な根拠が残る範囲で入力を短くすれば、安い料金帯を維持できる可能性があります。ただし、むやみに文書を分割すると、要約で説明すべき関係性が失われることがあります。費用を比べる単位は、最終的に合格した要約です。修正や統合のための追加処理も、その費用に含めます。
キャッシュを使うSonnetが、未キャッシュのHaikuより安くなる条件
再利用するコンテキストが大部分を占める場合、Sonnetが未キャッシュのHaikuより安くなることはあります。ただし、同じキャッシュ条件ならHaikuの方が安いままです。 キャッシュヒットでは、すでに処理した入力を再利用します。新しく生成する回答は割引されず、再利用する内容を保存する際にも書き込み料金が発生します。
SonnetのキャッシュヒットはMTokあたり$0.10で、Haikuの短いプロンプトの未キャッシュ入力と同じ単価です。Haikuのキャッシュヒットは、短いプロンプトの料金帯で**$0.01**、長いプロンプトの料金帯で**$0.05です。5分キャッシュへの書き込み単価は、Sonnetが$2.50**、Haikuが短い/長いプロンプトの料金帯で**$0.125 / $0.625**です。キャッシュ料金。
比較では、課金区分を揃える必要があります。Sonnetのキャッシュ済み入力を$0.10、Haikuの未キャッシュの長い入力を$0.50として比べると、入力だけならSonnetが有利になる一方、出力はSonnetの方が高いままです。両方でキャッシュを読み込む条件なら、入力単価は再びHaikuが安くなります。
長文要約と同じ入出力構成を使い、書き込み費用も含めて逆転する例を計算します。リクエストごとに、再利用できるプレフィックス149,000トークン、新しい入力1,000トークン、請求対象の出力6,000トークンを使うと仮定します。プレフィックスとは、文書や共通の指示など、複数のリクエストで再利用する、プロンプト先頭の変わらない部分です。
5分キャッシュへ一度書き込み、その同じ有効期間内に27回のキャッシュヒットが成功すると仮定します。
- Sonnetの最初のリクエスト:0.149 × $2.50 + 0.001 × $2 + 0.006 × $10 = $0.4345。
- その後のキャッシュヒットごとの費用:0.149 × $0.10 + 0.001 × $2 + 0.006 × $10 = $0.0769。
- 28リクエストの平均は約$0.08967となり、未キャッシュのHaikuのリクエストあたり$0.09をわずかに下回ります。
これは条件付きの計算上の逆転です。共通部分がキャッシュの対象になり、実際に再利用され、追加の書き込みが発生しないことを前提としています。毎回違う文書を扱う場合、リクエストの間隔が長すぎる場合、共通の指示が変わり続ける場合の予算には使えません。
Haikuにも同じキャッシュ条件を適用すると、長いプロンプトの料金帯で最初のリクエストは**$0.108625**、その後のキャッシュヒットは**$0.02295**です。条件を揃えたトークン料金の比較では、引き続きHaikuが有利です。キャッシュによって、Sonnetの判断力に追加料金を払う価値がある仕事の費用は抑えられます。ただし、大型モデルがあらゆる用途で安くなるわけではありません。
継続して使う文書アシスタントでは、キャッシュへの書き込みとヒットを別々に測定します。すべての入力をキャッシュヒットの単価で見積もると、最初の書き込み費用や、プロンプトの変化する部分を見落とします。文書自体がすでにキャッシュされていても、生成する出力は計算に含めてください。
Claudeのコーディング用途:指揮役はSonnet、限定した作業はHaiku
コーディングの指揮役にはSonnet、範囲を限定して検証できるワーカーの仕事にはHaikuを推奨します。 サブエージェントは、大きな仕事の一部として小さなタスクを割り当てられたモデルです。ワーカーに範囲の定まらないリポジトリ変更を丸ごと任せるのではなく、指揮役が根拠を確認できる部分を切り出して委任します。
月に1,000件のコーディング作業を行うと仮定します。各作業の構成は次のとおりです。
- Sonnetの指揮役が、合計で未キャッシュの入力30,000トークン、請求対象の出力6,000トークンを使います。
- 八つのワーカーが、それぞれ合計で未キャッシュの入力12,000トークン、請求対象の出力1,500トークンを使います。
これは、各役割が行うリクエスト全体の使用量を仮定したものです。個々のプロンプトは100,000トークン未満に収まります。ツールの説明、履歴、ワーカーが返す根拠、指揮役の最終レビューも、この合計に含めます。全処理をSonnetで行う構成と併用構成で、指揮役の使用量は同じと仮定します。引き継ぎ用の追加トークンや再試行が増えれば、比較結果は変わります。
現行API料金では、指揮役の費用は作業あたり**$0.12です。Haikuワーカーは一つあたり$0.00195で、八つでは$0.01560です。Sonnetワーカーは一つあたり$0.039で、八つでは$0.312**です。
併用構成: $0.12 + $0.01560 = 作業あたり$0.13560、月額は**$135.60です。
全処理Sonnet: $0.12 + $0.312 = 作業あたり$0.432、月額は$432**です。
計算上の節約額は**月に$296.40、割合では68.6%**です。Sonnetの指揮役への支払いが残るため、全体の請求額が20分の1になるわけではありません。このシナリオは、コード品質が同等であることや、実測の高速化を示していません。
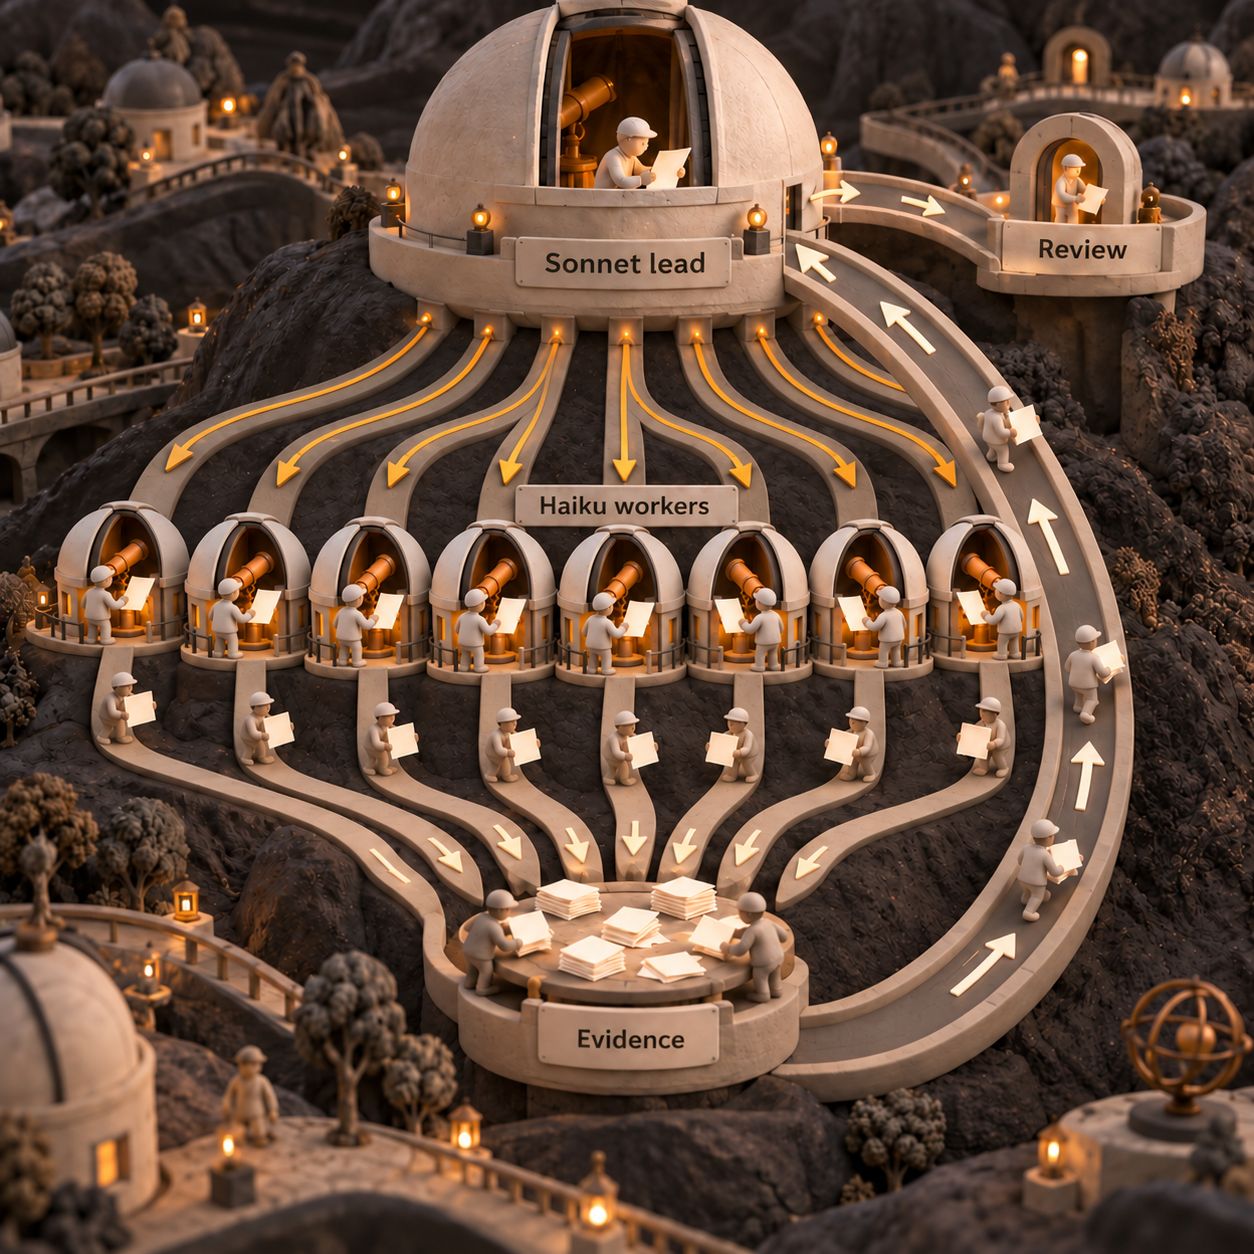
ワーカーに適した仕様の例は、「指定した関数を参照するファイルを探し、ファイルパスと関連箇所を返し、不確かな点を明示する」というものです。指定した失敗チェックのエラー出力を要約する仕事も考えられます。指揮役は、その根拠を使って変更内容を決めます。これはアプリケーション構成の推奨であり、本記事の作成時にClaude Codeのサブエージェント実装を実際に試したという意味ではありません。
失敗が起きやすいのは引き継ぎです。短くまとめた要約から、指揮役に必要な例外条件が抜けることがあります。未検証の主張を渡せば、安いワーカーが高くつく誤修正の原因にもなります。出典への参照を残し、ワーカーの回答を検証できるだけの原文を指揮役に渡します。重複して行った作業も併用構成の予算に含めてください。
小さいはずの仕事に、指揮役とほぼ同じリポジトリのコンテキストが必要な場合や、引き継ぎ内容のレビューが直接作業するより高くつく場合には、委任を避けます。各部分が密接に関係する変更なら、トークン料金が高くても、全処理をSonnetに任せた方が、合格基準を満たす成果までの総費用を抑えられることがあります。
SonnetからHaikuへ、HaikuからSonnetへ切り替える判断
まず範囲の狭い仕事を切り替え、その後、完了までのワークフロー全体を比較します。 Claude APIの中での切り替えなら、連携実装の多くを維持できる可能性があります。ただし、モデル名を変えただけで出力の振る舞いが同等になるとは限りません。
モデルIDはclaude-haiku-5-5とclaude-sonnet-5-5で、モデル一覧に記載されています。再現できる形で、プロンプト、検証ルール、代表的な入力、合格した回答を保存します。モデル、effort、トークン使用量、プロンプトの長さ、キャッシュの利用状況、仕事を完了するまでの試行回数を記録します。
SonnetからHaikuへの切り替えは、仕様が明確な分類器やワーカーで検討しやすくなります。処理量を増やす前に、形式、事実の裏付け、失敗時の費用が大きいケースを確認します。その仕事をSonnetに戻せるようにしておきます。
HaikuからSonnetへの切り替えは、修正や調整の費用がすでに節約額を超えている場合に妥当です。同じ評価例を残し、大型モデルへの切り替えで、移行のきっかけとなった失敗が解消するかを確認します。回答が洗練されて見えることを、正しさの根拠にしないでください。
移行の開発費も計算します。たとえば、時給$100と仮定して4時間の移行作業を行うと、費用は$400です。分類器の月間トークン節約額$304と比べると、評価や障害対応の費用を含める前の回収期間は約1.3か月です。一方、月に100件だけ分類するなら、同じ入出力構成での節約額は月に$0.304にとどまります。そのために正常に動いている処理経路を作り直す経済的な理由は、ほとんどありません。
現在の処理量が少ない場合、合否が幅広い判断力に左右される場合、置き換えによってレビュー工程が増える場合には、料金表だけを理由に切り替えないでください。プロンプト、根拠、検証処理を移しやすい形に保ち、将来の料金や能力の変化に合わせて判断を戻せるようにしておきます。
Claudeの各プランでは、どのモデルを使えますか?
主要なClaudeプランにはHaikuとSonnetが掲載されています。ただし、サブスクリプションでの利用可否とAPIのトークン課金は別の話です。 Claude OpusとClaude Fableは、Anthropicが提供する別のモデルファミリーです。ここではプランでの利用可否を説明するために触れており、二つのモデルの費用比較を広げるためではありません。2026年10月8日に確認したclaude.comのプラン比較には、次のように記載されています。
- Free: HaikuとSonnetを利用できます。OpusとFableは利用不可とされています。
- Pro: Haiku、Sonnet、Opusを利用できます。Fableは利用クレジットの対象とされています。
- Max 5xとMax 20x: Haiku、Sonnet、Opusを利用できます。Fableは**週間上限の50%**とされています。
- Team: Haiku、Sonnet、Opusを利用できます。Fableは**プレミアムシートの週間上限の50%**とされています。
- Enterpriseのセルフサービス版と営業経由版: Haiku、Sonnet、Opus、Fableはいずれも利用可能とされています。
プラン表に載っているのはモデルファミリーです。すべてのアカウントで同じ5.5の具体的なバージョンや、同じ製品設定が使えることを保証するものではありません。コンテキストの欄には最大1M、モデルによって異なると記載されています。この説明と、前述のAPI仕様は分けて考えてください。
本番機能を設計する開発者は、従量課金のAPI使用量や適用されるクレジットを、対話型のサブスクリプションとは別に予算化します。アプリでモデルを選ぶ契約者は、仕事の内容とプランの利用枠で判断します。APIのトークン費用例から、サブスクリプションに何件のコーディング作業が含まれるかは約束できません。
よくある質問
Claude SonnetとHaikuは、どう選べばよいですか?
名前の順番が逆になっても、選び方は変わりません。答えの範囲が狭く、検証できる仕事にはHaikuを、指揮役や幅広い判断が必要な仕事にはSonnetを評価します。モデル名だけでなく、合格基準を満たした成果と、請求対象になったすべての試行を比べてください。
Claude Haiku、Sonnet、Opusの使い分けは?
Haikuは、範囲を限定できる大量処理の低コストな候補です。この比較では、Sonnetを指揮役の候補にしています。AnthropicはClaude Opus 5.5を、長時間にわたるエージェントによるコーディングや知識業務向けと位置付けています。指揮役がまだ合格基準に届かない場合に評価してください。この位置付けは、自社アプリケーションで実測した品質の結果ではありません。モデル一覧。
Claude Sonnet、Opus、Haikuはコーディングでどう使い分けますか?
指揮役とワーカーを別々に選びます。本記事ではSonnetを指揮役に推奨し、Haikuを範囲を限定した根拠収集の候補としています。より難しく、長時間にわたる仕事には、Opusも指揮役の候補になります。最終的に合格基準を満たした変更を評価し、レビュー、再試行、引き継ぎの使用量も請求額に含めてください。
Haiku 4.5とSonnet 5の比較は、この記事と同じですか?
それは旧バージョン同士の比較です。このページの予算と仕様は、Claude Haiku 5.5とClaude Sonnet 5.5を対象にしています。現在の5.5の比較を判断する際に、旧Haikuの料金やコンテキスト上限を使わないでください。
Claude HaikuとSonnetの料金は、どれくらい違いますか?
未キャッシュの入力と出力のトークン数を同じにすると、プロンプトが100,000トークンまでならSonnet 5.5はHaiku 5.5の20倍、それを超えると4倍の料金になります。キャッシュヒットは単価が異なり、有料の書き込みも計算に含める必要があります。現行料金。
Claude Haikuは業務用途で十分に使えますか?
Anthropicが挙げている分類、抽出、ルーティングでは、最初に検討する候補として妥当です。導入前に、失敗すると高くつく自社のケースを検証してください。料金差があるからといって、個別の業務が必要な基準を満たすとは限りません。公式の用途説明。
Claude HaikuはSonnetより速いですか?
Anthropicの比較表のレイテンシー欄では、Haiku 5.5がFastest、Sonnet 5.5がFastとされています。これはベンダーによる区分です。本記事の作成時には、スループット、応答時間、仕事を完了するまでの速度を測定していません。モデル一覧。
Batch APIの割引はHaikuとSonnetの両方に適用されますか?
はい。Anthropicは、両モデルの対象となる入力・出力トークンに50%の割引を提示しています。Batchは非同期のため、完了を待てる仕事に使います。Haikuには引き続き、短いプロンプトと長いプロンプトで別々の料金帯があります。Batch料金。
今週、何から始めますか?
採点できる比較に合格したら、範囲を限定した仕事を一つ移します。 創業者ならチケットのラベル付け、CTOなら要件を限定した文書要約、開発者ならSonnetの指揮役を残したままファイル探索ワーカーから始められます。
合格基準を明文化します
必要な回答、裏付けとなる根拠、レビューが必要になる失敗を定めます。通常の成功例だけでなく、難しい例も含めてください。
完了までの総費用を計算します
各モデルの実際の入力、請求対象の出力、キャッシュへの書き込み、ヒット、再試行を記録します。Haikuのプロンプトごとの料金境界を確認し、委任する仕事では指揮役のレビューも含めます。
処理経路を選び、元に戻せるようにします
合格率と修正費用を考慮しても節約が残る仕事にはHaikuを採用します。大型モデルへの追加費用が成果に見合う仕事ではSonnetを維持するか、Sonnetに引き上げます。プロンプト、effort、業務量が変わったら予算を再確認してください。
選んだ役割に合わせてエージェント環境を準備するには、Claude CodeとCodexのセットアップチェックリストを入手してください。
- 公開日
- カテゴリー
- AI
- 言語
Claude API 料金:Haiku 5.5のコスト比較と移行の判断基準
Claude Haiku 5.5の料金を、Haiku 4.5・Sonnet 5.5と比較します。100,000トークンを超えた際の単価変更、月100万回の分類で$60となる試算、バッチとキャッシュの条件を解説。推論設定や再試行、誤判定の対応費用まで含めて、どの業務を移し、どこにSonnetを残すべきかを判断できます。2026年10月8日AI
AI議事録ツール比較:Otterの代替を用途・料金・連携で選ぶ
AI議事録ツールでOtterを置き換えるなら、用途と利用枠の確認が必要です。Granola、Krisp、MeetGeek、Circleback、Claapを中心に、ボットなしの記録、無料プランの上限、履歴や保存容量、CRM連携を比較。年払いで変わる費用とチームのライセンス数、過去の会議記録を残す移行手順も解説します。2026年10月8日AI
Mistral Large 4の料金と性能:API導入とセルフホストの判断基準
Mistral Large 4のAPI料金、公開記念の50%割引、ベンチマーク、重みの公開予定を整理します。セキュリティや文書業務で試す条件、安価なモデルを継続する条件、重みの公開を待つ条件を解説。具体的な文書処理予算とEUリージョンの制約をもとに、導入費用と検証の進め方を判断できます。2026年10月7日AI
AIエージェント Lindy AIレビュー:料金・使い方と導入前の確認ポイント
AIエージェントLindy AIの料金と使い方を、公開資料に基づいてレビュー。メールの仕分け、返信の下書き、会議準備やフォローアップの設定を解説し、クレジットの消費、課金、承認の適用範囲、停止した仕事の再開まで整理します。Gumloop、n8n、Marblismとの違いから、自社の仕事に合う選び方を確認できます。2026年10月7日AI
Mistral AI 料金ガイド2026:API単価とVibeの月額プランを比較
Mistral AI 料金を、APIのモデル別単価からVibeのFree・Pro・Teamプランまで整理。SmallとMediumの月額試算、キャッシュとBatchの割引、無料枠とAPIクレジット、学生割引、年払い・返金条件、EUリージョンの追加料金と制限を比較し、個人開発者や開発チームに合う選び方を解説します。2026年10月6日AI
Claude Skillsの使い方:週次レポートで学ぶスキルの作成・導入・共有
Claude Skillsで顧客向けの週次レポートを作る方法を、SKILL.mdとPythonスクリプトの具体例で解説します。数値の検証、根拠の扱い、アプリ・Claude Code・APIへの導入、チームでの共有、料金の考え方まで整理。新しい顧客データを毎回渡し、人がレビューできる下書きを作る手順を紹介します。2026年10月6日AI
AIエージェントをAI社員として導入するには?料金比較と30日間の検証
AIエージェントを「AI社員」として導入するなら、最初に任せる仕事と確認担当者を決めましょう。Marblism、Sintra、Viktor、Lindy、Appy.AI、Relevance AIの料金と課金単位を比較し、メール対応、日程調整、サポート、レポート作成を30日間で検証する手順を解説します。2026年10月6日AI