Claude Haiku vs Sonnet: Kosten, Aufgaben und Modellwahl
Claude Haiku vs Sonnet: Preise, lange Dokumente und Coding im Vergleich. Drei Monatsbudgets zeigen, wann Haiku spart und Sonnet die Leitung übernehmen sollte.
Veröffentlicht am
 Von Omid Saffari

Bei Claude Haiku vs Sonnet entscheidet die Aufgabe: Claude Haiku 5.5, das kleine Modell von Anthropic, eignet sich für klar begrenzte Klassifizierungs- und Extraktionsaufgaben. Claude Sonnet 5.5, das größere Allzweckmodell, übernimmt die Leitung beim Programmieren und Entscheidungen, die umfassenderes Urteilsvermögen verlangen. Im hier beschriebenen Szenario zur Ticketklassifizierung beträgt die monatliche Tokenrechnung $16 mit Haiku oder $320 mit Sonnet. Bei Prompts mit mehr als 100,000 Tokens schrumpft Haikus Preisvorteil vom Faktor 20 auf den Faktor vier.
Preise und Spezifikationen am 8. Oktober 2026 geprüft anhand von Anthropics Preisdokumentation, der Modellübersicht und claude.com/pricing. Die Budgets sind berechnete Szenarien mit offengelegten Tokenannahmen, keine Leistungstests. Alle Preise sind in USD angegeben.
Claude Haiku vs Sonnet: Welches Modell passt zur Aufgabe?
Haiku eignet sich für eng umrissene Antworten, die sich prüfen lassen. Sonnet übernimmt die Leitung, wenn es um Interpretation, Koordination und den Umgang mit Fehlschlägen geht. Entscheidend sind akzeptierte Ergebnisse, Promptlänge, wiederverwendbarer Kontext und die Kosten einer Fehlerkorrektur.
- Als Gründer Supporttickets zuordnen: mit Haiku beginnen. Eine Kategorie aus einer festen Liste lässt sich günstig erzeugen und anhand bereits zugeordneter Beispiele leicht bewerten. Ungeklärte Fälle werden weitergegeben, statt für jedes Ticket das größere Modell zu bezahlen.
- Als CTO eines mittelständischen Unternehmens lange Dokumente zusammenfassen: Haiku gewinnt beim Tokenbudget für originalgetreue Extraktion und klar eingegrenzte Zusammenfassungen, sofern die benötigten Fakten erhalten bleiben. Sonnet wird zum nächsten Kandidaten, wenn widersprüchliche Textstellen zusammengeführt oder Konsequenzen erklärt werden müssen. Beide Modelle können lange Eingaben verarbeiten; die Kapazität allein entscheidet die Wahl daher nicht mehr.
- Als Einzelentwickler oder technische Leitung einen Coding-Agenten einsetzen: Sonnet behält die Verantwortung für die gesamte Änderung. Haiku übernimmt kleine Aufgaben, etwa relevante Dateien zu finden, Fehlermeldungen zu extrahieren oder einen begrenzten Diff zusammenzufassen. Gespart wird bei den Teilaufgaben; das leitende Modell prüft weiterhin deren Belege.
Für erfahrene Verantwortliche zählt am Ende, ob der günstigere Weg mehr Korrekturarbeit verursacht. Bei hohem Volumen lohnt sich schon ein Bruchteil eines Cents pro Ticket. Eine zusätzliche Übergabe an einen Menschen kann diese Ersparnis sofort aufbrauchen.
Der folgende API-Vergleich bezieht sich auf Claude Haiku 5.5 und Claude Sonnet 5.5. MTok steht für eine Million Tokens, also die Textbausteine, die ein Modell verarbeitet. Input ist das gesendete Material, Output der erzeugte Inhalt.
Quellen: aktuelle Preisliste und Modellspezifikationen. Cache-Schreibvorgänge sind zusätzliche abgerechnete Inputkategorien; dazu unten mehr.
Haiku vs Sonnet: Welche Tokenpreise bestimmen die Kosten?
Bei ungecachten Tokens ist Haiku in beiden Prompt-Tarifstufen günstiger. Sonnet muss die höhere Rechnung durch ein akzeptiertes Ergebnis, weniger Korrekturarbeit oder einen insgesamt besseren Ablauf rechtfertigen.
Umgerechnet auf 1,000 ungecachte Tokens kostet Haiku in der Stufe für kurze Prompts $0.00010 für Input und $0.00050 für Output, in der Stufe für lange Prompts $0.00050 für Input und $0.00250 für Output. Bei Sonnet sind es $0.002 für Input und $0.010 für Output. Diese Werte ergeben sich aus den veröffentlichten Preisen pro MTok, geteilt durch 1,000. Sie sind nicht der Preis einer erledigten Aufgabe.
Diese Unterscheidung ist wichtig, weil der Output einen großen Teil der Rechnung ausmachen kann. Ein Klassifizierer, der nur eine Kategorie zurückgibt, hat ein anderes Verhältnis von Input zu Output als ein Agent, der eine lange Erklärung schreibt. Auch bei einer Coding-Sitzung können Verlauf und Tool-Ergebnisse spätere Anfragen deutlich größer machen als die ursprüngliche Anweisung.
Die Grafik zeigt die Kosten der drei weiter unten durchgerechneten Aufgaben. Innerhalb jedes Vergleichspaars bleiben die angenommenen Tokenmengen gleich. Beim Coding leitet Sonnet beide Abläufe. Der niedrigere Balken steht deshalb für eine hybride Lösung mit beiden Modellen.
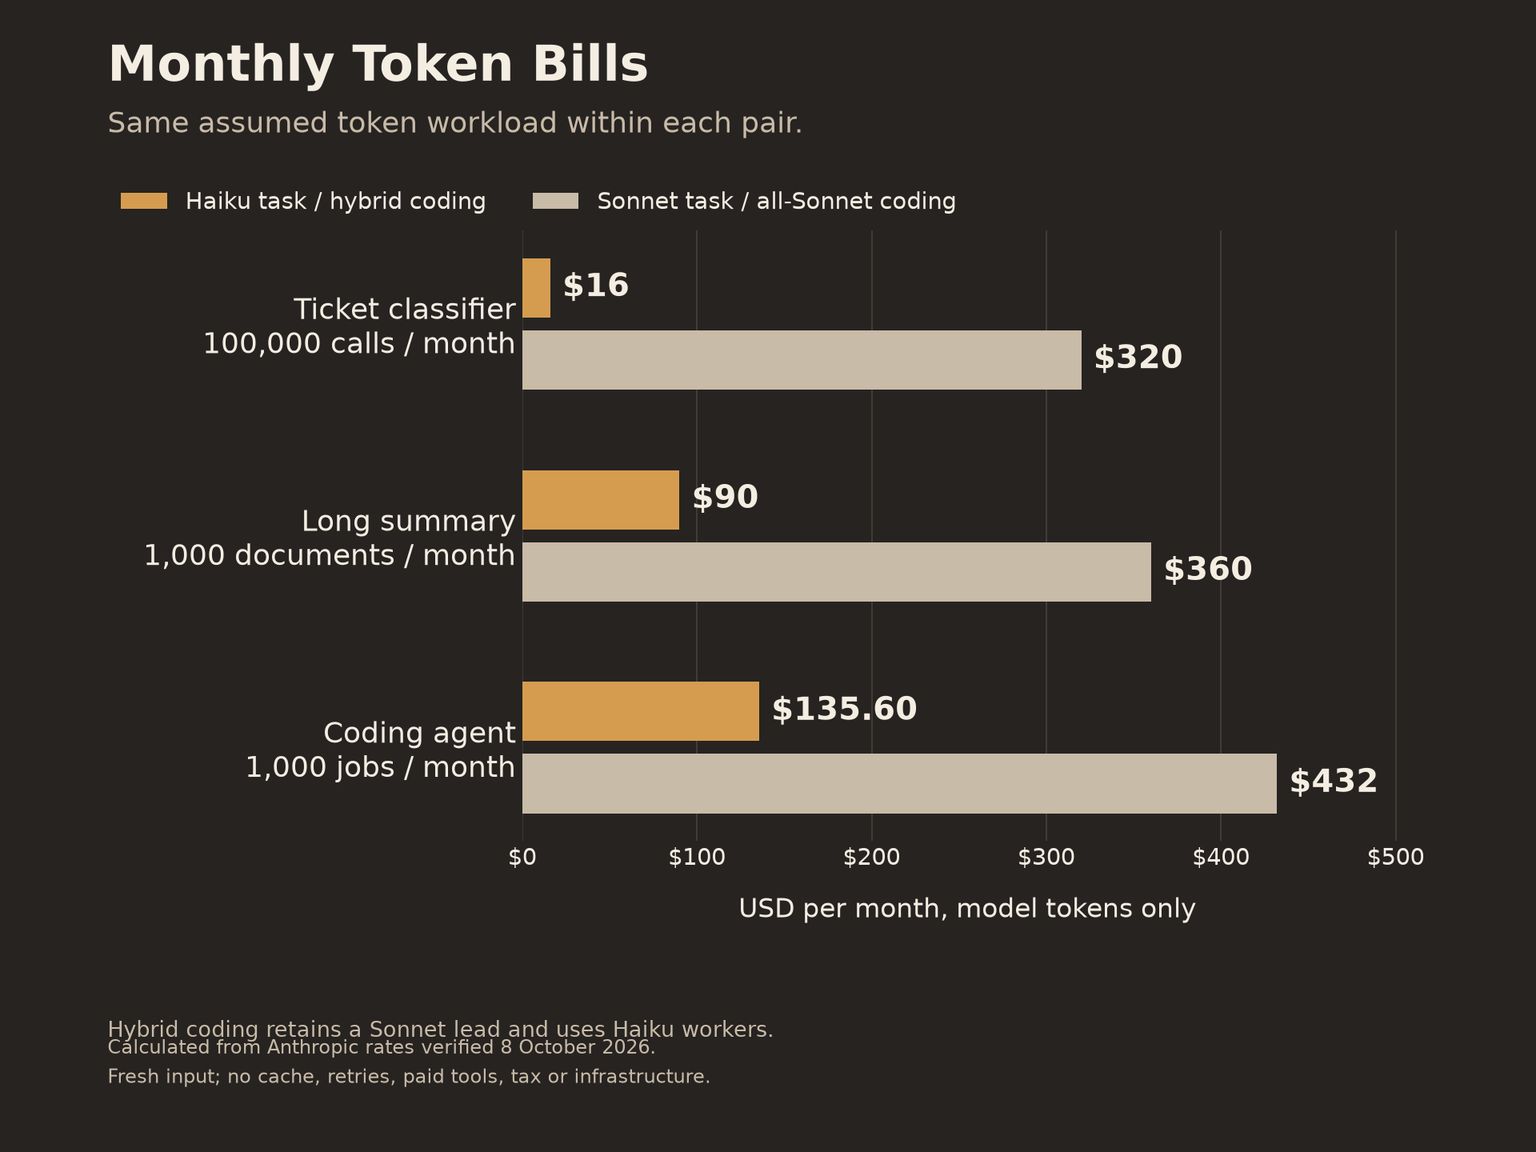
Alle drei Ausgangsrechnungen setzen die regulären Preise der direkt bei Anthropic genutzten API, ungecachten Input und keine Wiederholungsversuche oder separat berechneten serverseitigen Tools voraus. Steuern und Anwendungsinfrastruktur sind nicht enthalten. Die Outputmengen bezeichnen den gesamten abgerechneten Output, der für das Budget angenommen wird. Sie werden nicht aus der kurzen Antwort abgeleitet, die am Ende sichtbar ist. Vor der Budgetplanung für den Produktivbetrieb müssen diese Annahmen durch die tatsächliche Nutzung des jeweiligen Modells ersetzt werden.
Weitere Modelle und Abrechnungseinheiten behandelt der Leitfaden zu den Claude-API-Preisen.
Kontext und Thinking: Gleiche Grenzen, andere Standardeinstellungen
Bei der Kapazität liegen beide gleichauf. Haiku erhält Anthropics schnellere Einstufung; die standardmäßige Reasoning-Einstellung unterscheidet sich. Aus den Spezifikationen lässt sich für keines der Modelle ableiten, ob es die entscheidenden Details eines Dokuments bewahrt oder eine Änderung im Repository erfolgreich abschließt.
Für welche Aufgaben eignet sich Claude Haiku 5.5?
Claude Haiku 5.5 ist das kleine Modell für häufige, präzise definierte Aufgaben. Anthropic beschreibt den Einsatzzweck so: „Für Aufgaben mit hohem Volumen und hohen Anforderungen an die Latenz, etwa Klassifizierung, Extraktion und Routing.“ Bei kurzen Prompts kostet es $0.10 für Input / $0.50 für Output pro MTok, bei längeren Prompts $0.50 / $2.50. Offizielle Positionierung, Preise.
Typische Kandidaten sind ein Supportklassifizierer mit festen Zielkategorien, ein Extraktionssystem, das benannte Felder samt Belegstellen liefert, oder ein Unteragent, der Belege für ein anderes Modell sammelt. Die praktische Grenze setzt die Ergebnisprüfung: Eine formal plausible Antwort, die ein Ticket der falschen Warteschlange zuweist, bleibt falsch. Zeigt die eigene Bewertung bereits, dass Haikus Fehler mehr Korrekturarbeit kosten, als der niedrige Preis spart, eignet sich Haiku für diese Aufgabe nicht.
Der Leitfaden zu Claude Haiku 5.5 behandelt die Einführung des Modells. Dieser Vergleich stellt Haiku und Sonnet bei denselben Aufgaben gegenüber.
Für welche Aufgaben eignet sich Claude Sonnet 5.5?
Claude Sonnet 5.5 ist das Allzweckmodell für Aufgaben, die Geschwindigkeit mit umfassenderem Urteilsvermögen verbinden. Anthropic beschreibt es als „Die beste Kombination aus Geschwindigkeit und Intelligenz.“ Es kostet $2 für Input / $10 für Output pro MTok; Cache-Treffer kosten $0.10 für geeigneten wiederverwendeten Input. Offizielle Positionierung, Preise.
Das leitende Modell beim Coding muss entscheiden, was geändert wird, Belege zusammenführen und auf fehlgeschlagene Schritte reagieren. Für diese Rolle ist es sinnvoll, innerhalb dieses Vergleichs zunächst Sonnet zu prüfen. Sein klarer Nachteil ist die Rechnung: Wer es für jede leicht prüfbare Kategorie einsetzt, zahlt den höheren Preis unabhängig davon, ob die zusätzliche Leistungsfähigkeit hilft. Sonnet gehört dorthin, wo akzeptierte Ergebnisse den Aufpreis rechtfertigen.
Was bringen die gemeinsamen Modellgrenzen in der Praxis?
Beide Modelle bieten 1M Kontext, 128K maximale Ausgabe und adaptives Thinking. Der Kontext ist der verfügbare Arbeitsraum einer Anfrage; die maximale Ausgabe begrenzt die Generierung. Mit adaptivem Thinking kann das Modell seinen Reasoning-Aufwand anpassen. Haikus standardmäßiger API-Effort ist medium, Sonnets high. Beide unterstützen Bildeingaben und die Nutzung von Tools. Modellübersicht.
Für eine technische Leitung, die eine umfangreiche Sammlung von Richtlinien auswertet, entfällt damit ein Kapazitätsunterschied. Auslassungen, Widersprüche und die Beleglage müssen trotzdem geprüft werden. Durch den höheren standardmäßigen Effort entsteht außerdem ein unkontrollierter Budgetunterschied, wenn nur Modellnamen verglichen werden, ohne Einstellungen und abgerechnete Nutzung zu erfassen.
Hier geht es um Herstellerspezifikationen und redaktionelle Auswahlregeln. Ein gemessener Benchmark-Sieger wird nicht behauptet. Auch eine Ranglistenpunktzahl würde weder die Fehlerquote bei den eigenen Ticketkategorien noch die Qualität der fertigen Codeänderung belegen.
Aufgabe 1: Supporttickets klassifizieren
Für geprüfte Warteschlangenkategorien gewinnt Haiku: in diesem Szenario $16 statt $320 pro Monat. Das Modell erhält eine begrenzte Auswahl, seine Antwort wird validiert, und folgenreiche Aktionen bleiben an die Regeln der Anwendung gebunden.
Angenommen, ein SaaS-Unternehmen verarbeitet 100,000 Tickets pro Monat. Jede Klassifizierung verbraucht 1,200 ungecachte Input-Tokens und 80 abgerechnete Output-Tokens, einschließlich Anweisungen und Tickettext. Jeder Prompt bleibt unter 100,000 Tokens. Für beide Modelle werden jeweils dieselben abgerechneten Mengen angenommen.
Das ergibt monatlich 120 Millionen Input-Tokens und 8 Millionen Output-Tokens:
- Haiku: 120 × $0.10 + 8 × $0.50 = $12 + $4 = $16.
- Sonnet: 120 × $2 + 8 × $10 = $240 + $80 = $320.
Pro 1,000 Klassifizierungen kostet das $0.16 mit Haiku oder $3.20 mit Sonnet, berechnet anhand der aktuellen Preise. Die monatliche Tokenersparnis beträgt $304.
Eine brauchbare Aufgabenspezifikation nennt die erlaubten Zielkategorien und enthält eine Kategorie für ungeklärte Fälle. Zuerst wird geprüft, ob die Antwort eine erlaubte Kategorie verwendet. Anschließend lässt sich anhand von Beispielen mit bekannter Lösung bewerten, ob die gewählte Kategorie richtig ist. Die erste Prüfung erkennt ein ungültiges Format, die zweite eine plausible, aber falsche Entscheidung. Bei keiner der beiden Prüfungen muss die Selbsteinschätzung des Modells zur eigenen Sicherheit als Beweis gelten.
Angenommen, 10% der Tickets benötigen einen zusätzlichen Sonnet-Aufruf mit denselben angenommenen Tokenmengen. Der erste Haiku-Versuch wird weiterhin bezahlt: $16 + $32 = $48 pro Monat. Das spart $272 gegenüber Sonnet für jedes Ticket. Die Eskalationsquote ist eine Annahme und kein in diesem Durchlauf beobachtetes Ergebnis.
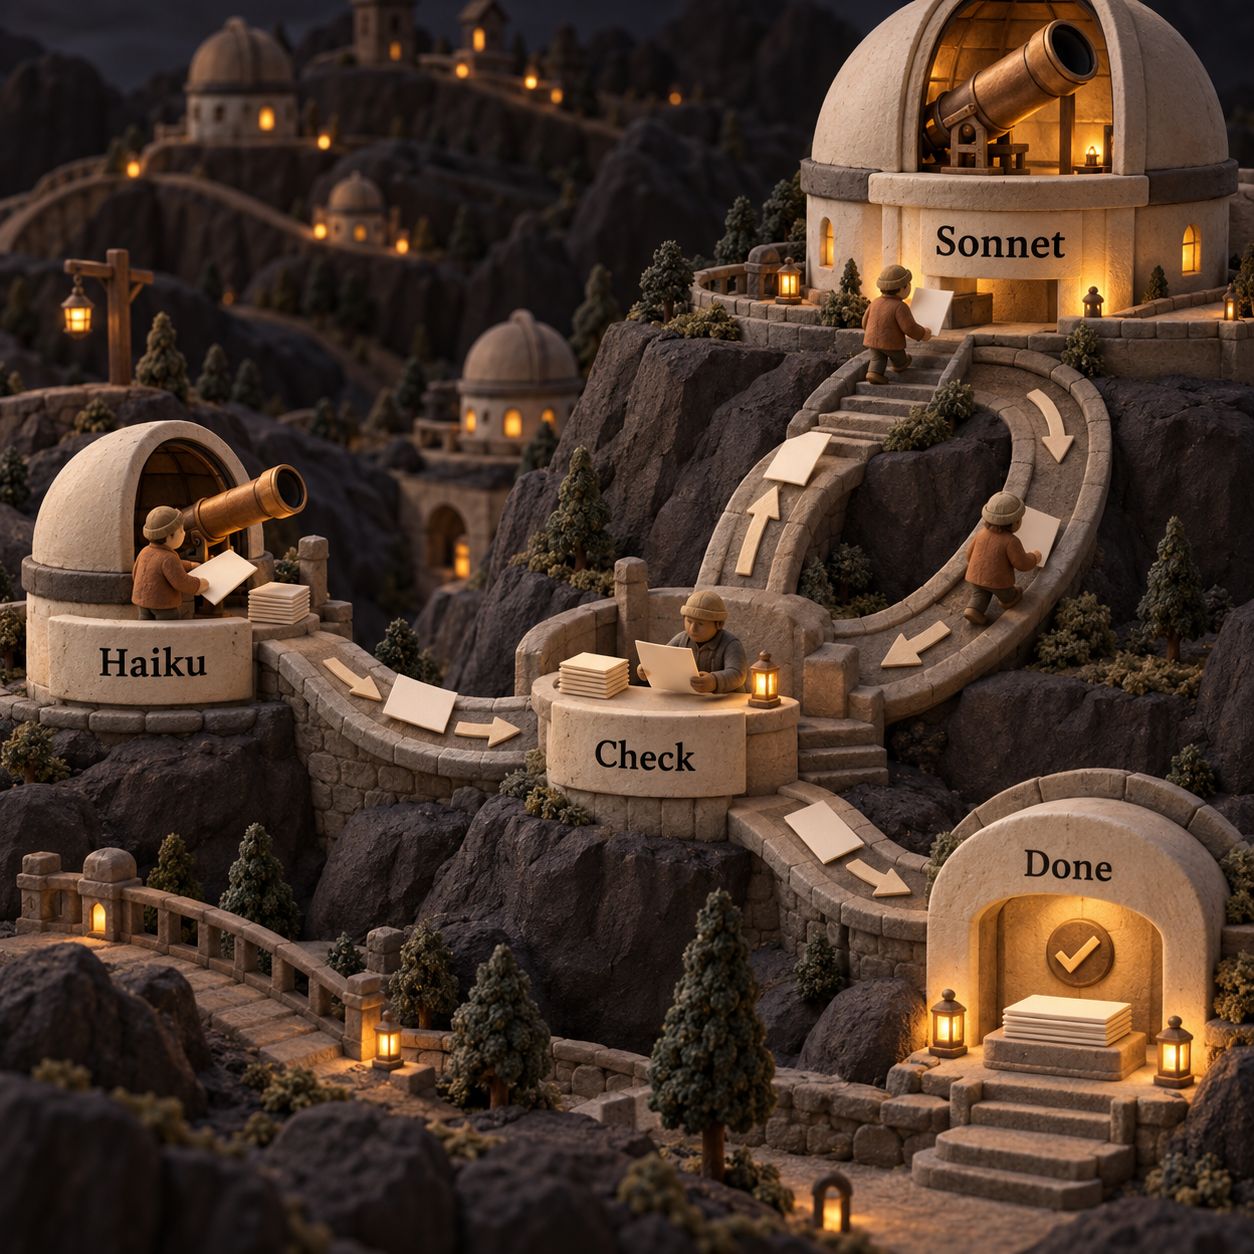
Auch allein aus den Tokenkosten ergibt sich eine Eskalationsgrenze. Beginnt jeder Fall mit Haiku und erhält anschließend ein Anteil e einen Sonnet-Aufruf mit gleicher Tokenmenge, betragen die Kosten H + e × S. Sie entsprechen den Kosten für Sonnet allein bei e = 1 - H/S: 95% Eskalation bei diesen Aufrufen in der Stufe für kurze Prompts oder 75% bei vergleichbaren Aufrufen in Haikus Stufe für lange Prompts. Größere Eskalationsprompts, Wiederholungsversuche und menschliche Prüfung können den günstigeren Weg schon früher unwirtschaftlich machen.
Aufgabe 2: Lange Dokumente mit mehr als 100K Tokens zusammenfassen
Für eine originalgetreue Zusammenfassung, die alle Prüfungen besteht, gewinnt Haiku bei den Tokenkosten. Hier beträgt der Preisabstand den Faktor vier. Sonnet sollte geprüft werden, wenn das Ergebnis Widersprüche interpretieren oder umfassendere Einschätzungen liefern muss, statt die belegten Fakten des Dokuments wiederzugeben.
Angenommen, monatlich werden 1,000 Dokumente verarbeitet. Jede Anfrage verbraucht 150,000 ungecachte Input-Tokens und 6,000 abgerechnete Output-Tokens. Der Input umfasst Dokument und Anweisungen. Jede Anfrage überschreitet Haikus Promptgrenze, daher gilt der höhere Tarif sowohl für Input als auch für Output.
Pro Dokument:
- Haiku: 0.15 × $0.50 + 0.006 × $2.50 = $0.075 + $0.015 = $0.09.
- Sonnet: 0.15 × $2 + 0.006 × $10 = $0.30 + $0.06 = $0.36.
Die monatlichen Gesamtkosten betragen $90 und $360, die Ersparnis $270, berechnet nach den Preisregeln für langen Kontext. Die Aussage, Haiku koste ein Zwanzigstel von Sonnet, gilt für diese Aufgabe nicht.
Die Grenze bezieht sich auf jeden einzelnen Prompt und ist kein monatliches Kontingent. Ein Prompt mit genau 100,000 Tokens fällt unter Haikus niedrigere Preise; für einen längeren Prompt gelten bei dieser Anfrage die höheren Preise. Der höhere Inputpreis darf nicht nur auf die überschüssigen Tokens angewendet werden. Ebenso wenig darf der Output weiter zum Tarif für kurze Prompts berechnet werden.
Für einen internen Projektüberblick muss vorab feststehen, welche Fakten die Zusammenfassung bewahren soll: Entscheidungen, Verantwortliche, Fristen, Ausnahmen und Belegstellen. Diese Felder werden gegen das Dokument geprüft. Soll eine technische Leitung widersprüchliche Anforderungen aus mehreren Dokumenten vergleichen, gehören solche Konfliktfälle in die Bewertung, bevor das günstigere Modell ausgewählt wird.
Ein gekürzter Input kann den niedrigeren Tarif erhalten, sofern die nötigen Belege weiterhin hineinpassen. Ein wahllos aufgeteiltes Dokument kann dagegen genau den Zusammenhang verlieren, den die Zusammenfassung erklären soll. Die sinnvolle Kosteneinheit bleibt die akzeptierte Zusammenfassung, einschließlich etwaiger Korrektur- oder Synthesedurchläufe.
Caching: Wann ist Sonnet günstiger als Haiku ohne Cache?
Dominiert wiederverwendeter Kontext, kann Sonnet günstiger sein als Haiku ohne Cache. Bei gleicher Cache-Nutzung bleibt jedoch Haiku günstiger. Ein Cache-Treffer verwendet bereits verarbeiteten Input erneut. Die neu erzeugte Antwort wird dadurch nicht billiger, und das Speichern des wiederverwendbaren Materials verursacht Schreibkosten.
Sonnets Cache-Treffer kosten $0.10 pro MTok, genauso viel wie Haikus ungecachter Input in der Stufe für kurze Prompts. Haikus eigene Treffer kosten $0.01 in dieser Stufe und $0.05 in der Stufe für lange Prompts. Für Cache-Schreibvorgänge mit fünf Minuten Gültigkeit gelten $2.50 für Sonnet beziehungsweise $0.125 / $0.625 für Haiku in dessen Stufen für kurze und lange Prompts. Cache-Preise.
Ein Vergleich muss dieselbe Abrechnungskategorie verwenden. Wird Sonnets gecachter Input für $0.10 mit Haikus ungecachtem langen Input für $0.50 verglichen, kann Sonnet beim Input günstiger sein, während sein Output weiterhin mehr kostet. Lesen beide aus dem Cache, hat Haiku wieder den niedrigeren Inputpreis.
Ein Beispiel mit Schreibkosten zeigt den Kostenschnittpunkt beim Tokenprofil der langen Zusammenfassung. Angenommen werden 149,000 wiederverwendbare Präfix-Tokens, 1,000 neue Input-Tokens und 6,000 abgerechnete Output-Tokens je Anfrage. Ein Präfix ist der unveränderte Anfang eines Prompts, etwa ein Dokument mit gemeinsamen Anweisungen, der in verschiedenen Anfragen erneut genutzt wird.
Angenommen, auf einen Cache-Schreibvorgang mit fünf Minuten Gültigkeit folgen 27 erfolgreiche Cache-Treffer innerhalb desselben gültigen Cache-Zeitraums:
- Sonnets erste Anfrage: 0.149 × $2.50 + 0.001 × $2 + 0.006 × $10 = $0.4345.
- Jeder weitere Treffer: 0.149 × $0.10 + 0.001 × $2 + 0.006 × $10 = $0.0769.
- Über 28 Anfragen liegt der Durchschnitt bei rund $0.08967, knapp unter Haikus Preis ohne Cache von $0.09 pro Anfrage.
Dieser rechnerische Kostenschnittpunkt gilt nur unter den genannten Bedingungen. Das gemeinsame Material muss für Caching geeignet sein und tatsächlich wiederverwendet werden; weitere Schreibvorgänge sind nicht vorgesehen. Die Rechnung passt nicht zu einem Budget, bei dem jedes Dokument neu ist, die Anfragen zu weit auseinanderliegen oder die gemeinsamen Anweisungen laufend geändert werden.
Bei derselben Cache-Nutzung kostet Haikus erste Anfrage in der Stufe für lange Prompts $0.108625, jeder folgende Treffer $0.02295. Im fairen Vergleich bleibt Haiku bei den Tokenkosten vorn. Caching kann Sonnet dort erschwinglich machen, wo sein Urteilsvermögen den Aufpreis rechtfertigt. Es macht das größere Modell jedoch nicht generell zur günstigeren Wahl.
Bei einem regelmäßig genutzten Dokumentenassistenten sollten Cache-Schreibvorgänge und Treffer getrennt gemessen werden. Eine Prognose, die sämtlichen Input als Cache-Treffer berechnet, übersieht die Anfangskosten und die veränderlichen Promptteile. Auch wenn das Dokument bereits im Cache liegt, gehört der erzeugte Output weiterhin in die Rechnung.
Claude Haiku vs Sonnet beim Coding: Sonnet übernimmt die Leitung
Für die Leitung beim Coding gewinnt Sonnet; für begrenzte, geprüfte Teilaufgaben Haiku. Ein Unteragent ist ein Modell, das innerhalb einer größeren Aufgabe einen kleineren Auftrag erhält. Sinnvoll ist eine Teilaufgabe, deren Belege das leitende Modell prüfen kann. Eine offene Änderung am Repository sollte nicht vollständig an den Unteragenten abgegeben werden.
Angenommen werden monatlich 1,000 Coding-Aufgaben. Jede Aufgabe umfasst:
- Ein leitendes Sonnet-Modell mit insgesamt 30,000 ungecachten Input-Tokens und 6,000 abgerechneten Output-Tokens.
- Acht Unteragenten, jeweils mit insgesamt 12,000 ungecachten Input-Tokens und 1,500 abgerechneten Output-Tokens.
Diese Annahmen beziehen sich auf die gesamte Nutzung über alle Anfragen der jeweiligen Rolle hinweg. Jeder einzelne Prompt bleibt unter 100,000 Tokens. Tool-Beschreibungen, Verlauf, Belege der Unteragenten und die abschließende Prüfung durch das leitende Modell sind in diesen Mengen enthalten. Für die reine Sonnet-Lösung und den hybriden Ablauf wird dieselbe Nutzung des leitenden Modells angenommen; zusätzliche Übergabe-Tokens oder Wiederholungsversuche würden den Vergleich verändern.
Nach den aktuellen API-Preisen kostet das leitende Modell $0.12 pro Aufgabe. Ein Haiku-Unteragent kostet $0.00195, acht zusammen also $0.01560. Ein Sonnet-Unteragent kostet $0.039, acht zusammen $0.312.
Hybrid: $0.12 + $0.01560 = $0.13560 pro Aufgabe oder $135.60 pro Monat.
Durchgehend Sonnet: $0.12 + $0.312 = $0.432 pro Aufgabe oder $432 pro Monat.
Die berechnete Ersparnis beträgt $296.40 pro Monat beziehungsweise 68.6%. Die Gesamtrechnung sinkt nicht um den Faktor 20, weil das leitende Sonnet-Modell weiterhin bezahlt wird. Das Szenario belegt weder gleiche Codequalität noch eine gemessene Beschleunigung.
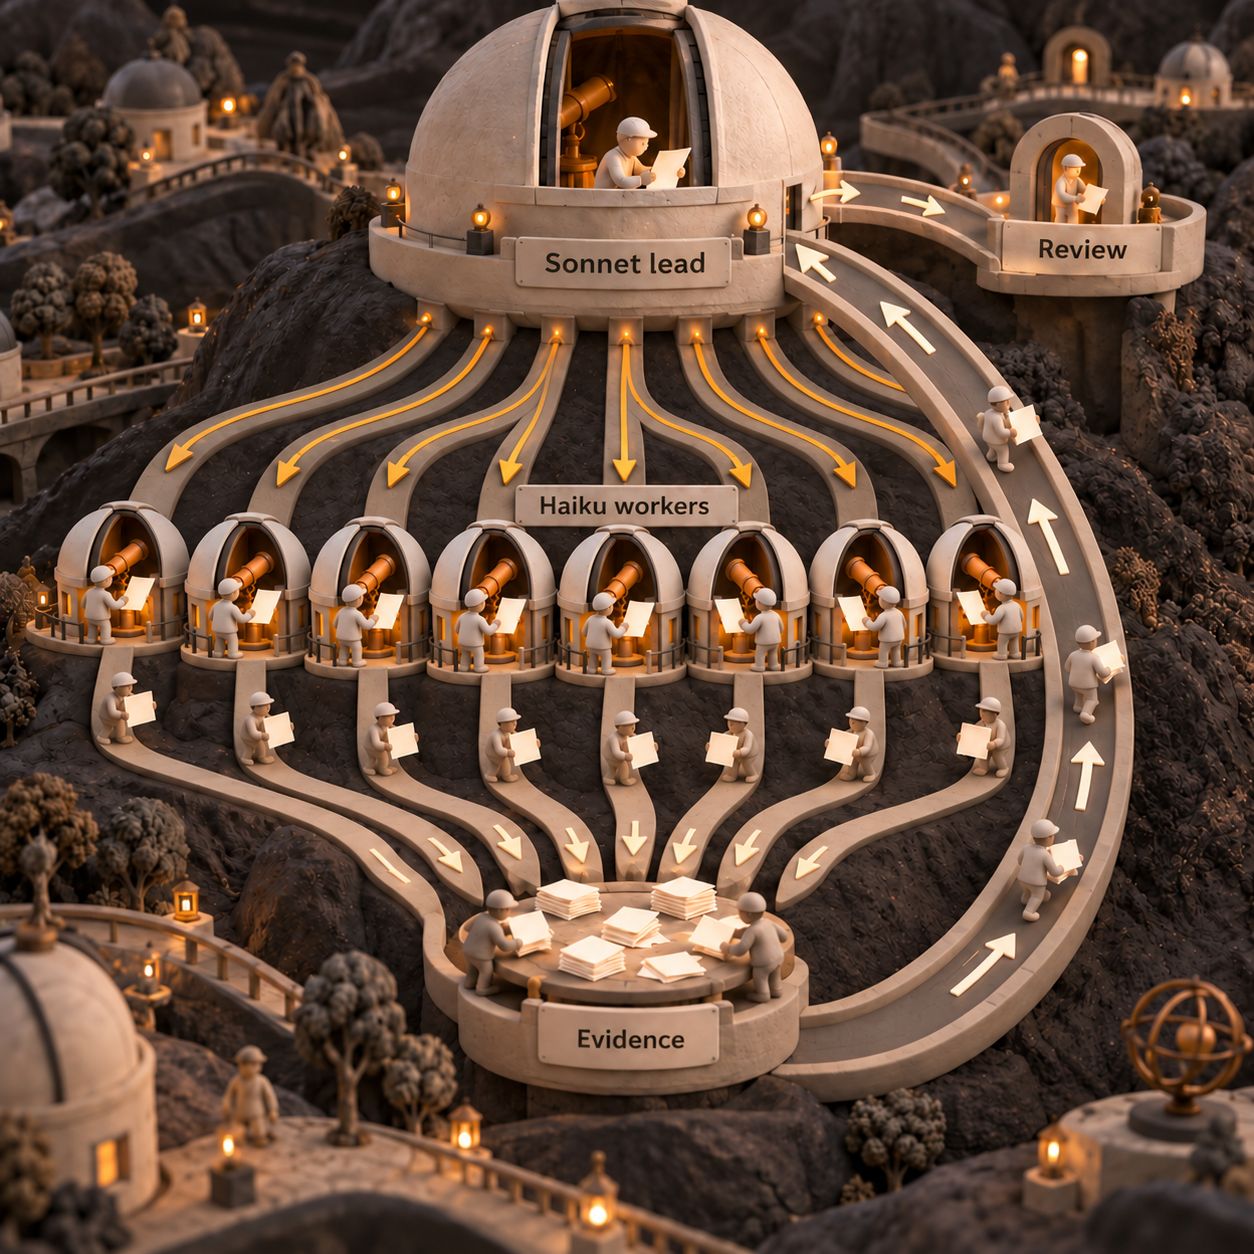
Eine passende Aufgabenspezifikation könnte lauten: Dateien finden, die auf eine benannte Funktion verweisen, Dateipfade und relevante Auszüge zurückgeben sowie Unsicherheiten kennzeichnen. Eine andere könnte verlangen, die Fehlerausgabe einer bestimmten fehlgeschlagenen Prüfung zusammenzufassen. Das leitende Modell entscheidet anhand der Belege, was geändert wird. Das ist eine Empfehlung für die Anwendungsarchitektur und keine Behauptung, in diesem Durchlauf sei die Implementierung der Unteragenten in Claude Code getestet worden.
Die Übergabe ist die mögliche Schwachstelle. Eine knappe Zusammenfassung kann genau die Ausnahme auslassen, die das leitende Modell benötigt. Eine ungeprüfte Behauptung kann aus einem günstigen Unteragenten eine teure Fehländerung machen. Deshalb müssen Quellenverweise erhalten bleiben und genügend Originalmaterial mitgegeben werden, damit das leitende Modell die Antwort prüfen kann. Wiederholte Arbeit gehört ebenfalls ins hybride Budget.
Eine Delegation lohnt sich nicht, wenn die vermeintlich kleine Teilaufgabe nahezu denselben Repository-Kontext benötigt wie das leitende Modell oder die Prüfung der Übergabe mehr kostet als die direkte Bearbeitung. Bei eng zusammenhängenden Änderungen kann durchgehend Sonnet trotz höherer Tokenrechnung zum günstigeren akzeptierten Ergebnis führen.
Von Sonnet zu Haiku wechseln – oder umgekehrt
Zuerst die klar begrenzte Aufgabe umstellen, dann den gesamten abgeschlossenen Ablauf vergleichen. Innerhalb der Claude API kann ein großer Teil der Integration erhalten bleiben. Ein geänderter Modellname belegt aber noch kein gleichwertiges Ausgabeverhalten.
Die Modell-IDs lauten claude-haiku-5-5 und claude-sonnet-5-5 und stehen in der Modellübersicht. Prompt, Validierungsregeln, repräsentative Eingaben und akzeptierte Antworten sollten in einer reproduzierbaren Fassung vorliegen. Zu erfassen sind Modell, Effort, Tokennutzung, Promptlänge, Cache-Verhalten und die Zahl der Versuche pro abgeschlossener Aufgabe.
Ein Wechsel von Sonnet zu Haiku bietet sich für einen Klassifizierer oder Unteragenten mit klarer Aufgabenspezifikation an. Vor einer Ausweitung der Nutzung müssen Format, Faktenbelege und besonders kostspielige Fehlerfälle geprüft werden. Die Aufgabe sollte sich einfach wieder auf Sonnet zurückstellen lassen.
Ein Wechsel von Haiku zu Sonnet ist sinnvoll, wenn Korrektur- oder Koordinationskosten die Ersparnis bereits übersteigen. Dieselben Beispiele sollten erhalten bleiben, damit sich feststellen lässt, ob das größere Modell die ausschlaggebenden Fehler tatsächlich behebt. Eine eleganter formulierte Antwort ist kein Beleg für Richtigkeit.
Auch der Entwicklungsaufwand gehört ins Budget. Eine beispielhafte vierstündige Migration bei angenommenen $100 pro Stunde kostet $400. Gemessen an der monatlichen Tokenersparnis von $304 beim Klassifizierer wäre dieser Betrag nach rund 1.3 Monaten wieder eingespart, noch ohne Bewertungs- und Vorfallkosten. Bei nur 100 Klassifizierungen im Monat spart dasselbe Tokenprofil $0.304 monatlich. Für diese Ersparnis gibt es kaum einen wirtschaftlichen Grund, einen funktionierenden Ablauf umzubauen.
Ein Wechsel allein wegen der Preisliste lohnt sich nicht bei geringem Aufgabenvolumen, bei Ergebnissen, die umfassenderes Urteilsvermögen verlangen, oder wenn das Ersatzmodell eine weitere Prüfstufe nötig macht. Prompts, Belege und Prüfungen sollten übertragbar bleiben, damit die Entscheidung bei künftigen Preis- oder Fähigkeitsänderungen umkehrbar ist.
Welche Modelle sind in den Claude-Tarifen verfügbar?
Haiku und Sonnet sind in den gängigen Claude-Tarifen aufgeführt. Der Zugang im Abonnement ist jedoch eine andere Frage als die Tokenabrechnung der API. Claude Opus und Claude Fable sind weitere Modellfamilien in Anthropics Angebot. Sie werden hier genannt, um den Tarifzugang zu erklären; der Kostenvergleich bleibt auf Haiku und Sonnet beschränkt. Der am 8. Oktober 2026 geprüfte Tarifvergleich auf claude.com nennt:
- Free: Haiku und Sonnet; Opus und Fable sind als nicht verfügbar gekennzeichnet.
- Pro: Haiku, Sonnet und Opus; bei Fable steht Nutzungsguthaben.
- Max 5x und Max 20x: Haiku, Sonnet und Opus; bei Fable steht 50% des Wochenlimits.
- Team: Haiku, Sonnet und Opus; bei Fable steht 50% des Wochenlimits für Premium-Lizenzen.
- Enterprise, sowohl bei direkter Buchung als auch über den Vertrieb: Haiku, Sonnet, Opus und Fable sind als verfügbar gekennzeichnet.
Die Tariftabelle nennt Modellfamilien. Sie garantiert nicht, dass jedes Konto dieselbe konkrete 5.5-Version oder identische Produkteinstellungen anbietet. In der Kontextzeile steht bis zu 1M, je nach Modell. Diese Aussage ist getrennt von den oben beschriebenen API-Spezifikationen zu betrachten.
Wer ein Feature für den Produktivbetrieb entwickelt, sollte verbrauchsabhängige API-Nutzung und gegebenenfalls verfügbare Guthaben getrennt vom interaktiven Abonnementzugang budgetieren. Bei der Modellwahl in der App zählen dagegen Aufgabe und Tarifkontingent. Ein Tokenbeispiel für die API kann nicht versprechen, wie viele Coding-Aufgaben ein Abonnement abdeckt.
Häufige Fragen zu Haiku und Sonnet
Claude Sonnet vs Haiku: Welches Modell wählen?
Auch bei umgekehrter Reihenfolge der Namen gilt dieselbe Auswahlregel. Haiku ist für eng umrissene Aufgaben mit prüfbaren Antworten zu bewerten, Sonnet für die Leitung oder Fälle, die umfassenderes Urteilsvermögen verlangen. Maßgeblich sind akzeptierte Ergebnisse und sämtliche abgerechneten Versuche, nicht allein die Modellnamen.
Claude Haiku vs Sonnet vs Opus: Wo liegen die Unterschiede?
Haiku ist der günstige Kandidat für klar begrenzte Aufgaben mit hohem Volumen; Sonnet ist in diesem Vergleich der Kandidat für die Leitung. Anthropic positioniert Claude Opus 5.5 für lang laufendes agentisches Coding und Wissensarbeit. Es sollte geprüft werden, wenn das leitende Modell die Akzeptanzkriterien weiterhin verfehlt. Diese Positionierung ist kein gemessenes Qualitätsergebnis für die eigene Anwendung. Modellübersicht.
Claude Sonnet vs Opus vs Haiku: Welche Rollen passen beim Coding?
Leitung und Unteragenten werden getrennt ausgewählt. Hier wird Sonnet für die Leitung empfohlen, Haiku für begrenzte Aufgaben zur Belegsammlung und Opus als weiterer Leitungskandidat für schwierigere, lang laufende Arbeit. Bewertet wird die abschließende akzeptierte Änderung. Prüfung, Wiederholungsversuche und Tokennutzung für Übergaben gehören in die Rechnung.
Haiku 4.5 vs Sonnet 5: Ist dieser Vergleich noch maßgeblich?
Das ist ein Vergleich älterer Versionen. Die Budgets und Spezifikationen auf dieser Seite beziehen sich auf Claude Haiku 5.5 und Claude Sonnet 5.5. Ein älterer Haiku-Preis oder eine frühere Kontextgrenze darf nicht als Entscheidungsgrundlage für den aktuellen 5.5-Vergleich dienen.
Claude Haiku vs Sonnet: Wie groß ist der Preisunterschied?
Bei identischen Mengen ungecachten Inputs und Outputs kostet Sonnet 5.5 für Prompts mit bis zu 100,000 Tokens das 20-Fache von Haiku 5.5, bei längeren Prompts das Vierfache. Für Cache-Treffer gelten andere Preise; kostenpflichtige Schreibvorgänge müssen einbezogen werden. Aktuelle Preise.
Reicht Claude Haiku für geschäftliche Aufgaben aus?
Für Klassifizierung, Extraktion und Routing, die von Anthropic genannten Aufgaben, ist es ein sinnvoller erster Kandidat. Vor der Einführung sind Prüfungen für die eigenen kostspieligen Fehlerfälle nötig. Der Preisabstand beweist nicht, dass eine bestimmte geschäftliche Aufgabe diese Anforderungen erfüllt. Offizielle Positionierung.
Ist Claude Haiku schneller als Sonnet?
Anthropic bezeichnet Haiku 5.5 in der vergleichenden Latenzzeile als „Fastest“ und Sonnet 5.5 als „Fast“, also als „am schnellsten“ beziehungsweise „schnell“. Das sind Herstellerangaben. In diesem Durchlauf wurden weder Durchsatz noch Antwortzeit oder die Geschwindigkeit vollständig erledigter Aufgaben gemessen. Modellübersicht.
Gilt der Batch-API-Rabatt für Haiku und Sonnet?
Ja. Anthropic nennt für beide Modelle einen Rabatt von 50% auf geeignete Input- und Output-Tokens. Batch arbeitet asynchron und eignet sich deshalb für Aufgaben, die warten können. Haikus getrennte Tarifstufen für kurze und lange Prompts gelten weiterhin. Batch-Preise.
Was lässt sich diese Woche sinnvoll umstellen?
Eine klar begrenzte Aufgabe umstellen, sobald sie einen bewerteten Vergleich bestanden hat. Für Gründer bieten sich Ticketkategorien an, für technische Leitungen eine eingegrenzte Dokumentenzusammenfassung und für Entwickler ein Unteragent zum Auffinden von Dateien, während Sonnet die Leitung behält.
Akzeptanzkriterien festlegen
Die erforderliche Antwort, die nötigen Belege und die Fehlerfälle benennen, die eine Prüfung auslösen. Schwierige Beispiele gehören ebenso dazu wie Routinefälle, die bereits funktionieren.
Die vollständige Aufgabe kalkulieren
Für jedes Modell tatsächlichen Input, abgerechneten Output, Cache-Schreibvorgänge, Treffer und Wiederholungsversuche erfassen. Haikus Grenze pro Prompt prüfen und bei delegierten Aufgaben die Prüfung durch das leitende Modell einbeziehen.
Den Ablauf wählen und den Rückweg offenhalten
Haiku dort einsetzen, wo Akzeptanz und Korrekturkosten seine Ersparnis bewahren. Sonnet beibehalten oder dorthin eskalieren, wo das größere Modell seinen Aufpreis rechtfertigt. Das Budget erneut prüfen, sobald sich Prompt, Effort oder Arbeitslast ändern.
Die Checkliste zur Einrichtung von Claude Code und Codex hilft, das Agenten-Setup anhand der gewählten Rollen zu planen.
- Veröffentlicht
- Kategorie
- AI
- Sprache
Claude Haiku 5.5: Wann sich der günstigere Tarif rechnet
Claude Haiku 5.5 im Kostenvergleich: Preise, die 100K-Promptgrenze und eine Beispielrechnung mit Haiku 4.5 und Sonnet 5.5. Wann lohnt sich der Wechsel?8. Okt. 2026AI
KI-Meeting-Protokoll: Welche Otter-Alternative passt?
Otter-Alternativen für KI-Meeting-Protokolle: Granola, Krisp, MeetGeek, Circleback und Claap nach Preisen, Gratislimits, Aufnahme ohne Bot und CRM vergleichen.8. Okt. 2026AI
Mistral Large 4: Was es kostet und wann es sich lohnt
Mistral Large 4 im Überblick: API-Preise, Einführungsrabatt und Benchmarks. Wann sich die Preview lohnt und wer auf die Modellgewichte warten sollte.7. Okt. 2026AI
KI-Assistent Lindy AI: Was er kann und was er kostet
KI-Assistent Lindy AI im Überblick: Preise, Credit-Verbrauch, E-Mails, Meetings und Freigabegrenzen – mit Einordnung von Gumloop, n8n und Marblism.7. Okt. 2026AI
Mistral API Pricing 2026: API-Kosten und Vibe im Überblick
Mistral-Preise für API und Vibe: Modellkosten, Gratislimits, EU-Hosting und eine Monatsrechnung im Vergleich. Geprüft im Oktober 2026, alle Preise in USD.6. Okt. 2026AI
Claude Skills im Einsatz: Kundenberichte automatisieren
Claude Skills erstellen, installieren und im Team teilen: Anleitung für wöchentliche Kundenberichte mit geprüften Kennzahlen und menschlicher Prüfung.6. Okt. 2026AI
KI-Agenten als Mitarbeiter: Kosten, Tools und Einstieg
KI-Agenten als digitale Mitarbeiter: Aufgaben, Preise und Grenzen von sechs Tools. So gelingt der Einstieg mit klaren Zuständigkeiten und einem 30-Tage-Pilot.6. Okt. 2026AI