Claude API 가격 비교: Haiku와 Sonnet의 업무별 선택 기준
Claude API 가격을 기준으로 Haiku 5.5와 Sonnet 5.5를 비교합니다. 고객 지원 티켓 분류, 긴 문서 요약, 코딩 서브에이전트의 월 비용을 같은 토큰 조건으로 계산하고, 캐싱과 오류 수정 비용까지 고려해 업무에 맞는 모델을 고르는 기준을 설명합니다.
게시일
 작성자 Omid Saffari

Claude API 가격을 기준으로 Haiku와 Sonnet을 비교할 때는 맡길 업무부터 정해야 합니다. Anthropic의 소형 모델인 Claude Haiku 5.5는 범위가 명확한 분류·추출 작업에, 더 큰 범용 모델인 Claude Sonnet 5.5는 코딩을 주도하거나 폭넓은 판단이 필요한 작업에 적합합니다. 이 글에서 가정한 고객 지원 티켓 분류 작업의 월 토큰 비용은 Haiku가 $16, Sonnet이 $320입니다. 프롬프트가 100,000토큰을 초과하면 Haiku의 가격 이점은 20배에서 4배로 줄어듭니다.
가격과 사양은 2026년 10월 8일 확인했습니다. 기준 자료는 Anthropic 가격 문서, 모델 개요, claude.com/pricing입니다. 아래 예산은 명시한 토큰 사용량을 바탕으로 계산한 시나리오이며, 성능 테스트 결과가 아닙니다. 가격은 모두 USD입니다.
Claude API 가격 비교: Haiku와 Sonnet 중 무엇을 고를까요?
답을 검증할 수 있고 범위가 좁은 작업에는 Haiku를, 해석·조율·실패 복구까지 맡을 리드 에이전트에는 Sonnet을 선택합니다. 판단 기준은 검증을 통과한 결과, 프롬프트 길이, 재사용 가능한 컨텍스트, 오류를 수정하는 데 드는 비용입니다.
- 고객 지원 티켓을 분배하는 창업자라면: Haiku부터 검토합니다. 정해진 처리 큐 중 하나를 고르는 라벨은 생성 비용이 낮고, 정답 라벨을 붙인 예제로 정확성을 평가하기도 쉽습니다. 모든 티켓에 큰 모델의 비용을 쓰기보다, 해결하지 못한 사례만 상위 모델로 넘깁니다.
- 긴 문서를 요약하는 중견 기업 CTO라면: 필요한 사실을 빠뜨리지 않는다는 조건에서, 원문에 충실한 추출과 범위가 정해진 요약은 Haiku가 토큰 예산에 유리합니다. 서로 충돌하는 대목을 조정하거나 그 영향을 설명해야 한다면 다음 후보로 Sonnet을 검토합니다. 두 모델 모두 긴 입력을 처리할 수 있으므로, 이제 입력 용량만으로 선택할 수는 없습니다.
- 코딩 에이전트를 운영하는 개인 개발자나 엔지니어링 리드라면: 전체 변경 작업은 Sonnet이 주도하게 합니다. Haiku에는 관련 파일 찾기, 실패 메시지 추출, 범위가 정해진 diff 요약 같은 작은 일을 맡깁니다. 워커에서 비용을 줄이되, 리드 에이전트가 워커의 근거를 계속 검토해야 합니다.
운영 책임자가 마지막으로 확인할 것은 저렴한 경로가 수정 작업을 늘리는지입니다. 티켓 한 건에서 아끼는 돈이 센트 단위에도 못 미치더라도 대량 처리에서는 의미가 있습니다. 하지만 사람이 한 번 더 인계받아야 한다면 그 절감액은 바로 사라질 수 있습니다.
아래 API 비교는 Claude Haiku 5.5와 Claude Sonnet 5.5를 기준으로 합니다. MTok는 모델이 처리하는 텍스트 단위인 토큰 백만 개를 뜻합니다. 입력은 모델에 보내는 내용이고, 출력은 모델이 생성하는 내용입니다.
출처: 현재 요금표, 모델 사양. 캐시 쓰기는 별도로 과금되는 입력 항목이며, 아래에서 설명합니다.
Haiku와 Sonnet 비용 차이: 실제 청구액을 결정하는 단가
캐시를 쓰지 않은 토큰의 단가는 짧은 프롬프트와 긴 프롬프트 구간 모두 Haiku가 낮습니다. Sonnet의 높은 비용은 검증을 통과한 결과, 줄어든 수정 작업, 더 나은 전체 워크플로로 정당화되어야 합니다.
캐시를 쓰지 않은 토큰 1,000개로 환산하면 Haiku는 짧은 프롬프트 구간에서 입력 $0.00010, 출력 $0.00050, 긴 프롬프트 구간에서 입력 $0.00050, 출력 $0.00250입니다. Sonnet은 입력 $0.002, 출력 $0.010입니다. 이는 공개된 MTok당 단가를 1,000으로 나눈 값이며, 작업 하나를 완료하는 가격은 아닙니다.
출력 비중에 따라 청구액이 크게 달라질 수 있어 이 구분이 중요합니다. 라벨 하나를 반환하는 분류기와 긴 설명을 작성하는 에이전트의 입력·출력 구성은 다릅니다. 코딩 세션에서도 대화 이력과 툴 결과가 쌓이면 나중 요청은 처음 지시보다 커질 수 있습니다.
아래 차트는 이어서 살펴볼 세 작업의 비용입니다. 각 비교 쌍에는 같은 토큰 수를 가정했습니다. 코딩 비교에서는 두 워크플로 모두 Sonnet이 리드를 맡으므로, 낮은 막대는 전부 Haiku를 쓰는 에이전트가 아니라 혼합 구성입니다.
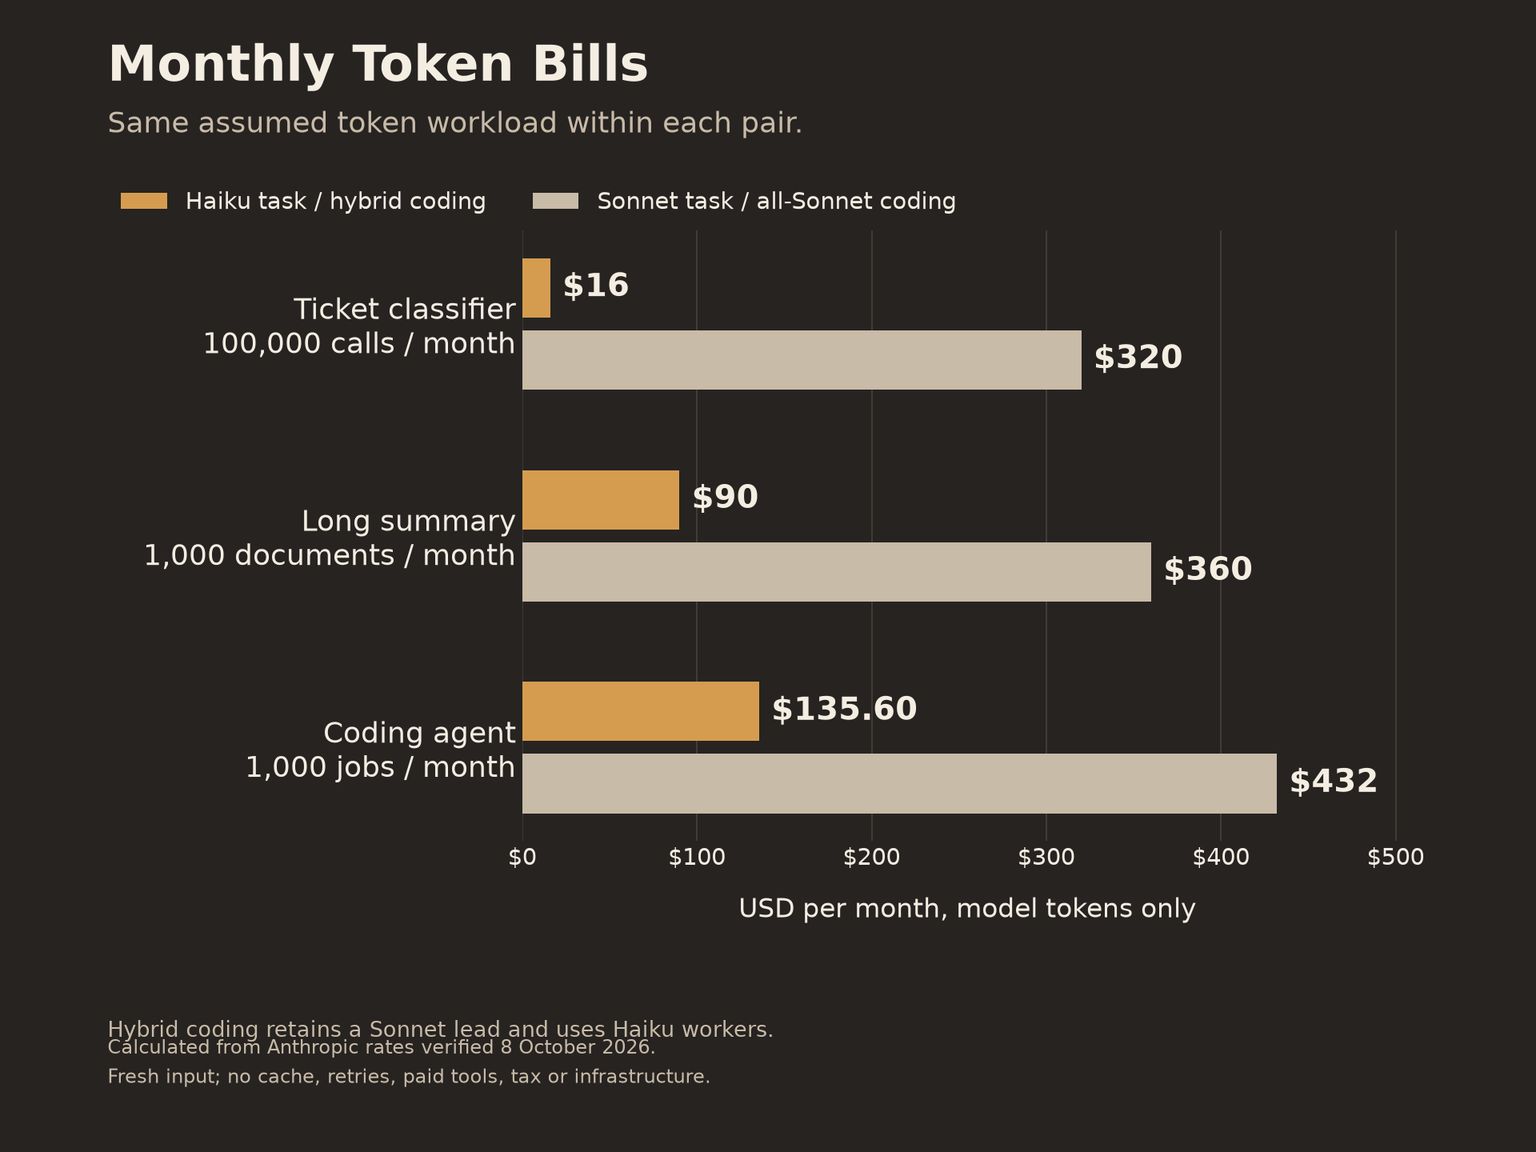
세 기본 시나리오 모두 Anthropic 직접 제공 API의 표준 요금, 캐시를 쓰지 않은 입력, 재시도와 별도 과금되는 서버 툴이 없는 조건을 가정합니다. 세금과 애플리케이션 인프라는 제외합니다. 출력 토큰 수는 사용자에게 보이는 짧은 답변에서 추정한 값이 아니라, 예산 계산에 가정한 총 청구 출력량입니다. 운영 예산을 정하기 전에 이 가정을 각 모델의 실제 사용량으로 바꿔야 합니다.
전체 모델 라인업과 다른 과금 항목은 Claude API 가격 가이드를 참고합니다.
컨텍스트와 추론: 한도는 같고 기본 설정은 다릅니다
용량은 같고, Anthropic의 상대 속도 표기는 Haiku가 앞서며, 기본 추론 설정은 다릅니다. 어느 모델의 사양도 문서에서 필요한 세부 사항을 보존하거나 저장소 변경을 완료한다는 증거가 되지는 않습니다.
Claude Haiku 5.5는 어떤 작업에 적합할까요?
Claude Haiku 5.5는 자주 실행하고 요구사항이 명확한 작업에 검토할 소형 모델입니다. Anthropic은 **"For high-volume, latency-sensitive tasks such as classification, extraction, and routing."**라고 설명합니다. 즉, 분류·추출·라우팅처럼 처리량이 많고 지연 시간에 민감한 작업을 위한 모델입니다. 짧은 프롬프트의 MTok당 단가는 입력 $0.10 / 출력 $0.50이며, 긴 프롬프트에서는 $0.50 / $2.50로 올라갑니다. 공식 용도 설명, 요금.
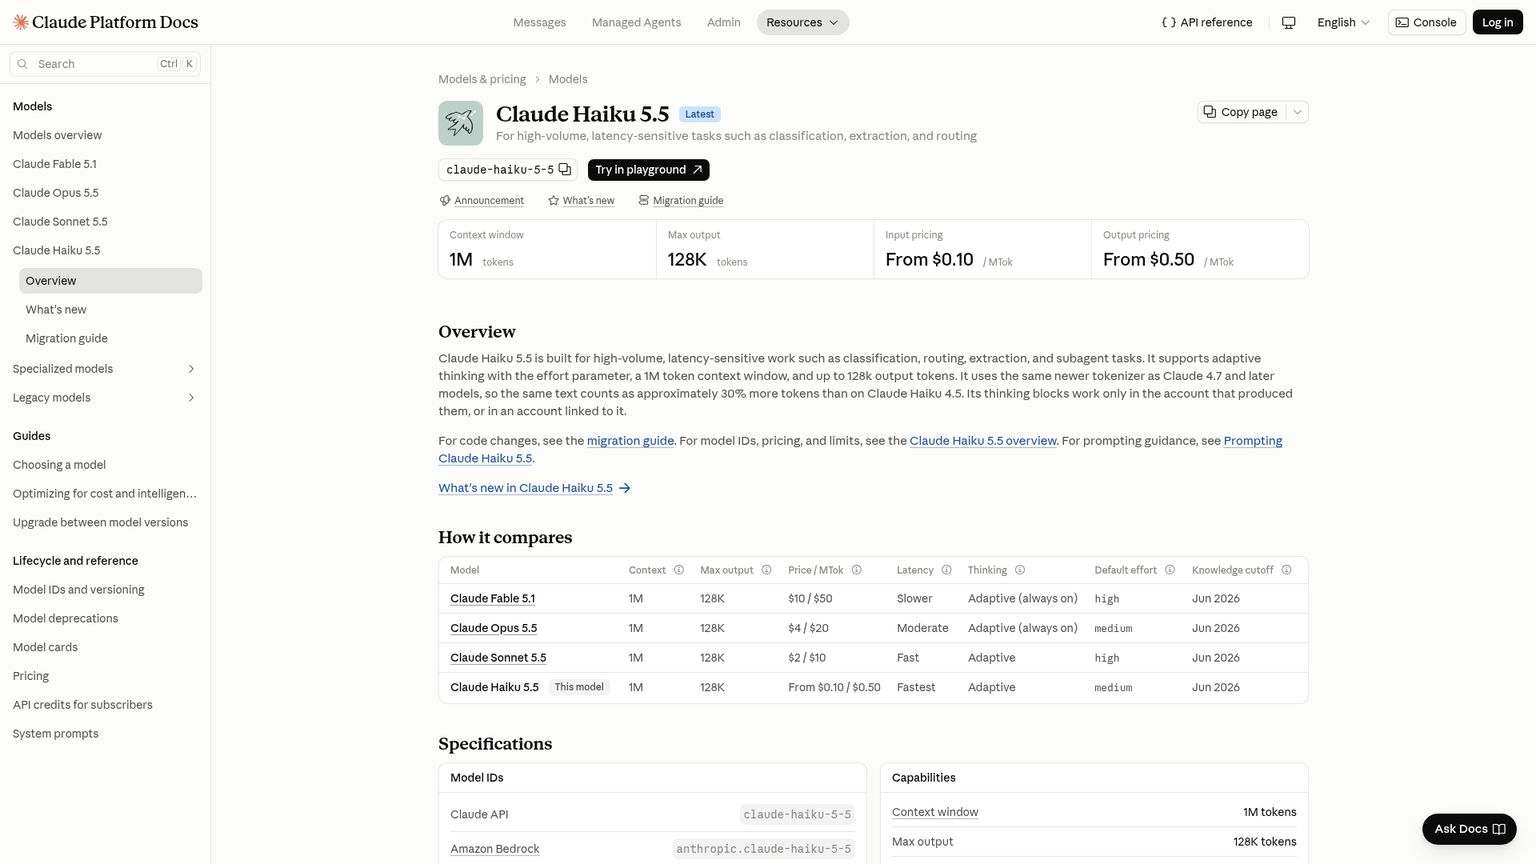
정해진 대상 중 하나를 선택하는 고객 지원 분류기, 지정된 필드와 근거 대목을 반환하는 추출기, 다른 모델을 위해 근거를 수집하는 워커에 적합합니다. 실무에서 관건은 결과 검증입니다. 형식상 멀쩡한 답변이라도 잘못된 큐로 보냈다면 오답입니다. 이미 평가에서 오류 수정 비용이 가격 절감액보다 크다고 드러난 작업에는 Haiku를 쓰지 않는 편이 좋습니다.
Claude Haiku 5.5 가이드는 이 모델의 도입 판단을 다룹니다. 이 글은 같은 작업을 Haiku와 Sonnet에 맡길 때의 비용을 비교합니다.
Claude Sonnet 5.5는 어떤 작업에 적합할까요?
Claude Sonnet 5.5는 속도와 폭넓은 판단을 함께 요구하는 작업에 검토할 범용 모델입니다. Anthropic은 "The best combination of speed and intelligence.", 즉 속도와 지능을 가장 잘 결합한 모델이라고 소개합니다. MTok당 입력 $2 / 출력 $10이며, 캐시 적용이 가능한 재사용 입력의 캐시 적중 단가는 $0.10입니다. 공식 용도 설명, 요금.
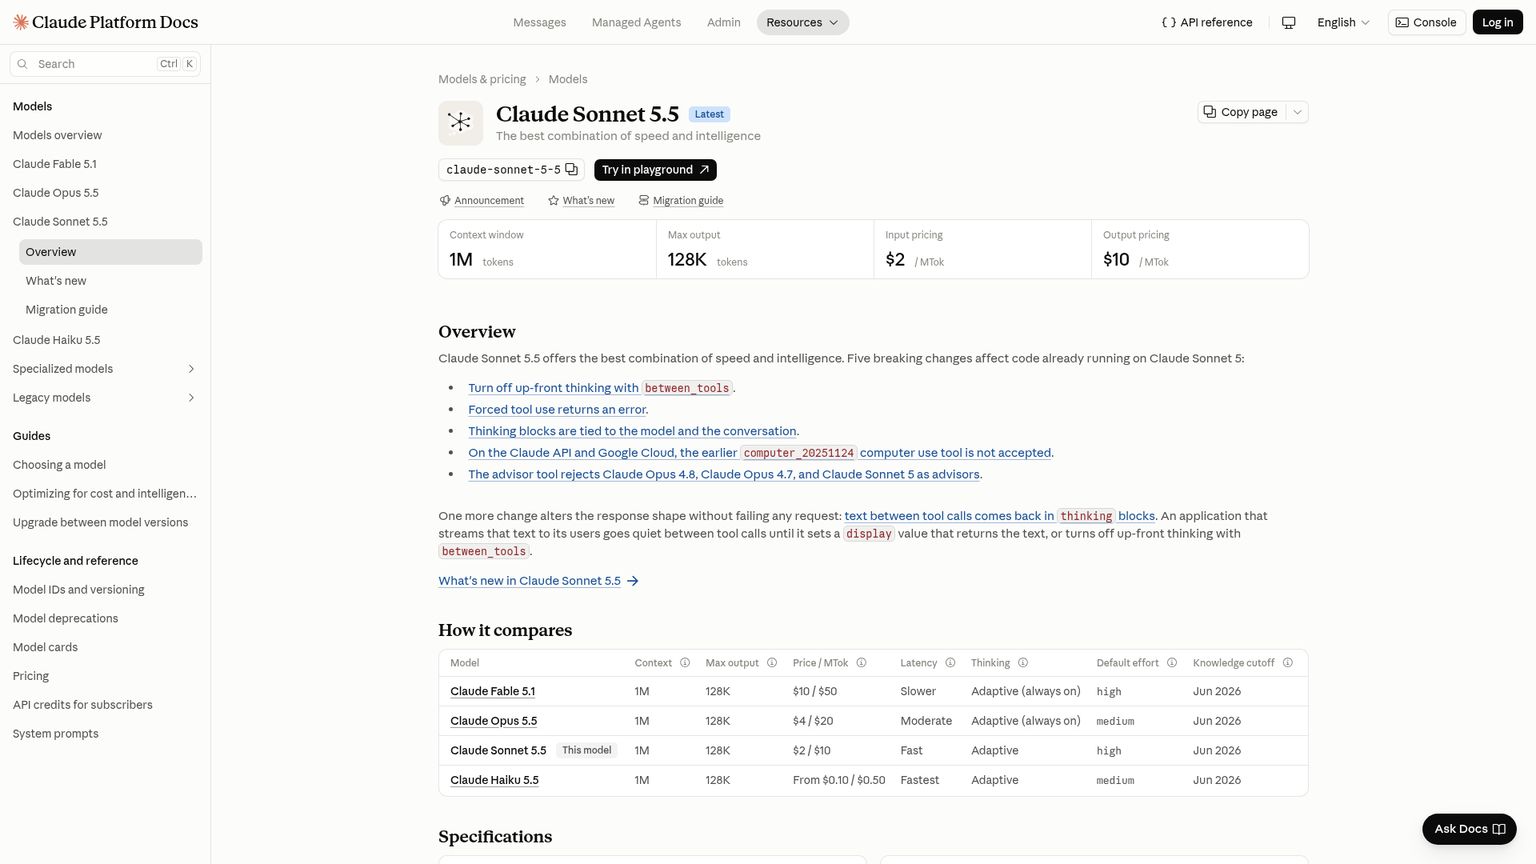
코딩 리드의 역할에는 변경할 부분을 결정하고, 근거를 종합하고, 실패한 단계를 처리하는 일이 포함됩니다. 이 두 모델 중에서 그런 역할을 고른다면 Sonnet부터 평가하는 것이 합리적입니다. 분명한 약점은 비용입니다. 쉽게 검증할 수 있는 라벨까지 전부 Sonnet에 맡기면, 추가 능력이 도움이 되는지와 관계없이 높은 단가를 지불합니다. 검증을 통과한 결과가 추가 비용을 정당화하는 곳에 배치합니다.
공통 사양만으로 알 수 있는 것은 어디까지일까요?
두 모델 모두 1M 컨텍스트, 128K 최대 출력, 적응형 추론을 제공합니다. 컨텍스트는 요청 하나에 사용할 수 있는 작업 공간이며, 최대 출력은 생성량의 상한입니다. 적응형 추론은 모델이 추론을 조절하게 합니다. Haiku의 API 기본 effort는 medium, Sonnet은 high입니다. 두 모델 모두 이미지 입력과 툴 사용을 지원합니다. 모델 개요.
많은 정책 문서를 검토하는 CTO에게 동일한 컨텍스트 한도는 용량 차이가 없다는 뜻입니다. 누락, 모순, 출처의 뒷받침을 확인할 필요까지 없어지는 것은 아닙니다. 기본 effort도 다르므로, 설정과 청구 사용량을 기록하지 않고 모델 이름만 비교하면 예산에 영향을 주는 차이를 통제하지 못합니다.
이 내용은 공급업체 사양과 편집상의 선택 기준입니다. 측정된 벤치마크 승자를 주장하지 않습니다. 리더보드 점수만으로 특정 티켓 분류의 오류율이나 최종 코드 변경의 품질을 알 수는 없습니다.
작업 1: 고객 지원 티켓 분류
검증 가능한 큐 라벨을 고르는 작업은 이 시나리오에서 Haiku가 월 $16으로, Sonnet의 $320보다 유리합니다. 모델의 선택 범위를 제한하고 응답을 검증하며, 중요한 결과를 초래하는 조치는 애플리케이션 규칙으로 통제합니다.
SaaS 기업이 매월 티켓 100,000건을 처리한다고 가정합니다. 분류 한 건에는 지시와 티켓 본문을 포함해 캐시를 쓰지 않은 입력 1,200토큰과 청구 출력 80토큰을 사용합니다. 각 프롬프트는 100,000토큰 미만입니다. 두 모델 모두에 같은 청구 토큰 수를 각각 가정합니다.
월 사용량은 입력 120 MTok, 출력 8 MTok입니다.
- Haiku: 120 × $0.10 + 8 × $0.50 = $12 + $4 = $16.
- Sonnet: 120 × $2 + 8 × $10 = $240 + $80 = $320.
현재 단가로 계산한 분류 1,000건당 비용은 Haiku $0.16, Sonnet $3.20입니다. 월 토큰 비용 절감액은 $304입니다.
분류 규칙에는 허용하는 처리 대상과 미해결 대상을 명시하는 것이 좋습니다. 응답이 허용된 라벨을 사용하는지 검증한 다음, 정답이 있는 예제에서 올바른 라벨을 골랐는지 평가합니다. 앞의 검사는 형식 오류를 잡고, 뒤의 평가는 그럴듯하지만 틀린 판단을 잡습니다. 어느 쪽도 모델이 스스로 제시한 확신도를 증거로 받아들일 필요는 없습니다.
티켓의 10%에 Sonnet 호출 한 번이 추가로 필요하다고 가정하고, 그 호출에도 같은 토큰 수를 적용합니다. 처음 Haiku를 호출한 비용도 지불하므로 월 비용은 $16 + $32 = $48이며, 모든 티켓에 Sonnet을 쓰는 것보다 $272를 아낍니다. 이 전환 비율은 가정이며, 이번 작업에서 관측한 결과가 아닙니다.
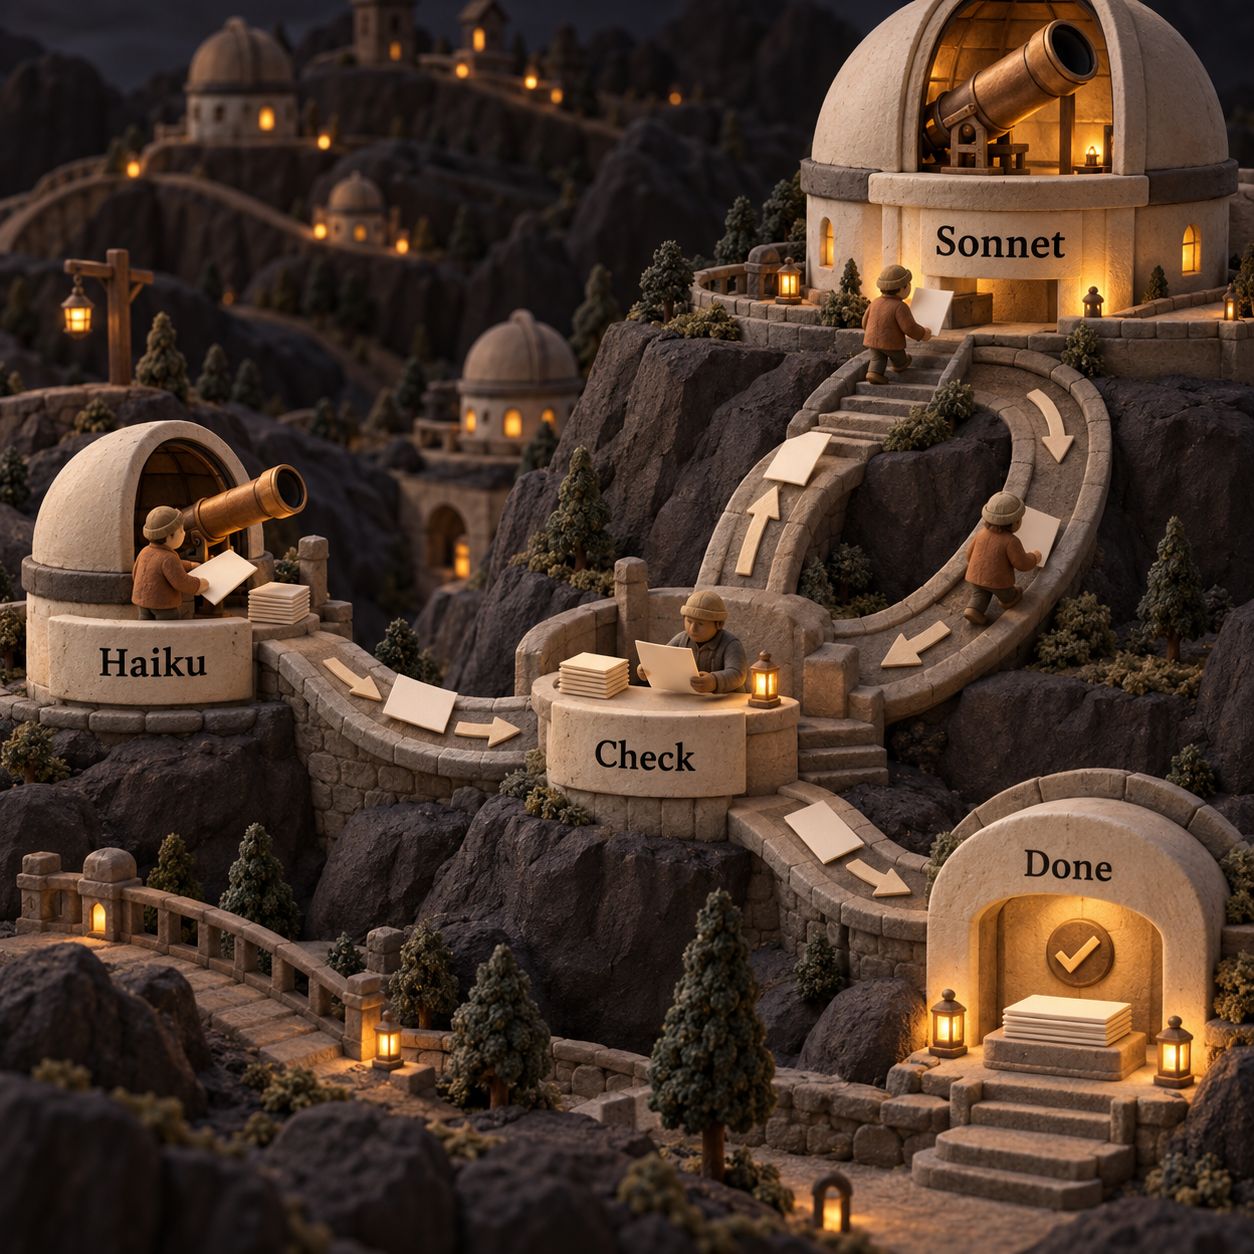
토큰 비용만으로 계산한 전환 한계도 있습니다. 모든 사례를 Haiku로 시작하고, 그중 비율 e에 같은 토큰 수의 Sonnet 호출을 추가하면 비용은 H + e × S입니다. e = 1 - H/S에서 Sonnet만 쓰는 비용과 같아집니다. 이 짧은 프롬프트 조건에서는 전환 비율 95%, Haiku의 긴 프롬프트 구간에서 같은 토큰 수로 비교하면 **75%**입니다. 상위 모델로 넘기는 프롬프트가 더 크거나, 재시도와 사람의 검토가 필요하면 저렴한 경로가 더 일찍 불리해질 수 있습니다.
작업 2: 100K를 초과하는 긴 문서 요약
검증을 통과하는 충실한 요약이라면 토큰 비용은 Haiku가 유리하며, 여기서는 4배 차이가 납니다. 원문이 뒷받침하는 사실을 재현하는 것에 더해 충돌을 해석하거나 폭넓은 판단이 필요한 결과물이라면 Sonnet을 평가할 만합니다.
매월 문서 1,000개를 처리하고, 요청마다 캐시를 쓰지 않은 입력 150,000토큰과 청구 출력 6,000토큰을 사용한다고 가정합니다. 입력에는 문서와 지시를 포함합니다. 모든 요청이 Haiku의 프롬프트 기준을 초과하므로, 입력과 출력 모두 높은 단가를 적용합니다.
문서 한 개의 비용은 다음과 같습니다.
- Haiku: 0.15 × $0.50 + 0.006 × $2.50 = $0.075 + $0.015 = $0.09.
- Sonnet: 0.15 × $2 + 0.006 × $10 = $0.30 + $0.06 = $0.36.
긴 컨텍스트 요금 규칙에 따른 월 합계는 $90과 $360, 절감액은 $270입니다. 이 작업에는 Haiku가 Sonnet 가격의 20분의 1이라는 설명을 적용할 수 없습니다.
기준은 월간 계정 사용량이 아니라 각 프롬프트의 길이입니다. 정확히 100,000토큰인 프롬프트는 Haiku의 낮은 단가가 적용되며, 더 긴 프롬프트는 해당 요청에 높은 단가가 적용됩니다. 기준을 초과한 입력 토큰에만 높은 가격을 적용하거나, 출력은 짧은 프롬프트 단가로 계산해서는 안 됩니다.
내부 프로젝트 브리프를 작성하는 운영 담당자라면 요약에 반드시 남겨야 할 사실을 정합니다. 의사결정, 담당자, 기한, 예외, 근거 대목이 그 대상입니다. 해당 항목을 원문과 대조합니다. 여러 문서의 일관되지 않은 요구사항을 비교하는 CTO라면, 저렴한 모델을 고르기 전에 이런 충돌 사례도 평가에 포함합니다.
필요한 근거가 모두 들어간다는 조건에서 입력을 줄이면 낮은 요금 구간을 유지할 수 있습니다. 문서를 무작정 나누면 요약에서 설명해야 할 관계를 놓칠 수 있습니다. 기준은 여전히 검증을 통과한 요약이며, 수정이나 종합을 위한 추가 처리 비용까지 포함해야 합니다.
캐싱하면 Sonnet이 캐시 없는 Haiku보다 저렴해질까요?
재사용 컨텍스트가 대부분을 차지하면 Sonnet이 캐시 없는 Haiku보다 저렴해질 수 있지만, 같은 캐시 패턴에서는 여전히 Haiku가 저렴합니다. 캐시 적중은 이미 처리한 입력을 재사용하는 것입니다. 새로 생성하는 답변에는 할인이 적용되지 않으며, 재사용할 내용을 저장하는 쓰기 비용이 발생합니다.
Sonnet의 캐시 적중 단가는 MTok당 $0.10으로, Haiku의 짧은 프롬프트 구간에서 캐시를 쓰지 않은 입력 단가와 같습니다. Haiku의 캐시 적중 단가는 짧은 프롬프트 구간 $0.01, 긴 프롬프트 구간 $0.05입니다. 유효 기간 5분의 캐시 쓰기 단가는 Sonnet $2.50, Haiku는 짧은/긴 프롬프트 구간 각각 $0.125 / $0.625입니다. 캐시 요금.
비교할 때는 과금 항목을 맞춰야 합니다. Sonnet의 캐시 입력 $0.10과 Haiku의 캐시 없는 긴 입력 $0.50을 비교하면 입력은 Sonnet이 유리할 수 있지만, 출력은 여전히 더 비쌉니다. 두 모델 모두 캐시에서 읽으면 다시 Haiku의 입력 단가가 더 낮습니다.
긴 문서 요약의 토큰 구성을 사용해 캐시 쓰기까지 포함한 비용 역전 조건을 계산해 보겠습니다. 요청마다 재사용 가능한 접두부 149,000토큰, 새 입력 1,000토큰, 청구 출력 6,000토큰을 가정합니다. 접두부는 문서와 공통 지시처럼 여러 요청에서 바뀌지 않고 재사용하는 프롬프트 앞부분입니다.
유효 기간 5분의 캐시에 한 번 쓰고, 같은 유효 기간 안에 캐시 적중이 27회 성공한다고 가정합니다.
- Sonnet의 첫 요청: 0.149 × $2.50 + 0.001 × $2 + 0.006 × $10 = $0.4345.
- 이후 캐시 적중 요청마다: 0.149 × $0.10 + 0.001 × $2 + 0.006 × $10 = $0.0769.
- 요청 28회의 평균은 약 $0.08967로, 캐시 없는 Haiku의 요청당 $0.09보다 조금 낮습니다.
이는 조건부 산술 계산에서 나타나는 비용 역전입니다. 공유 내용이 캐싱 대상이고 실제로 재사용되며, 추가 쓰기가 없다고 가정합니다. 문서가 매번 새롭거나, 요청 간격이 너무 길거나, 공통 지시가 계속 바뀌는 예산에는 맞지 않습니다.
Haiku에도 같은 캐시 패턴을 적용하면 긴 프롬프트 구간의 첫 요청은 $0.108625, 이후 캐시 적중 요청은 $0.02295입니다. 조건을 맞추면 여전히 토큰 비용은 Haiku가 유리합니다. 캐싱은 Sonnet의 판단 능력에 추가 비용을 지불할 가치가 있는 작업에서 부담을 줄여 주지만, 큰 모델을 모든 경우에 더 저렴한 선택으로 만들지는 않습니다.
반복해서 쓰는 문서 어시스턴트라면 캐시 쓰기와 적중을 따로 측정합니다. 모든 입력을 캐시 적중 단가로 계산한 예측은 초기 비용과 프롬프트에서 바뀌는 부분을 놓칩니다. 문서 자체가 이미 캐시되어 있어도 생성 출력은 계산에 포함해야 합니다.
Haiku와 Sonnet으로 코딩하기: 리드는 Sonnet에 맡깁니다
코딩 리드는 Sonnet, 범위가 정해져 있고 검증 가능한 워커 작업은 Haiku를 권합니다. 서브에이전트는 큰 작업 안에서 더 작은 일을 맡는 모델입니다. 워커에게 범위가 열려 있는 저장소 변경 전체를 맡기기보다, 리드가 근거를 검토할 수 있는 부분을 위임합니다.
매월 코딩 작업 1,000건을 가정합니다. 각 작업의 구성은 다음과 같습니다.
- Sonnet 리드의 총 사용량은 캐시를 쓰지 않은 입력 30,000토큰과 청구 출력 6,000토큰입니다.
- 워커 여덟 개가 각각 캐시를 쓰지 않은 입력 12,000토큰과 청구 출력 1,500토큰을 사용합니다.
이는 각 역할이 여러 요청에서 사용하는 총량에 대한 가정입니다. 개별 프롬프트는 모두 100,000토큰 미만입니다. 이 총량에 툴 설명, 이력, 워커가 전달한 근거, 리드의 최종 검토를 포함합니다. 전부 Sonnet을 쓰는 구성과 혼합 구성에서 리드 사용량이 같다고 가정하며, 추가 인계 토큰이나 재시도가 발생하면 비교 결과가 바뀝니다.
현재 API 단가로 리드 비용은 작업당 $0.12입니다. Haiku 워커 한 개는 $0.00195, 여덟 개는 $0.01560입니다. Sonnet 워커 한 개는 $0.039, 여덟 개는 $0.312입니다.
혼합 구성: $0.12 + $0.01560 = 작업당 $0.13560, 월 $135.60.
전부 Sonnet 구성: $0.12 + $0.312 = 작업당 $0.432, 월 $432.
계산한 절감액은 **월 $296.40, 비율로는 68.6%**입니다. Sonnet 리드 비용을 계속 지불하므로 전체 청구액이 20배 줄지는 않습니다. 이 시나리오는 코드 품질이 같거나 실제 속도가 빨라졌다는 것을 입증하지 않습니다.
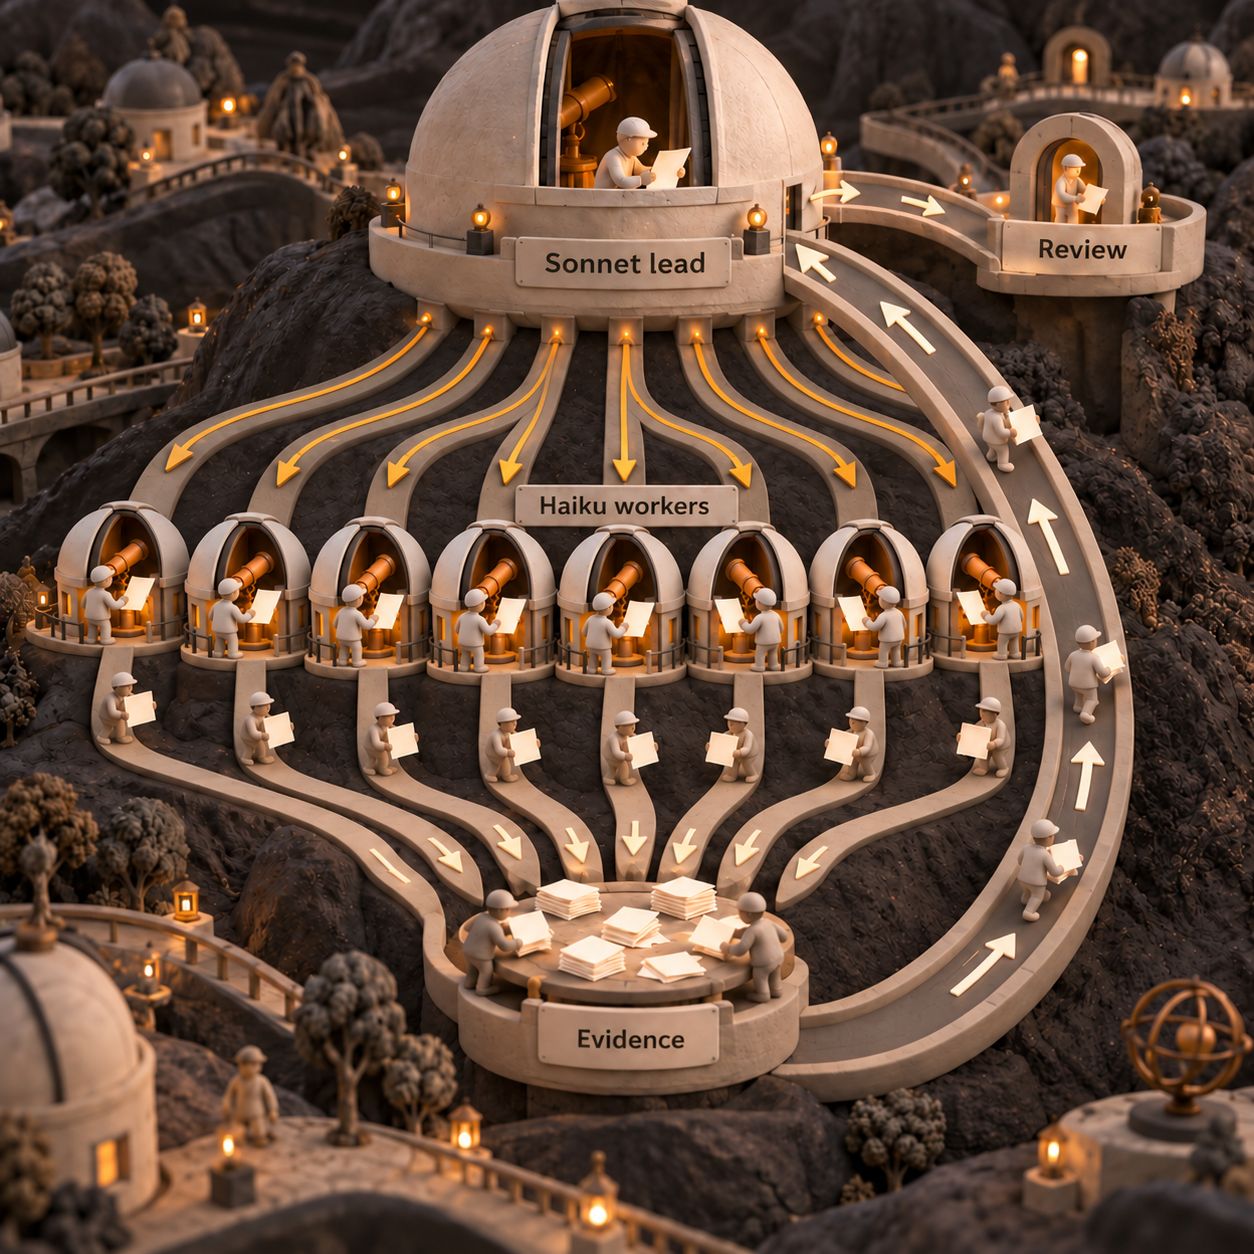
워커의 작업 규칙은 특정 함수 이름을 참조하는 파일을 찾고, 파일 경로와 관련 대목을 반환하며, 불확실한 부분을 표시하도록 정할 수 있습니다. 지정한 실패 검사에서 나온 오류 출력을 요약하게 할 수도 있습니다. 리드는 그 근거로 무엇을 바꿀지 결정합니다. 이는 애플리케이션 구조에 대한 권고이며, 이번 작업에서 Claude Code의 서브에이전트 구현을 실제로 실행했다는 뜻은 아닙니다.
취약한 지점은 인계입니다. 짧게 압축한 요약에서 리드에게 필요한 예외가 빠질 수 있고, 검증하지 않은 주장은 저렴한 워커가 비용이 많이 드는 잘못된 수정을 하게 만들 수 있습니다. 출처 참조를 남기고, 리드가 워커의 답을 확인할 수 있도록 충분한 원자료를 전달합니다. 반복한 작업도 혼합 구성의 예산에 포함합니다.
작다고 생각한 일이 리드와 거의 같은 저장소 컨텍스트를 필요로 하거나, 인계 내용을 검토하는 비용이 직접 수행하는 비용보다 크다면 위임하지 않는 편이 좋습니다. 서로 긴밀하게 연결된 변경에서는 토큰 청구액이 높더라도 전부 Sonnet을 쓰는 편이 검증을 통과한 결과를 더 저렴하게 얻는 방법일 수 있습니다.
Sonnet에서 Haiku로, 또는 Haiku에서 Sonnet으로 전환하려면
범위가 좁은 작업부터 바꾼 다음, 완료된 워크플로 전체를 비교합니다. Claude API 안에서 전환하면 기존 연동의 상당 부분을 유지할 수 있지만, 모델 이름만 바꿨다고 출력 동작이 같아지는 것은 아닙니다.
모델 개요에 나온 모델 ID는 claude-haiku-5-5와 claude-sonnet-5-5입니다. 프롬프트, 검증 규칙, 대표 입력, 검증을 통과한 답변을 재현 가능한 형태로 보관합니다. 완료한 작업마다 모델, effort, 토큰 사용량, 프롬프트 길이, 캐시 동작, 시도 횟수를 기록합니다.
Sonnet에서 Haiku로 바꾸는 것은 요구사항이 명확한 분류기나 워커에서 합리적입니다. 트래픽을 늘리기 전에 형식, 사실을 뒷받침하는 근거, 비용이 큰 실패 사례를 확인합니다. 해당 작업을 Sonnet으로 쉽게 되돌릴 수 있게 합니다.
Haiku에서 Sonnet으로 바꾸는 것은 이미 수정이나 조율 비용이 절감액을 넘어설 때 합리적입니다. 같은 예제를 유지해 큰 모델이 전환의 원인이 된 실패를 해결하는지 확인합니다. 더 매끄러운 답변을 정확성의 근거로 삼아서는 안 됩니다.
엔지니어링 작업도 예산에 넣습니다. 예를 들어 전환에 4시간이 걸리고 시간당 $100을 가정하면 비용은 $400입니다. 티켓 분류의 월 토큰 절감액 $304를 기준으로 회수 기간은 약 1.3개월이며, 평가와 사고 대응 비용은 포함하지 않은 값입니다. 같은 토큰 구성에서 월 분류량이 100건뿐이라면 절감액은 월 $0.304입니다. 이 정도를 아끼려고 잘 작동하는 처리 경로를 다시 만드는 것은 경제적 이유가 약합니다.
현재 작업량이 적거나, 결과를 받아들이는 데 폭넓은 판단이 필요하거나, 모델을 바꾸면서 검토 단계가 추가된다면 요금표만 보고 전환하지 않습니다. 향후 가격이나 기능이 달라졌을 때 선택을 되돌릴 수 있도록 프롬프트, 근거, 검증 규칙을 옮겨 쓸 수 있게 유지합니다.
Claude 요금제에서는 어떤 모델을 쓸 수 있나요?
주요 Claude 요금제에 Haiku와 Sonnet이 포함되어 있지만, 구독자의 모델 접근 권한과 API의 토큰당 청구액은 별개의 문제입니다. Claude Opus와 Claude Fable도 Anthropic의 모델 제품군입니다. 여기서는 요금제 접근 권한을 설명하기 위해 언급하며, 두 모델의 비용 비교 범위를 넓히지는 않습니다. 2026년 10월 8일 확인한 claude.com 요금제 비교에는 다음과 같이 나옵니다.
- Free: Haiku와 Sonnet을 제공하며, Opus와 Fable은 이용 불가로 표시됩니다.
- Pro: Haiku, Sonnet, Opus를 제공하며, Fable은 사용 크레딧으로 표시됩니다.
- Max 5x와 Max 20x: Haiku, Sonnet, Opus를 제공하며, Fable은 **주간 한도의 50%**로 표시됩니다.
- Team: Haiku, Sonnet, Opus를 제공하며, Fable은 **프리미엄 좌석에서 주간 한도의 50%**로 표시됩니다.
- Enterprise의 셀프서비스 및 영업 지원 방식: Haiku, Sonnet, Opus, Fable 모두 이용 가능으로 표시됩니다.
요금제 표는 모델 제품군을 기준으로 합니다. 모든 계정에서 동일한 5.5 버전이나 같은 제품 설정을 제공한다는 보장은 아닙니다. 컨텍스트 항목에는 최대 1M, 모델에 따라 다름이라고 나옵니다. 이 문구와 앞서 설명한 API 사양은 구분해야 합니다.
운영 서비스의 기능을 만드는 개발자라면 종량제 API 사용량과 적용되는 크레딧을 대화형 구독 접근 권한과 별도로 계산합니다. 앱에서 모델을 고르는 구독자라면 작업과 요금제 한도를 기준으로 결정합니다. API 토큰 계산 예시로 구독에 포함된 코딩 작업 수를 보장할 수는 없습니다.
자주 묻는 질문
Claude Sonnet과 Haiku, 어떤 모델을 선택해야 하나요?
이름의 순서를 바꿔도 선택 기준은 같습니다. 답을 검증할 수 있는 좁은 작업에는 Haiku를, 리드 역할이나 폭넓은 판단이 필요한 사례에는 Sonnet을 평가합니다. 모델 이름만 보기보다 검증을 통과한 결과와 과금된 전체 시도를 비교합니다.
Claude Haiku, Sonnet, Opus는 어떻게 선택하나요?
범위가 정해진 대량 작업의 저비용 후보는 Haiku이며, 이 비교에서 리드 후보는 Sonnet입니다. Anthropic은 Claude Opus 5.5를 장시간 에이전트 코딩과 지식 작업용으로 제시합니다. 리드가 여전히 결과의 합격 기준을 충족하지 못한다면 Opus를 평가합니다. 이런 용도 설명은 해당 애플리케이션에서 측정한 품질 결과가 아닙니다. 모델 개요.
코딩에는 Claude Sonnet, Opus, Haiku 중 무엇을 써야 하나요?
리드와 워커를 따로 선택합니다. 여기서 리드로 권하는 모델은 Sonnet이고, 범위가 정해진 근거 수집 작업의 후보는 Haiku이며, 더 어렵고 오래 걸리는 작업의 또 다른 리드 후보는 Opus입니다. 검증을 통과한 최종 변경을 평가하고, 검토·재시도·인계 사용량을 비용에 포함합니다.
Haiku 4.5와 Sonnet 5는 어떻게 비교하나요?
그것은 이전 버전을 비교하는 질문입니다. 이 페이지의 예산과 사양은 Claude Haiku 5.5와 Claude Sonnet 5.5를 기준으로 합니다. 현재 5.5 버전을 비교하면서 이전 Haiku의 요금이나 컨텍스트 한도를 적용해서는 안 됩니다.
Claude Haiku와 Sonnet의 가격 차이는 얼마인가요?
캐시를 쓰지 않은 입력과 출력의 토큰 수가 같다면, 프롬프트 100,000토큰 이하에서 Sonnet 5.5는 Haiku 5.5의 20배, 더 긴 프롬프트에서는 4배입니다. 캐시 적중에는 다른 단가가 적용되며, 유료 캐시 쓰기 비용도 포함해야 합니다. 현재 요금.
Claude Haiku로 업무에 필요한 품질을 얻을 수 있나요?
Anthropic이 명시한 용도인 분류·추출·라우팅에서는 합리적인 시작 후보입니다. 도입 전에 비용이 큰 실패 사례를 검증해야 합니다. 가격 차이는 특정 업무가 그 기준을 통과한다는 증거가 아닙니다. 공식 용도 설명.
Claude Haiku가 Sonnet보다 빠른가요?
Anthropic은 상대 지연 시간 항목에서 Haiku 5.5를 Fastest, Sonnet 5.5를 Fast로 표시합니다. 이는 공급업체의 표기입니다. 이번 작업에서는 처리량, 응답 시간, 작업 완료 속도를 측정하지 않았습니다. 모델 개요.
Haiku와 Sonnet 모두 Batch API 할인을 받을 수 있나요?
그렇습니다. Anthropic은 두 모델 모두 적용 대상 입력·출력 토큰에 50% 할인을 명시합니다. Batch는 비동기 방식이므로 기다릴 수 있는 작업에 사용합니다. Haiku의 짧은 프롬프트와 긴 프롬프트 요금 구간은 별도로 유지됩니다. Batch 요금.
이번 주에는 무엇부터 바꿔 볼까요?
점수를 매겨 비교한 뒤 합격한 작업 하나부터 옮깁니다. 창업자는 티켓 라벨부터, CTO는 범위를 제한한 문서 요약부터, 개발자는 Sonnet 리드를 유지하면서 파일을 찾는 워커부터 시작할 수 있습니다.
결과의 합격 기준을 정합니다
필요한 답변과 근거, 검토를 요청해야 하는 실패 조건을 명시합니다. 평범한 성공 사례뿐 아니라 어려운 예제도 포함합니다.
작업 전체의 비용을 계산합니다
각 모델의 실제 입력, 청구 출력, 캐시 쓰기, 적중, 재시도를 기록합니다. Haiku의 프롬프트별 기준을 확인하고, 위임 작업에는 리드의 검토도 포함합니다.
처리 경로를 고르고 되돌릴 방법을 남깁니다
결과의 합격 여부와 수정 비용을 고려해도 절감액이 유지되는 곳에는 Haiku를 도입합니다. 큰 모델의 추가 비용이 타당한 작업에는 Sonnet을 계속 쓰거나, 해당 작업을 Sonnet으로 넘깁니다. 프롬프트, effort, 작업량이 바뀌면 예산을 다시 확인합니다.
선택한 역할에 맞춰 에이전트를 구성하려면 Claude Code 및 Codex 설정 체크리스트를 받아보세요.
- 게시일
- 카테고리
- AI
- 언어
Claude API 가격 비교: Haiku 5.5로 바꿔도 되는 작업은?
Claude API 가격과 Haiku 5.5 전환 조건을 살펴봅니다. 100,000토큰 경계, 캐싱·배치 요금, 월 백만 건 분류 비용을 Haiku 4.5·Sonnet 5.5와 비교합니다. 재시도와 오류 비용까지 따져 옮길 작업을 판단하고 API 마이그레이션 주의사항을 확인하십시오.2026년 10월 8일AI
AI 회의록 툴, Otter AI 대신 무엇을 쓸까? 업무별 대안 비교
AI 회의록 툴을 업무에 맞게 고르는 기준을 정리합니다. Granola, Krisp, MeetGeek, Circleback, Claap의 무료 한도와 유료 요금, 봇 없는 기록, CRM 연동을 비교하고, 회의 시간과 기록 보관 범위에 따라 Otter AI를 계속 쓸지 바꿀지 판단합니다.2026년 10월 8일AI
Mistral Large 4 가격과 성능: 프리뷰를 쓸 때와 웨이트를 기다릴 때
Mistral Large 4 가격과 출시 할인, 벤치마크 주장을 정리합니다. 문서 업무의 토큰 비용 예시로 더 저렴한 모델과 비교하고, 보안·문서 작업에 호스팅 프리뷰를 시험할 조건과 EU 리전의 기능 제약을 짚습니다. 자체 호스팅에 필요한 웨이트를 기다려야 할 때도 확인합니다.2026년 10월 7일AI
AI 에이전트 Lindy AI 리뷰: 요금·활용법·한계 비교
AI 에이전트 Lindy AI의 요금과 크레딧 비용, 이메일 자동화와 회의록 AI 설정을 살펴봅니다. 실제 문서로 확인한 연동·승인 범위와 사용량별 비용 예시를 바탕으로, AI 비서가 필요한 팀에 적합한지 판단하고 Gumloop, n8n, Marblism 대안까지 비교합니다.2026년 10월 7일AI
Mistral API 가격 가이드: 모델별 비용과 Vibe 구독 요금 (2026)
Mistral API 가격과 Vibe의 Pro·Team 요금을 비교합니다. 모델별 토큰 단가, 무료 사용 한도, API 크레딧과 EU 리전 추론의 추가 요금을 확인하고, Small 4와 Medium 3.5의 월 비용을 같은 사용량으로 계산합니다. 2026년 10월 기준입니다.2026년 10월 6일AI
AI 업무 자동화: Claude Skills로 주간 고객 보고서 만들기
Claude Skills로 AI 업무 자동화를 시작하는 방법을 소개합니다. 주간 고객 보고서 예제의 SKILL.md와 Python 계산 스크립트를 만들고, Claude 앱·Claude Code·API에 설치하는 절차와 팀 공유, 비용, 데이터 검증 및 사람의 검토 기준까지 살펴봅니다.2026년 10월 6일AI
AI 에이전트를 직원처럼 쓰는 법: 비용 비교와 도입 기준
AI 에이전트를 직원처럼 활용하려는 소규모 사업자를 위한 가이드입니다. 여섯 툴의 USD 요금과 사용량 한도를 비교하고, 메일·일정·고객지원·보고 업무를 30일 시범 운영으로 평가합니다. 사람의 검토와 수정, 설정 시간까지 계산해 어떤 역할을 유지할지 판단하는 방법을 설명합니다.2026년 10월 6일AI