Оптимизация CUDA с Agentic CUDA Optimizer: практическое руководство
Разбираем, как настроить Agentic CUDA Optimizer, провести ограниченный эксперимент с ядром и проверить корректность, время GPU и затраты на модель.


Оптимизация CUDA здесь начинается с небольшого ядра умножения матриц float32. Пропустите его через поиск из семи попыток, сохраняйте кандидатов только после прохождения всех доверенных тестов и ничего не внедряйте, пока выигрыш победителя не окупит обращения к модели, время GPU и работу по ревью. Это руководство посвящено Agentic CUDA Optimizer от Bertaye, а не исследовательской системе CUDA Agent от ByteDance и Tsinghua.
Оптимизация CUDA с Agentic CUDA Optimizer: короткий ответ
Используйте Agentic CUDA Optimizer как изолированный стенд для экспериментов, а не как автономную систему доказательства корректности. Зафиксируйте исходный коммит v0.0, соберите C++-раннер тестов в документированном окружении Windows, предоставьте собственное эталонное ядро и набор входных данных, ограничьте поиск параметром --max-iterations 7, а затем проверьте history.json, summary.json и best.cu перед отдельным повторным прогоном.
Оптимизатор автоматизирует полезный цикл: пишет кандидата, компилирует и запускает его, отклоняет при расхождении результатов, измеряет время после успешной проверки и передаёт полученные данные в следующую попытку. Но он не способен подтвердить, что эталон верен, тесты покрывают продакшен, а ускорение отдельного ядра действительно снижает общий счёт за GPU.
Репозиторий появился в коммите 1e9464da54dfc651337a97c3643bfeefec712bc1 24 сентября 2026 года в 19:41:43 UTC. Коммит важно зафиксировать: это руководство описывает v0.0, а не последующие изменения.
Что на самом деле делает оптимизатор
Представьте мастерскую с контрольными пунктами. Модель может переделывать небольшую деталь на верстаке — CUDA-ядро — и менять параметры его запуска. Измерительным оборудованием управляет тестовый раннер. На витрину кандидат попадает только тогда, когда для каждого предоставленного теста получен допустимый результат.
Отдельный раннер на C++ компилирует исходный код CUDA через NVRTC, запускает его с помощью CUDA Driver API и сохраняет результаты. Python сравнивает их с эталоном и отбирает кандидатов. Тесты с пометкой correctness обязаны пройти проверку, но не влияют на оценку. Тесты performance одновременно проверяют результат и участвуют в расчёте среднего геометрического значения задержки, по которому строится рейтинг.
По умолчанию каждый замеряемый тест получает 10 прогревочных и 100 измеряемых запусков с использованием событий CUDA. Эти числа относятся ко времени ядра, а не к стоимости всей задачи. Компиляция, обращения к модели, неудачные попытки, генерация входных данных, повторные прогоны профайлера и ручное ревью в эту задержку не входят.
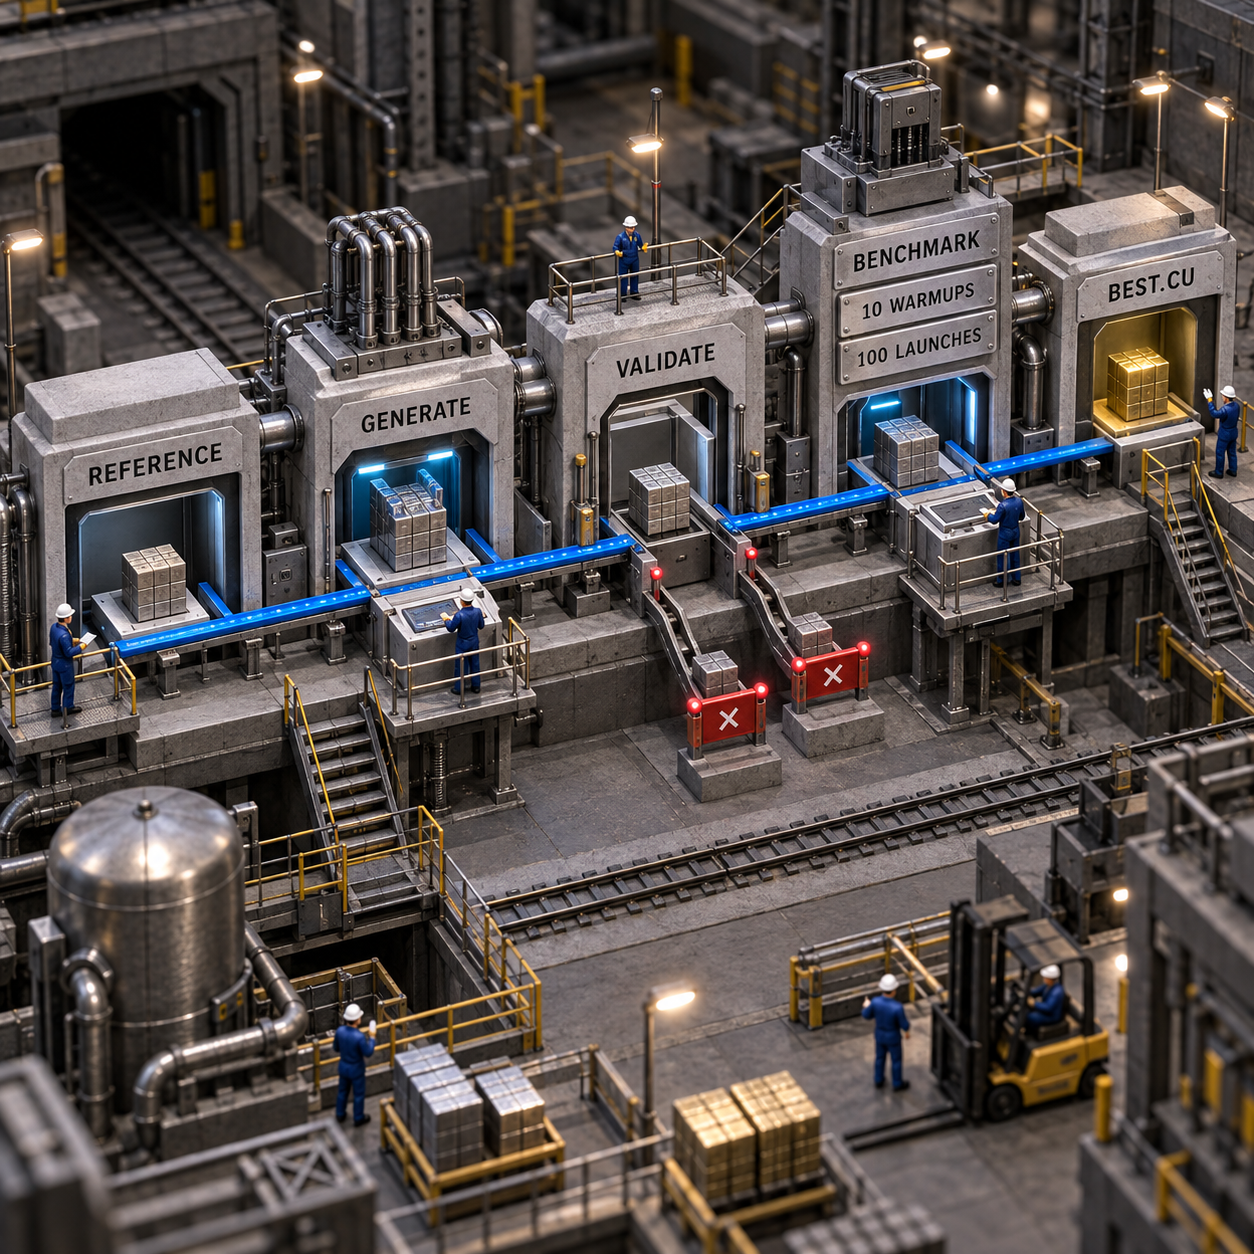
Именно поэтому тестовый раннер полезнее, чем единственный запрос универсальному агенту для программирования с просьбой придумать хитрое ядро. Его преимущество — ограниченный и зафиксированный цикл с явными контрольными точками. Но это не доказывает, что LangGraph найдёт решение лучше, чем сильный агент для программирования. Автор репозитория подчеркнул то же самое при запуске проекта: ценность создают рамки вокруг этапов.
Настройка зафиксированной сборки для Windows
Сначала следуйте документированному сценарию для Windows. Репозиторий разрабатывался на RTX 3060 Laptop GPU; в документации указана Visual Studio 2026 с инструментами C++. Перед сборкой убедитесь, что установлены Python 3.12 или новее, CMake 3.24 или новее, компилятор C++17, драйвер NVIDIA и совместимый CUDA Toolkit.
python --version
cmake --version
where.exe cl
nvidia-smi
nvcc --version

git clone https://github.com/bertaye/agentic-cuda-optimizer.git
cd agentic-cuda-optimizer
git checkout --detach 1e9464da54dfc651337a97c3643bfeefec712bc1

python -m venv .venv
.venv\Scripts\python -m pip install -r optimizer_agent/requirements.txt
cmake -S cuda_test_harness -B cuda_test_harness/build -DCMAKE_BUILD_TYPE=Release
cmake --build cuda_test_harness/build --parallel

Set-Content .env 'OPENAI_API_KEY=your-key-here'
Если хотя бы одна проверка зависимостей не прошла, остановитесь. Когда агент одновременно меняет ядра, исправлять ещё и инструментарий трудно: причины сбоев смешиваются.
В v0.0 есть две детали, на которые стоит обратить внимание:
- README предлагает
--config optimizer_agent/example.json, но в зафиксированном коммите этого файла нет. Передавайте явные флаги либо создайте и проверьте собственную конфигурацию. - В публичном репозитории нет файла лицензии, а GitHub не обнаруживает лицензию. Открытый доступ к коду не означает разрешения на коммерческое использование. Перед применением в компании, распространением или включением в платный продукт получите разрешение либо юридическое заключение.
Для других платформ в этой версии документированного сценария установки нет. При подготовке статьи проверялась среда Linux, но в ней отсутствовали необходимые инструменты CUDA и сборки. Это была проверка зависимостей, а не успешный тест под Linux.
Наконец, изолируйте машину. Если доверить оптимизатору создание входных данных, сгенерированный Python-код будет выполняться локально без песочницы. Сгенерированный CUDA-код также запускается непосредственно на GPU. Используйте одноразовый хост или VM с минимальными правами, без продакшен-данных, посторонних секретов и доступа к важным сетевым папкам.
Спроектируйте эксперимент, который честно выявит неудачу
Начните с одного ядра, чей контракт можно изложить на одной странице. Умножение матриц float32 с построчным хранением — хороший пилотный пример: входы, выход и размеры заданы явно, а нечётные размеры выявляют ошибки обработки границ, которые легко пропустить на удобных квадратных тестах.
Подготовьте за пределами каталога результатов оптимизатора три ресурса:
reference.cu— простую, проверенную реализацию из надёжного источника. Не просите одну и ту же модель создавать и эталон, и кандидата.initial.cu— реальную базовую реализацию, которую в ином случае вы бы выпустили. Так эффектная победа над слабым сгенерированным кодом не будет ошибочно принята за выигрыш для бизнеса.input_cases.json— фиксированные воспроизводимые бинарные входы с осмысленными допусками сравнения, соответствующими вашему численному контракту.
В ограниченный пилот можно включить один тест корректности с нечётными размерами, например M=31, N=37, K=29, а затем два умеренных теста производительности: 256 на 256 на 256 и M=384, N=256, K=320. Это рекомендации по построению эксперимента, а не бенчмарки репозитория. Оставьте вне оптимизатора четвёртую, скрытую от поиска форму матриц и новые значения, чтобы финальный кандидат встретился с неизвестным ему тестом.
Используйте нетривиальные значения — не только нули или единицы. Проверьте размер каждого буфера, порядок аргументов, скалярный тип и допуски. В манифесте должен быть как минимум один тест performance. Пройти обязаны все тесты, однако на рейтинг влияют только тесты производительности.
До запуска сохраните хеши либо копии эталона, входных данных и тестового раннера. Оптимизатор может свободно менять исходный код кандидата и параметры запуска для каждого теста, но не критерии успеха.
Проведите ровно семь попыток улучшения
В команде ниже явно заданы входные данные и используется документированный путь к интерпретатору Windows. Она фиксирует сигнатуру точки входа, передаёт независимый эталон и реальную базовую реализацию, а бюджет улучшений ограничивает семью попытками.
.venv\Scripts\python optimizer_agent\optimizer_agent.py `
  --description "Row-major float32 matrix multiplication C=MxN from A=MxK and B=KxN." `
  --signature 'extern "C" __global__ void matmul_f32(const float* a, const float* b, float* c, int m, int n, int k)' `
  --reference .\experiment\reference.cu `
  --initial-kernel .\experiment\initial.cu `
  --input-cases .\experiment\input_cases.json `
  --max-iterations 7
По умолчанию используется модель gpt-5-mini со средним уровнем рассуждений, а обращения к API оплачиваются с вашего аккаунта. Семь попыток улучшения не означают семь вызовов модели или семь запусков ядра. В одной попытке могут быть обращения к инструментам и повторные исправления, а каждый замеряемый тест по умолчанию включает 10 прогревочных и 100 измеряемых запусков.
Для первого чистого базового прогона не включайте --use-nsight и --nvidia-research. Профилирование Nsight добавляет повторные запуски и требует Nsight Compute, а также разрешения на чтение счётчиков производительности GPU. NVIDIA research добавляет работу модели и поиск данных. Когда основной цикл станет стабильным, меняйте по одному параметру за раз.
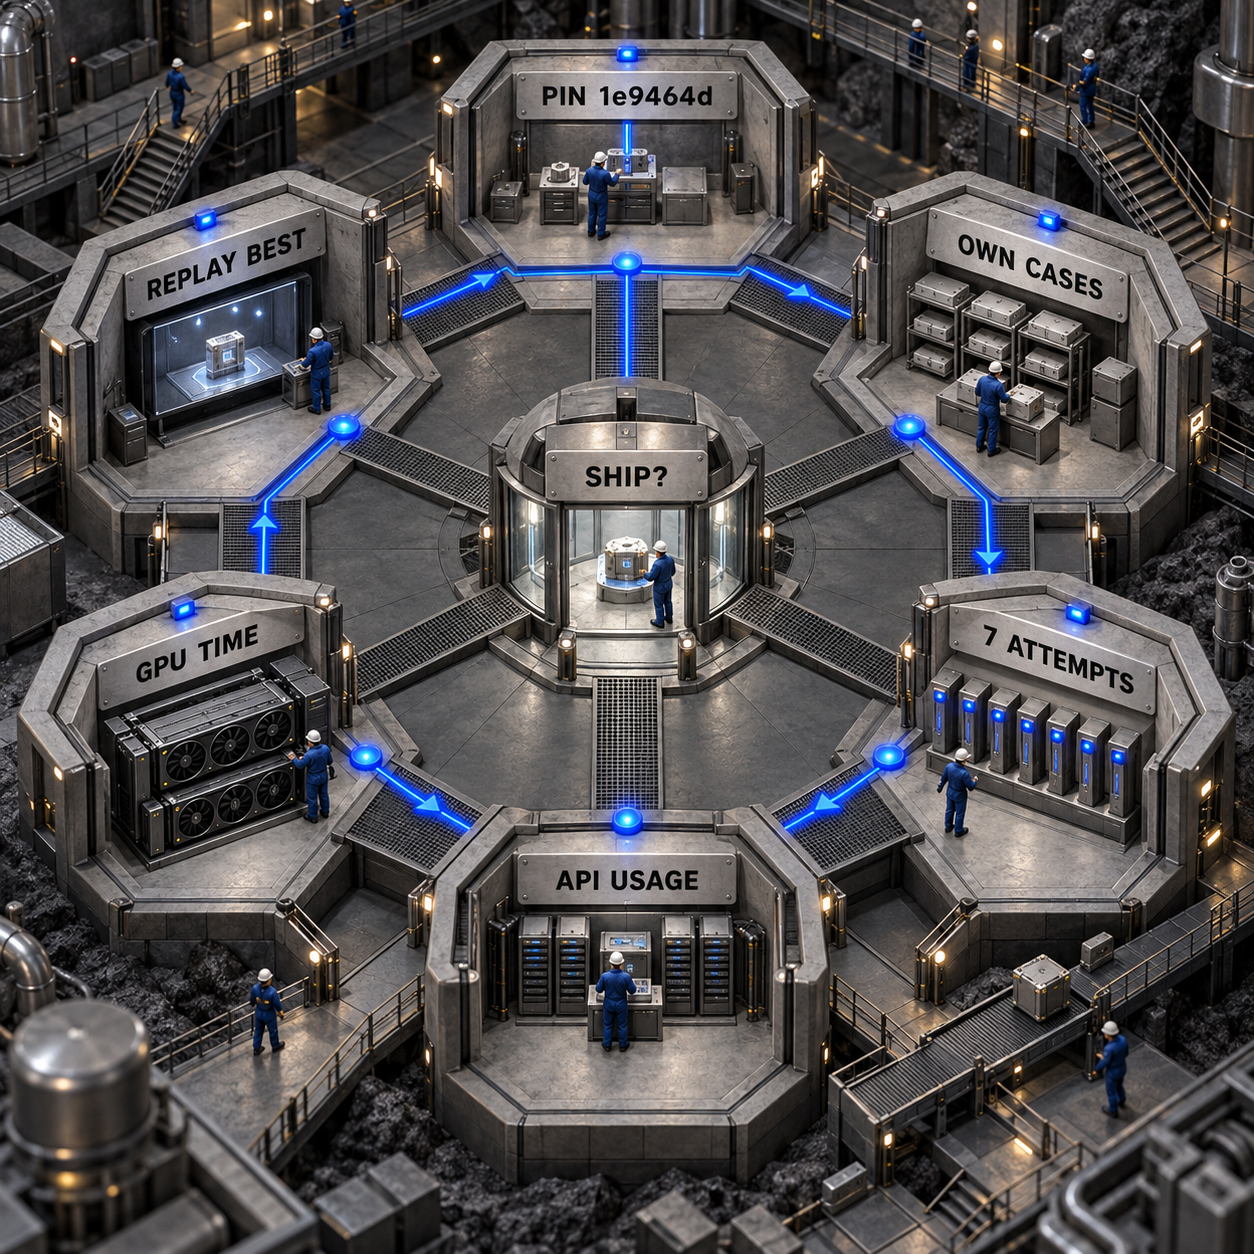
Перед нажатием Enter заведите журнал эксперимента и запишите:
- зафиксированный коммит и состояние рабочего дерева
- модель GPU, версии драйвера и CUDA Toolkit
- хеши эталона и тестов
- время начала и окончания
- общее время работы GPU по настенным часам
- название модели, число вызовов, токены или другие доступные метаданные использования из сохранённых файлов ответов
- валидных и отклонённых кандидатов, а также причины отказов
- задержку базовой реализации и победителя для каждого теста
На время сравнения не нагружайте GPU другими задачами. Фоновая работа на GPU может превратить небольшое кажущееся ускорение в погрешность измерений.
Изучите данные и повторно запустите победителя
Считайте каталог результатов комплектом для аудита, а не полкой с трофеями. Каждый сеанс хранится в results/run-NNN/. Начните с этих файлов:
history.jsonсодержит все проверенные попытки, подробности выполнения каждого теста, результаты валидации, конфигурацию запуска и измеренную задержку.summary.jsonуказывает лучшую итерацию, задержку каждого теста, доступные данные об ускорении относительно базовой реализации и причину завершения.best.cu— самый быстрый кандидат, прошедший все предоставленные тесты.- Файлы
best-case-N.jsonсодержат запросы для повторного запуска победившего исходного кода на предоставленных тестах. - В
model-*.jsonи файлах ответов инструментов сохранено взаимодействие с агентом. Для учёта расходов на API изучите их метаданные использования:summary.jsonне суммирует затраты на модель. heatmap.pngиheatmap.svgпоказывают историю замеров. Это средства навигации, а не доказательство корректности.
Считайте отклонённых кандидатов так же внимательно, как и валидных. Прогон с шестью отклонёнными предложениями и одним узким победителем говорит совсем не о том же, что прогон, в котором каждый кандидат остался валидным. Изучите ошибки компиляции, расхождения результатов и убедитесь, что исходный код победителя действительно отличается от родительского.
Затем повторно выполните каждый сохранённый best-case-N.json через тестовый раннер на том же простаивающем GPU. После этого проверьте best.cu на скрытой форме матриц и новых значениях с помощью независимого эталона. Предоставленные тесты подтверждают лишь то, что кандидат прошёл именно их. Они не доказывают общую корректность, отсутствие гонок или безопасное поведение для любой допустимой формы.
Отклоните победителя, если провален хотя бы один скрытый тест, если при повторном измерении результат пересекается с базовым в пределах погрешности или если выигрыш исчезает в реальном приложении. Сгенерированный эталон не может быть единственным источником истины, а победа над сгенерированным стартовым ядром не равна победе над cuBLAS или другой продакшен-реализацией. Сравнения с cuBLAS в репозитории нет.
Проверьте, окупается ли ускорение
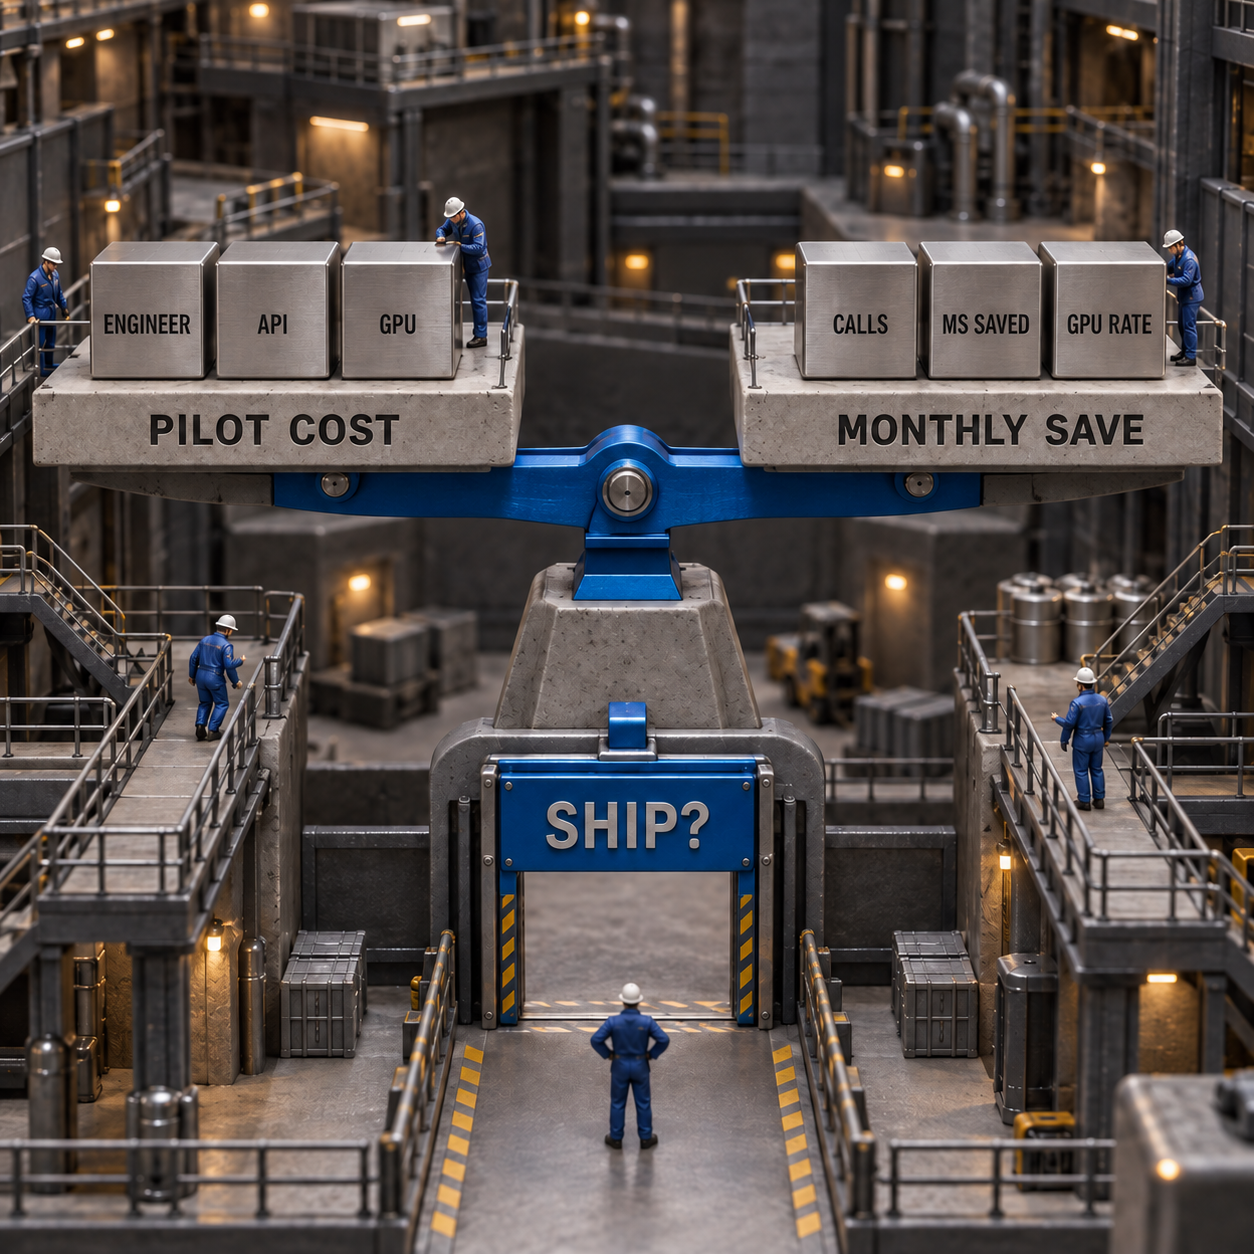
Считайте экономику всей задачи, а не оценку отдельного ядра. У публичного репозитория нет цены подписки, но нет и разрешения на коммерческое использование. При этом эксперимент всё равно расходует время инженера, платные обращения к API модели и время GPU.
Удобная таблица расчёта состоит из трёх строк:
pilot cost = engineer setup and review + model charges + GPU wall-clock costsaved GPU hours per month = end-to-end milliseconds saved per invocation × monthly invocations ÷ 3,600,000payback months = pilot cost ÷ monthly gross GPU saving
Подставляйте миллисекунды, сэкономленные после интеграции во всём процессе, а не задержку по событиям CUDA из summary.json. Если ядро вызывается несколько раз на запрос, учитывайте измеренное число вызовов. Если ускорение меняет пропускную способность, нагрузку на память или батчинг, заново измерьте всю рабочую нагрузку, а не экстраполируйте результат отдельного ядра.
Работа человека тоже стоит недёшево. На странице CUDA-консультантов Upwork сейчас приведены ориентировочные диапазоны: от $500 до $1,200 за профилирование производительности и от $2,500 до $4,500 за настройку ядра. Это рыночные ориентиры, а не коммерческие предложения и не доказательство того, что агент заменяет специалиста. Но они показывают ценность воспроизводимого эксперимента первого этапа, если тот помогает дорогому эксперту сосредоточиться на кандидатах с убедительными данными.
Правило «внедрять или нет» предельно простое: переходите к контролируемому интеграционному тесту, только если кандидат проходит независимые проверки, стабильно превосходит базовую реализацию, ускоряет реальную нагрузку и укладывается в срок окупаемости, который команда определила до запуска.
Семь команд, которым этот подход принесёт пользу
Сценарии расположены по вероятности превратить подтверждённое ускорение ядра в деньги или высвободившиеся ресурсы.
Если речь идёт о приложении целиком, зрелом примитиве от поставщика или постоянно меняющемся наборе форм, начинать стоит с другого инструмента. Этот оптимизатор прямо позиционируется как экспериментальный и предназначен для отдельных ядер.
Более широкий обзор соседних систем есть в материале сравнение ИИ-агентов для оптимизации GPU: там рассмотрены AKO, KernelAgent, AutoKernel, Apex и CUDA Agent. Репозиторий Bertaye — более новый и отдельный проект.
Два продукта, которые можно построить вокруг оптимизатора
1. Аудит ограниченной оптимизации CUDA
Это самая перспективная возможность. Предлагайте командам с одним дорогим CUDA-ядром пакет доказательств фиксированного объёма: фиксацию окружения, приём доверенных тестов, прогон из семи попыток, независимое повторное тестирование, учёт затрат на модель и GPU, а также отчёт с решением «внедрять или нет».
Спрос невелик, но необычно конкретен. По данным DataForSEO, в США выполняется около 30 поисков в месяц по запросу cuda optimization и 20 по cuda kernel optimization; в обоих случаях конкуренция в платном поиске низкая. На том же рынке Upwork указывает ориентиры от $500 до $1,200 за профилирование и от $2,500 до $4,500 за настройку. Такое сочетание указывает на узкую экспертную услугу, а не на массовое приложение самообслуживания.
Минимальная версия, которую уже можно продавать, включает защищённую форму приёма данных, одноразовый GPU-раннер, заблокированный манифест тестов, сборщик затрат запуска и HTML-отчёт с доказательствами. Ручная проверка должна остаться частью процесса. Главный риск — доверие: один неверный победитель способен перечеркнуть ценность множества успешных аудитов, а отсутствие лицензии у репозитория требует получить разрешение, прежде чем строить на его коде коммерческий сервис.
2. Регрессионный контроль GPU-ядер
Создайте управляемый CI-сервис, который повторно запускает утверждённые ядра на зарезервированном оборудовании, проверяет сохранённые результаты и блокирует релиз при отклонении задержки или корректности. GPU-платформы и CUDA-консультанты готовы платить за стабильную историю изменений драйвера, инструментария и исходного кода.
По данным DataForSEO, в США выполняется около 10 поисков в месяц по запросу gpu performance optimization. Этого мало для бизнеса, который опирается только на SEO, но достаточно, чтобы подтвердить лексику покупателей. Распространять продукт стоит через консультантов, поставщиков GPU и внутренние платформенные команды.
Для MVP нужны очередь оборудования, отпечатки окружения, подписанные эталонные тесты, повторные замеры, пороги и компактное сравнение с последним принятым запуском. Главная проблема — разброс результатов: общие хосты, тепловое состояние и обновления драйвера могут вызывать ложные срабатывания, если раннер не контролирует машину и не повторяет измерения.
Ограничения, которые должны повлиять на решение
Честный вывод: v0.0 — полезный каркас для эксперимента, который требует очень высокого уровня доверия и контроля.
- Он оптимизирует отдельные CUDA-ядра, а не приложения целиком.
- Успешное прохождение предоставленных тестов не доказывает общую корректность.
- Сгенерированный эталон не является независимым источником истины.
- Прирост производительности зависит от нагрузки и оборудования.
- Сравнения с cuBLAS или другой библиотекой поставщика нет.
- Стандартный замер не учитывает компиляцию и повторные прогоны профайлера, поэтому не отражает полную стоимость запуска.
- Сгенерированные скрипты входных данных выполняются локально без песочницы.
- Документированный сценарий сборки предназначен для Windows; для другой платформы потребуется собственный подтверждённый журнал настройки.
- Упомянутой конфигурации-примера в зафиксированном коммите нет.
- Репозиторий не предоставляет прав на коммерческое использование.
Отдельный раннер полезен, когда важны явные этапы, сохраняемые доказательства и воспроизводимый бюджет. Универсального агента для программирования может быть достаточно, если специалист уже контролирует терминал, тесты надёжны, а задача действительно разовая. Раннер оправдан лишь тогда, когда его рамки и журнал аудита снижают риск или объём повторной работы.
Часто задаваемые вопросы
Как использовать Agentic CUDA Optimizer на Mac?
В зафиксированном репозитории документирована сборка для Windows с NVIDIA GPU и совместимым стеком CUDA, а не установка на Mac. Используйте удалённую или одноразовую машину NVIDIA, которую можно проверить, и учитывайте эту платформу отдельно, не пытаясь переводить команды Windows наугад.
Agentic CUDA Optimizer и ByteDance CUDA Agent — это одно и то же?
Нет. В этом руководстве рассматривается agentic-cuda-optimizer от Bertaye — процесс на LangGraph с C++-раннером CUDA-тестов, выпущенный в сентябре 2026 года. CUDA Agent от ByteDance и Tsinghua — отдельная исследовательская система с собственным репозиторием.
Какой GitHub-репозиторий CUDA Agent используется в руководстве?
Используется bertaye/agentic-cuda-optimizer, зафиксированный на коммите 1e9464d. В результатах поиска также встречается BytedTsinghua-SIA/CUDA-Agent, но это не то программное обеспечение, которое настраивается здесь.
Использует ли оптимизатор NVIDIA CUDA Agent?
Нет, отдельный агент NVIDIA не входит в документированный цикл. Проект может дополнительно получать рекомендации NVIDIA с помощью --nvidia-research и анализировать счётчики Nsight Compute через --use-nsight, однако генерацией кандидатов и оркестрацией по-прежнему управляет собственный процесс этого репозитория.
Практический шаг на понедельник прост: поручите одному GPU-инженеру взять одно низкорисковое ядро float32, одну одноразовую машину NVIDIA и за один день подготовить независимый эталон, тесты и таблицу затрат. Запускайте пилот из семи попыток только после того, как эти условия зафиксированы.
Если нужно встроить измеряемый GPU-эксперимент и процесс его проверки в продакшен-систему, подходящая отправная точка — продакшен-системы на базе ИИ.
- Последнее обновление
- 25 сент. 2026 г.
- Категория
- Build
Сделать этот сайт предпочтительным в Google


Отметьте omidsaffari.com как предпочтительный источник — и Google будет поднимать его для вас в Top Stories, AI Overviews и AI Mode.

Цены Runpod в 2026 году: что выгоднее — Pods или Serverless
Разбираем цены Runpod на Pods, Serverless и хранилище, считаем расходы на H100 и находим порог, после которого выделенный GPU обходится дешевле.25 сент. 2026 г.Build
Vercel Sandbox Drives: постоянное рабочее пространство для ИИ-агента
Разбираем Vercel Sandbox Drives: как подключить постоянный диск, безопасно перезапускать песочницы и учитывать ограничения записи, снимков и региона.25 сент. 2026 г.Build
Аналоги Firecrawl для веб-скрапинга: что выбрать
Сравниваем аналоги Firecrawl по краулингу, Markdown и JSON, цене принятой страницы и сложности миграции — от Apify и Crawl4AI до ScrapFly и Jina Reader.25 сент. 2026 г.Build
Аналоги CodeRabbit: что выбрать для ИИ-ревью кода
Сравниваем аналоги CodeRabbit по цене, Git-хостам, границам данных и модели оплаты: Greptile, Qodo, PR-Agent, Kodus, Cursor Bugbot и GitHub Copilot.25 сент. 2026 г.Build
Greptile vs CodeRabbit: что выбрать для ревью кода
Сравниваем Greptile и CodeRabbit по цене, лимитам, глубине ревью и поддержке Git-платформ. Расчёты для пяти авторов и понятные критерии выбора.25 сент. 2026 г.Build
Perplexity Portable Computer на AMD: как запустить локально в Windows
Как запустить Perplexity Portable Computer на AMD Ryzen AI Max в Windows: локальная модель, доступ к папкам, тест и границы облачных запросов.25 сент. 2026 г.Build
Обзор AgentRun: когда workflow для ИИ-агентов оправдан
Обзор AgentRun beta.4 на сценариях поддержки: типизированное состояние, лимиты вызовов агента, эскалация, цена и честные границы применения.24 сент. 2026 г.Build