CUDA-Kernel optimieren: Ein belastbarer Pilot mit Agentic CUDA Optimizer
Mit Agentic CUDA Optimizer einen CUDA-Kernel optimieren: sieben Versuche testen und Korrektheit, GPU-Zeit sowie Modellkosten vor dem Einsatz prüfen.


Wer mit Agentic CUDA Optimizer einen CUDA-Kernel optimieren will, sollte klein und kontrolliert anfangen: einen überschaubaren float32-Matrixmultiplikations-Kernel durch eine Suche mit sieben Versuchen schicken, Kandidaten nur nach bestandenen vertrauenswürdigen Testfällen übernehmen und erst dann ausliefern, wenn der gespeicherte Sieger die Kosten für Modellaufrufe, GPU-Zeit und Prüfung wieder einspielt. Dieser Leitfaden behandelt Bertaye's Agentic CUDA Optimizer, nicht das Forschungssystem CUDA Agent von ByteDance und Tsinghua.
Kurzantwort: CUDA-Kernel optimieren, aber mit Leitplanken
Agentic CUDA Optimizer eignet sich als klar begrenzte Experimentierumgebung, nicht als autonome Beweismaschine. Den ersten Commit v0.0 festschreiben, den C++-Testrunner mit der dokumentierten Windows-Toolchain bauen, einen eigenen Referenz-Kernel samt Eingabefällen bereitstellen und die Suche mit --max-iterations 7 deckeln. Anschließend history.json, summary.json und best.cu prüfen, bevor der Sieger unabhängig erneut ausgeführt wird.
Der Optimierer kann eine nützliche Schleife automatisieren: einen Kandidaten schreiben, kompilieren und ausführen, bei abweichenden Ausgaben verwerfen, nach bestandener Ausgabeprüfung messen und die gewonnenen Daten in den nächsten Versuch einfließen lassen. Er kann jedoch weder bestätigen, dass die Referenz korrekt ist, noch dass die Testfälle die Produktion abdecken oder ein schnellerer isolierter Kernel tatsächlich die gesamte GPU-Rechnung senkt.
Das Repository erschien am 24. September 2026 um 19:41:43 UTC mit dem Commit 1e9464da54dfc651337a97c3643bfeefec712bc1. Diesen Commit festzuschreiben ist wichtig, denn der Leitfaden beschreibt v0.0 und nicht spätere Änderungen.
Was der Optimierer tatsächlich macht
Am besten lässt sich das System als Modellwerkstatt mit Prüftoren verstehen. Das Modell darf das kleine Werkstück auf der Werkbank – den CUDA-Kernel – neu gestalten und dessen Startkonfiguration anpassen. Der Testrunner kontrolliert die Messgeräte. In die Vitrine gelangt ein Kandidat erst, wenn jeder bereitgestellte Fall eine zulässige Ausgabe erzeugt.
Im Hintergrund kompiliert ein eigenständiger C++-Runner den CUDA-Quellcode mit NVRTC, startet ihn über die CUDA Driver API und speichert die Ausgaben. Python vergleicht diese mit der Referenz und wählt Kandidaten aus. Als correctness markierte Fälle müssen bestehen, fließen aber nicht in die Bewertung ein. performance-Fälle dienen sowohl der Validierung als auch der Berechnung der geometrisch gemittelten Latenz für das Ranking.
Standardmäßig erhält jeder gemessene Fall 10 Aufwärmstarts und 100 Messstarts mit CUDA-Events. Diese Zahlen beschreiben die Kernel-Laufzeit, nicht die Gesamtkosten des Auftrags. Kompilierung, Modellaufrufe, fehlgeschlagene Versuche, Eingabeerzeugung, Profiler-Wiederholungen und menschliche Prüfung liegen außerhalb dieser Latenz.
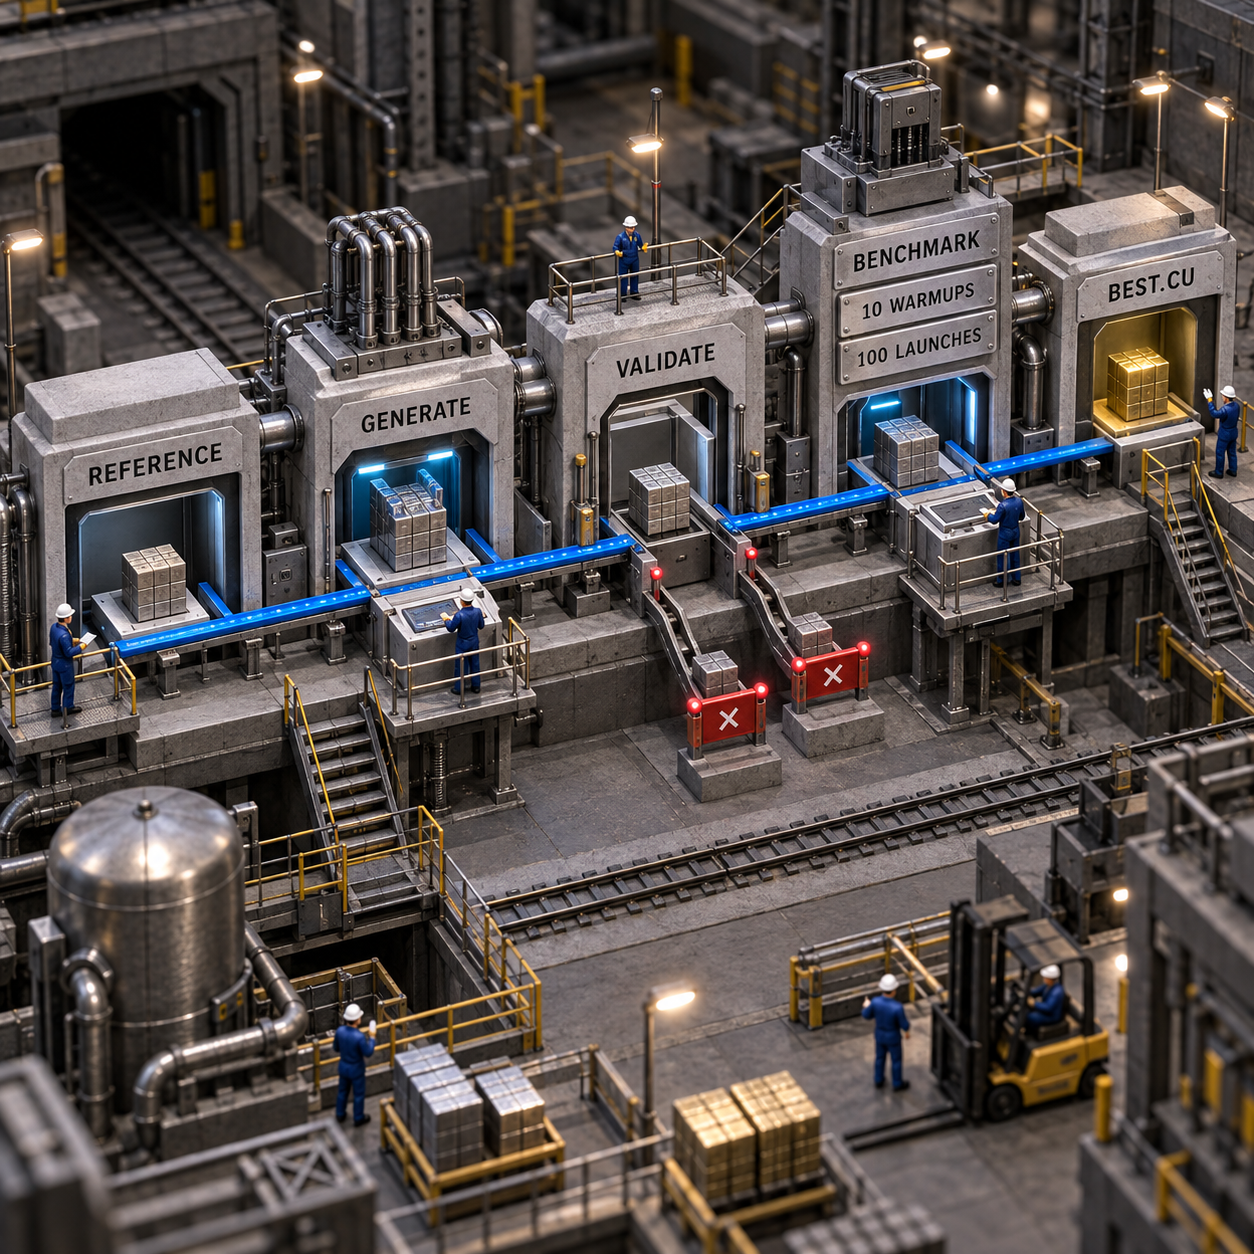
Genau diese Trennung spricht dafür, den Testrunner zu verwenden, statt einen allgemeinen Coding-Agenten mit einem einzigen Prompt um einen cleveren Kernel zu bitten. Der Nutzen liegt in einer protokollierten, begrenzten Schleife mit klaren Prüftoren. Sie beweist nicht, dass LangGraph eine bessere Lösung findet als ein leistungsfähiger Coding-Agent. Der Autor des Repositorys betonte in der Diskussion zur Veröffentlichung ebenfalls, dass der Wert in den Leitplanken um die einzelnen Schritte liegt.
Den festgeschriebenen Windows-Build einrichten
Zuerst dem dokumentierten Windows-Pfad folgen. Entwickelt wurde das Repository mit einer RTX 3060 Laptop GPU; dokumentiert ist Visual Studio 2026 mit C++-Tools. Vor dem Kompilieren müssen Python 3.12 oder neuer, CMake 3.24 oder neuer, ein C++17-Compiler, ein NVIDIA-Treiber und ein kompatibles CUDA Toolkit vorhanden sein.
python --version
cmake --version
where.exe cl
nvidia-smi
nvcc --version

git clone https://github.com/bertaye/agentic-cuda-optimizer.git
cd agentic-cuda-optimizer
git checkout --detach 1e9464da54dfc651337a97c3643bfeefec712bc1

python -m venv .venv
.venv\Scripts\python -m pip install -r optimizer_agent/requirements.txt
cmake -S cuda_test_harness -B cuda_test_harness/build -DCMAKE_BUILD_TYPE=Release
cmake --build cuda_test_harness/build --parallel

Set-Content .env 'OPENAI_API_KEY=your-key-here'
Sobald eine Prüfung der Voraussetzungen fehlschlägt, sollte der Ablauf gestoppt werden. Wird gleichzeitig die Toolchain repariert und der Kernel durch einen Agenten verändert, lassen sich Fehler nur schwer zuordnen.
Zwei Details von v0.0 verdienen besondere Aufmerksamkeit:
- Das README empfiehlt
--config optimizer_agent/example.json, doch diese Datei fehlt im festgeschriebenen Commit. Stattdessen explizite Flags verwenden oder eine eigene Konfiguration anlegen und prüfen. - Das öffentliche Repository enthält keine Lizenzdatei; auch GitHub erkennt keine Lizenz. Öffentliche Sichtbarkeit erteilt keine kommerzielle Nutzungserlaubnis. Vor dem Einsatz im Unternehmen, der Weitergabe oder der Verwendung in einem kostenpflichtigen Produkt ist eine Genehmigung beziehungsweise rechtliche Prüfung erforderlich.
Für andere Plattformen existiert in dieser Version kein dokumentierter Einrichtungsweg. Für diesen Artikel wurde eine Linux-Umgebung geprüft, der jedoch die erforderlichen CUDA- und Build-Tools fehlten. Das war eine Prüfung der Voraussetzungen, kein erfolgreicher Linux-Test.
Schließlich gehört der Rechner isoliert. Wenn der Optimierer Eingaben erzeugen darf, wird das generierte Python lokal und ohne Sandbox ausgeführt. Auch der generierte CUDA-Code läuft direkt auf der GPU. Sinnvoll ist ein entbehrlicher Host oder eine VM mit stark begrenzten Zugangsdaten, ohne Produktionsdaten, sonstige Geheimnisse oder Zugriff auf wichtige Dateifreigaben.
Ein Experiment entwerfen, das ehrlich scheitern kann
Am Anfang sollte genau ein Kernel stehen, dessen Vertrag sich auf einer Seite beschreiben lässt. Eine zeilenweise gespeicherte float32-Matrixmultiplikation ist ein guter Pilotfall: Eingaben, Ausgabe und Dimensionen sind eindeutig, während ungerade Größen Randfehler aufdecken können, die bei bequemen quadratischen Fällen verborgen bleiben.
Außerhalb des Ergebnisverzeichnisses des Optimierers werden drei Komponenten vorbereitet:
reference.cu: eine einfache, geprüfte Implementierung aus einer vertrauenswürdigen Quelle. Das gleiche Modell sollte nicht zugleich das Orakel und den Kandidaten erstellen.initial.cu: die echte Ausgangsversion, die andernfalls ausgeliefert würde. So wird ein spektakulärer Sieg über schwachen generierten Code nicht mit einem geschäftlichen Erfolg verwechselt.input_cases.json: feste, reproduzierbare Binäreingaben und sinnvolle Vergleichstoleranzen für den numerischen Vertrag.
Ein begrenzter Pilot kann einen ungerade geformten Korrektheitsfall wie M=31, N=37, K=29 und anschließend zwei moderate Performance-Fälle wie 256 mal 256 mal 256 sowie M=384, N=256, K=320 enthalten. Das sind Vorschläge für den Versuchsaufbau, keine Benchmarks des Repositorys. Eine vierte, zurückgehaltene Form mit neuen Werten bleibt außerhalb des Optimierers, damit der Endkandidat einen Fall bewältigen muss, den er während der Suche nicht gesehen hat.
Die Werte sollten aussagekräftig und nicht durchgehend null oder eins sein. Jede Puffergröße, Argumentreihenfolge, jeder Skalartyp und jede Toleranz ist zu prüfen. Das Manifest muss mindestens einen performance-Fall enthalten. Alle Fälle müssen bestehen, doch nur die Performance-Fälle beeinflussen das Ranking.
Referenz, Eingaben und Testrunner werden vor dem Lauf gehasht oder kopiert. Der Optimierer darf den Kandidatenquellcode und die Startkonfiguration je Fall verändern, nicht aber die Definition des Erfolgs.
Einen CUDA-Kernel in genau sieben Versuchen optimieren
Der folgende Befehl verwendet explizite Eingaben und den dokumentierten Windows-Pfad zum Interpreter. Er schreibt die Einstiegssignatur fest, übergibt die unabhängige Referenz sowie die echte Ausgangsversion und begrenzt das Verbesserungsbudget auf sieben Versuche.
.venv\Scripts\python optimizer_agent\optimizer_agent.py `
  --description "Row-major float32 matrix multiplication C=MxN from A=MxK and B=KxN." `
  --signature 'extern "C" __global__ void matmul_f32(const float* a, const float* b, float* c, int m, int n, int k)' `
  --reference .\experiment\reference.cu `
  --initial-kernel .\experiment\initial.cu `
  --input-cases .\experiment\input_cases.json `
  --max-iterations 7
Als Standardmodell dient gpt-5-mini mit mittlerem Reasoning-Aufwand; die API-Nutzung wird dem eigenen Konto berechnet. Sieben Verbesserungsversuche bedeuten weder sieben Modellaufrufe noch sieben Kernel-Starts. Ein Vorschlag kann Tool-Aufrufe und Korrekturwiederholungen auslösen, während allein jeder gemessene Fall standardmäßig 10 Aufwärmstarts und 100 Messstarts umfasst.
Für eine erste saubere Ausgangsmessung bleiben --use-nsight und --nvidia-research deaktiviert. Nsight-Profiling erzeugt zusätzliche Wiederholungsarbeit und setzt Nsight Compute sowie die Berechtigung zum Lesen der GPU-Leistungszähler voraus. NVIDIA-Recherche verursacht zusätzliche Modell- und Abrufarbeit. Erst wenn die Basisschleife stabil läuft, sollte jeweils eine Variable hinzukommen.
Vor dem Start wird ein Versuchsprotokoll angelegt. Es enthält:
- festgeschriebenen Commit und Status des Arbeitsbaums
- GPU-Modell sowie Treiber- und CUDA-Toolkit-Versionen
- Hashes der Referenz und Testfälle
- Start- und Endzeitstempel
- gesamte GPU-Wandzeit
- Modellname, Aufrufe, Token oder andere in den gespeicherten Antwortdateien verfügbare Nutzungsdaten
- gültige und verworfene Kandidaten samt Ablehnungsgründen
- Latenz der Ausgangsversion und des Siegers für jeden Fall
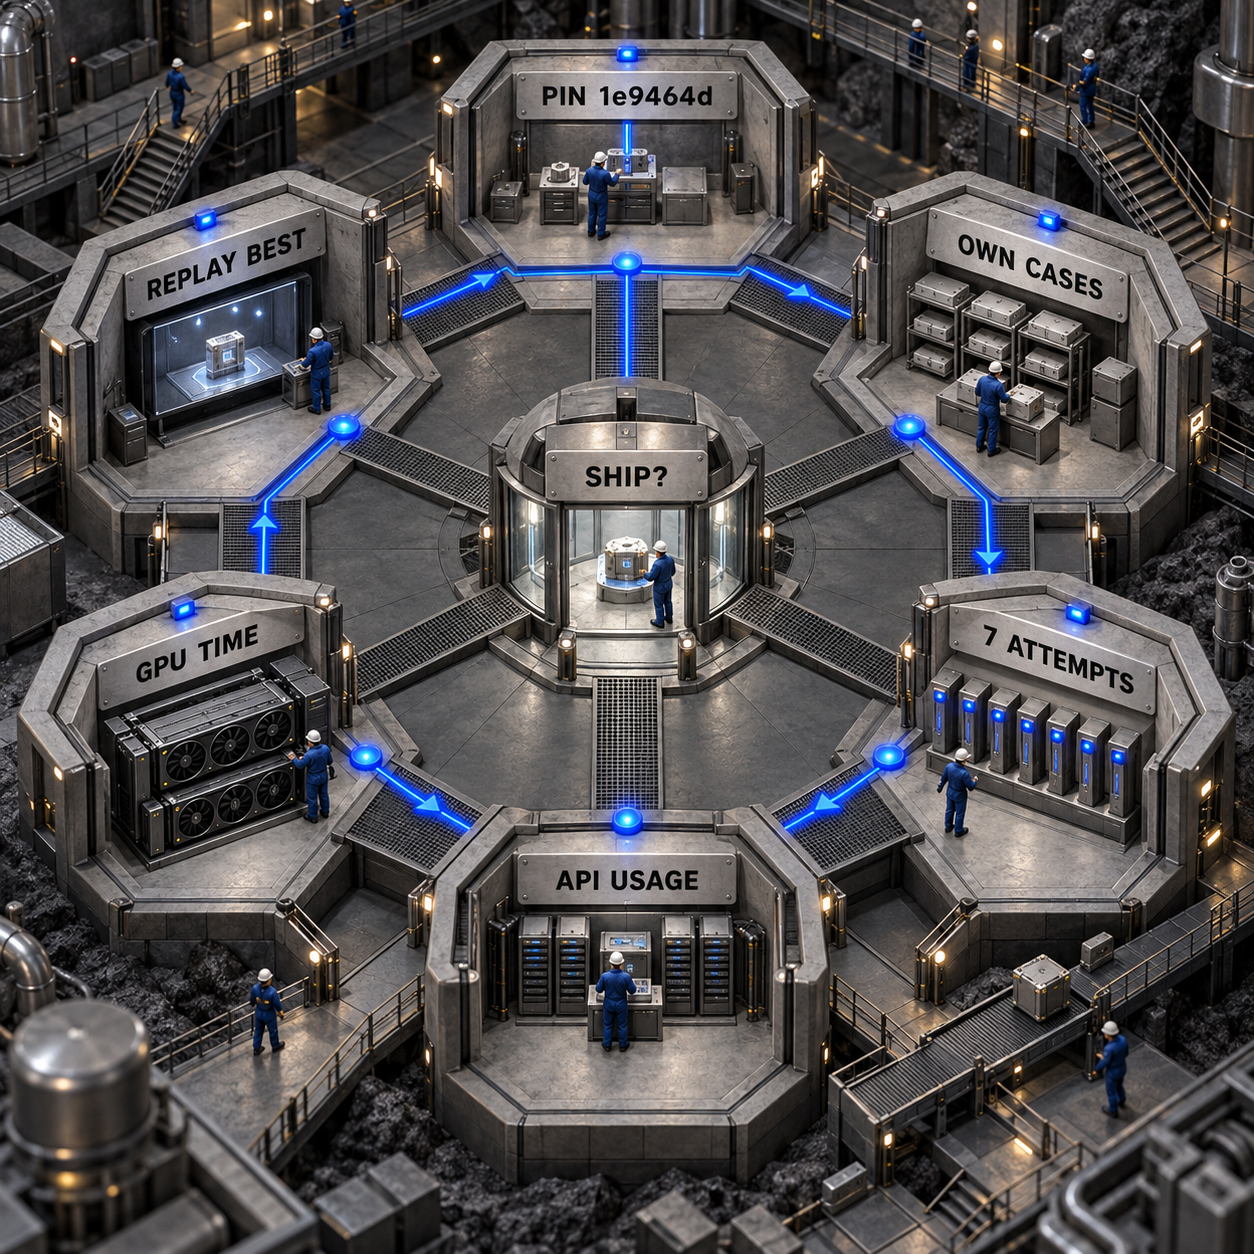
Bei Zeitvergleichen sollte die GPU anderweitig unbeschäftigt sein. Hintergrundlast auf der GPU kann einen kleinen scheinbaren Fortschritt in Messrauschen verwandeln.
Daten prüfen und den Sieger erneut ausführen
Das Ergebnisverzeichnis ist ein Prüfarchiv, keine Trophäensammlung. Jede Sitzung liegt unter results/run-NNN/. Die Prüfung beginnt mit diesen Dateien:
history.jsonenthält alle bewerteten Versuche, Ausführungsdetails pro Fall, Validierungsergebnisse, Startkonfiguration und gemessene Latenz.summary.jsonnennt die beste Iteration, die Latenz je Fall, verfügbare Beschleunigungen gegenüber der Ausgangsversion und den Grund für das Ende.best.cuist der schnellste Kandidat, der alle bereitgestellten Fälle bestanden hat.best-case-N.json-Dateien sind Wiederholungsanforderungen für den siegreichen Quellcode auf den bereitgestellten Fällen.model-*.jsonund Tool-Antwortdateien bewahren die Agenteninteraktion auf. Ihre Nutzungsmetadaten dienen der API-Kostenrechnung, dasummary.jsondie Modellausgaben nicht summiert.heatmap.pngundheatmap.svgzeigen den zeitlichen Verlauf. Sie erleichtern die Navigation, belegen aber keine Korrektheit.
Die verworfenen Kandidaten verdienen ebenso viel Aufmerksamkeit wie die gültigen. Ein Lauf mit sechs abgelehnten Vorschlägen und einem knappen Sieger sagt etwas anderes aus als ein Lauf, in dem jeder Kandidat gültig blieb. Zu prüfen sind Compilerfehler, Ausgabeabweichungen und die Frage, ob sich der siegreiche Quellcode tatsächlich von seinem Vorgänger unterscheidet.
Danach wird jede gespeicherte best-case-N.json auf derselben unbeschäftigten GPU erneut durch den Testrunner geschickt. Anschließend wird best.cu mit der verborgenen Form und neuen Werten gegen ein unabhängiges Orakel getestet. Die bereitgestellten Fälle belegen nur, dass der Kandidat diese Fälle bestanden hat. Sie beweisen weder allgemeine Korrektheit noch Freiheit von Race Conditions oder sicheres Verhalten für jede gültige Form.
Der Sieger ist zu verwerfen, wenn ein Holdout fehlschlägt, wiederholte Messungen sich innerhalb des Rauschens mit der Ausgangsversion überschneiden oder der Vorteil in der realen Anwendung verschwindet. Eine generierte Referenz genügt nicht als einziges Orakel. Ebenso wenig ist ein Sieg über den generierten Start-Kernel ein Sieg über cuBLAS oder eine andere produktive Ausgangslösung. Das Repository veröffentlicht keinen Vergleich mit cuBLAS.
Prüfen, ob sich die Beschleunigung rechnet
Entscheidend ist die Wirtschaftlichkeit des gesamten Auftrags, nicht der Wert des isolierten Kernels. Das öffentliche Repository verlangt keine Abonnementgebühr, gewährt aber auch keine kommerzielle Nutzungslizenz. Das Experiment kostet dennoch Entwicklungszeit, Modell-API-Nutzung und GPU-Zeit.
Ein brauchbares Arbeitsblatt umfasst drei Zeilen:
pilot cost = engineer setup and review + model charges + GPU wall-clock costsaved GPU hours per month = end-to-end milliseconds saved per invocation × monthly invocations ÷ 3,600,000payback months = pilot cost ÷ monthly gross GPU saving
In die Rechnung gehören die nach der Integration eingesparten Ende-zu-Ende-Millisekunden, nicht die CUDA-Event-Latenz aus summary.json. Läuft der Kernel mehrmals pro Anfrage, zählen die gemessenen Aufrufe. Verändert die höhere Geschwindigkeit Durchsatz, Speicherdruck oder Batching, muss die gesamte Arbeitslast erneut gemessen werden, statt das Kernel-Ergebnis einfach hochzurechnen.
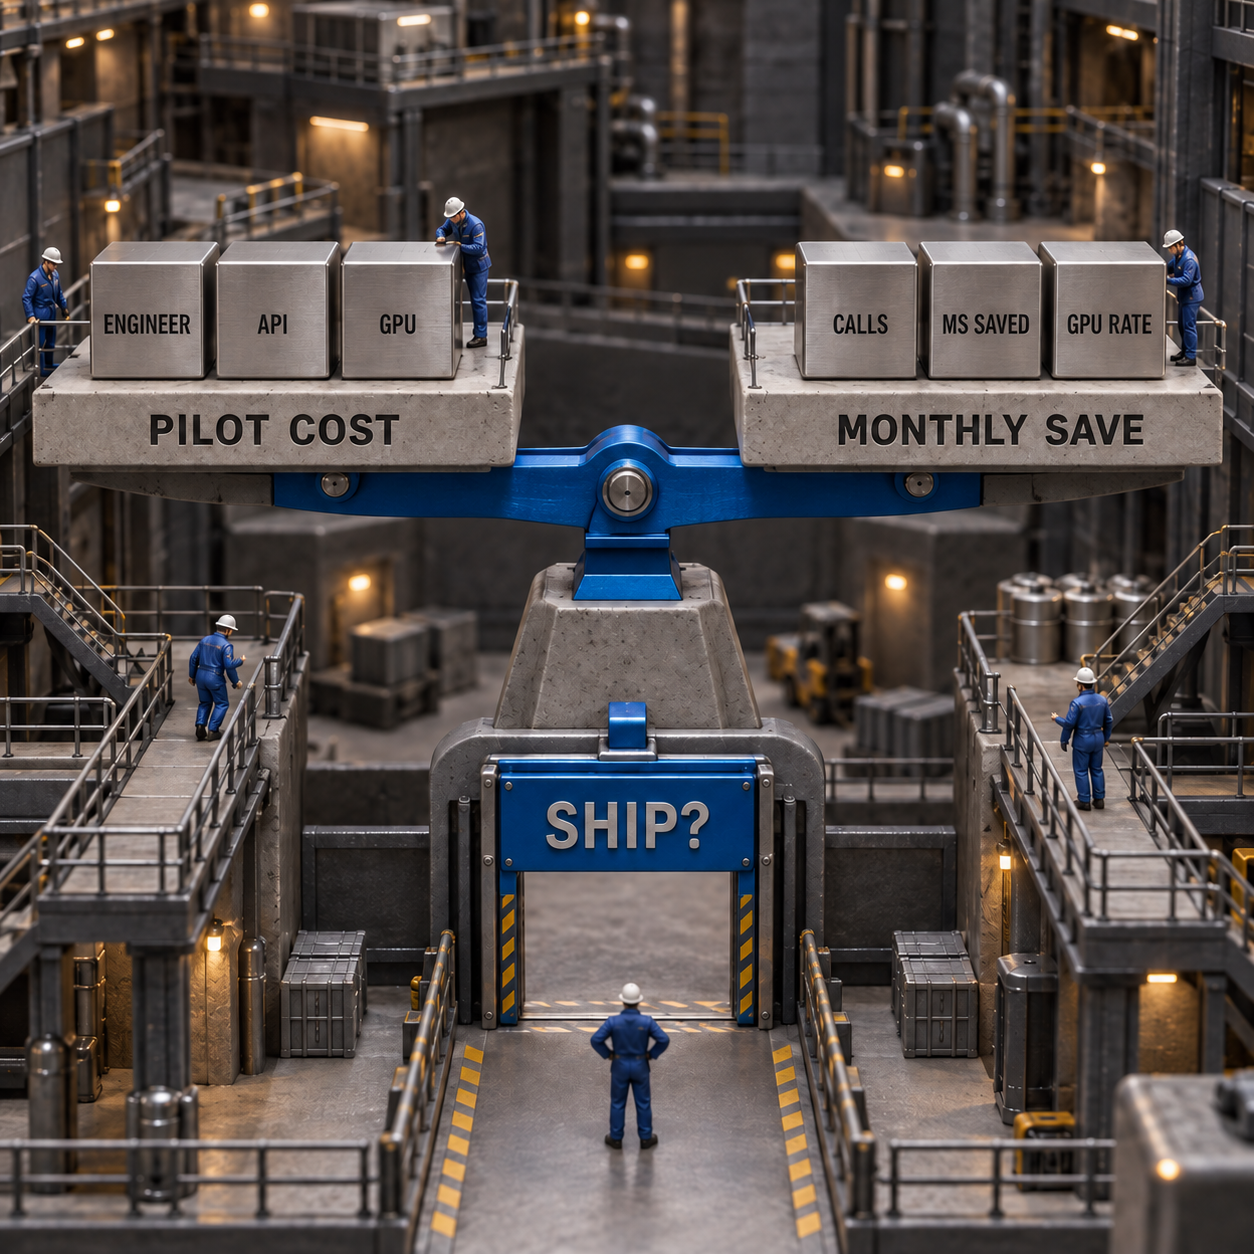
Auch die menschliche Alternative ist nicht billig. Die Upwork-Seite für CUDA-Beratung nennt derzeit Planungsrahmen von $500 bis $1,200 für Performance-Profiling und $2,500 bis $4,500 für Kernel-Tuning. Das sind Marktplatzspannen, keine Angebote und kein Beleg dafür, dass ein Agent einen Spezialisten ersetzt. Sie zeigen jedoch, warum ein wiederholbares Experiment für den ersten Durchgang wertvoll sein kann, wenn es die teure Expertenarbeit auf Kandidaten mit sauberer Beweislage konzentriert.
Die Go-/No-Go-Regel ist nüchtern: Ein Kandidat gelangt nur dann in einen kontrollierten Integrationstest, wenn er unabhängige Fälle besteht, die Ausgangsversion wiederholt schlägt, die reale Arbeitslast verbessert und sich innerhalb des vorab vom Team festgelegten Zeitfensters amortisiert.
Sieben Teams, für die sich der Einsatz eignet
Die folgenden Anwendungsfälle sind danach geordnet, wer einen validierten Kernel-Vorteil am ehesten in Geld oder freie Kapazität umwandeln kann.
Handelt es sich bei der Arbeitslast um eine vollständige Anwendung, eine ausgereifte Anbieterfunktion oder eine ständig wechselnde Sammlung von Formen, ist ein anderer Ausgangspunkt sinnvoller. Dieser Optimierer ist ausdrücklich experimentell und auf einzelne Kernel ausgerichtet.
Einen breiteren Blick auf benachbarte Systeme bietet der bestehende Vergleich von KI-Agenten für GPU-Optimierung mit AKO, KernelAgent, AutoKernel, Apex und CUDA Agent. Bertaye's Repository ist ein neueres, eigenständiges Projekt.
Zwei Produktideen rund um den Optimierer
1. Begrenztes CUDA-Optimierungsaudit
Das ist die stärkste Chance. Teams mit einem kostspieligen CUDA-Kernel erhalten ein klar umrissenes Beweispaket: Erfassung der Umgebung, Übernahme vertrauenswürdiger Testfälle, ein Lauf mit sieben Versuchen, unabhängige Wiederholung, Abrechnung der Modell- und GPU-Kosten sowie ein Go-/No-Go-Bericht.
Die Nachfrage ist klein, aber ungewöhnlich präzise. DataForSEO meldet in den USA rund 30 Suchanfragen pro Monat für cuda optimization und 20 für cuda kernel optimization, jeweils bei geringem Wettbewerb in der bezahlten Suche. Im selben Markt liegen die Upwork-Planungspreise bei $500 bis $1,200 für Profiling und $2,500 bis $4,500 für Tuning. Diese Kombination spricht für eine schmale Expertenleistung, nicht für eine Self-Service-Anwendung für den Massenmarkt.
Die kleinste verkaufsfähige Version besteht aus einem sicheren Aufnahmeformular, einem entbehrlichen GPU-Runner, einem gesperrten Fallmanifest, einer Laufkostenerfassung und einem HTML-Beweisbericht. Ein menschlicher Prüfer bleibt Teil des Ablaufs. Der Haken ist das Vertrauen: Ein einziger fehlerhafter Sieger kann den Wert vieler erfolgreicher Audits zunichtemachen. Zudem erfordert die fehlende Lizenz des Repositorys eine Genehmigung, bevor dessen Code zur Grundlage eines kommerziellen Dienstes wird.
2. Regressionsschranke für GPU-Kernel
Denkbar ist ein kontrollierter CI-Dienst, der freigegebene Kernel auf reservierter Hardware erneut ausführt, gespeicherte Ausgaben prüft und ein Release bei Abweichungen von Latenz oder Korrektheit blockiert. GPU-Plattformteams und CUDA-Beratungen könnten für eine stabile Historie über Änderungen an Treiber, Toolkit und Quellcode hinweg zahlen.
DataForSEO meldet in den USA rund 10 Suchanfragen pro Monat für gpu performance optimization. Das ist für ein reines SEO-Geschäft zu wenig, bestätigt aber die Sprache der Käufer. Der Vertrieb sollte über Beratungen, GPU-Anbieter und interne Plattformteams erfolgen.
Ein MVP benötigt eine Hardwarewarteschlange, Umgebungsfingerabdrücke, signierte Referenzfälle, wiederholte Messungen, Schwellenwerte und einen kompakten Vergleich mit dem letzten akzeptierten Lauf. Der Haken ist die Varianz: Geteilte Hosts, Temperaturzustand und Treiberänderungen können Fehlalarme auslösen, wenn der Runner den Rechner nicht kontrolliert und Messungen nicht wiederholt.
Grenzen, die die Entscheidung beeinflussen sollten
Die ehrliche Einschätzung: v0.0 ist ein brauchbares Gerüst für Experimente, bringt aber eine erhebliche Beweislast mit.
- Optimiert werden einzelne CUDA-Kernel, nicht vollständige Anwendungen.
- Das Bestehen der bereitgestellten Fälle belegt keine allgemeine Korrektheit.
- Eine generierte Referenz ist kein unabhängiges Orakel.
- Performance-Vorteile hängen von Arbeitslast und Hardware ab.
- Ein Vergleich mit cuBLAS oder anderen Anbieterbibliotheken fehlt.
- Die Standardzeitmessung schließt Kompilierung und Profiler-Wiederholungen aus und entspricht daher nicht den gesamten Laufkosten.
- Generierte Eingabeskripte werden lokal und ohne Sandbox ausgeführt.
- Der dokumentierte Build-Pfad gilt für Windows; für andere Plattformen ist ein eigener geprüfter Einrichtungsnachweis nötig.
- Die genannte Beispielkonfiguration fehlt im festgeschriebenen Commit.
- Das Repository begründet keine kommerziellen Nutzungsrechte.
Der separate Runner lohnt sich, wenn explizite Stufen, dauerhafte Nachweise und ein wiederholbares Budget gefragt sind. Ein allgemeiner Coding-Agent kann genügen, wenn bereits ein Experte das Terminal beaufsichtigt, die Tests belastbar sind und die Aufgabe tatsächlich einmalig ist. Seinen Platz verdient der Runner nur, wenn Leitplanken und Prüfpfad Risiken oder Wiederholungsarbeit senken.
Häufig gestellte Fragen
Wie lässt sich Agentic CUDA Optimizer auf einem Mac verwenden?
Das festgeschriebene Repository dokumentiert einen Windows-Build mit NVIDIA-GPU und kompatiblem CUDA-Stack, keine Einrichtung für den Mac. Statt den Windows-Befehl auf Verdacht zu übertragen, sollte ein verifizierbarer entfernter oder entbehrlicher NVIDIA-Rechner genutzt und diese Plattform separat gekennzeichnet werden.
Ist Agentic CUDA Optimizer dasselbe wie ByteDance CUDA Agent?
Nein. Dieser Leitfaden behandelt Bertaye's agentic-cuda-optimizer, einen LangGraph-Ablauf mit einem C++-CUDA-Testrunner, der im September 2026 veröffentlicht wurde. CUDA Agent von ByteDance und Tsinghua ist ein separates Forschungssystem mit eigenem Repository.
Welches CUDA-Agent-Repository auf GitHub verwendet dieser Leitfaden?
Verwendet wird bertaye/agentic-cuda-optimizer, festgeschrieben auf Commit 1e9464d. In den Suchergebnissen erscheint außerdem BytedTsinghua-SIA/CUDA-Agent; diese Software wird hier nicht eingerichtet.
Verwendet der Optimierer einen NVIDIA CUDA Agent?
Der dokumentierte Ablauf enthält keinen separaten NVIDIA-Agenten. Das Projekt kann optional mit --nvidia-research NVIDIA-Hinweise abrufen und mit --use-nsight Leistungszähler von Nsight Compute untersuchen; Kandidatenerzeugung und Orchestrierung verbleiben jedoch im eigenen Ablauf dieses Repositorys.
Der nächste sinnvolle Schritt am Montag ist einfach: Eine GPU-Fachkraft erhält einen risikoarmen float32-Kernel, einen entbehrlichen NVIDIA-Rechner und einen Tag Zeit, um die unabhängige Referenz, die Testfälle und das Kostenblatt vorzubereiten. Der Pilot mit sieben Versuchen startet erst, wenn diese Prüftore schriftlich feststehen.
Wenn ein gemessenes GPU-Experiment samt Prüfpfad in ein Produktivsystem integriert werden soll, sind KI-Produktionssysteme der passende Ausgangspunkt.
- Zuletzt aktualisiert
- 25. Sept. 2026
- Kategorie
- Build
Diese Seite in Google bevorzugen


Markieren Sie omidsaffari.com als bevorzugte Quelle, und Google hebt die Seite für Sie in Top Stories, AI Overviews und AI Mode hervor.

GPU mieten bei Runpod: Was Pods und Serverless 2026 kosten
GPU mieten bei Runpod: Der Vergleich erklärt Pod-, Serverless- und Speicherkosten, rechnet H100-Szenarien durch und zeigt klar den Break-even.25. Sept. 2026Build
Vercel Sandbox Drives: Persistente Workspaces richtig nutzen
Vercel Sandbox Drives speichern Agenten-Workspaces über Neustarts hinweg. So funktionieren Mounts, Snapshots, Regionen, Kosten und der Ein-Writer-Zugriff.25. Sept. 2026Build
Firecrawl Alternative: 7 Tools im Kostenvergleich
Sieben Firecrawl-Alternativen im Vergleich: Kosten, Markdown- und JSON-Ausgabe, Migrationsaufwand und Preis je nutzbarer Seite für KI-Pipelines.25. Sept. 2026Build
CodeRabbit Alternative: 7 Tools für automatisierte Code-Reviews
Sieben CodeRabbit-Alternativen im Vergleich: Kosten, Git-Hosts, Datenschutz und Self-Hosting für Teams, die ihren KI-Code-Reviewer gezielt ersetzen.25. Sept. 2026Build
CodeRabbit Alternative: Wann Greptile die bessere Wahl ist
Greptile oder CodeRabbit? Der Vergleich zeigt Preise, Prüflimits, Git-Plattformen und reale Teamkosten – plus einen belastbaren Testplan vor dem Kauf.25. Sept. 2026Build
Perplexity Windows App: Portable Computer lokal nutzen
Portable Computer in der Perplexity Windows App einrichten: AMD-PC prüfen, Dateiaufgaben lokal testen und Kosten sowie Cloud-Freigaben kontrollieren.25. Sept. 2026Build
AgentRun im Test: KI-Workflow-Automatisierung mit klaren Grenzen
AgentRun im Praxistest: Wie der TypeScript-Interpreter KI-Workflows strukturiert, Agentenaufrufe begrenzt – und wann eine einfache Funktion besser ist.24. Sept. 2026Build