Cómo mejorar el rendimiento GPU con Agentic CUDA Optimizer
Mejora el rendimiento GPU con Agentic CUDA Optimizer: prepara un kernel, limita la búsqueda a siete intentos y valida el ahorro antes de desplegarlo.


Somete un pequeño kernel de multiplicación de matrices float32 a una búsqueda de siete intentos para mejorar el rendimiento GPU, conserva los candidatos solo si superan todos los casos de confianza y no despliegues nada hasta que el ganador guardado compense las llamadas al modelo, el tiempo de GPU y el trabajo de revisión. Esta guía trata sobre Agentic CUDA Optimizer de Bertaye, no sobre el sistema de investigación CUDA Agent de ByteDance y Tsinghua.
Respuesta breve
Utiliza Agentic CUDA Optimizer como un ejecutor de experimentos con límites claros, no como una máquina autónoma de demostraciones. Fija el commit inicial v0.0, compila su ejecutor de pruebas en el entorno Windows documentado, aporta tu propio kernel de referencia y tus casos de entrada, limita la búsqueda con --max-iterations 7 y audita history.json, summary.json y best.cu antes de repetir la prueba por separado.
El optimizador puede automatizar un ciclo útil: escribir un candidato, compilarlo, ejecutarlo, descartarlo si los resultados difieren, medirlo si los resultados son válidos y suministrar esas evidencias al siguiente intento. Lo que no puede determinar es si tu referencia es correcta, si los casos cubren producción o si un kernel aislado más rápido reducirá la factura total de GPU.
El repositorio apareció con el commit 1e9464da54dfc651337a97c3643bfeefec712bc1 el 24 de septiembre de 2026 a las 19:41:43 UTC. Fijar ese commit importa porque esta guía describe v0.0, no los cambios que lleguen después.
Qué hace realmente el optimizador
Piensa en un taller donde un modelo diseña piezas y cada una pasa por controles de calidad. El modelo puede rediseñar la pieza pequeña que está sobre la mesa —el kernel CUDA— y ajustar cómo se lanza. El ejecutor de pruebas controla los instrumentos de medición. Un candidato solo llega a la vitrina después de producir un resultado aceptable en todos los casos proporcionados.
Por debajo, un ejecutor independiente escrito en C++ compila el código CUDA con NVRTC, lo lanza mediante la CUDA Driver API y guarda los resultados. Python compara esos resultados con la referencia y selecciona los candidatos. Los casos marcados como correctness deben aprobarse, pero no afectan la puntuación. Los marcados como performance validan el resultado y además contribuyen a la latencia media geométrica que se usa para clasificarlos.
De forma predeterminada, cada caso cronometrado recibe 10 lanzamientos de calentamiento y 100 lanzamientos medidos con eventos CUDA. Esas cifras describen el tiempo del kernel, no el costo del trabajo completo. La compilación, las llamadas al modelo, los intentos fallidos, la generación de entradas, las repeticiones del profiler y la revisión humana quedan fuera de esa latencia.
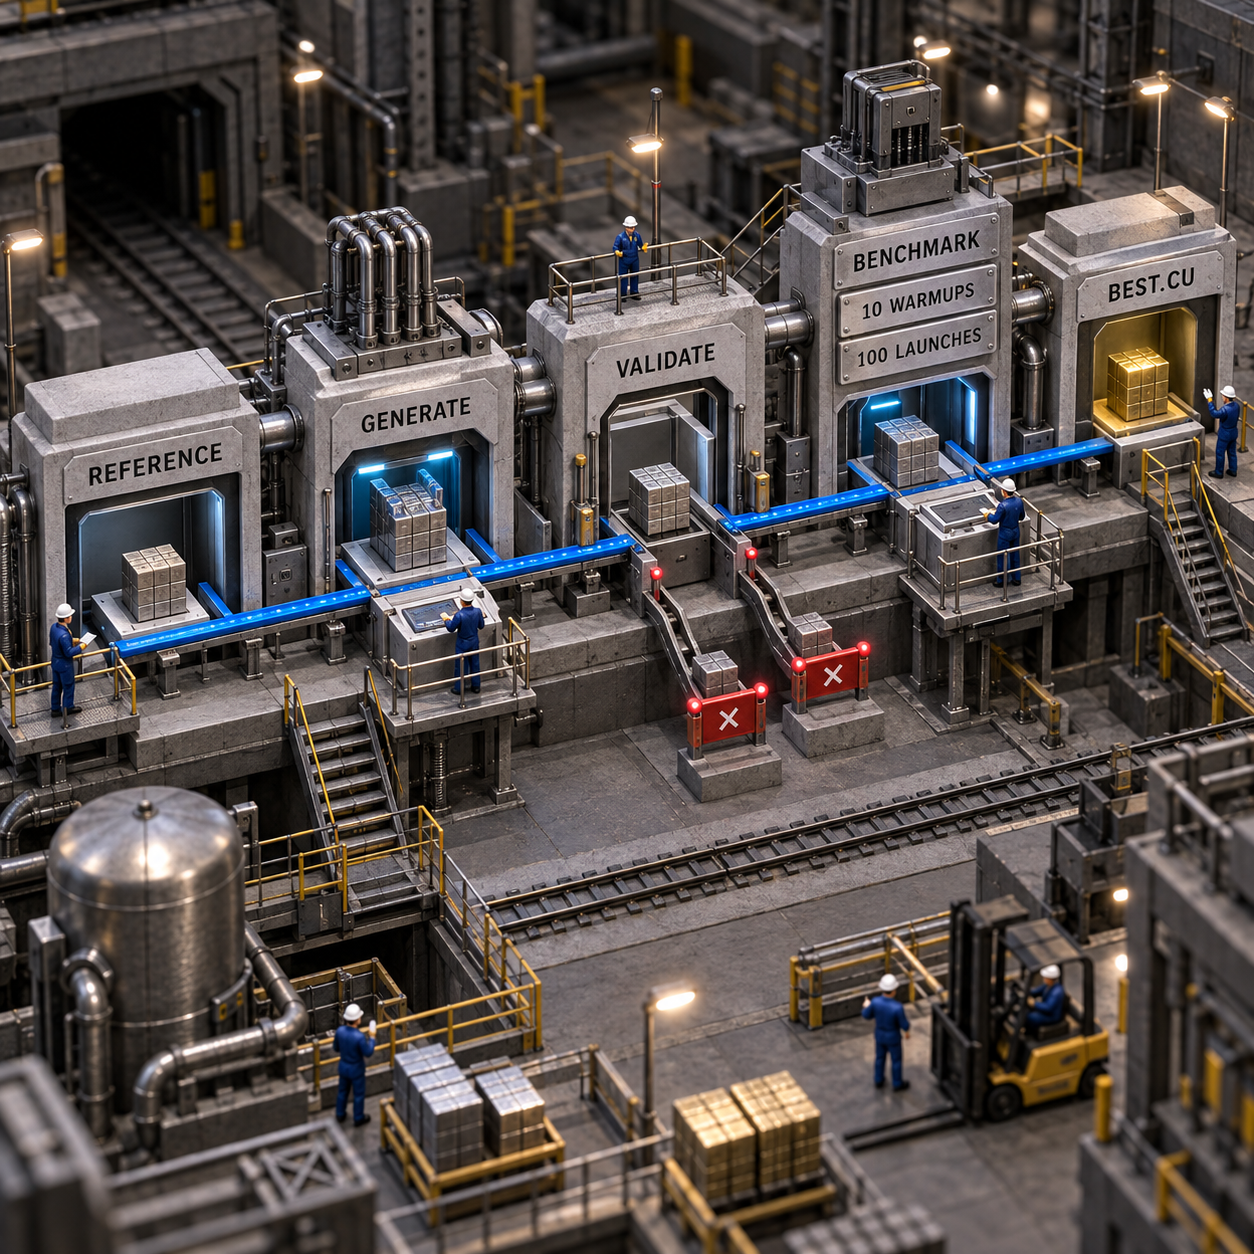
Esta separación justifica utilizar el ejecutor de pruebas en lugar de pedir a un agente de programación general que produzca un kernel ingenioso con un solo prompt. La ventaja es contar con un ciclo registrado y acotado, con controles explícitos. No demuestra que LangGraph vaya a encontrar una solución mejor que un agente de programación competente. El autor del repositorio señaló lo mismo en el debate del lanzamiento: el valor está en los límites que rodean cada paso.
Prepara la compilación fijada para Windows
Empieza por la ruta documentada para Windows. El repositorio se desarrolló con una RTX 3060 Laptop GPU y documenta Visual Studio 2026 con las herramientas de C++. Antes de compilar, confirma que tienes Python 3.12 o posterior, CMake 3.24 o posterior, un compilador C++17, un controlador de NVIDIA y un CUDA Toolkit compatible.
python --version
cmake --version
where.exe cl
nvidia-smi
nvcc --version

git clone https://github.com/bertaye/agentic-cuda-optimizer.git
cd agentic-cuda-optimizer
git checkout --detach 1e9464da54dfc651337a97c3643bfeefec712bc1

python -m venv .venv
.venv\Scripts\python -m pip install -r optimizer_agent/requirements.txt
cmake -S cuda_test_harness -B cuda_test_harness/build -DCMAKE_BUILD_TYPE=Release
cmake --build cuda_test_harness/build --parallel

Set-Content .env 'OPENAI_API_KEY=your-key-here'
Detente si falla alguna comprobación de requisitos. Resolver problemas del entorno de compilación mientras un agente también modifica kernels hace que sea difícil atribuir cada fallo a su causa.
Hay dos detalles de v0.0 que merecen atención:
- El README propone
--config optimizer_agent/example.json, pero ese archivo no existe en el commit fijado. Utiliza parámetros explícitos o crea y revisa tu propia configuración. - El repositorio público no contiene un archivo de licencia y GitHub no detecta ninguna. Que el código sea visible públicamente no concede una licencia comercial. Obtén permiso o una revisión legal antes de usarlo en una empresa, redistribuirlo o incorporarlo a un producto de pago.
Esta versión no documenta una ruta de configuración para ninguna otra plataforma. Para este artículo se revisó un entorno Linux, pero no tenía las herramientas necesarias de CUDA y compilación. Por tanto, fue una auditoría de requisitos previos, no una prueba exitosa en Linux.
Por último, aísla el equipo. Si permites que el optimizador cree las entradas, el Python generado se ejecutará localmente sin sandbox. El CUDA generado también se ejecutará directamente en la GPU. Utiliza un host desechable o una máquina virtual con credenciales limitadas, sin datos de producción, sin secretos ajenos al experimento y sin acceso a recursos compartidos importantes.
Cómo diseñar una prueba honesta de rendimiento GPU
Empieza con un solo kernel cuyo contrato puedas explicar en una página. Una multiplicación de matrices float32 en disposición row-major es un buen piloto: las entradas, la salida y las dimensiones son explícitas, mientras que los tamaños impares dejan al descubierto problemas en los bordes que pueden pasar inadvertidos con casos cuadrados favorables.
Prepara tres recursos fuera del directorio de resultados del optimizador:
reference.cu, una implementación sencilla y revisada procedente de una fuente de confianza. No pidas al mismo modelo que cree el oráculo y el candidato.initial.cu, la línea base real que desplegarías de otro modo. Así evitas confundir una mejora espectacular frente a código generado deficiente con una mejora para el negocio.input_cases.json, con entradas binarias fijas y reproducibles, además de tolerancias de comparación adecuadas para tu contrato numérico.
Un piloto acotado podría incluir un caso de corrección con forma impar, como M=31, N=37 y K=29, seguido de dos casos modestos de rendimiento: 256 por 256 por 256 y M=384, N=256 y K=320. Son sugerencias para diseñar el experimento, no benchmarks del repositorio. Reserva una cuarta forma y valores nuevos fuera del optimizador para que el candidato final se enfrente a un caso que no vio durante la búsqueda.
Utiliza valores no triviales, no solo ceros o unos. Revisa el tamaño de cada búfer, el orden de los argumentos, el tipo escalar y la tolerancia. El manifiesto debe contener al menos un caso performance. Todos los casos deben aprobarse, aunque solo los de rendimiento afectan la clasificación.
Calcula el hash o guarda una copia de la referencia, las entradas y el ejecutor de pruebas antes de iniciar la ejecución. El optimizador debe poder cambiar el código fuente candidato y la configuración de lanzamiento de cada caso, pero no la definición de éxito.
Ejecuta exactamente siete intentos de mejora
El siguiente comando usa entradas explícitas y la ruta documentada del intérprete para Windows. Fija la firma del punto de entrada, aporta la referencia independiente y la línea base real, y limita a siete el presupuesto de intentos de mejora.
.venv\Scripts\python optimizer_agent\optimizer_agent.py `
  --description "Row-major float32 matrix multiplication C=MxN from A=MxK and B=KxN." `
  --signature 'extern "C" __global__ void matmul_f32(const float* a, const float* b, float* c, int m, int n, int k)' `
  --reference .\experiment\reference.cu `
  --initial-kernel .\experiment\initial.cu `
  --input-cases .\experiment\input_cases.json `
  --max-iterations 7
El modelo predeterminado es gpt-5-mini con un nivel medio de razonamiento, y su uso de la API se factura a tu cuenta. Siete intentos de mejora no equivalen a siete llamadas al modelo ni a siete lanzamientos del kernel. Una propuesta puede recurrir a herramientas y reintentos de corrección, mientras que cada caso cronometrado tiene por defecto 10 calentamientos y 100 lanzamientos medidos.
Deja --use-nsight y --nvidia-research desactivados para obtener primero una línea base limpia. El profiling con Nsight añade trabajo de repetición y exige Nsight Compute, además de permiso para leer los contadores de rendimiento de la GPU. La investigación de NVIDIA añade trabajo de modelo y recuperación de información. Incorpora una sola variable cada vez cuando el ciclo básico ya sea estable.
Antes de pulsar Enter, abre un registro del experimento y anota:
- el commit fijado y el estado de cambios locales del árbol
- el modelo de GPU y las versiones del controlador y de CUDA Toolkit
- los hashes de la referencia y los casos
- las marcas de tiempo de inicio y finalización
- el tiempo total de reloj de GPU
- el nombre del modelo, las llamadas, los tokens u otros metadatos de uso disponibles en los archivos de respuestas guardados
- los candidatos válidos, los candidatos rechazados y los motivos del rechazo
- la latencia por caso de la línea base y del ganador
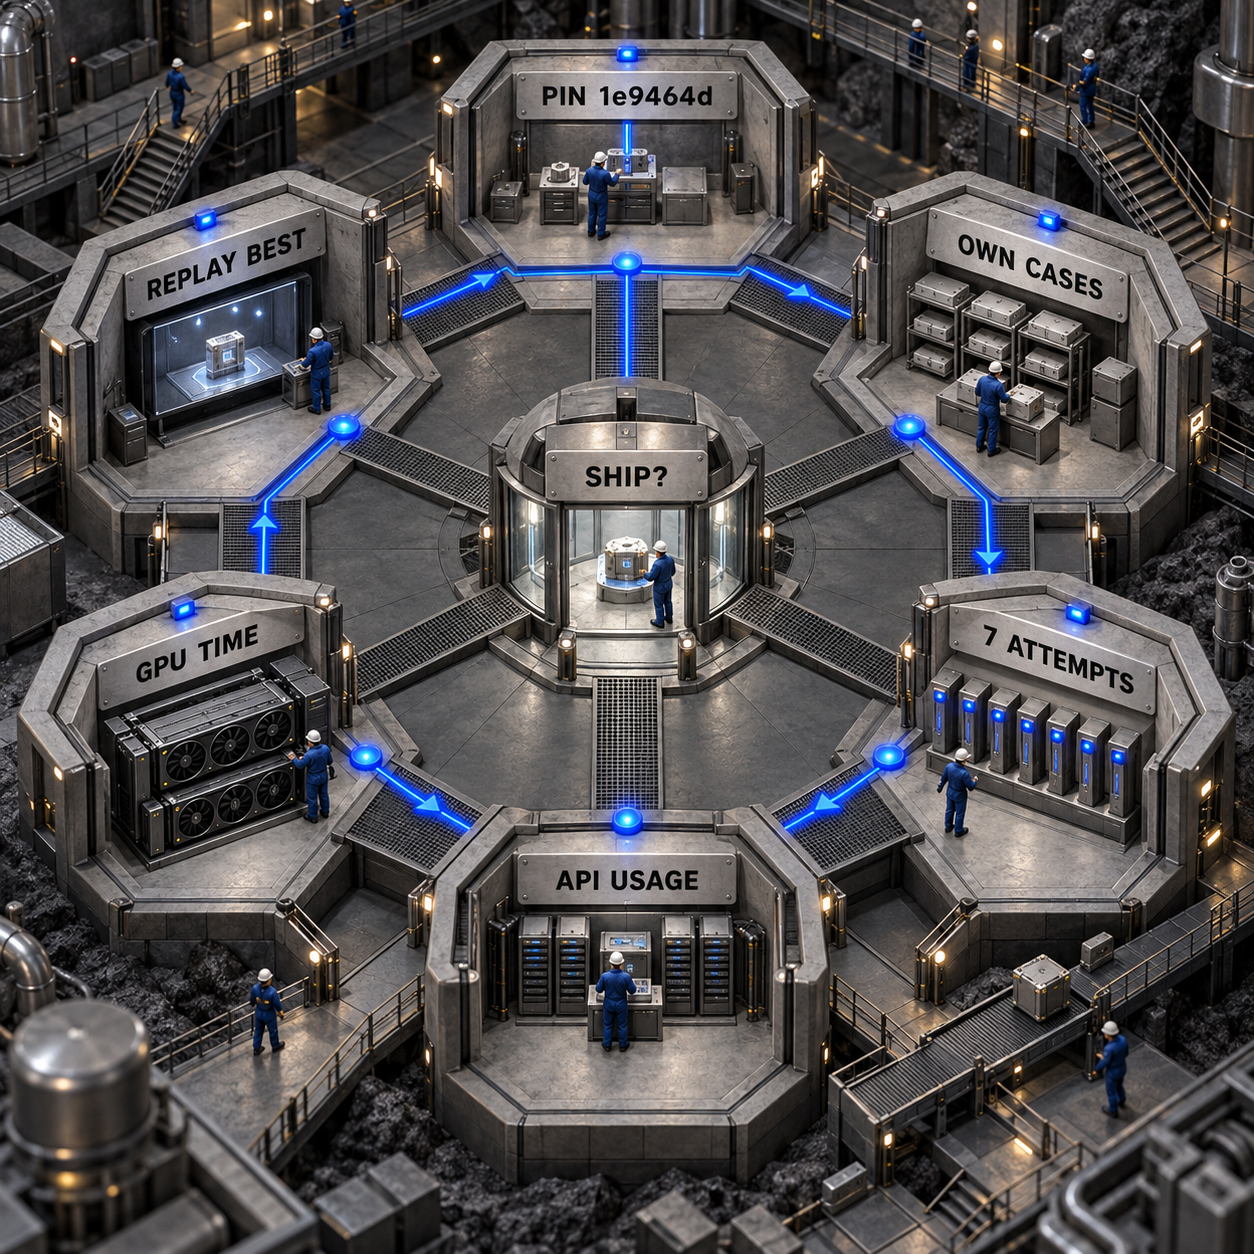
Mantén la GPU sin otras cargas mientras comparas los tiempos. La actividad en segundo plano puede convertir una pequeña mejora aparente en simple ruido de medición.
Lee las evidencias y repite la prueba del ganador
Trata el directorio de resultados como un paquete de auditoría, no como una vitrina de trofeos. Cada sesión se guarda en results/run-NNN/. Empieza por estos archivos:
history.jsoncontiene todos los intentos evaluados, los detalles de ejecución por caso, los resultados de validación, la configuración de lanzamiento y la latencia medida.summary.jsonidentifica la mejor iteración, la latencia por caso, las mejoras de velocidad disponibles frente a la línea base y el motivo de finalización.best.cues el candidato más rápido que aprobó todos los casos proporcionados.- Los archivos
best-case-N.jsonson solicitudes para repetir la ejecución del código ganador con los casos proporcionados. - Los archivos
model-*.jsony las respuestas de herramientas conservan la interacción del agente. Revisa sus metadatos de uso para contabilizar la API, porquesummary.jsonno suma el gasto del modelo. heatmap.pngyheatmap.svgmuestran el historial de tiempos. Sirven para orientarse, no como evidencia de corrección.
Cuenta los candidatos rechazados con el mismo cuidado que los válidos. Una ejecución con seis propuestas rechazadas y un único ganador estrecho cuenta una historia distinta de otra en la que todos los candidatos fueron válidos. Revisa los fallos de compilación, las diferencias en los resultados y si el código ganador realmente difiere de su predecesor.
A continuación, repite cada best-case-N.json guardado con el ejecutor de pruebas en la misma GPU inactiva. Después, prueba best.cu con la forma reservada y valores nuevos mediante un oráculo independiente. Los casos proporcionados solo demuestran que el candidato superó esos casos; no prueban la corrección general, la ausencia de condiciones de carrera ni un comportamiento seguro para todas las formas válidas.
Descarta el ganador si falla alguna prueba reservada, si al repetir la medición cruza la línea base dentro del margen de ruido o si la mejora desaparece en la aplicación real. Una referencia generada no sirve como único oráculo, y superar al kernel inicial generado no significa superar a cuBLAS ni a otra línea base de producción. El repositorio no publica ninguna comparación con cuBLAS.
Decide si la mejora de velocidad compensa
Calcula la rentabilidad del trabajo completo, no solo la puntuación del kernel aislado. El repositorio público no tiene un precio de suscripción, pero tampoco concede una licencia comercial. Aun así, el experimento consume tiempo de ingeniería, uso de la API del modelo y tiempo de GPU.
Una hoja de cálculo útil tiene tres líneas:
pilot cost = engineer setup and review + model charges + GPU wall-clock costsaved GPU hours per month = end-to-end milliseconds saved per invocation × monthly invocations ÷ 3,600,000payback months = pilot cost ÷ monthly gross GPU saving
Usa los milisegundos ahorrados de extremo a extremo después de la integración, no la latencia de eventos CUDA de summary.json. Si el kernel se ejecuta varias veces por solicitud, contabiliza las invocaciones medidas. Si una ejecución más rápida modifica el throughput, la presión de memoria o el batching, vuelve a medir la carga completa en lugar de extrapolar el resultado del kernel por simple suposición.
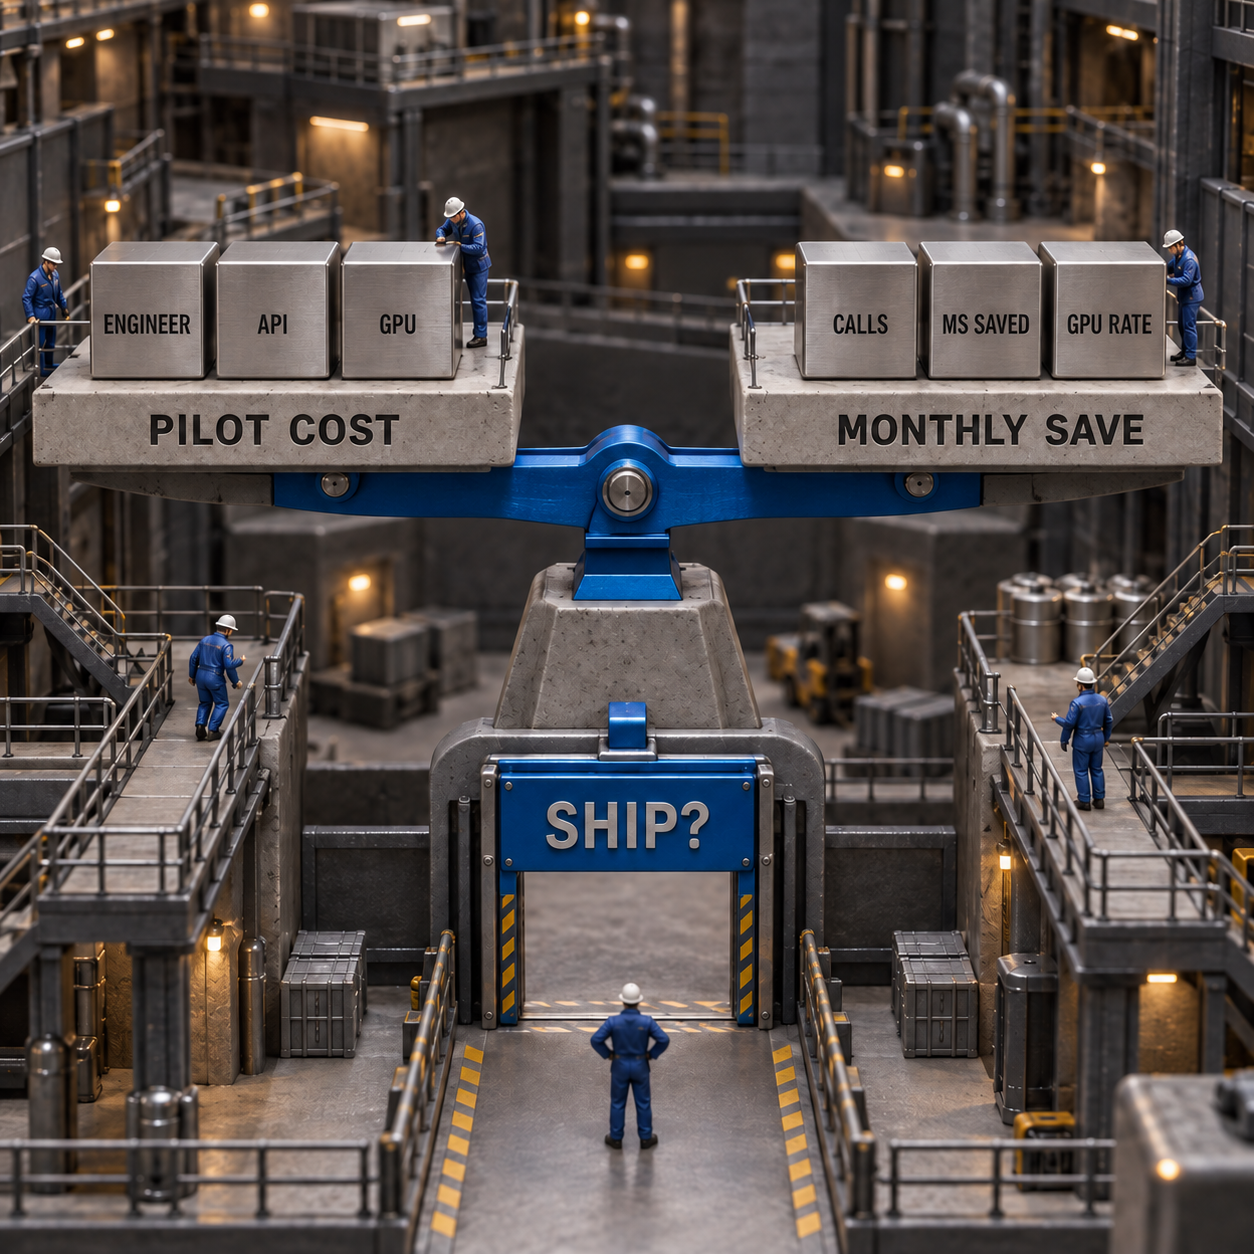
La alternativa humana tampoco es barata. La página de consultores CUDA de Upwork ofrece actualmente rangos orientativos de $500 a $1,200 por análisis de rendimiento y de $2,500 a $4,500 por ajuste de kernels. Son rangos de un marketplace, no cotizaciones, y tampoco demuestran que un agente sustituya a un especialista. Sí ayudan a entender por qué un experimento inicial repetible puede aportar valor si limita el trabajo experto costoso a candidatos respaldados por evidencias claras.
La regla para seguir o detenerse es tajante: avanza a una prueba de integración controlada solo cuando el candidato supere casos independientes, venza repetidamente a la línea base, mejore la carga real y tenga un plazo de amortización que el equipo haya definido antes de la ejecución.
Siete equipos que pueden aprovecharlo bien
Estos casos de uso están ordenados según la probabilidad de convertir una mejora validada del kernel en dinero o capacidad liberada.
Si la carga es una aplicación completa, una primitiva madura de un proveedor o un conjunto cambiante de formas, empieza por otra vía. Este optimizador es explícitamente experimental y está orientado a kernels individuales.
Para comparar sistemas cercanos, el artículo comparativo de agentes de IA para optimización GPU analiza AKO, KernelAgent, AutoKernel, Apex y CUDA Agent. El repositorio de Bertaye es un proyecto más reciente e independiente.
Dos productos con potencial a su alrededor
1. Auditoría acotada de optimización CUDA
Es la oportunidad más sólida. Ofrece un paquete de evidencias con alcance fijo a equipos que tienen un kernel CUDA costoso: captura del entorno, recepción de casos de confianza, una ejecución de siete intentos, repetición independiente, contabilidad del costo del modelo y de la GPU, y un informe que recomiende seguir o detenerse.
La demanda es pequeña, pero muy específica. DataForSEO registra unas 30 búsquedas mensuales en Estados Unidos para cuda optimization y 20 para cuda kernel optimization, ambas con poca competencia en publicidad de pago. En ese mismo mercado, Upwork muestra precios orientativos de $500 a $1,200 por profiling y de $2,500 a $4,500 por ajuste. La combinación apunta a un servicio experto de nicho, no a una aplicación masiva de autoservicio.
La versión mínima que se puede vender incluye un formulario seguro de recepción, un ejecutor GPU desechable, un manifiesto de casos bloqueado, un recopilador de costos de ejecución y un informe HTML con evidencias. Mantén a un revisor humano en el proceso. El obstáculo es la confianza: un solo ganador incorrecto puede borrar el valor de muchas auditorías exitosas, y la ausencia de licencia del repositorio obliga a obtener permiso antes de basar en su código un servicio comercial.
2. Control de regresiones de kernels GPU
Crea un servicio de CI controlado que repita kernels aprobados en hardware reservado, verifique las salidas guardadas y bloquee una versión cuando cambien la latencia o la corrección. Los equipos de plataforma GPU y las consultoras CUDA pagarían por un registro estable entre cambios de controlador, toolkit y código fuente.
DataForSEO registra unas 10 búsquedas mensuales en Estados Unidos para gpu performance optimization. Es un volumen demasiado bajo para un negocio basado solo en SEO, pero basta para validar el lenguaje que utilizan los compradores. La distribución debería llegar a través de consultoras, proveedores de GPU y equipos internos de plataforma.
Un MVP necesita una cola de hardware, huellas del entorno, casos de referencia firmados, mediciones repetidas, umbrales y una comparación compacta con la última ejecución aceptada. El problema es la variabilidad: los hosts compartidos, el estado térmico y los cambios de controlador pueden provocar falsas alarmas si el ejecutor no controla el equipo y repite las mediciones.
Límites que deben cambiar tu decisión
La conclusión honesta es que v0.0 constituye una estructura útil para experimentar, pero exige un grado elevado de confianza.
- Optimiza kernels CUDA individuales, no aplicaciones completas.
- Superar los casos proporcionados no demuestra la corrección general.
- Una referencia generada no es un oráculo independiente.
- Las mejoras de rendimiento dependen de la carga y del hardware.
- No se incluye ninguna comparación con cuBLAS ni con otra biblioteca de proveedor.
- La medición predeterminada no cuenta la compilación ni las repeticiones del profiler, por lo que no representa el costo total de ejecución.
- Los scripts de entrada generados se ejecutan localmente sin sandbox.
- La compilación documentada corresponde a Windows; cualquier otra plataforma necesita su propio registro de configuración verificada.
- La configuración de ejemplo mencionada no existe en el commit fijado.
- El repositorio no establece derechos de licencia comercial.
El ejecutor independiente merece la pena cuando necesitas etapas explícitas, evidencias persistentes y un presupuesto repetible. Un agente de programación general puede bastar si un especialista ya supervisa la terminal, las pruebas son sólidas y el trabajo es realmente puntual. El ejecutor solo justifica su lugar cuando esos límites y el historial de auditoría reducen el riesgo o la repetición.
Preguntas frecuentes
¿Cómo se utiliza Agentic CUDA Optimizer en un Mac?
El repositorio fijado documenta una compilación para Windows con una GPU NVIDIA y un entorno CUDA compatible, no una configuración para Mac. Utiliza un equipo NVIDIA remoto o desechable que puedas verificar, y documenta esa plataforma por separado en lugar de traducir los comandos de Windows por intuición.
¿Agentic CUDA Optimizer es lo mismo que CUDA Agent de ByteDance?
No. Esta guía trata sobre agentic-cuda-optimizer de Bertaye, un flujo de LangGraph con un ejecutor de pruebas CUDA en C++ publicado en septiembre de 2026. CUDA Agent de ByteDance y Tsinghua es otro sistema de investigación con un repositorio independiente.
¿Qué repositorio de CUDA-Agent en GitHub utiliza esta guía?
Utiliza bertaye/agentic-cuda-optimizer, fijado en el commit 1e9464d. Los resultados de búsqueda también muestran BytedTsinghua-SIA/CUDA-Agent, pero no es el software que se configura aquí.
¿El optimizador utiliza un NVIDIA CUDA Agent?
El ciclo documentado no incluye ningún agente independiente de NVIDIA. El proyecto puede recuperar de manera opcional recomendaciones de NVIDIA con --nvidia-research e inspeccionar contadores de Nsight Compute con --use-nsight, pero tanto la generación de candidatos como la orquestación siguen dentro del flujo propio de este repositorio.
El próximo lunes, da un paso concreto: asigna a un ingeniero de GPU un kernel float32 de bajo riesgo, un equipo NVIDIA desechable y un día para preparar la referencia independiente, los casos y la hoja de costos. Ejecuta el piloto de siete intentos solo cuando esos controles estén por escrito.
Si quieres integrar un experimento GPU medido y su proceso de revisión en un sistema de producción, el servicio adecuado es sistemas de IA en producción.
- Última actualización
- 25 sept 2026
- Categoría
- Build
Prefiera este sitio en Google


Marque omidsaffari.com como fuente preferida y Google lo destacará para usted en Top Stories, AI Overviews y AI Mode.

Runpod pricing en 2026: cuándo elegir Pods o Serverless
Compara los precios de Runpod para Pods, Serverless y almacenamiento, con cálculos de H100 y el punto de equilibrio según el tiempo facturable.25 sept 2026Build
Vercel Sandbox Drives: cómo crear espacios de trabajo persistentes
Aprende a montar Vercel Sandbox Drives, conservar archivos entre sandboxes y medir almacenamiento, lecturas, escrituras y costos de cómputo.25 sept 2026Build
Web scraping: 7 alternativas a Firecrawl comparadas
Comparamos 7 alternativas a Firecrawl para web scraping por costos, rastreo, Markdown, JSON, alojamiento propio y carga operativa en equipos pequeños.25 sept 2026Build
Alternativas a CodeRabbit: 7 opciones según precio y control
Comparamos 7 alternativas a CodeRabbit por precio, privacidad, compatibilidad con Git y control operativo para elegir la opción que mejor encaja con su equipo.25 sept 2026Build
CodeRabbit vs Greptile: precios, límites y cuál elegir
Comparamos CodeRabbit vs Greptile en precio, límites, profundidad de revisión y compatibilidad para saber qué revisor de código con IA encaja mejor.25 sept 2026Build
Perplexity Computer en local: guía para Windows con AMD
Guía para usar Perplexity Computer en local con Windows y Ryzen AI Max: requisitos, permisos, prueba de archivos y control del acceso a la nube.25 sept 2026Build
AgentRun a prueba: flujos de trabajo con IA bajo control
Probamos AgentRun beta.4 para flujos de trabajo con IA: contratos tipados, ramas visibles, llamadas limitadas y escalamiento explícito frente a otras opciones.24 sept 2026Build