Agentic CUDA Optimizer로 GPU 최적화하는 방법
Agentic CUDA Optimizer로 GPU 최적화를 안전하게 실험하는 방법을 알아봅니다. v0.0 커밋 고정, Windows 환경 설정, 7회 탐색, 정확성 검증, GPU 시간과 모델 비용 기록, best.cu 독립 재실행, 실제 워크로드의 비용 회수 판단까지 정리했습니다.


작은 float32 행렬 곱셈 커널 하나를 일곱 차례 탐색에 투입해 GPU 최적화를 시험합니다. 신뢰할 수 있는 모든 케이스를 통과한 후보만 남기고, 저장된 최종 후보가 모델 호출·GPU 시간·검토 작업에 든 비용을 회수하기 전에는 아무것도 배포하지 않습니다. 이 가이드는 Bertaye의 Agentic CUDA Optimizer를 다루며, ByteDance와 Tsinghua의 CUDA Agent 연구 시스템은 대상이 아닙니다.
한눈에 보는 결론
Agentic CUDA Optimizer는 자율 증명 도구가 아니라 통제된 실험 실행기로 사용해야 합니다. 초기 v0.0 커밋을 고정하고 문서화된 Windows 스택에서 C++ 테스트 러너를 빌드한 다음, 직접 준비한 참조 커널과 입력 케이스를 제공하고 --max-iterations 7로 탐색 범위를 제한합니다. 이후 별도로 재실행하기 전에 history.json, summary.json, best.cu를 직접 검토합니다.
이 옵티마이저는 후보 작성, 컴파일, 실행, 출력이 다를 때의 탈락 처리, 출력이 맞을 때의 시간 측정, 그리고 그 증거를 다음 시도에 반영하는 유용한 루프를 자동화합니다. 하지만 참조 구현이 옳은지, 테스트 케이스가 운영 환경을 충분히 포괄하는지, 단일 커널의 속도 향상이 전체 GPU 비용을 낮추는지까지 판단해 주지는 않습니다.
저장소는 2026년 9월 24일 19:41:43 UTC에 커밋 1e9464da54dfc651337a97c3643bfeefec712bc1로 공개되었습니다. 이 가이드는 이후 변경될 코드가 아니라 v0.0을 기준으로 하므로 해당 커밋을 고정하는 것이 중요합니다.
GPU 최적화 도구가 실제로 하는 일
검사 공정을 갖춘 모델 공방이라고 생각하면 이해하기 쉽습니다. 모델은 작업대 위의 작은 부품인 CUDA 커널을 다시 설계하고 실행 방식을 조정할 수 있습니다. 측정 장비는 테스트 러너가 통제합니다. 제공된 모든 케이스에서 허용 가능한 출력을 낸 후보만 최종 진열대에 오릅니다.
내부에서는 독립형 C++ 러너가 NVRTC로 CUDA 소스를 컴파일하고, CUDA Driver API로 실행한 뒤 출력을 저장합니다. Python은 이 출력을 참조 결과와 비교해 후보를 선별합니다. correctness로 표시된 케이스는 반드시 통과해야 하지만 점수에는 반영되지 않습니다. performance로 표시된 케이스는 검증과 함께 순위 산정에 쓰이는 기하평균 지연 시간에도 반영됩니다.
기본 설정에서는 시간 측정 케이스마다 CUDA 이벤트를 사용해 10회의 워밍업 실행과 100회의 측정 실행을 수행합니다. 이 수치는 작업 전체의 비용이 아니라 커널 실행 시간만 나타냅니다. 컴파일, 모델 호출, 실패한 시도, 입력 생성, 프로파일러 재실행, 사람의 검토는 모두 이 지연 시간에 포함되지 않습니다.
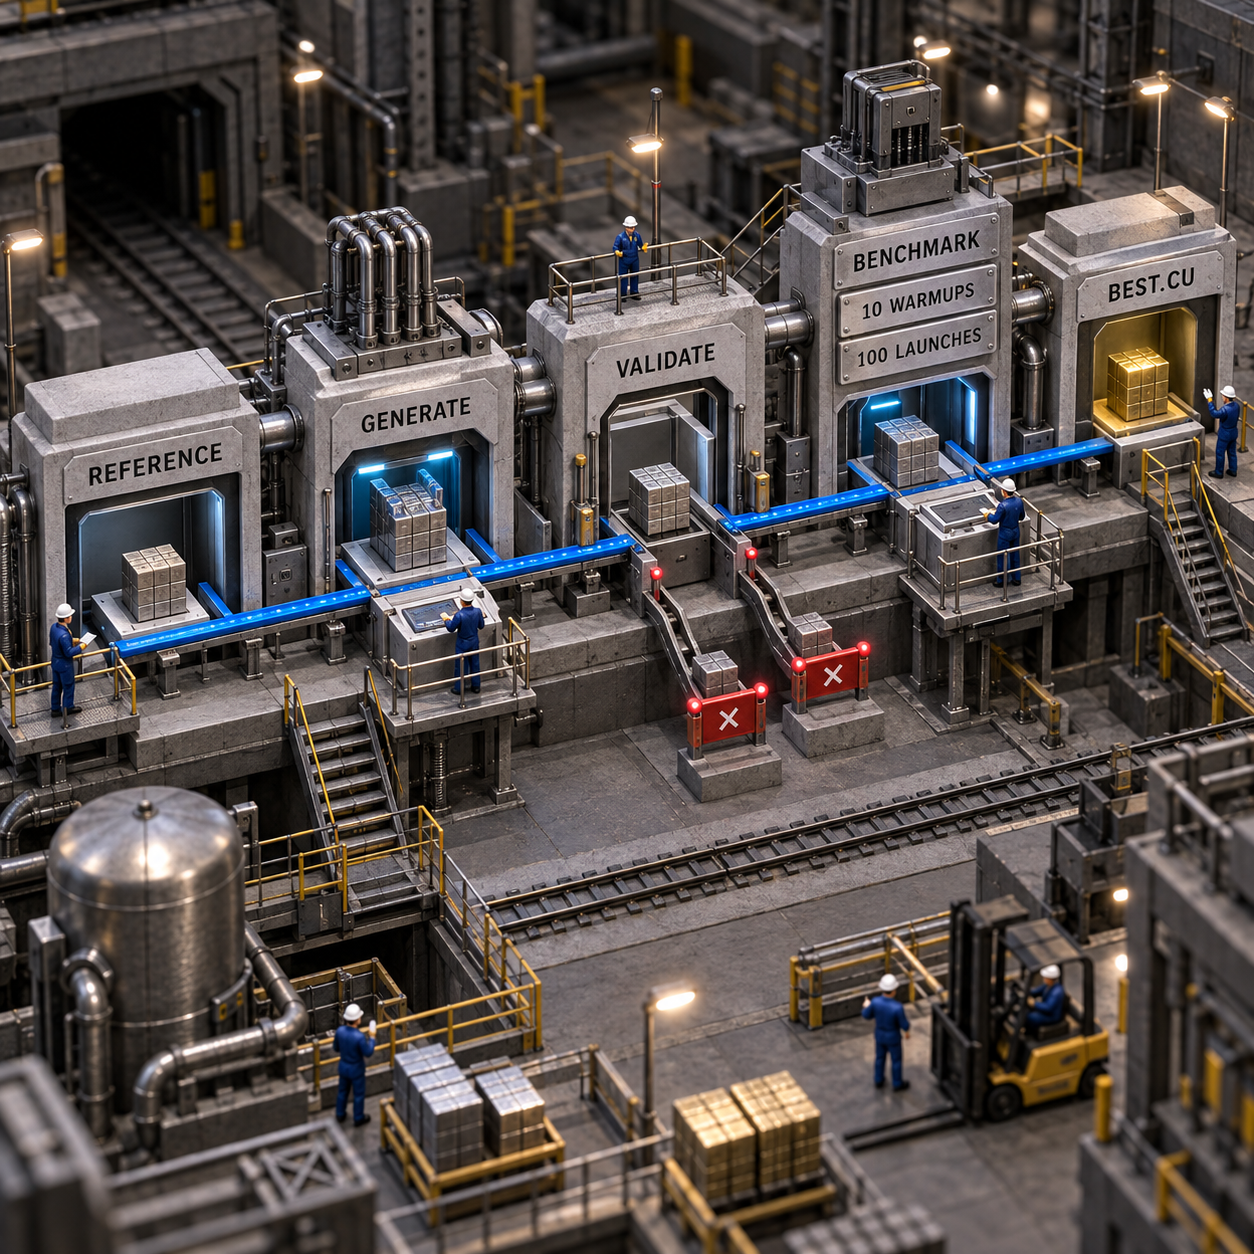
이런 역할 분리가 있기 때문에 범용 코딩 에이전트에게 한 번의 프롬프트로 영리한 커널 하나를 만들어 달라고 하는 대신 테스트 러너를 사용할 이유가 생깁니다. 핵심 이점은 단계별 관문이 분명하고 기록이 남으며 범위가 제한된 루프라는 점입니다. LangGraph가 유능한 코딩 에이전트보다 더 나은 답을 반드시 찾아준다는 뜻은 아닙니다. 저장소 작성자도 출시 당시 논의에서 같은 취지로 설명했습니다. 가치는 각 단계를 둘러싼 통제 장치에 있습니다.
고정한 Windows 빌드 환경 설정
먼저 문서에 나온 Windows 경로를 그대로 따릅니다. 이 저장소는 RTX 3060 Laptop GPU에서 개발되었으며 C++ 도구를 포함한 Visual Studio 2026 환경을 안내합니다. 컴파일에 앞서 Python 3.12 이상, CMake 3.24 이상, C++17 컴파일러, NVIDIA 드라이버, 호환되는 CUDA Toolkit이 있는지 확인합니다.
python --version
cmake --version
where.exe cl
nvidia-smi
nvcc --version

git clone https://github.com/bertaye/agentic-cuda-optimizer.git
cd agentic-cuda-optimizer
git checkout --detach 1e9464da54dfc651337a97c3643bfeefec712bc1

python -m venv .venv
.venv\Scripts\python -m pip install -r optimizer_agent/requirements.txt
cmake -S cuda_test_harness -B cuda_test_harness/build -DCMAKE_BUILD_TYPE=Release
cmake --build cuda_test_harness/build --parallel

Set-Content .env 'OPENAI_API_KEY=your-key-here'
필수 조건 검사 중 하나라도 실패하면 멈춰야 합니다. 에이전트가 커널을 바꾸는 동안 툴체인 문제까지 함께 해결하면 실패 원인을 구분하기 어려워집니다.
v0.0에서 주의할 점은 두 가지입니다.
- README는
--config optimizer_agent/example.json을 제안하지만, 고정한 커밋에는 해당 파일이 없습니다. 명시적인 플래그를 사용하거나 자체 설정 파일을 만들고 검토해야 합니다. - 공개 저장소에는 라이선스 파일이 없으며 GitHub도 감지된 라이선스가 없다고 표시합니다. 코드가 공개되어 있다는 사실만으로 상업적 사용 허가를 받은 것은 아닙니다. 회사에서 사용하거나 재배포하거나 유료 제품에 적용하기 전에 허가를 받거나 법률 검토를 거쳐야 합니다.
이 버전에는 다른 플랫폼을 위한 문서화된 설정 경로가 없습니다. 이 글을 위해 Linux 환경도 점검했지만 필요한 CUDA 및 빌드 도구가 없었습니다. 따라서 이는 성공적인 Linux 테스트가 아니라 필수 조건 감사에 그쳤습니다.
마지막으로 실행 장비를 격리합니다. 옵티마이저가 입력을 만들도록 허용하면 생성된 Python 코드가 샌드박스 없이 로컬에서 실행됩니다. 생성된 CUDA 코드도 GPU에서 직접 실행됩니다. 권한을 최소화한 일회용 호스트나 VM을 사용하고, 운영 데이터와 무관한 비밀 정보 및 중요한 파일 공유에는 접근하지 못하게 해야 합니다.
실패 가능성이 정직하게 드러나는 실험 설계
계약을 한 페이지 안에 설명할 수 있는 커널 하나부터 시작합니다. 행 우선 float32 행렬 곱셈은 입력·출력·차원이 명확해 첫 실험에 적합합니다. 동시에 홀수 크기를 넣으면 다루기 쉬운 정사각형 케이스가 놓칠 수 있는 경계 처리를 드러낼 수 있습니다.
옵티마이저의 결과 디렉터리 밖에 다음 세 가지 자산을 준비합니다.
reference.cu: 신뢰할 수 있는 출처에서 가져와 검토를 마친 단순한 구현입니다. 같은 모델에 오라클과 후보를 모두 만들게 해서는 안 됩니다.initial.cu: 실제로 배포하려던 기준 구현입니다. 품질이 낮은 생성 코드보다 크게 빨라진 결과를 사업적 성과로 오인하지 않게 해줍니다.input_cases.json: 고정되어 재현 가능한 바이너리 입력과 수치 계약에 맞는 유의미한 비교 허용 오차를 담습니다.
범위를 제한한 파일럿에는 M=31, N=37, K=29처럼 홀수 형태의 정확성 케이스 하나와 256×256×256, M=384, N=256, K=320처럼 적당한 크기의 성능 케이스 두 개를 넣을 수 있습니다. 이는 저장소의 벤치마크 결과가 아니라 실험 설계를 위한 제안입니다. 네 번째 홀드아웃 형태와 새로운 값은 옵티마이저 밖에 보관해, 최종 후보가 탐색 중 보지 못한 케이스를 통과하게 합니다.
영이나 일로만 채운 값이 아니라 충분히 다양한 값을 사용합니다. 모든 버퍼 크기, 인수 순서, 스칼라 타입, 허용 오차를 검토합니다. 매니페스트에는 최소 하나의 performance 케이스가 있어야 합니다. 모든 케이스를 통과해야 하지만 순위에는 성능 케이스만 반영됩니다.
실행 전에 참조 구현, 입력, 테스트 러너를 해시하거나 복사해 둡니다. 옵티마이저가 바꿀 수 있는 대상은 후보 소스와 케이스별 실행 설정이어야 하며, 성공의 정의 자체가 바뀌어서는 안 됩니다.
개선 시도는 정확히 일곱 번만 실행합니다
아래 명령은 입력을 명시적으로 지정하고 문서에 나온 Windows 인터프리터 경로를 사용합니다. 엔트리 시그니처를 고정하고 독립적인 참조 구현과 실제 기준 구현을 제공하며, 개선 예산을 일곱 번으로 제한합니다.
.venv\Scripts\python optimizer_agent\optimizer_agent.py `
  --description "Row-major float32 matrix multiplication C=MxN from A=MxK and B=KxN." `
  --signature 'extern "C" __global__ void matmul_f32(const float* a, const float* b, float* c, int m, int n, int k)' `
  --reference .\experiment\reference.cu `
  --initial-kernel .\experiment\initial.cu `
  --input-cases .\experiment\input_cases.json `
  --max-iterations 7
기본 모델은 중간 수준의 추론 강도를 사용하는 gpt-5-mini이며 API 사용료는 사용자 계정에 청구됩니다. 개선 시도가 일곱 번이라고 해서 모델 호출이나 커널 실행도 일곱 번이라는 뜻은 아닙니다. 한 번의 제안에 툴 호출과 수정 재시도가 포함될 수 있고, 시간 측정 케이스 하나만으로도 기본 10회의 워밍업과 100회의 측정 실행이 이뤄집니다.
첫 번째 기준 실행에서는 --use-nsight와 --nvidia-research를 끈 채로 둡니다. Nsight 프로파일링은 재실행 작업을 추가하며 Nsight Compute와 GPU 성능 카운터를 읽을 권한도 필요합니다. NVIDIA research는 모델 및 검색 작업을 더합니다. 기본 루프가 안정된 뒤 한 번에 변수 하나씩 추가합니다.
Enter를 누르기 전에 실험 로그를 열고 다음 항목을 기록합니다.
- 고정한 커밋과 작업 트리 변경 여부
- GPU 모델, 드라이버, CUDA Toolkit 버전
- 참조 구현 및 케이스 해시
- 시작 및 종료 시각
- 전체 GPU 벽시계 시간
- 저장된 응답 파일에서 확인할 수 있는 모델 이름, 호출 수, 토큰 또는 기타 사용량 메타데이터
- 유효 후보, 탈락 후보, 탈락 사유
- 기준 구현과 최종 후보의 케이스별 지연 시간
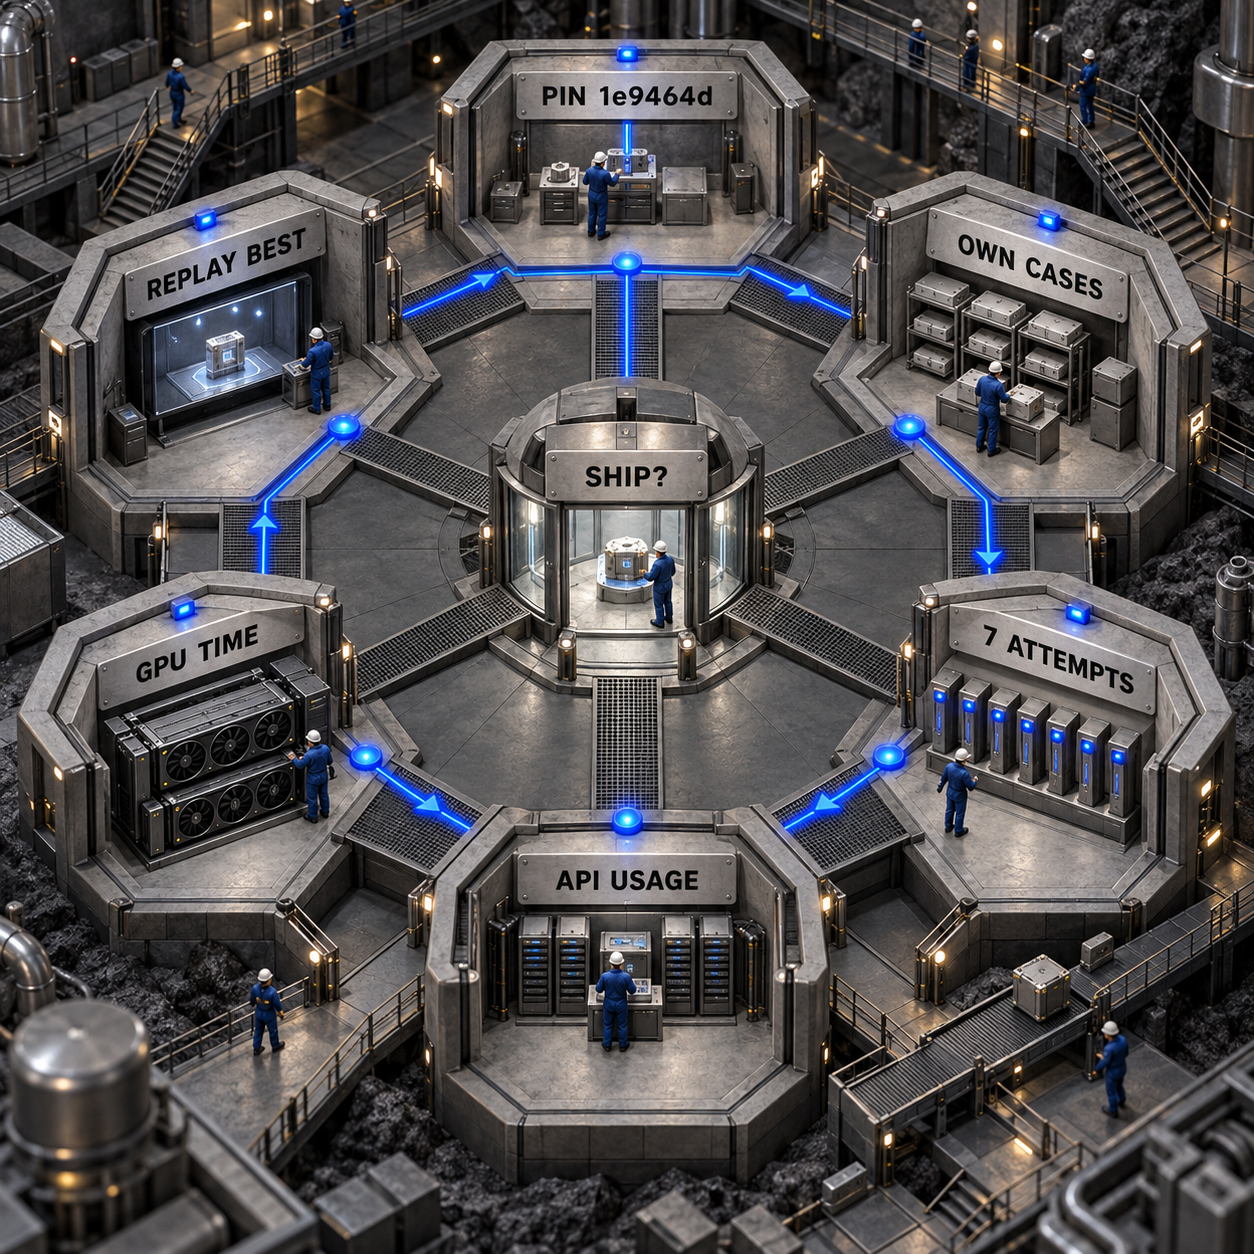
시간을 비교하는 동안에는 GPU가 다른 작업을 하지 않게 유지합니다. 백그라운드 GPU 작업이 있으면 작아 보이는 성능 향상이 측정 노이즈로 바뀔 수 있습니다.
증거를 읽은 뒤 최종 후보를 다시 실행합니다
결과 디렉터리는 전리품 보관함이 아니라 감사 자료 묶음으로 취급합니다. 각 세션은 results/run-NNN/ 아래에 저장됩니다. 먼저 다음 파일을 확인합니다.
history.json에는 평가한 모든 시도, 케이스별 실행 세부 정보, 검증 결과, 실행 설정, 측정 지연 시간이 담깁니다.summary.json에는 최적 반복 회차, 케이스별 지연 시간, 확인 가능한 기준 대비 속도 향상, 종료 사유가 기록됩니다.best.cu는 제공된 모든 케이스를 통과한 후보 중 가장 빠른 커널입니다.best-case-N.json파일은 제공된 케이스에서 최종 소스를 다시 실행하기 위한 요청입니다.model-*.json과 툴 응답 파일에는 에이전트 상호작용이 보존됩니다.summary.json은 모델 지출 총액을 계산하지 않으므로 이 파일들의 사용량 메타데이터를 확인해 API 비용을 집계합니다.heatmap.png와heatmap.svg는 시간 측정 이력을 보여줍니다. 탐색을 돕는 자료일 뿐 정확성의 증거는 아닙니다.
유효한 후보만큼 탈락 후보도 꼼꼼히 셉니다. 제안 여섯 개가 탈락하고 좁은 조건의 최종 후보 하나만 남은 실행은 모든 후보가 유효했던 실행과 전혀 다른 정보를 줍니다. 컴파일 실패, 출력 불일치, 최종 소스가 상위 후보와 실제로 달라졌는지를 검토합니다.
그다음 동일한 유휴 GPU에서 저장된 각 best-case-N.json을 테스트 러너로 다시 실행합니다. 이어서 독립적인 오라클로 홀드아웃 형태와 새로운 값에 대해 best.cu를 테스트합니다. 제공된 케이스가 입증하는 것은 후보가 그 케이스들을 통과했다는 사실뿐입니다. 일반적인 정확성, 경쟁 상태의 부재, 모든 유효 형태에서의 안전한 동작까지 증명하지는 않습니다.
홀드아웃 하나라도 실패하거나, 반복 측정 결과가 노이즈 범위 안에서 기준선과 겹치거나, 실제 애플리케이션에서 이점이 사라지면 최종 후보를 폐기합니다. 생성된 참조 구현만을 오라클로 삼아서는 안 되며, 생성된 초기 커널을 이겼다고 해서 cuBLAS나 다른 운영 기준 구현을 이긴 것은 아닙니다. 이 저장소는 cuBLAS 비교 결과를 공개하지 않습니다.
속도 향상이 비용을 회수하는지 판단합니다
단일 커널 점수가 아니라 전체 작업의 경제성으로 결정합니다. 공개 저장소에는 구독료가 없지만 상업적 이용을 허용하는 라이선스도 없습니다. 실험에는 여전히 엔지니어 시간, 모델 API 사용량, GPU 시간이 들어갑니다.
유용한 계산표에는 다음 세 줄이 들어갑니다.
pilot cost = engineer setup and review + model charges + GPU wall-clock costsaved GPU hours per month = end-to-end milliseconds saved per invocation × monthly invocations ÷ 3,600,000payback months = pilot cost ÷ monthly gross GPU saving
summary.json의 CUDA 이벤트 지연 시간이 아니라 통합 후 실제로 줄어든 엔드투엔드 밀리초를 사용합니다. 커널이 요청마다 여러 차례 실행된다면 측정된 호출 수를 반영합니다. 실행 속도 향상이 처리량, 메모리 압박, 배치 방식에 영향을 준다면 커널 결과를 추정으로 확대하지 말고 전체 워크로드를 다시 측정합니다.
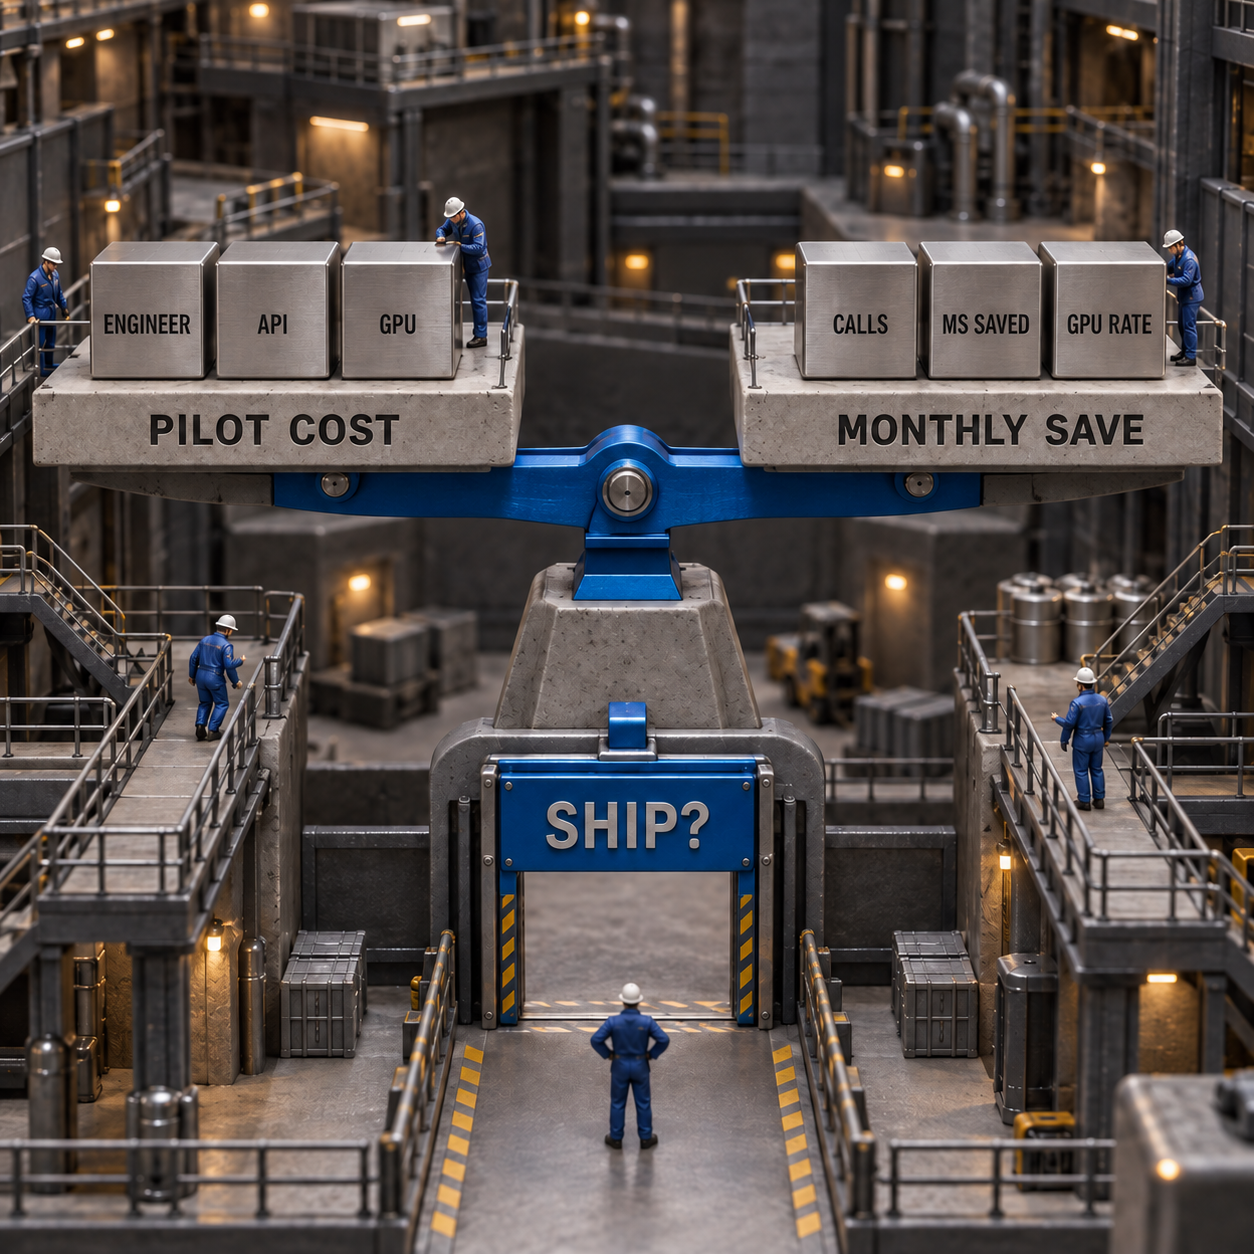
사람이 직접 최적화하는 대안도 저렴하지 않습니다. Upwork의 CUDA 컨설턴트 페이지가 현재 제시하는 계획 범위는 성능 프로파일링 $500~$1,200, 커널 튜닝 $2,500~$4,500입니다. 이는 마켓플레이스의 범위일 뿐 견적이 아니며, 에이전트가 전문가를 대체한다는 증거도 아닙니다. 다만 반복 가능한 초기 실험이 깔끔한 증거를 갖춘 후보로 범위를 좁혀 준다면, 비용이 큰 전문가 작업을 줄이는 데 가치가 있을 수 있음을 보여줍니다.
진행 여부를 정하는 규칙은 단호해야 합니다. 후보가 독립적인 케이스를 통과하고, 반복해서 기준 구현을 앞서며, 실제 워크로드를 개선하고, 실행 전에 팀이 정한 회수 기간을 충족할 때만 통제된 통합 테스트로 넘깁니다.
GPU 최적화 효과를 얻기 좋은 일곱 팀
다음 활용 사례는 검증된 커널 성능 향상을 실제 비용 절감이나 여유 용량으로 전환할 가능성이 높은 순서입니다.
워크로드가 전체 애플리케이션이거나, 성숙한 공급사 프리미티브이거나, 형태가 계속 바뀌는 집합이라면 다른 접근부터 시작해야 합니다. 이 옵티마이저는 명시적으로 실험용이며 개별 커널을 대상으로 합니다.
인접 시스템을 더 폭넓게 살펴보려면 기존의 GPU 최적화용 AI 에이전트 비교를 참고할 수 있습니다. 이 글은 AKO, KernelAgent, AutoKernel, Apex, CUDA Agent를 다룹니다. Bertaye의 저장소는 이들과 별개인 더 새로운 프로젝트입니다.
이 도구를 기반으로 만들 만한 두 가지 제품
1. 범위가 명확한 CUDA 최적화 감사
가장 가능성이 큰 기회입니다. 비용이 큰 CUDA 커널 하나를 보유한 팀에 범위가 고정된 증거 패키지를 판매합니다. 환경 기록, 신뢰할 수 있는 케이스 접수, 일곱 번의 시도, 독립 재실행, 모델 및 GPU 비용 집계, 진행 여부 보고서를 묶는 방식입니다.
수요는 작지만 매우 구체적입니다. DataForSEO에 따르면 미국에서 cuda optimization은 한 달 약 30회, cuda kernel optimization은 20회 검색되며 둘 다 유료 검색 경쟁이 낮습니다. 같은 시장에서 Upwork가 제시하는 계획 가격은 프로파일링 $500~$1,200, 튜닝 $2,500~$4,500입니다. 이 조합은 대중적인 셀프서비스 앱이 아니라 전문성이 필요한 틈새 서비스를 가리킵니다.
판매 가능한 최소 버전은 안전한 접수 양식, 일회용 GPU 러너, 잠긴 케이스 매니페스트, 실행 비용 수집기, HTML 증거 보고서로 구성됩니다. 사람의 검토는 계속 포함해야 합니다. 문제는 신뢰입니다. 잘못된 최종 후보 하나가 여러 차례 성공한 감사의 가치를 지울 수 있고, 저장소에 라이선스가 없으므로 코드를 기반으로 상업 서비스를 만들기 전에는 허가가 필요합니다.
2. GPU 커널 회귀 테스트 관문
예약된 하드웨어에서 승인된 커널을 다시 실행하고 저장된 출력을 검사하며, 지연 시간이나 정확성이 나빠지면 릴리스를 차단하는 통제된 CI 서비스를 만들 수 있습니다. GPU 플랫폼 팀과 CUDA 컨설팅 업체는 드라이버, 툴킷, 소스 변경 전반에 걸친 안정적인 기록에 비용을 지불할 가능성이 있습니다.
DataForSEO에 따르면 미국에서 gpu performance optimization은 한 달 약 10회 검색됩니다. SEO만으로 사업을 운영하기에는 너무 적지만, 구매자가 실제로 쓰는 표현을 확인하기에는 충분합니다. 유통은 컨설팅 업체, GPU 공급사, 내부 플랫폼 팀을 통해 이뤄져야 합니다.
MVP에는 하드웨어 대기열, 환경 지문, 서명된 참조 케이스, 반복 측정, 임곗값, 마지막 승인 실행과 비교한 간결한 차이가 필요합니다. 문제는 변동성입니다. 러너가 장비를 통제하고 측정을 반복하지 않으면 공유 호스트, 열 상태, 드라이버 변경 때문에 잘못된 경고가 발생할 수 있습니다.
의사결정을 바꿔야 할 한계
솔직히 말하면 v0.0은 유용한 실험용 골격이지만 검증 책임이 큽니다.
- 전체 애플리케이션이 아니라 개별 CUDA 커널을 최적화합니다.
- 제공된 케이스를 통과했다고 해서 일반적인 정확성이 입증되지는 않습니다.
- 생성된 참조 구현은 독립적인 오라클이 아닙니다.
- 성능 향상은 워크로드와 하드웨어에 따라 달라집니다.
- cuBLAS나 다른 공급사 라이브러리와 비교한 결과가 없습니다.
- 기본 시간 측정에는 컴파일과 프로파일러 재실행이 빠져 있어 전체 실행 비용을 나타내지 않습니다.
- 생성된 입력 스크립트가 샌드박스 없이 로컬에서 실행됩니다.
- 문서화된 빌드 경로는 Windows이며, 다른 플랫폼에서는 별도로 검증된 설정 기록이 필요합니다.
- 고정한 커밋에는 이름이 언급된 예제 설정 파일이 없습니다.
- 저장소는 상업적 이용 권리를 확립해 주지 않습니다.
독립된 러너는 단계가 명확하고 증거가 지속적으로 보존되며 예산을 반복해서 적용할 수 있어야 할 때 유용합니다. 전문가가 이미 터미널을 감독하고, 테스트가 강력하며, 실제로 한 번만 수행할 작업이라면 범용 코딩 에이전트로 충분할 수 있습니다. 통제 장치와 감사 추적이 위험이나 반복 작업을 줄일 때만 러너를 둘 가치가 있습니다.
자주 묻는 질문
Mac에서 Agentic CUDA Optimizer를 어떻게 사용하나요?
고정한 저장소가 문서화한 것은 NVIDIA GPU와 호환되는 CUDA 스택을 갖춘 Windows 빌드이지 Mac 설정이 아닙니다. 검증 가능한 원격 또는 일회용 NVIDIA 장비를 사용하고, Windows 명령을 추측으로 옮기지 말고 해당 플랫폼을 별도로 명시해야 합니다.
Agentic CUDA Optimizer와 ByteDance CUDA Agent는 같은 도구인가요?
아닙니다. 이 가이드는 2026년 9월에 공개된 LangGraph 워크플로와 C++ CUDA 테스트 러너로 구성된 Bertaye의 agentic-cuda-optimizer를 다룹니다. ByteDance와 Tsinghua의 CUDA Agent는 별도의 연구 시스템이자 저장소입니다.
이 가이드가 사용하는 CUDA-Agent GitHub 저장소는 무엇인가요?
bertaye/agentic-cuda-optimizer의 커밋 1e9464d를 고정해 사용합니다. 검색 결과에는 BytedTsinghua-SIA/CUDA-Agent도 나타나지만, 이 글에서 설정하는 소프트웨어는 아닙니다.
옵티마이저가 NVIDIA CUDA Agent를 사용하나요?
문서에 나온 루프에는 별도의 NVIDIA 에이전트가 없습니다. 프로젝트는 선택적으로 --nvidia-research로 NVIDIA 지침을 검색하고 --use-nsight로 Nsight Compute 카운터를 확인할 수 있지만, 후보 생성과 오케스트레이션은 계속 이 저장소 자체의 워크플로에서 이뤄집니다.
월요일에 할 일은 간단합니다. GPU 엔지니어 한 명에게 위험이 낮은 float32 커널 하나, 일회용 NVIDIA 장비 한 대, 독립적인 참조 구현·케이스·비용표를 준비할 하루를 배정합니다. 이 관문을 문서로 확정한 뒤에만 일곱 번의 파일럿을 실행합니다.
측정 가능한 GPU 실험과 검토 절차를 운영 시스템에 포함하려면 AI 운영 시스템에서 시작하는 것이 맞습니다.
- 마지막 업데이트
- 2026년 9월 25일
- 카테고리
- Build
Google에서 이 사이트를 우선하기


omidsaffari.com을 선호 소스로 지정하면 Google이 Top Stories, AI Overviews, AI Mode에서 우선적으로 보여 줍니다.

Runpod 가격 총정리: Pod와 Serverless, 비용은 언제 갈릴까?
Runpod 가격을 H100 Pod, Serverless, 스토리지까지 실제 수치로 비교합니다. 100시간·730시간·요청별 비용과 60.33% 손익분기점, Secure Cloud와 Community Cloud의 차이를 살펴보고 워크로드별 최적의 선택을 확인하세요.2026년 9월 25일Build
코딩 에이전트를 위한 Vercel Sandbox Drive 실전 가이드
코딩 에이전트의 작업 폴더와 의존성 캐시를 Vercel Sandbox Drive에 보존하는 방법을 알아봅니다. 단일 쓰기 규칙, 스냅샷 읽기, 리전 제약, 스토리지·읽기·쓰기·컴퓨팅 비용, 검증 절차를 바탕으로 재시작 시간을 줄일 가치가 있는지 판단합니다.2026년 9월 25일Build
Firecrawl 대안 7선: 실전 웹 크롤러 비용·기능 비교
Firecrawl 대안 7종을 웹 크롤러 기능, Markdown·JSON 출력, 검수 통과 페이지 비용, 이전 난이도로 비교합니다. Apify, Crawl4AI, ScrapFly 등 팀의 URL 탐색 범위와 운영 방식에 맞는 선택 기준을 한눈에 확인하세요.2026년 9월 25일Build
AI 코드 리뷰 도구 7선: CodeRabbit 대안 비용 비교
AI 코드 리뷰 도구를 찾는 팀을 위해 CodeRabbit과 Greptile, cubic, Qodo, PR-Agent, Kodus, Cursor Bugbot, GitHub Copilot의 가격, Git 호스트, 데이터 경계, 셀프호스팅 조건을 같은 기준으로 비교했습니다.2026년 9월 25일Build
CodeRabbit vs Greptile: AI 코드 리뷰 도구, 무엇을 고를까
CodeRabbit과 Greptile의 요금, 리뷰 한도, 플랫폼 지원, 런타임 검증을 비교합니다. 작성자 다섯 명의 100·300·600회 리뷰 비용표와 반복 리뷰, 작성자별 과금 구조를 바탕으로 어떤 AI 코드 리뷰 도구가 워크로드에 맞는지 확인하세요.2026년 9월 25일Build
AI 에이전트를 PC에서 실행하는 법: Perplexity Portable Computer 가이드
AMD Ryzen AI Max Windows PC에서 Perplexity Portable Computer로 AI 에이전트 로컬 실행법을 알아봅니다. 지원 사양, 모델 설치, 폴더 권한, 3개 예외 테스트, 예약 작업과 클라우드 승인에 따른 비용·데이터 경계까지 단계별로 정리했습니다.2026년 9월 25일Build
AgentRun 리뷰: AI 에이전트 프레임워크가 필요한 순간
AgentRun beta.4를 직접 설치해 4가지 지원 시나리오와 31개 테스트로 검증했습니다. 스키마 검사, 호출 제한, 에스컬레이션, 실제 비용과 한계를 바탕으로 이 AI 에이전트 프레임워크가 어떤 팀에 적합한지 정리하고 현실적인 도입 판단 기준을 제시합니다.2026년 9월 24일Build