Performance GPU : bien utiliser Agentic CUDA Optimizer
Configurez Agentic CUDA Optimizer, encadrez l’optimisation d’un kernel CUDA et validez exactitude, temps GPU et coûts du modèle avant tout déploiement.


Faites passer un petit kernel de multiplication matricielle en float32 par une recherche en sept tentatives, ne conservez un candidat que s’il réussit tous les cas de référence, puis ne déployez rien avant d’avoir vérifié que le gain de performance GPU du vainqueur rembourse les appels au modèle, le temps GPU et le travail de revue. Ce guide porte sur Agentic CUDA Optimizer de Bertaye, et non sur le système de recherche CUDA Agent de ByteDance et Tsinghua.
La réponse courte
Utilisez Agentic CUDA Optimizer comme un banc d’essai balisé, pas comme une machine à produire des preuves de façon autonome. Épinglez le commit initial v0.0, compilez son exécuteur de tests C++ avec l’environnement Windows documenté, fournissez votre propre kernel de référence et vos propres cas d’entrée, limitez la recherche avec --max-iterations 7, puis auditez history.json, summary.json et best.cu avant de procéder à un rejeu séparé.
L’outil automatise une boucle utile : écrire un candidat, le compiler, l’exécuter, l’écarter si ses sorties diffèrent, le chronométrer si elles sont conformes, puis réinjecter ces résultats dans la tentative suivante. En revanche, il ne peut ni certifier la justesse de votre référence, ni garantir que vos cas couvrent la production, ni conclure qu’un kernel isolé plus rapide réduira la facture GPU globale.
Le dépôt a été publié avec le commit 1e9464da54dfc651337a97c3643bfeefec712bc1, le 24 septembre 2026 à 19:41:43 UTC. Épingler ce commit est essentiel : ce guide décrit la v0.0, pas les modifications qui pourraient suivre.
Ce que l’outil mesure vraiment en matière de performance GPU
Imaginez un atelier piloté par un modèle et jalonné de contrôles qualité. Le modèle peut redessiner la petite pièce posée sur l’établi — le kernel CUDA — et ajuster son mode de lancement. L’exécuteur de tests commande les instruments de mesure. Un candidat n’est retenu qu’après avoir produit une sortie acceptable pour chacun des cas fournis.
Concrètement, un exécuteur C++ autonome compile le code source CUDA avec NVRTC, le lance via l’API CUDA Driver et enregistre les sorties. Python compare ensuite ces sorties à la référence et sélectionne les candidats. Les cas marqués correctness doivent réussir, mais n’entrent pas dans le score. Ceux marqués performance servent à la fois à valider le résultat et à calculer la moyenne géométrique des latences utilisée pour le classement.
Par défaut, chaque cas chronométré reçoit 10 lancements de préchauffage et 100 lancements mesurés à l’aide d’événements CUDA. Ces valeurs décrivent le temps du kernel, pas le coût du travail complet. La compilation, les appels au modèle, les tentatives rejetées, la génération des entrées, les relectures du profiler et la revue humaine restent hors de cette latence.
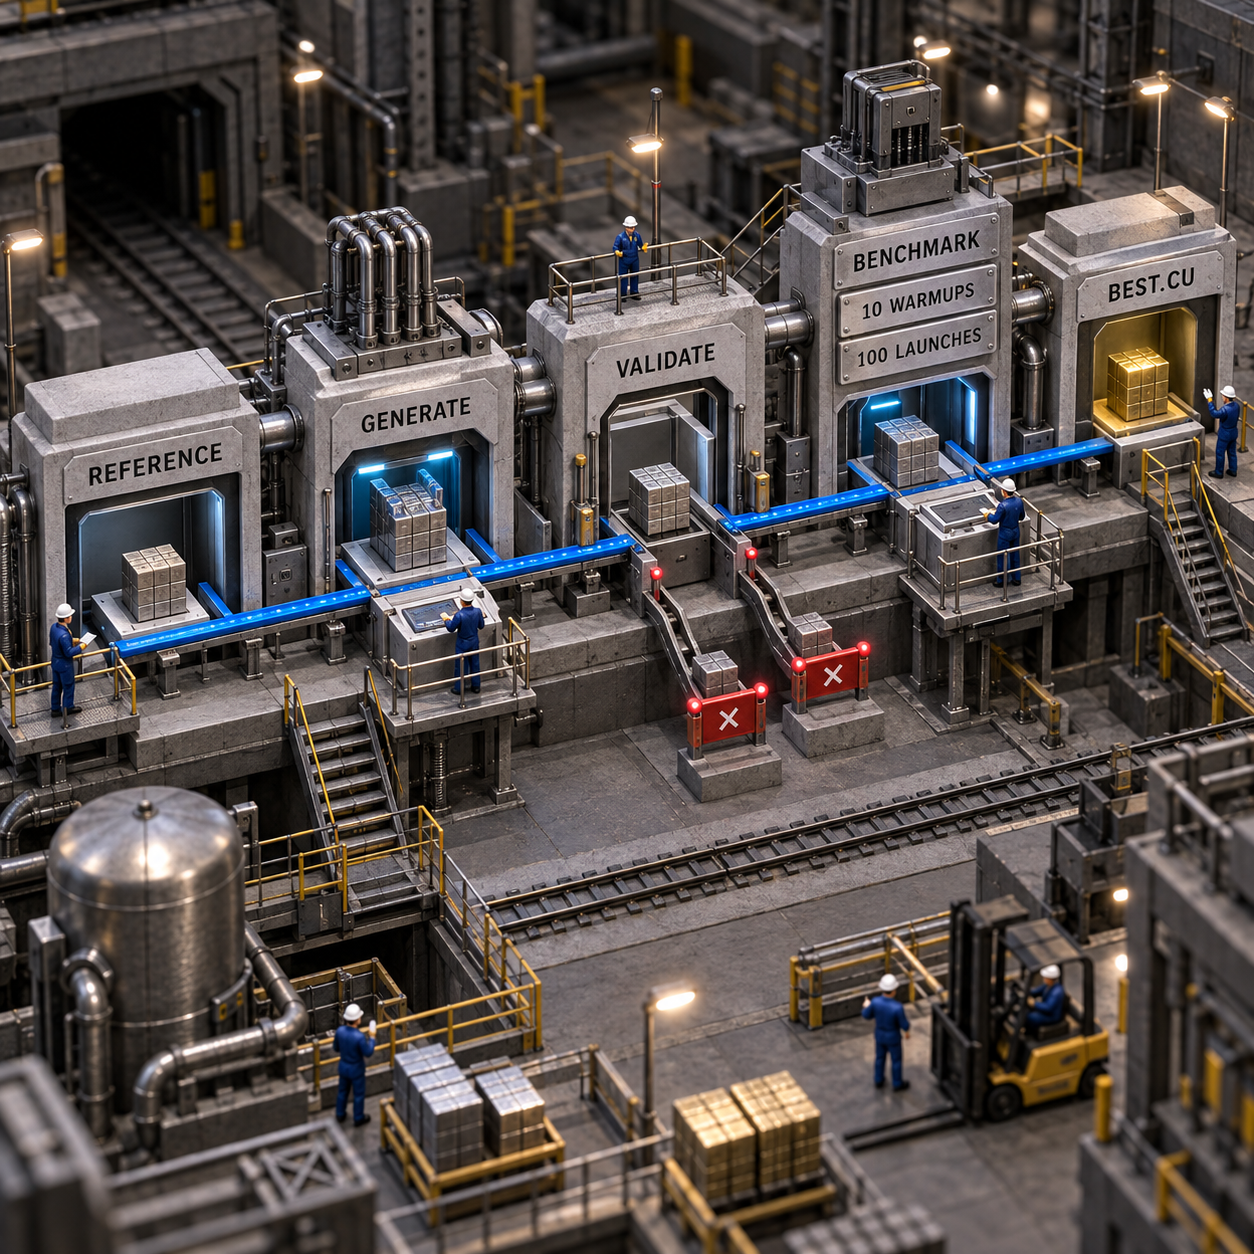
C’est précisément cette séparation qui justifie l’emploi de l’exécuteur de tests plutôt qu’une simple demande adressée à un agent de code généraliste pour obtenir un kernel ingénieux en un seul prompt. L’intérêt réside dans une boucle enregistrée, bornée et dotée de contrôles explicites. Rien ne prouve pour autant que LangGraph trouvera une meilleure réponse qu’un agent de code compétent. L’auteur du dépôt l’a lui-même souligné lors du lancement : la valeur vient du cadre imposé aux étapes.
Configurer la build Windows épinglée
Commencez par suivre le parcours Windows documenté. Le dépôt a été développé avec un GPU RTX 3060 Laptop et documente Visual Studio 2026 avec les outils C++. Avant de compiler, vérifiez la présence de Python 3.12 ou version ultérieure, de CMake 3.24 ou version ultérieure, d’un compilateur C++17, d’un pilote NVIDIA et d’un CUDA Toolkit compatible.
python --version
cmake --version
where.exe cl
nvidia-smi
nvcc --version

git clone https://github.com/bertaye/agentic-cuda-optimizer.git
cd agentic-cuda-optimizer
git checkout --detach 1e9464da54dfc651337a97c3643bfeefec712bc1

python -m venv .venv
.venv\Scripts\python -m pip install -r optimizer_agent/requirements.txt
cmake -S cuda_test_harness -B cuda_test_harness/build -DCMAKE_BUILD_TYPE=Release
cmake --build cuda_test_harness/build --parallel

Set-Content .env 'OPENAI_API_KEY=your-key-here'
Arrêtez-vous dès qu’un prérequis échoue. Réparer la chaîne d’outils pendant qu’un agent modifie aussi les kernels rend l’origine des erreurs difficile à établir.
Deux particularités de la v0.0 méritent votre attention :
- Le README recommande
--config optimizer_agent/example.json, mais ce fichier est absent du commit épinglé. Utilisez des options explicites ou créez votre propre configuration, puis relisez-la. - Le dépôt public ne contient aucun fichier de licence, et GitHub n’en détecte aucune. La visibilité publique ne vaut pas autorisation d’exploitation commerciale. Obtenez une permission ou un avis juridique avant tout usage en entreprise, toute redistribution ou toute intégration dans un produit payant.
Aucune autre plateforme ne bénéficie d’une procédure d’installation documentée dans cette version. Un environnement Linux a été examiné pour cet article, mais les outils CUDA et de compilation requis en étaient absents : il s’agissait donc d’un contrôle des prérequis, pas d’un test Linux réussi.
Enfin, isolez la machine. Si vous laissez l’outil créer les entrées, le code Python généré s’exécute localement sans sandbox. Le code CUDA généré s’exécute lui aussi directement sur le GPU. Choisissez un hôte jetable ou une VM avec des identifiants aux droits limités, sans données de production, sans secrets sans rapport avec l’expérience et sans accès à des partages de fichiers importants.
Concevoir une expérience capable d’échouer honnêtement
Commencez par un seul kernel dont le contrat tient sur une page. Une multiplication de matrices float32 en disposition row-major constitue un bon pilote : les entrées, la sortie et les dimensions sont explicites, tandis que les tailles impaires révèlent des problèmes de gestion des bords que des matrices carrées trop commodes peuvent masquer.
Préparez trois éléments en dehors du répertoire de résultats de l’outil :
reference.cu, une implémentation simple et relue, issue d’une source fiable. Ne demandez pas au même modèle de produire à la fois l’oracle et le candidat.initial.cu, la véritable baseline que vous auriez autrement déployée. Vous éviterez ainsi de confondre une victoire spectaculaire sur un code généré médiocre avec un gain utile à l’entreprise.input_cases.json, avec des entrées binaires fixes et reproductibles, ainsi que des tolérances de comparaison adaptées à votre contrat numérique.
Un pilote borné pourrait comporter un cas de justesse aux dimensions impaires, par exemple M=31, N=37, K=29, puis deux cas de performance modérés, tels que 256 par 256 par 256 et M=384, N=256, K=320. Il s’agit de suggestions pour concevoir l’expérience, et non de benchmarks du dépôt. Gardez à l’écart de l’outil une quatrième forme de holdout et de nouvelles valeurs, afin de confronter le candidat final à un cas jamais vu pendant la recherche.
Utilisez des valeurs non triviales, pas uniquement des zéros ou des uns. Vérifiez la taille de chaque buffer, l’ordre des arguments, le type scalaire et la tolérance. Le manifeste doit contenir au moins un cas performance. Tous les cas doivent réussir, mais seuls les cas de performance influencent le classement.
Calculez le hash de la référence, des entrées et de l’exécuteur de tests — ou copiez-les — avant le lancement. L’outil doit pouvoir modifier le code du candidat et les paramètres de lancement propres à chaque cas, mais pas la définition de la réussite.
Lancer exactement sept tentatives d’amélioration
La commande ci-dessous utilise des entrées explicites et le chemin documenté de l’interpréteur Windows. Elle fixe la signature du point d’entrée, fournit la référence indépendante et la véritable baseline, puis limite à sept le budget d’amélioration.
.venv\Scripts\python optimizer_agent\optimizer_agent.py `
  --description "Row-major float32 matrix multiplication C=MxN from A=MxK and B=KxN." `
  --signature 'extern "C" __global__ void matmul_f32(const float* a, const float* b, float* c, int m, int n, int k)' `
  --reference .\experiment\reference.cu `
  --initial-kernel .\experiment\initial.cu `
  --input-cases .\experiment\input_cases.json `
  --max-iterations 7
Le modèle utilisé par défaut est gpt-5-mini avec un effort de raisonnement moyen, et son utilisation de l’API est facturée sur votre compte. Sept tentatives d’amélioration ne signifient ni sept appels au modèle, ni sept lancements de kernel. Une proposition peut mobiliser des appels d’outils et des tentatives de correction, tandis que chaque cas chronométré compte à lui seul, par défaut, 10 préchauffages et 100 lancements mesurés.
Pour établir une première baseline propre, laissez --use-nsight et --nvidia-research désactivés. Le profiling Nsight ajoute des relectures et nécessite Nsight Compute ainsi que l’autorisation de lire les compteurs de performance du GPU. La recherche NVIDIA ajoute du travail de modèle et de récupération d’informations. N’introduisez qu’une variable à la fois, une fois la boucle de base stabilisée.
Avant d’appuyer sur Entrée, ouvrez un journal d’expérience et consignez :
- le commit épinglé et l’état de propreté de l’arbre de travail
- le modèle de GPU et les versions du pilote et du CUDA Toolkit
- les hashes de la référence et des cas
- les horodatages de début et de fin
- le temps total d’occupation du GPU
- le nom du modèle, les appels, les tokens ou toute autre métadonnée d’usage disponible dans les fichiers de réponse enregistrés
- les candidats valides, les candidats rejetés et les motifs de rejet
- la latence par cas pour la baseline et le vainqueur
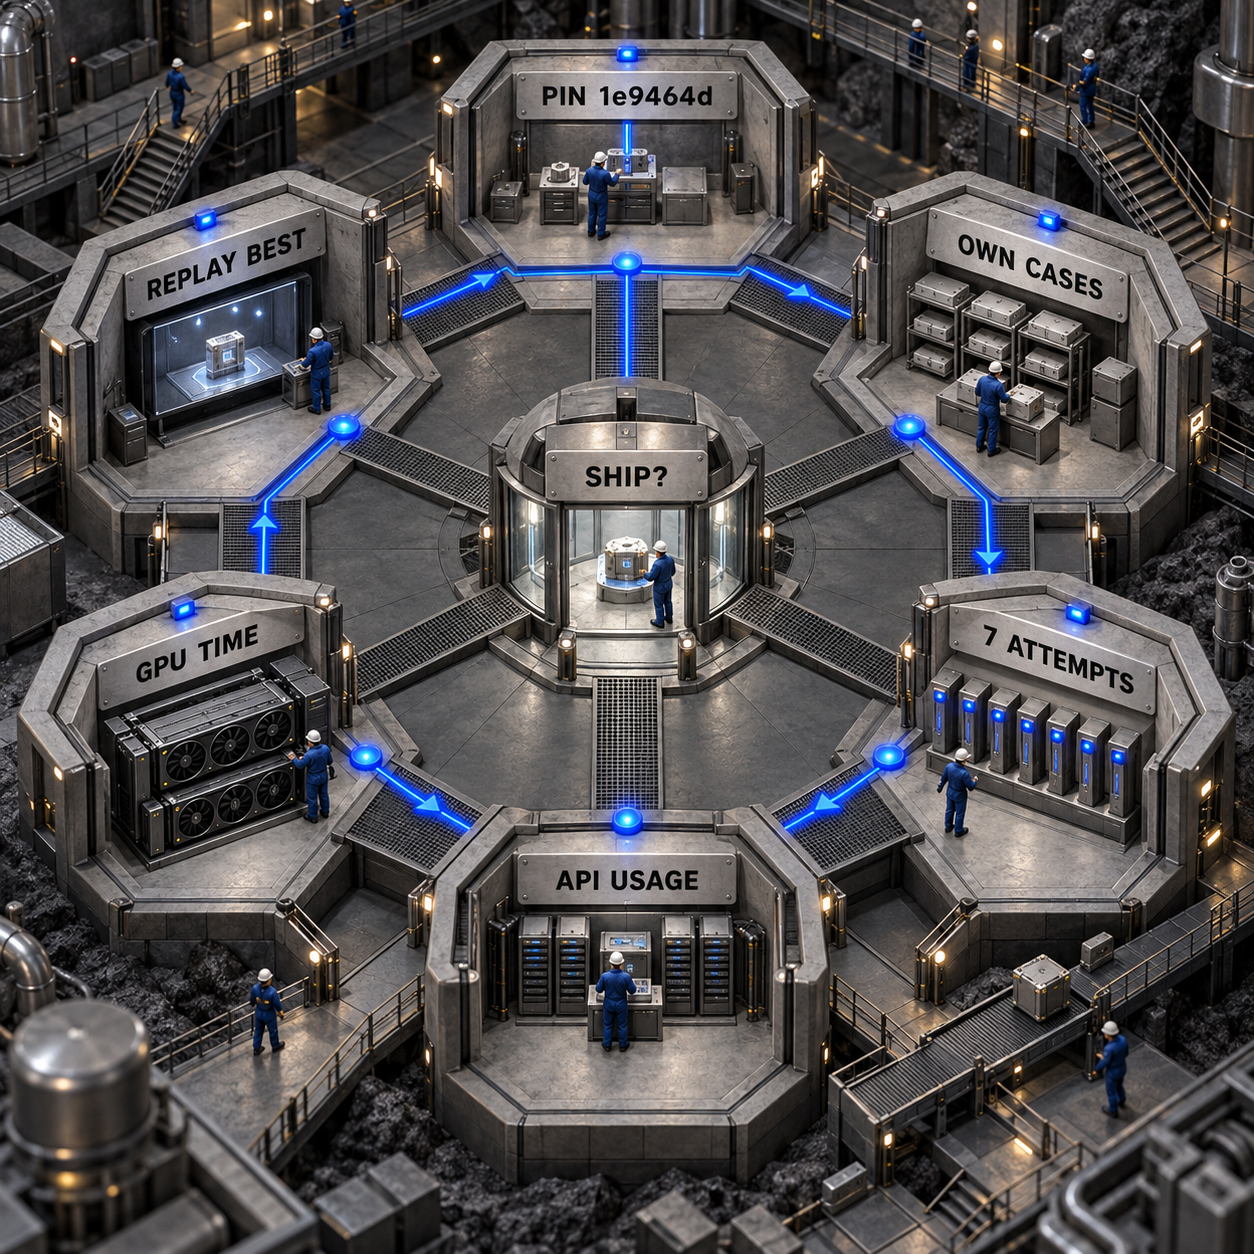
Laissez le GPU au repos pendant les comparaisons de temps. Une activité GPU en arrière-plan peut transformer une petite amélioration apparente en simple bruit de mesure.
Lire les preuves, puis rejouer le vainqueur
Considérez le répertoire de résultats comme un dossier d’audit, pas comme une vitrine à trophées. Chaque session se trouve sous results/run-NNN/. Commencez par ces fichiers :
history.jsoncontient toutes les tentatives évaluées, le détail d’exécution de chaque cas, les résultats de validation, la configuration de lancement et la latence mesurée.summary.jsonindique la meilleure itération, la latence par cas, les accélérations disponibles par rapport à la baseline et le motif d’arrêt.best.cuest le candidat le plus rapide ayant réussi tous les cas fournis.- Les fichiers
best-case-N.jsonsont les requêtes de rejeu du code vainqueur sur les cas fournis. - Les fichiers
model-*.jsonet les réponses d’outils conservent l’interaction avec l’agent. Consultez leurs métadonnées d’usage pour comptabiliser l’API, carsummary.jsonne totalise pas les dépenses liées au modèle. heatmap.pngetheatmap.svgretracent l’historique des temps. Ce sont des outils de navigation, pas des preuves de justesse.
Comptez les candidats rejetés avec autant de soin que les candidats valides. Une exécution comportant six propositions rejetées et un seul vainqueur étroit n’enseigne pas la même chose qu’une exécution où chaque candidat reste valide. Examinez les erreurs de compilation, les écarts de sortie et la réalité des différences entre le code gagnant et son parent.
Rejouez ensuite chaque best-case-N.json enregistré dans l’exécuteur de tests, sur le même GPU au repos. Puis confrontez best.cu à la forme cachée et à de nouvelles valeurs avec un oracle indépendant. Les cas fournis établissent uniquement que le candidat a réussi ces cas. Ils ne démontrent ni sa justesse générale, ni l’absence de race condition, ni la sûreté de son comportement pour toutes les formes valides.
Écartez le vainqueur si un holdout échoue, si des mesures répétées rejoignent la baseline dans la marge de bruit, ou si le gain disparaît dans l’application réelle. Une référence générée ne constitue pas à elle seule un oracle acceptable, et battre le kernel initial généré ne signifie pas battre cuBLAS ou une autre baseline de production. Le dépôt ne publie aucune comparaison avec cuBLAS.
Vérifier que l’accélération est rentable
Raisonnez sur l’économie du job complet, pas sur le seul score du kernel. Le dépôt public n’affiche aucun prix d’abonnement, mais il n’accorde pas non plus de licence commerciale. Votre expérience consomme malgré tout du temps d’ingénierie, des appels à l’API du modèle et du temps GPU.
Une feuille de calcul utile comporte trois lignes :
pilot cost = engineer setup and review + model charges + GPU wall-clock costsaved GPU hours per month = end-to-end milliseconds saved per invocation × monthly invocations ÷ 3,600,000payback months = pilot cost ÷ monthly gross GPU saving
Utilisez les millisecondes économisées de bout en bout après intégration, pas la latence mesurée par événements CUDA dans summary.json. Si le kernel s’exécute plusieurs fois par requête, comptez le nombre d’invocations mesuré. Si l’exécution plus rapide modifie le débit, la pression mémoire ou le batching, remesurez la charge complète au lieu d’extrapoler le résultat du kernel.
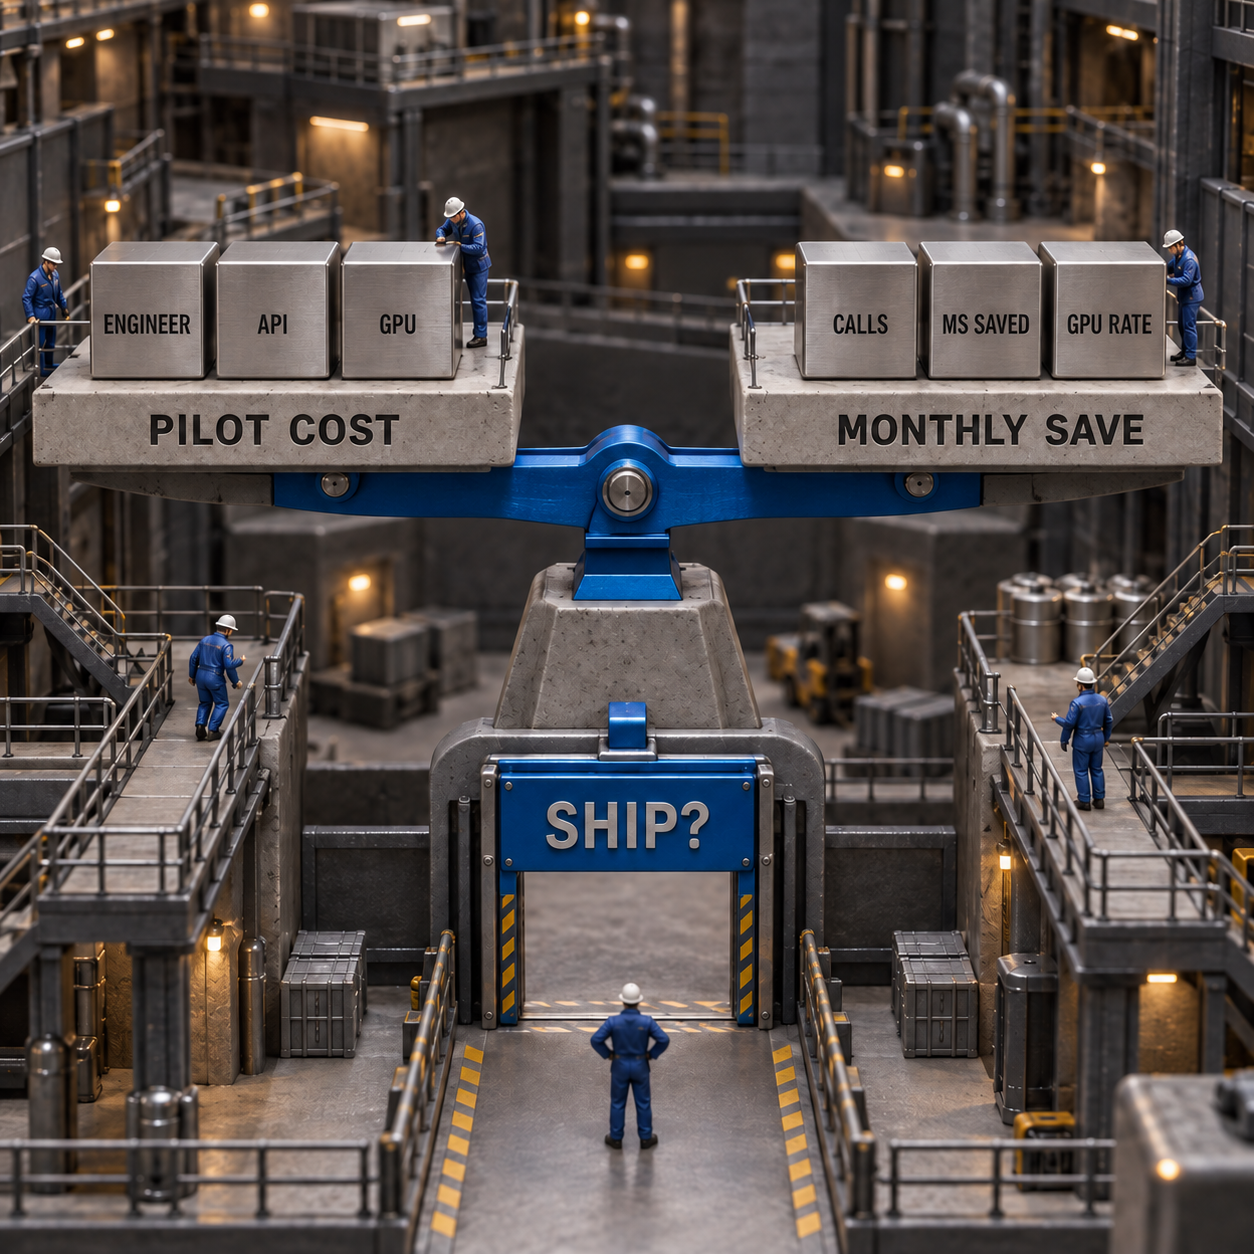
L’alternative humaine a elle aussi un coût. La page d’Upwork consacrée aux consultants CUDA indique actuellement des fourchettes indicatives de $500 à $1,200 pour le profiling des performances et de $2,500 à $4,500 pour l’optimisation d’un kernel. Ce sont des fourchettes de marketplace, pas des devis, et elles ne prouvent pas qu’un agent remplace un spécialiste. Elles montrent toutefois l’intérêt potentiel d’une expérience initiale reproductible si elle permet de concentrer le travail expert coûteux sur des candidats étayés par des preuves solides.
La règle de décision est nette : ne passez à un test d’intégration contrôlé que si le candidat réussit des cas indépendants, bat plusieurs fois la baseline, améliore la charge réelle et respecte une fenêtre de rentabilité fixée par l’équipe avant l’expérience.
Sept équipes capables d’en tirer parti
Ces cas d’usage sont classés selon la probabilité qu’une équipe transforme un gain validé sur un kernel en économies ou en capacité supplémentaire.
Si la charge est une application complète, une primitive mature fournie par un éditeur ou un ensemble de formes en évolution constante, commencez ailleurs. Cet outil est explicitement expérimental et vise des kernels individuels.
Pour situer les systèmes voisins, le comparatif existant des agents IA dédiés à l’optimisation GPU couvre AKO, KernelAgent, AutoKernel, Apex et CUDA Agent. Le dépôt de Bertaye est un projet plus récent et distinct.
Deux produits à construire autour de l’outil
1. Audit borné d’optimisation CUDA
C’est l’opportunité la plus solide. Proposez aux équipes qui possèdent un kernel CUDA coûteux un livrable au périmètre fixe : capture de l’environnement, collecte de cas fiables, exécution en sept tentatives, rejeu indépendant, comptabilisation des coûts du modèle et du GPU, puis rapport de décision go/no-go.
La demande est modeste, mais particulièrement précise. DataForSEO recense environ 30 recherches mensuelles aux États-Unis pour cuda optimization et 20 pour cuda kernel optimization, avec dans les deux cas une faible concurrence sur les liens sponsorisés. Sur le même marché, Upwork affiche des tarifs indicatifs de $500 à $1,200 pour le profiling et de $2,500 à $4,500 pour l’optimisation. Ce faisceau d’indices désigne un service d’expertise de niche, pas une application grand public en libre-service.
La plus petite offre commercialisable réunit un formulaire de dépôt sécurisé, un exécuteur GPU jetable, un manifeste de cas verrouillé, un collecteur des coûts d’exécution et un rapport de preuves en HTML. Conservez une revue humaine. Le principal obstacle est la confiance : un seul vainqueur incorrect peut annuler la valeur de nombreux audits réussis, et l’absence de licence dans le dépôt impose d’obtenir une autorisation avant de fonder un service commercial sur ce code.
2. Garde de régression pour kernels GPU
Construisez un service CI contrôlé qui rejoue les kernels approuvés sur du matériel réservé, vérifie les sorties enregistrées et bloque une release lorsque la latence ou la justesse dérive. Les équipes de plateforme GPU et les cabinets de conseil CUDA paieraient pour disposer d’un historique stable à travers les changements de pilote, de toolkit et de code source.
DataForSEO recense environ 10 recherches mensuelles aux États-Unis pour gpu performance optimization. C’est trop peu pour bâtir une activité reposant uniquement sur le SEO, mais suffisant pour valider le vocabulaire des acheteurs. La distribution devrait passer par les cabinets de conseil, les fournisseurs de GPU et les équipes de plateforme internes.
Un MVP nécessite une file d’attente matérielle, des empreintes d’environnement, des cas de référence signés, des mesures répétées, des seuils et un diff compact avec la dernière exécution acceptée. La variance est le principal écueil : hôtes partagés, état thermique et changements de pilote peuvent déclencher de fausses alertes si l’exécuteur ne contrôle pas la machine et ne répète pas les mesures.
Les limites qui doivent peser sur votre décision
Le constat honnête est le suivant : la v0.0 offre une ossature d’expérimentation utile, mais impose une lourde charge de vérification.
- Elle optimise des kernels CUDA individuels, pas des applications complètes.
- Réussir les cas fournis ne démontre pas la justesse générale.
- Une référence générée n’est pas un oracle indépendant.
- Les gains de performance dépendent de la charge et du matériel.
- Aucune comparaison avec cuBLAS ou une autre bibliothèque d’éditeur n’est incluse.
- Le chronométrage par défaut exclut la compilation et les relectures du profiler ; il ne représente donc pas le coût total de l’exécution.
- Les scripts d’entrée générés s’exécutent localement sans sandbox.
- La procédure de compilation documentée vise Windows ; une autre plateforme exige son propre relevé d’installation vérifié.
- Le fichier de configuration d’exemple mentionné manque dans le commit épinglé.
- Le dépôt n’établit aucun droit d’exploitation commerciale.
L’exécuteur séparé est utile lorsqu’il faut des étapes explicites, des preuves persistantes et un budget reproductible. Un agent de code généraliste peut suffire lorsqu’un expert supervise déjà le terminal, que les tests sont robustes et que le travail est véritablement ponctuel. Cet exécuteur ne mérite sa place que si son cadre et sa piste d’audit réduisent le risque ou le travail répétitif.
Questions fréquentes
Comment utiliser Agentic CUDA Optimizer sur un Mac ?
Le dépôt épinglé documente une build Windows avec un GPU NVIDIA et une stack CUDA compatible, pas une installation sur Mac. Utilisez une machine NVIDIA distante ou jetable que vous pouvez vérifier, et documentez cette plateforme séparément au lieu d’adapter les commandes Windows au hasard.
Agentic CUDA Optimizer est-il le même outil que CUDA Agent de ByteDance ?
Non. Ce guide porte sur agentic-cuda-optimizer de Bertaye, un workflow LangGraph associé à un exécuteur de tests CUDA en C++, publié en septembre 2026. CUDA Agent de ByteDance et Tsinghua est un autre système de recherche, avec un dépôt distinct.
Quel dépôt GitHub CUDA-Agent ce guide utilise-t-il ?
Il utilise bertaye/agentic-cuda-optimizer, épinglé au commit 1e9464d. Les résultats de recherche font aussi apparaître BytedTsinghua-SIA/CUDA-Agent, qui n’est pas le logiciel configuré ici.
L’outil s’appuie-t-il sur un NVIDIA CUDA Agent ?
Aucun agent NVIDIA séparé ne fait partie de la boucle documentée. Le projet peut, en option, récupérer des recommandations NVIDIA avec --nvidia-research et inspecter les compteurs Nsight Compute avec --use-nsight, mais la génération des candidats et l’orchestration restent assurées par le workflow propre à ce dépôt.
L’action à lancer lundi est simple : confiez à un ingénieur GPU un kernel float32 à faible risque, une machine NVIDIA jetable et une journée pour préparer la référence indépendante, les cas et la feuille de coûts. Ne lancez le pilote en sept tentatives qu’une fois ces garde-fous consignés.
Si vous souhaitez intégrer une expérience GPU mesurée et son parcours de revue à un système de production, l’offre systèmes d’IA en production est le point de départ adapté.
- Dernière mise à jour
- 25 sept. 2026
- Catégorie
- Build
Préférez ce site dans Google


Marquez omidsaffari.com comme source préférée et Google le met en avant pour vous dans Top Stories, AI Overviews et AI Mode.

Cloud GPU Runpod : le vrai coût des Pods face au Serverless
Comparez les tarifs du cloud GPU Runpod pour les Pods et le Serverless, le coût du stockage et le seuil de 60.33% qui détermine l’option la moins chère.25 sept. 2026Build
Vercel Sandbox Drive : un stockage persistant pour les agents de code
Découvrez comment monter un Vercel Sandbox Drive, conserver fichiers et caches entre deux sandboxes, gérer les accès concurrents et maîtriser les coûts.25 sept. 2026Build
Web scraping IA : 7 alternatives à Firecrawl comparées
Comparez 7 alternatives à Firecrawl pour vos pipelines IA : crawl, sorties Markdown et JSON, effort de migration et coût par page réellement exploitable.25 sept. 2026Build
7 alternatives à CodeRabbit pour la revue de code IA
Comparez 7 alternatives à CodeRabbit : prix, hébergement, confidentialité et coûts pour 300 revues, afin de choisir selon vos contraintes réelles.25 sept. 2026Build
CodeRabbit ou Greptile : quel outil de revue de code IA choisir ?
CodeRabbit ou Greptile ? Comparez tarifs, limites de revue, intégrations Git et coûts réels pour choisir l’outil adapté à votre équipe de développement.25 sept. 2026Build
Perplexity Windows : configurer Portable Computer en local
Configurez Perplexity Portable Computer sur un PC Windows AMD compatible, testez l’inférence locale et maîtrisez permissions, coûts et passages cloud.25 sept. 2026Build
AgentRun : test d’un framework agent IA TypeScript
AgentRun encadre les workflows d’agents IA en TypeScript. Test des branches, schémas, escalades, coûts et limites face à LangGraph.js et Temporal.24 sept. 2026Build