Prestazioni GPU: mettere alla prova Agentic CUDA Optimizer
Scopri come testare Agentic CUDA Optimizer in sette tentativi, verificare ogni kernel e capire se il guadagno sulle prestazioni GPU ripaga davvero.


Per migliorare le prestazioni GPU, fai passare un piccolo kernel di moltiplicazione matriciale float32 attraverso una ricerca di sette tentativi, conserva i candidati solo quando superano tutti i casi attendibili e non portare nulla in produzione finché il vincitore salvato non ripaga le chiamate al modello, il tempo GPU e il lavoro di revisione. Questa guida riguarda Agentic CUDA Optimizer di Bertaye, non il sistema di ricerca CUDA Agent di ByteDance e Tsinghua.
In breve
Usa Agentic CUDA Optimizer come test runner per esperimenti ben delimitati, non come sistema autonomo di verifica. Blocca il commit iniziale v0.0, compila il test runner C++ sullo stack Windows documentato, fornisci un kernel di riferimento e casi di input tuoi, limita la ricerca con --max-iterations 7, quindi esamina history.json, summary.json e best.cu prima di eseguire una verifica separata.
L'optimizer può automatizzare un ciclo utile: scrive un candidato, lo compila, lo esegue, lo scarta se gli output differiscono, ne misura i tempi se gli output sono corretti e usa le evidenze per il tentativo successivo. Non può stabilire se il riferimento è giusto, se i casi coprono la produzione o se un kernel isolato più veloce riduce davvero il costo complessivo della GPU.
Il repository è stato pubblicato con il commit 1e9464da54dfc651337a97c3643bfeefec712bc1 il 24 settembre 2026 alle 19:41:43 UTC. Bloccare quel commit è importante: questa guida descrive v0.0, non le modifiche che arriveranno in seguito.
Che cosa fa davvero l'optimizer
Immaginalo come un'officina dotata di controlli di qualità. Il modello può riprogettare il piccolo componente sul banco, cioè il kernel CUDA, e modificarne la configurazione di lancio. Il test runner governa gli strumenti di misura. Un candidato arriva in vetrina solo dopo aver prodotto un output accettabile per ogni caso fornito.
Dietro le quinte, un runner C++ autonomo compila il sorgente CUDA con NVRTC, lo avvia tramite la CUDA Driver API e salva gli output. Python confronta questi output con il riferimento e seleziona i candidati. I casi contrassegnati come correctness devono essere superati, ma non influiscono sul punteggio. Quelli contrassegnati come performance servono sia alla validazione sia al calcolo della latenza media geometrica usata per la classifica.
Per impostazione predefinita, ogni caso cronometrato prevede 10 lanci di warm-up e 100 lanci misurati con eventi CUDA. Questi numeri descrivono il tempo del kernel, non il costo del job. Compilazione, chiamate al modello, tentativi falliti, generazione degli input, replay del profiler e revisione umana restano fuori da quella latenza.
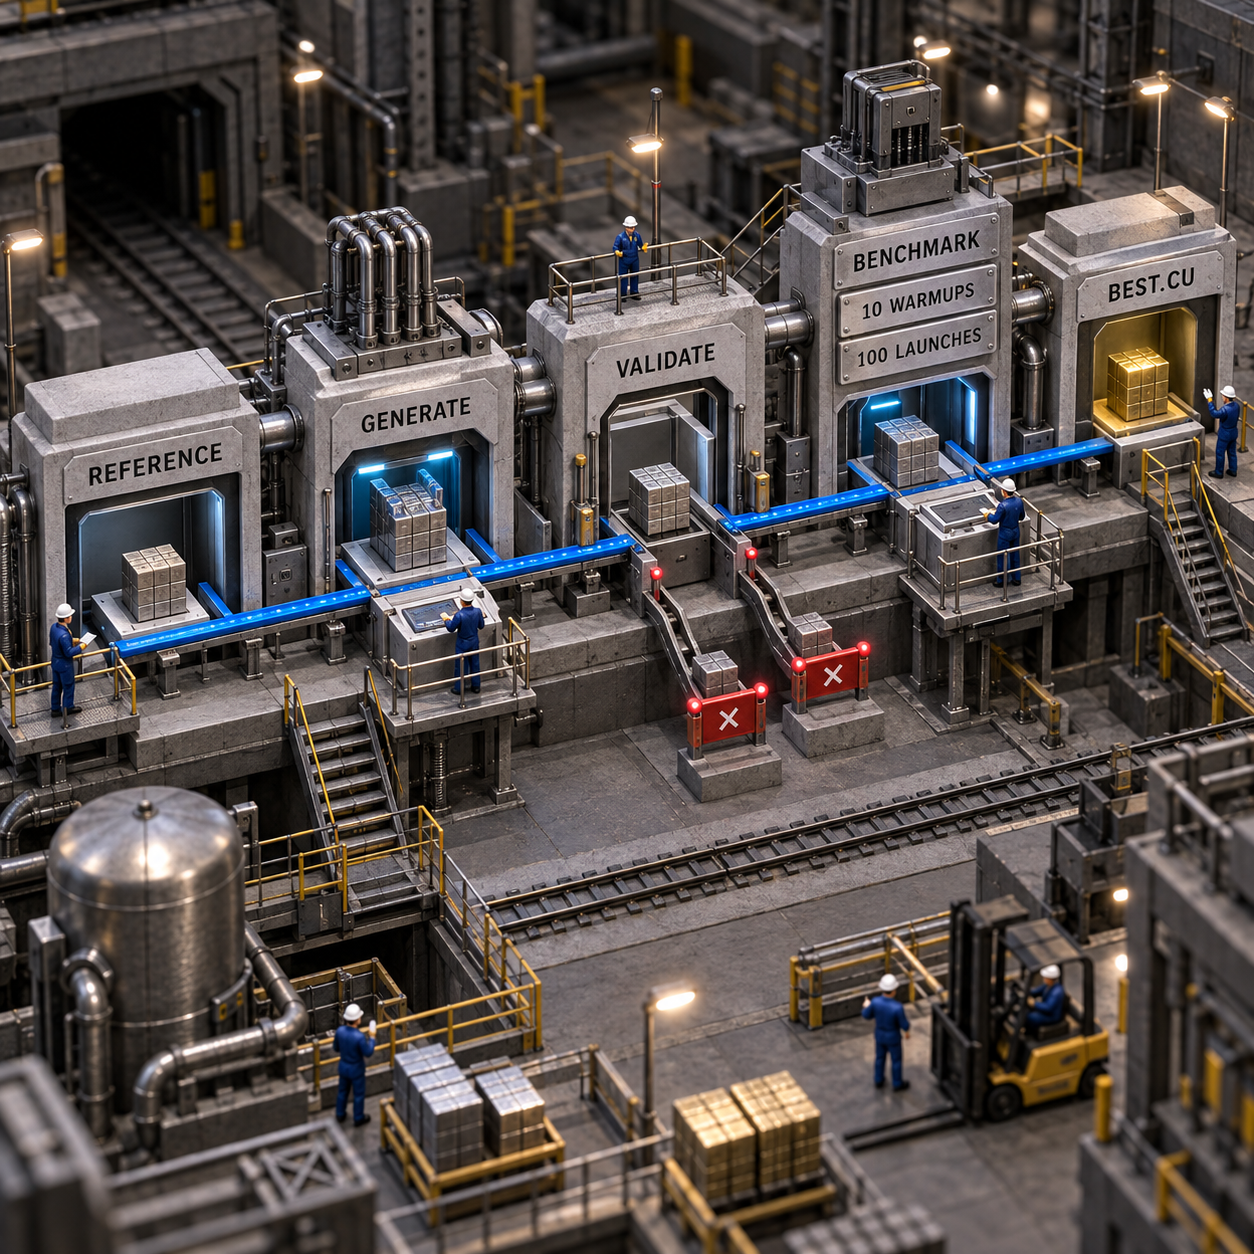
È proprio questa separazione a giustificare l'uso del test runner invece di chiedere a un agente di coding generico un singolo kernel brillante con un solo prompt. Il vantaggio è un ciclo registrato, circoscritto e dotato di controlli espliciti. Non dimostra che LangGraph troverà una risposta migliore di quella di un agente di coding competente. L'autore del repository ha sottolineato lo stesso punto nella discussione di lancio: il valore sta nei limiti imposti alle varie fasi.
Preparare l'ambiente di programmazione CUDA su Windows
Parti dal percorso Windows documentato. Il repository è stato sviluppato con una RTX 3060 Laptop GPU e documenta Visual Studio 2026 con gli strumenti C++. Prima di compilare, verifica la presenza di Python 3.12 o successivo, CMake 3.24 o successivo, un compilatore C++17, un driver NVIDIA e un CUDA Toolkit compatibile.
python --version
cmake --version
where.exe cl
nvidia-smi
nvcc --version

git clone https://github.com/bertaye/agentic-cuda-optimizer.git
cd agentic-cuda-optimizer
git checkout --detach 1e9464da54dfc651337a97c3643bfeefec712bc1

python -m venv .venv
.venv\Scripts\python -m pip install -r optimizer_agent/requirements.txt
cmake -S cuda_test_harness -B cuda_test_harness/build -DCMAKE_BUILD_TYPE=Release
cmake --build cuda_test_harness/build --parallel

Set-Content .env 'OPENAI_API_KEY=your-key-here'
Fermati se anche uno solo dei controlli sui prerequisiti fallisce. Correggere la toolchain mentre un agente modifica anche i kernel rende difficile capire da dove provengano gli errori.
Due dettagli della v0.0 richiedono attenzione:
- Il README suggerisce
--config optimizer_agent/example.json, ma quel file non è presente nel commit fissato. Usa flag espliciti oppure crea e verifica una configurazione tua. - Il repository pubblico non contiene un file di licenza e GitHub non rileva alcuna licenza. La visibilità pubblica non equivale a una concessione per uso commerciale. Prima di usarlo in azienda, ridistribuirlo o inserirlo in un prodotto a pagamento, ottieni un'autorizzazione o un parere legale.
In questa versione non è documentato alcun percorso di configurazione per altre piattaforme. Per l'articolo è stato esaminato un ambiente Linux, che però non disponeva degli strumenti CUDA e di compilazione necessari: è stata quindi una verifica preliminare dei prerequisiti, non un test Linux riuscito.
Infine, isola la macchina. Se lasci che sia l'optimizer a creare gli input, il codice Python generato viene eseguito in locale senza sandbox. Anche il codice CUDA generato gira direttamente sulla GPU. Usa un host o una VM usa e getta con credenziali limitate, senza dati di produzione, senza segreti estranei all'esperimento e senza accesso a condivisioni di file importanti.
Come testare onestamente le prestazioni GPU
Comincia da un solo kernel, il cui contratto possa stare in una pagina. Una moltiplicazione di matrici float32 in row-major è un buon progetto pilota: input, output e dimensioni sono espliciti, mentre le dimensioni dispari fanno emergere i problemi ai bordi che i comodi casi con matrici quadrate possono nascondere.
Prepara tre risorse al di fuori della directory dei risultati dell'optimizer:
reference.cu, un'implementazione semplice e verificata, proveniente da una fonte attendibile. Non chiedere allo stesso modello di creare sia l'oracolo sia il candidato.initial.cu, la baseline reale che altrimenti porteresti in produzione. Così eviti di scambiare per un successo aziendale una vittoria eclatante su codice generato ma debole.input_cases.json, con input binari fissi e riproducibili e tolleranze di confronto adeguate al contratto numerico.
Un progetto pilota circoscritto potrebbe includere un caso di correttezza con dimensioni dispari, come M=31, N=37, K=29, seguito da due casi prestazionali moderati, come 256 per 256 per 256 e M=384, N=256, K=320. Sono suggerimenti per progettare l'esperimento, non benchmark del repository. Tieni fuori dall'optimizer una quarta combinazione di dimensioni come holdout, insieme a valori nuovi, così il candidato finale dovrà affrontare un caso mai visto durante la ricerca.
Usa valori non banali, non soltanto zeri o uno. Controlla dimensione di ogni buffer, ordine degli argomenti, tipo scalare e tolleranza. Il manifest deve contenere almeno un caso performance. Tutti i casi devono essere superati, ma solo quelli prestazionali influiscono sulla classifica.
Calcola l'hash oppure conserva una copia del riferimento, degli input e del test runner prima dell'esecuzione. L'optimizer deve poter modificare il sorgente candidato e le impostazioni di lancio per ciascun caso, non la definizione del successo.
Eseguire esattamente sette tentativi di miglioramento
Il comando seguente usa input espliciti e il percorso documentato dell'interprete Windows. Fissa la firma dell'entry point, fornisce il riferimento indipendente e la baseline reale e limita a sette tentativi il budget di miglioramento.
.venv\Scripts\python optimizer_agent\optimizer_agent.py `
  --description "Row-major float32 matrix multiplication C=MxN from A=MxK and B=KxN." `
  --signature 'extern "C" __global__ void matmul_f32(const float* a, const float* b, float* c, int m, int n, int k)' `
  --reference .\experiment\reference.cu `
  --initial-kernel .\experiment\initial.cu `
  --input-cases .\experiment\input_cases.json `
  --max-iterations 7
Il modello predefinito è gpt-5-mini con livello di ragionamento medio e l'uso delle API viene addebitato al tuo account. Sette tentativi di miglioramento non equivalgono a sette chiamate al modello né a sette avvii del kernel. Una proposta può richiedere chiamate a strumenti e nuovi tentativi di correzione, mentre ogni singolo caso cronometrato prevede per impostazione predefinita 10 warm-up e 100 lanci misurati.
Per ottenere una prima baseline pulita, lascia disattivati --use-nsight e --nvidia-research. La profilazione Nsight aggiunge lavoro di replay e richiede Nsight Compute, oltre all'autorizzazione per leggere i contatori delle prestazioni GPU. La ricerca NVIDIA aggiunge attività del modello e di recupero delle informazioni. Quando il ciclo di base è stabile, introduci una sola variabile alla volta.
Prima di premere Invio, apri un registro dell'esperimento e annota:
- commit fissato e stato delle modifiche non salvate nell'albero di lavoro
- modello GPU e versioni del driver e del CUDA Toolkit
- hash del riferimento e dei casi
- timestamp di inizio e fine
- tempo di esecuzione GPU complessivo
- nome del modello, chiamate, token o altri metadati d'uso disponibili nei file delle risposte salvate
- candidati validi, candidati scartati e motivi dello scarto
- latenza per ciascun caso della baseline e del vincitore
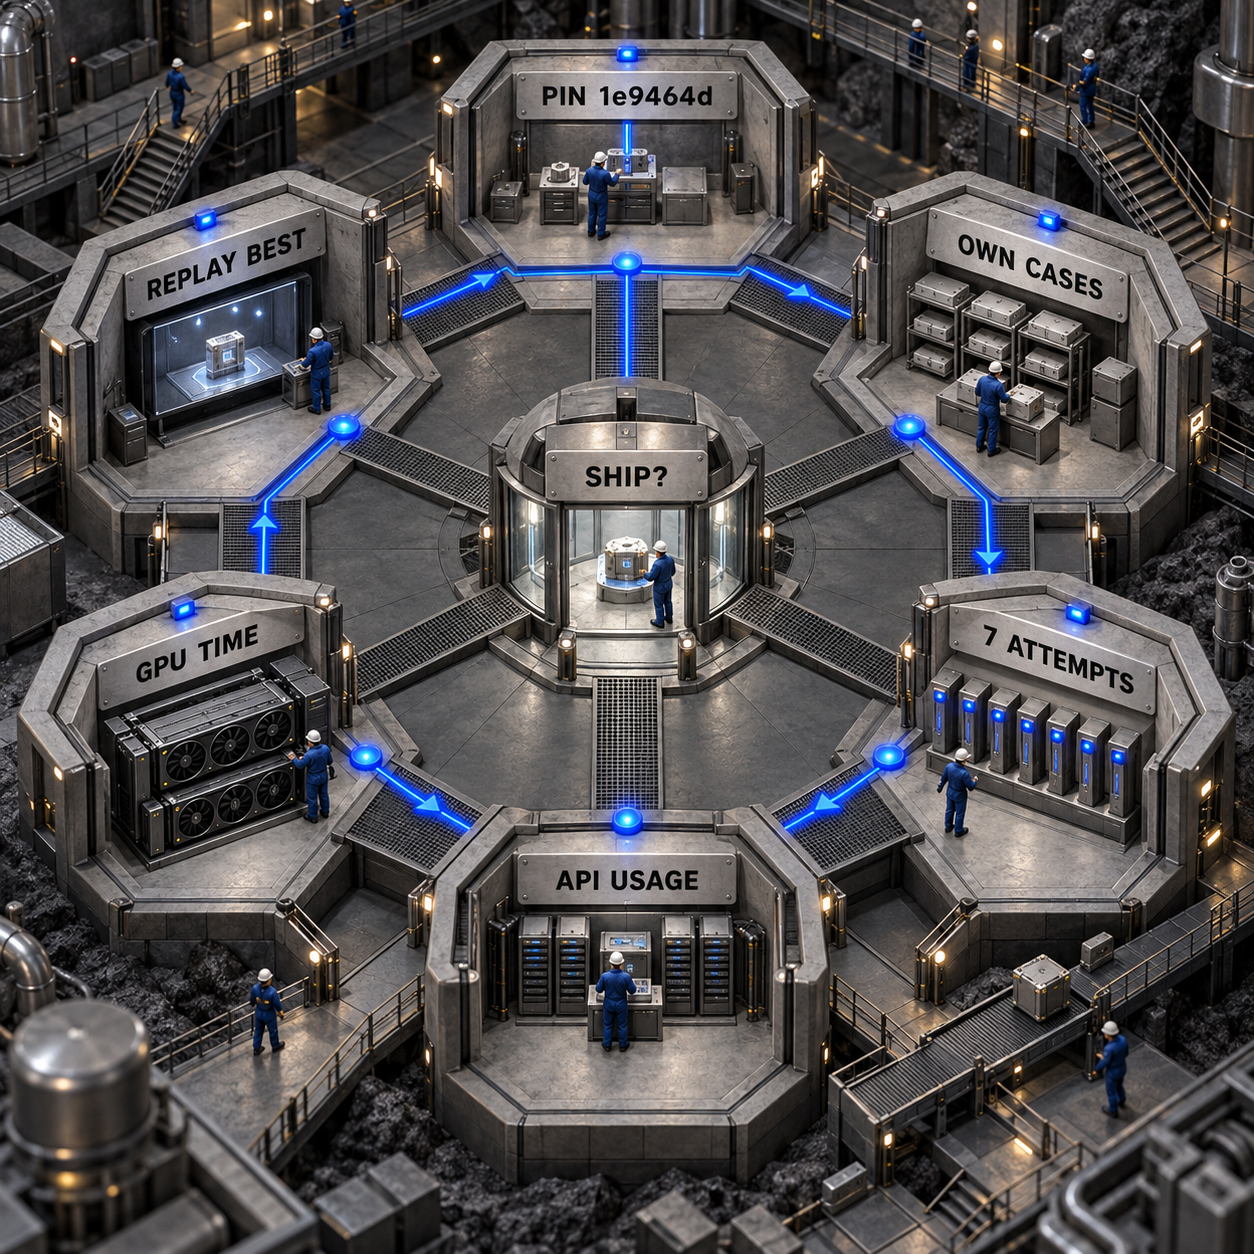
Durante il confronto dei tempi, non assegnare altri carichi alla GPU. Attività GPU in background possono trasformare un piccolo miglioramento apparente in semplice rumore di misura.
Leggere le evidenze e rieseguire il vincitore
Considera la directory dei risultati un pacchetto di audit, non una bacheca dei trofei. Ogni sessione si trova in results/run-NNN/. Comincia da questi file:
history.jsoncontiene tutti i tentativi valutati, i dettagli dell'esecuzione per ogni caso, i risultati della validazione, la configurazione di lancio e la latenza misurata.summary.jsonindica l'iterazione migliore, la latenza per ciascun caso, gli eventuali speedup rispetto alla baseline e il motivo dell'arresto.best.cuè il candidato più veloce tra quelli che hanno superato tutti i casi forniti.- I file
best-case-N.jsonsono richieste di replay del sorgente vincitore sui casi forniti. - I file
model-*.jsone quelli delle risposte degli strumenti conservano l'interazione con l'agente. Per contabilizzare le API, controlla i relativi metadati d'uso:summary.jsonnon calcola la spesa complessiva del modello. heatmap.pngeheatmap.svgmostrano lo storico dei tempi. Servono a orientarsi, non provano la correttezza.
Conta i candidati scartati con la stessa attenzione riservata a quelli validi. Un'esecuzione con sei proposte respinte e un solo vincitore molto specifico racconta una storia diversa da una in cui ogni candidato è rimasto valido. Esamina gli errori di compilazione, le difformità negli output e verifica se il sorgente vincitore differisce davvero dal suo predecessore.
Quindi riesegui ogni best-case-N.json salvato tramite il test runner, sulla stessa GPU inattiva. Infine prova best.cu sulla forma nascosta e con valori nuovi usando un oracolo indipendente. I casi forniti dimostrano soltanto che il candidato ha superato quei casi. Non provano la correttezza generale, l'assenza di race condition o la sicurezza del comportamento per ogni forma valida.
Scarta il vincitore se fallisce anche un solo holdout, se misurazioni ripetute lo riportano entro il margine di rumore della baseline o se il vantaggio scompare nell'applicazione reale. Un riferimento generato non è accettabile come unico oracolo e battere il kernel iniziale generato non significa battere cuBLAS o un'altra baseline di produzione. Il repository non pubblica confronti con cuBLAS.
Capire se lo speedup si ripaga
Ragiona sull'economia dell'intero job, non sul punteggio del kernel isolato. Il repository pubblico non prevede un abbonamento, ma neppure concede una licenza commerciale. L'esperimento richiede comunque ore di lavoro degli ingegneri, chiamate alle API del modello e tempo GPU.
Un foglio di calcolo utile contiene tre righe:
pilot cost = engineer setup and review + model charges + GPU wall-clock costsaved GPU hours per month = end-to-end milliseconds saved per invocation × monthly invocations ÷ 3,600,000payback months = pilot cost ÷ monthly gross GPU saving
Usa i millisecondi end-to-end risparmiati dopo l'integrazione, non la latenza degli eventi CUDA riportata in summary.json. Se il kernel viene eseguito più volte per richiesta, conta le invocazioni misurate. Se l'esecuzione più rapida modifica throughput, pressione sulla memoria o batching, misura di nuovo l'intero carico di lavoro invece di estrapolare il risultato del kernel.
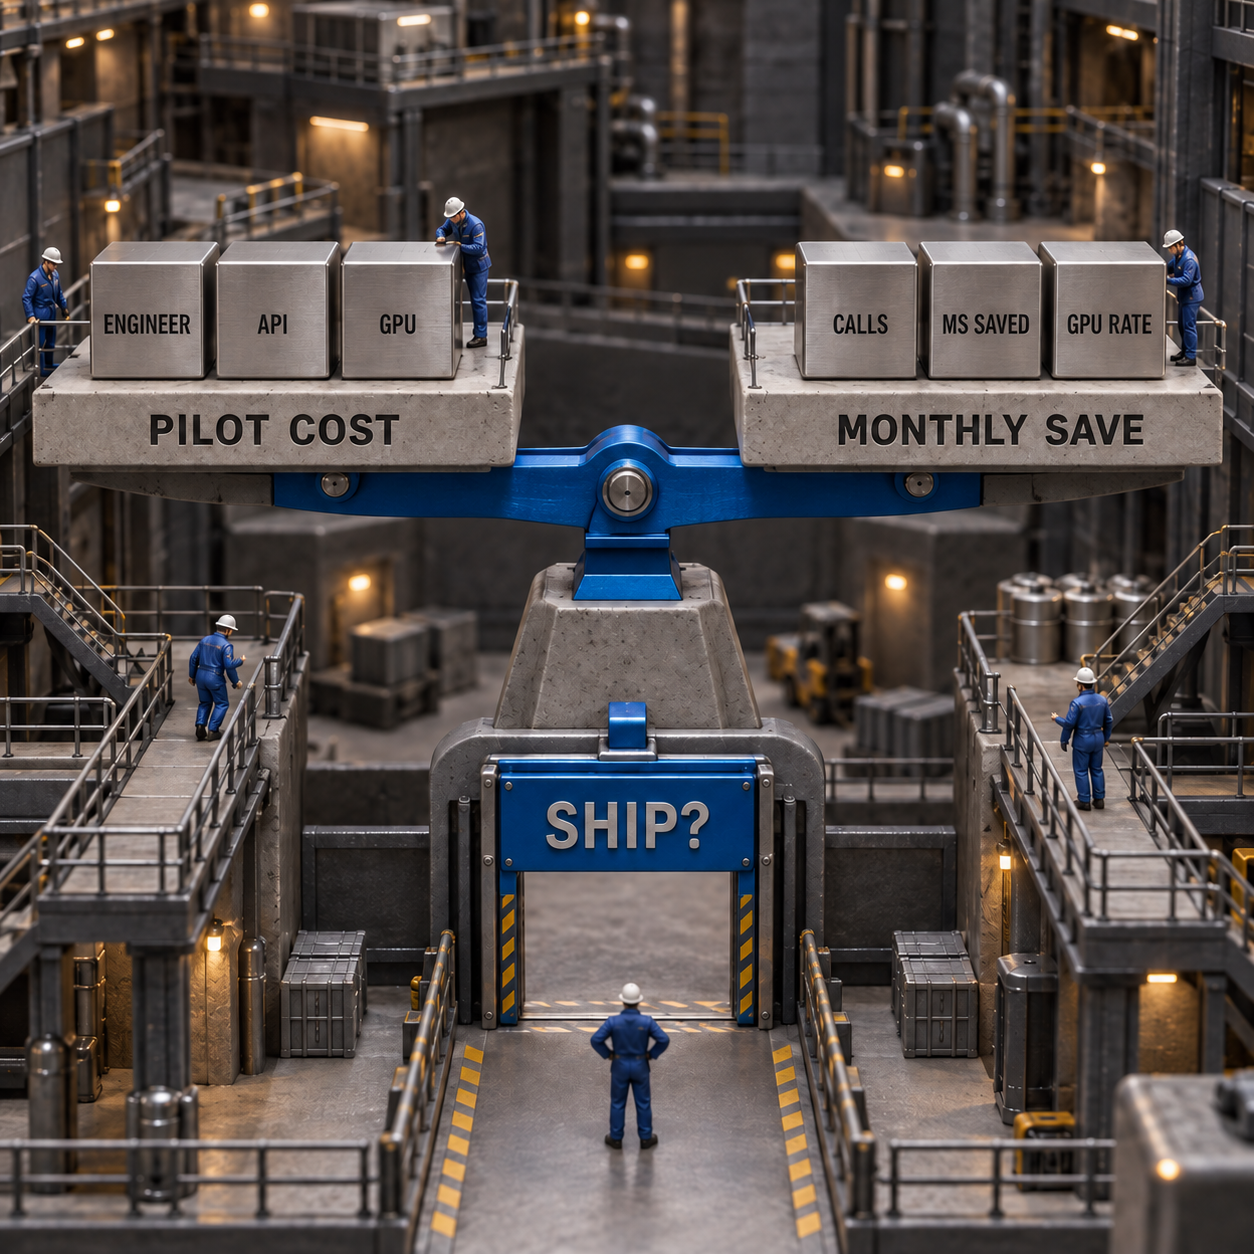
L'alternativa umana non costa poco. La pagina di Upwork dedicata ai consulenti CUDA indica attualmente intervalli orientativi di $500–$1,200 per il profiling delle prestazioni e $2,500–$4,500 per l'ottimizzazione dei kernel. Sono fasce di prezzo di un marketplace, non preventivi né prove che un agente possa sostituire uno specialista. Mostrano però perché un esperimento preliminare ripetibile può essere utile, se restringe il costoso lavoro dell'esperto ai candidati accompagnati da evidenze solide.
La regola go/no-go è netta: passa a un test d'integrazione controllato soltanto se il candidato supera casi indipendenti, batte ripetutamente la baseline, migliora il carico reale e rispetta una finestra di rientro stabilita dal team prima dell'esecuzione.
Sette team che possono sfruttarlo bene
Questi casi d'uso sono ordinati in base alla probabilità che il team riesca a convertire il guadagno di un kernel validato in denaro o capacità risparmiata.
Se il carico di lavoro è un'applicazione completa, una primitiva matura di un fornitore o un insieme di forme in continuo cambiamento, conviene partire da altro. Questo optimizer è dichiaratamente sperimentale e rivolto ai singoli kernel.
Per una panoramica più ampia dei sistemi affini, il confronto esistente tra agenti AI per l'ottimizzazione GPU prende in esame AKO, KernelAgent, AutoKernel, Apex e CUDA Agent. Il repository di Bertaye è un progetto separato e più recente.
Due prodotti da costruire intorno all'optimizer
1. Audit circoscritto di ottimizzazione CUDA
È l'opportunità più solida. Vendi ai team con un singolo kernel CUDA costoso un pacchetto di evidenze a perimetro fisso: acquisizione dell'ambiente, raccolta di casi attendibili, esecuzione di sette tentativi, replay indipendente, contabilizzazione dei costi del modello e della GPU e un report go/no-go.
La domanda è limitata, ma insolitamente specifica. DataForSEO rileva circa 30 ricerche mensili negli Stati Uniti per cuda optimization e 20 per cuda kernel optimization, entrambe con una concorrenza a pagamento bassa. Nello stesso mercato, Upwork indica fasce orientative di $500–$1,200 per il profiling e $2,500–$4,500 per il tuning. Questa combinazione suggerisce un servizio specialistico di nicchia, non un'app self-service di massa.
La versione minima vendibile comprende un modulo di acquisizione sicuro, un runner GPU usa e getta, un manifest dei casi bloccato, un sistema di raccolta dei costi di esecuzione e un report HTML delle evidenze. Mantieni un revisore umano nel processo. Il punto critico è la fiducia: basta un solo vincitore errato per cancellare il valore di molti audit riusciti; inoltre, l'assenza di una licenza nel repository impone di ottenere un'autorizzazione prima di basare un servizio commerciale sul suo codice.
2. Controllo di regressione per kernel GPU
Crea un servizio CI controllato che riesegua i kernel approvati su hardware riservato, verifichi gli output salvati e blocchi una release quando latenza o correttezza peggiorano. I team di piattaforma GPU e le società di consulenza CUDA pagherebbero per avere uno storico stabile attraverso i cambiamenti di driver, toolkit e sorgente.
DataForSEO rileva circa 10 ricerche mensili negli Stati Uniti per gpu performance optimization. Sono troppo poche per un'attività fondata solo sulla SEO, ma bastano a confermare il linguaggio usato dagli acquirenti. La distribuzione dovrebbe passare da società di consulenza, fornitori GPU e team di piattaforma interni.
Un MVP richiede una coda hardware, fingerprint dell'ambiente, casi di riferimento firmati, misurazioni ripetute, soglie e un confronto compatto con l'ultima esecuzione accettata. Il punto critico è la variabilità: host condivisi, stato termico e cambiamenti dei driver possono generare falsi allarmi, a meno che il runner non controlli la macchina e ripeta le misurazioni.
Limiti che devono pesare sulla decisione
La valutazione onesta è che la v0.0 costituisce un'utile struttura per esperimenti, ma comporta un notevole onere di verifica.
- Ottimizza singoli kernel CUDA, non applicazioni complete.
- Superare i casi forniti non dimostra la correttezza generale.
- Un riferimento generato non è un oracolo indipendente.
- I guadagni prestazionali dipendono dal carico e dall'hardware.
- Non è incluso alcun confronto con cuBLAS o altre librerie dei fornitori.
- I tempi predefiniti escludono compilazione e replay del profiler, quindi non rappresentano il costo totale dell'esecuzione.
- Gli script di input generati vengono eseguiti in locale senza sandbox.
- Il percorso di build documentato è Windows; per un'altra piattaforma serve un resoconto di configurazione verificato separatamente.
- Nel commit fissato manca la configurazione di esempio citata.
- Il repository non stabilisce diritti per l'uso commerciale.
Il runner separato è utile quando servono fasi esplicite, evidenze persistenti e un budget ripetibile. Un agente di coding generico può bastare se un esperto sta già supervisionando il terminale, i test sono solidi e il lavoro è davvero occasionale. Il runner giustifica il proprio ruolo solo quando i limiti e la traccia di audit riducono rischio o lavoro ripetitivo.
Domande frequenti
Come si usa Agentic CUDA Optimizer su un Mac?
Il repository fissato documenta una build Windows con una GPU NVIDIA e uno stack CUDA compatibile, non una configurazione per Mac. Usa una macchina NVIDIA remota o usa e getta che sia possibile verificare e tratta quella piattaforma separatamente, senza tradurre a intuito i comandi Windows.
Agentic CUDA Optimizer e ByteDance CUDA Agent sono lo stesso progetto?
No. Questa guida riguarda agentic-cuda-optimizer di Bertaye, un workflow LangGraph con un test runner CUDA in C++ pubblicato nel settembre 2026. CUDA Agent di ByteDance e Tsinghua è un sistema di ricerca distinto, con un proprio repository.
Quale repository GitHub di CUDA Agent usa questa guida?
Usa bertaye/agentic-cuda-optimizer, fissato al commit 1e9464d. Nei risultati di ricerca compare anche BytedTsinghua-SIA/CUDA-Agent, che non è il software configurato qui.
L'optimizer usa un NVIDIA CUDA Agent?
Il ciclo documentato non include un agente NVIDIA separato. Il progetto può facoltativamente recuperare indicazioni NVIDIA con --nvidia-research ed esaminare i contatori di Nsight Compute con --use-nsight, ma la generazione dei candidati e l'orchestrazione restano affidate al workflow del repository.
Il passo concreto per lunedì è semplice: assegna a un ingegnere GPU un kernel float32 a basso rischio, una macchina NVIDIA usa e getta e una giornata per preparare riferimento indipendente, casi e prospetto dei costi. Esegui il progetto pilota da sette tentativi solo quando questi controlli sono stati messi per iscritto.
Se vuoi integrare in un sistema di produzione un esperimento GPU misurato e il relativo percorso di revisione, il servizio sistemi AI in produzione è il punto di partenza più adatto.
- Ultimo aggiornamento
- 25 set 2026
- Categoria
- Build
Preferisca questo sito su Google


Segni omidsaffari.com come fonte preferita e Google lo mette in evidenza per lei in Top Stories, AI Overviews e AI Mode.

Runpod pricing 2026: quanto costano Pod e Serverless
Runpod pricing spiegato con costi di Pod, Serverless e storage, un calcolo H100 con data certa e la soglia di pareggio basata sul tempo fatturabile.25 set 2026Build
Vercel Sandbox Drives: workspace persistenti per agenti
Scopri come usare Vercel Sandbox Drives per conservare workspace, cache e file tra sandbox diverse, gestendo snapshot, regioni, limiti e costi.25 set 2026Build
Web crawler alternativi a Firecrawl: 7 opzioni a confronto
Confronto tra 7 web crawler alternativi a Firecrawl: prezzi, modelli operativi e costi per pagina accettata, con un piano pratico per migrare.25 set 2026Build
AI code review: 7 alternative a CodeRabbit a confronto
Confronto tra 7 alternative a CodeRabbit per AI code review: prezzi, host Git, privacy, self-hosting e costi reali per un team di cinque sviluppatori.25 set 2026Build
AI code review: Greptile o CodeRabbit, quale conviene?
Confronto tra Greptile e CodeRabbit per AI code review: prezzi, limiti, piattaforme, crediti e costi reali per un team di cinque sviluppatori.25 set 2026Build
Perplexity Computer su Windows: guida alla modalità locale
Configura Perplexity Computer in locale su un PC Windows compatibile, scegli il modello giusto e prova un flusso ricorrente sui file con permessi cloud chiari.25 set 2026Build
Workflow AI sotto controllo: AgentRun alla prova
AgentRun mette confini espliciti ai workflow AI: la prova di stato tipizzato, chiamate agli agenti, escalation, costi e limiti della beta.4.24 set 2026Build