Agentic CUDA Optimizerで始める、検証可能なGPU高速化
Agentic CUDA Optimizerを固定コミットからセットアップし、CUDAカーネル探索を7回で区切る手順を解説。独自の参照実装と入力ケース、best.cuの監査、ホールドアウトでの再検証、モデルAPI・GPU時間・レビュー工数を含む採算判断まで、GPU高速化を本番へ持ち込む前に確認すべき要点をまとめます。


GPU高速化の対象として、小規模なfloat32行列乗算カーネルを改善上限7回の探索にかけます。信頼できる全テストケースを通過した候補だけを残し、保存した最良候補がモデル呼び出し、GPU時間、レビュー工数に見合うと確認できるまでは出荷しません。本稿で扱うのはBertayeのAgentic CUDA Optimizerです。ByteDanceとTsinghuaによる研究システムCUDA Agentとは別物です。
まず押さえるべき要点
Agentic CUDA Optimizerは、自律的な証明装置ではなく、範囲を明確に区切った実験ランナーとして使います。 最初のv0.0コミットを固定し、文書どおりのWindows環境でC++テストランナーをビルドします。独自に用意した参照カーネルと入力ケースを渡し、--max-iterations 7で探索回数に上限を設けたうえで、別途リプレイする前にhistory.json、summary.json、best.cuを監査してください。
このオプティマイザーが自動化できるのは、候補の作成、コンパイル、実行、出力不一致時の棄却、合格時の計測、そしてその証拠を次の試行へ渡すループです。一方で、参照実装そのものが正しいか、テストケースが本番環境を十分に網羅しているか、高速化した単体カーネルがGPU全体のコストを下げるかまでは判断できません。
このリポジトリは、2026年9月24日19:41:43 UTCにコミット1e9464da54dfc651337a97c3643bfeefec712bc1として公開されました。本稿が対象とするのは今後更新される版ではなくv0.0なので、このコミットの固定が重要です。
GPU高速化で実際に自動化される範囲
検査工程を備えたモデル工房と考えると分かりやすいでしょう。モデルが作業台で設計し直せるのは、CUDAカーネルという小さな部品と、その起動方法です。測定装置を管理するのはテストランナーです。提供した全ケースで許容範囲の出力が得られた候補だけが、最終候補として残ります。
内部では、スタンドアロンのC++ランナーがNVRTCでCUDAソースをコンパイルし、CUDA Driver API経由で起動して出力を保存します。Pythonはその出力を参照実装と比較し、候補を選別します。correctnessと指定したケースは合格必須ですが、スコアには影響しません。performanceと指定したケースは検証にも使われ、順位付けに用いる幾何平均レイテンシーにも反映されます。
デフォルトでは、計測対象の各ケースについてCUDAイベントを使い、ウォームアップを10回、計測を100回行います。ここで得られるのはカーネルの実行時間であり、ジョブ全体のコストではありません。コンパイル、モデル呼び出し、失敗した試行、入力生成、プロファイラーのリプレイ、人によるレビューは、すべてこのレイテンシーの外側です。
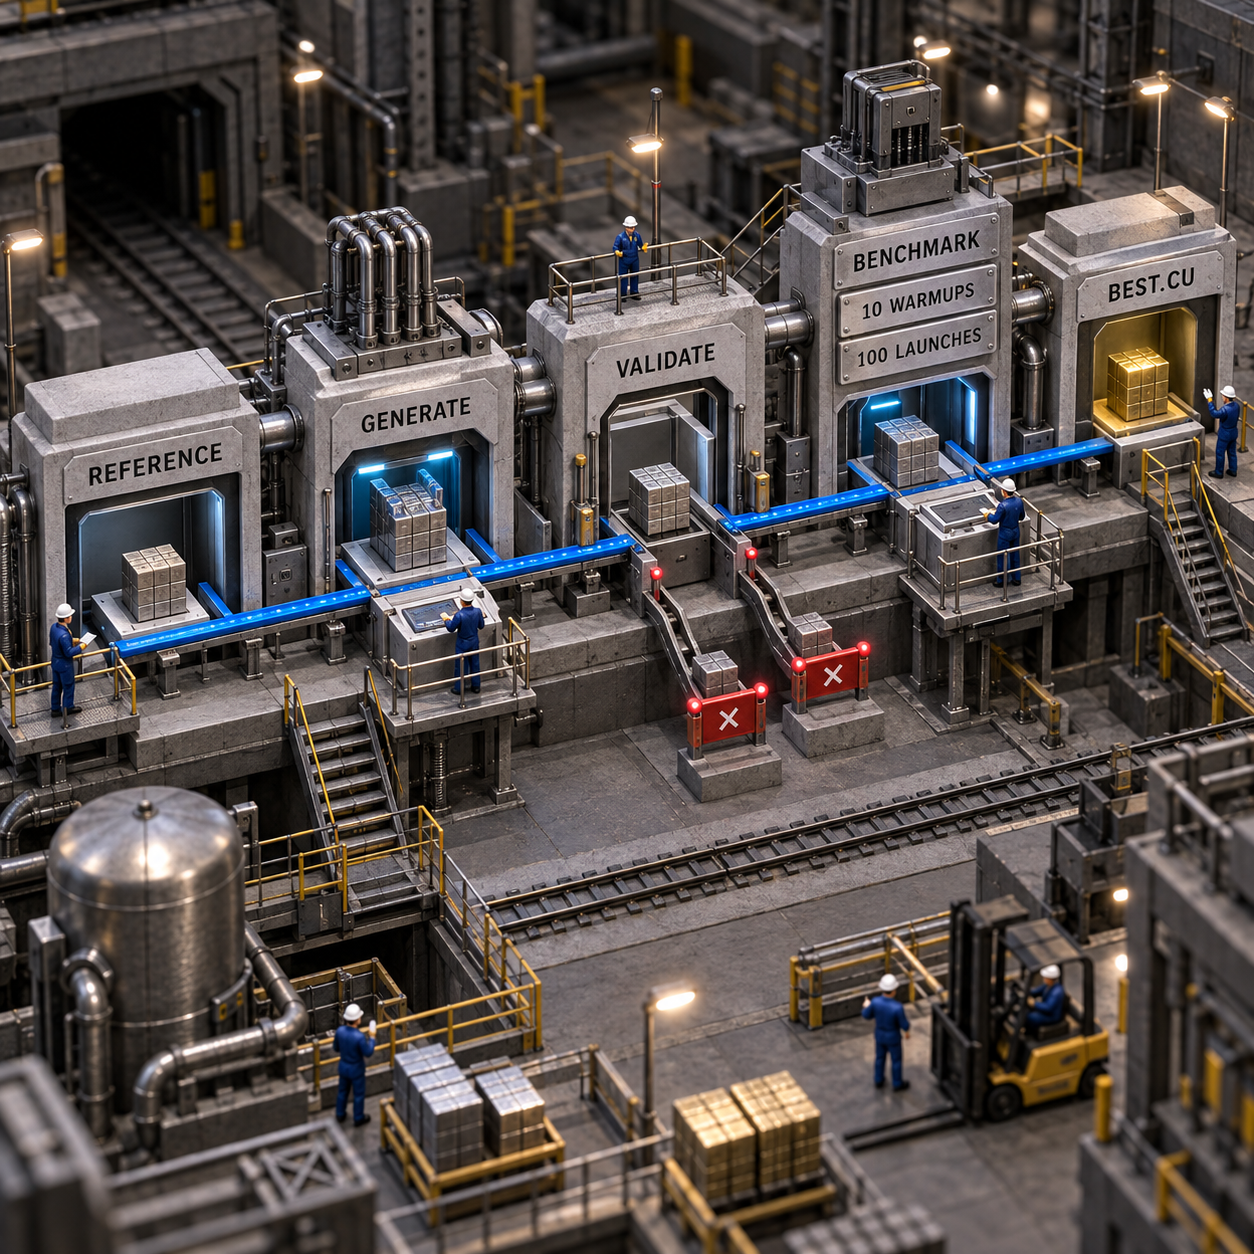
一般的なコーディングエージェントに1回のプロンプトで巧妙なカーネルを書かせるのではなく、このテストランナーを使う理由は、まさにこの分離にあります。明示的なゲートを持つ、記録可能で上限のあるループにできる点が利点です。ただし、LangGraphが高性能なコーディングエージェントより優れた答えを見つける証明にはなりません。リポジトリ作者も公開時の議論で、価値は各工程を囲うガードレールにあると説明しています。
固定したWindowsビルド環境を整える
まずは文書化されているWindows手順に従ってください。 このリポジトリはRTX 3060 Laptop GPUで開発され、C++ツールを含むVisual Studio 2026の使用が案内されています。コンパイル前に、Python 3.12以降、CMake 3.24以降、C++17コンパイラー、NVIDIAドライバー、互換性のあるCUDA Toolkitが揃っていることを確認します。
python --version
cmake --version
where.exe cl
nvidia-smi
nvcc --version

git clone https://github.com/bertaye/agentic-cuda-optimizer.git
cd agentic-cuda-optimizer
git checkout --detach 1e9464da54dfc651337a97c3643bfeefec712bc1

python -m venv .venv
.venv\Scripts\python -m pip install -r optimizer_agent/requirements.txt
cmake -S cuda_test_harness -B cuda_test_harness/build -DCMAKE_BUILD_TYPE=Release
cmake --build cuda_test_harness/build --parallel

Set-Content .env 'OPENAI_API_KEY=your-key-here'
前提条件の確認が1つでも失敗したら、そこで止めてください。エージェントがカーネルを変更している最中にツールチェーンまで直すと、失敗原因の切り分けが難しくなります。
v0.0には、特に注意すべき点が2つあります。
- READMEでは
--config optimizer_agent/example.jsonが提案されていますが、固定したコミットにはそのファイルが存在しません。明示的なフラグを使うか、独自の設定を作成してレビューしてください。 - 公開リポジトリにはライセンスファイルがなく、GitHubもライセンスを検出していません。公開されていること自体は、商用利用の許諾を意味しません。社内利用、再配布、有料製品への組み込みの前に、許可を得るか法務確認を行ってください。
このバージョンでは、ほかのプラットフォーム向けセットアップ手順は文書化されていません。本稿ではLinux環境も確認しましたが、必要なCUDAツールとビルドツールがなかったため、実施できたのは前提条件の監査までであり、Linuxでの動作確認ではありません。
最後に、実行マシンを隔離します。オプティマイザーに入力を生成させると、生成されたPythonコードはサンドボックスなしでローカル実行されます。生成されたCUDAコードもGPU上で直接動きます。権限を絞り、本番データや無関係な機密情報を置かず、重要なファイル共有にも接続しない使い捨てホストまたはVMを使ってください。
正直に失敗できる実験を1つ設計する
まずは、仕様を1ページで説明できるカーネルを1つ選びます。 行優先のfloat32行列乗算は、入力、出力、次元が明確なのでパイロットに適しています。また、都合のよい正方行列だけでは見逃しやすい境界処理も、端数のあるサイズなら検証できます。
オプティマイザーの結果ディレクトリとは別の場所に、次の3つを用意します。
reference.cu:信頼できる出所から得た、単純でレビュー済みの実装。同じモデルに正解判定用の実装と候補の両方を作らせないでください。initial.cu:そのままなら実際に出荷するベースライン。性能の低い生成コードに対する大幅な改善を、事業上の成果と取り違えないために必要です。input_cases.json:固定された再現可能なバイナリ入力と、数値計算の要件に即した意味のある比較許容誤差を含むケース。
範囲を限定したパイロットなら、M=31、N=37、K=29のような端数形状の正しさ検証ケースを1つ、256×256×256とM=384、N=256、K=320のような控えめな性能ケースを2つ用意できます。これらは実験設計の提案であり、リポジトリのベンチマークではありません。探索中に見せない第4のホールドアウト形状と新しい値も別途保持し、最終候補を未見ケースで検証します。
ゼロや1だけでなく、意味のある値を使ってください。各バッファーのサイズ、引数順、スカラー型、許容誤差をすべてレビューします。マニフェストにはperformanceケースが少なくとも1つ必要です。全ケースが合格必須ですが、順位に影響するのは性能ケースだけです。
実行前に、参照実装、入力、テストランナーのハッシュを取るかコピーを保存します。オプティマイザーに変更を許すのは、候補ソースとケースごとの起動設定です。成功条件そのものは変更させません。
改善試行は正確に7回で打ち切る
次のコマンドでは、入力を明示し、文書化されたWindows用インタープリターパスを使っています。エントリーシグネチャを固定し、独立した参照実装と実際のベースラインを渡し、改善試行の上限を7回に設定します。
.venv\Scripts\python optimizer_agent\optimizer_agent.py `
  --description "Row-major float32 matrix multiplication C=MxN from A=MxK and B=KxN." `
  --signature 'extern "C" __global__ void matmul_f32(const float* a, const float* b, float* c, int m, int n, int k)' `
  --reference .\experiment\reference.cu `
  --initial-kernel .\experiment\initial.cu `
  --input-cases .\experiment\input_cases.json `
--max-iterations 7デフォルトモデルはgpt-5-mini、推論強度はmediumで、API利用料は自身のアカウントに課金されます。改善試行7回は、モデル呼び出しが7回、あるいはカーネル起動が7回という意味ではありません。1つの提案でもツール呼び出しや修正の再試行が発生し、計測対象の各ケースだけでもデフォルトでウォームアップ10回と計測100回が実行されます。
最初のクリーンなベースラインでは、--use-nsightと--nvidia-researchを無効のままにします。Nsightプロファイリングはリプレイ作業を増やし、Nsight Computeに加えてGPUパフォーマンスカウンターを読み取る権限も必要です。NVIDIAリサーチはモデル処理と情報取得を追加します。基本ループが安定してから、変数を1つずつ追加してください。
実行を開始する前に実験ログを用意し、次の内容を記録します。
- 固定したコミットと作業ツリーの変更状態
- GPUモデル、ドライバー、CUDA Toolkitのバージョン
- 参照実装とケースのハッシュ
- 開始時刻と終了時刻
- GPUの総経過時間
- 保存されたレスポンスファイルから確認できるモデル名、呼び出し回数、トークン数、その他の利用メタデータ
- 有効な候補、棄却した候補、棄却理由
- ベースラインと最良候補について、ケースごとのレイテンシー
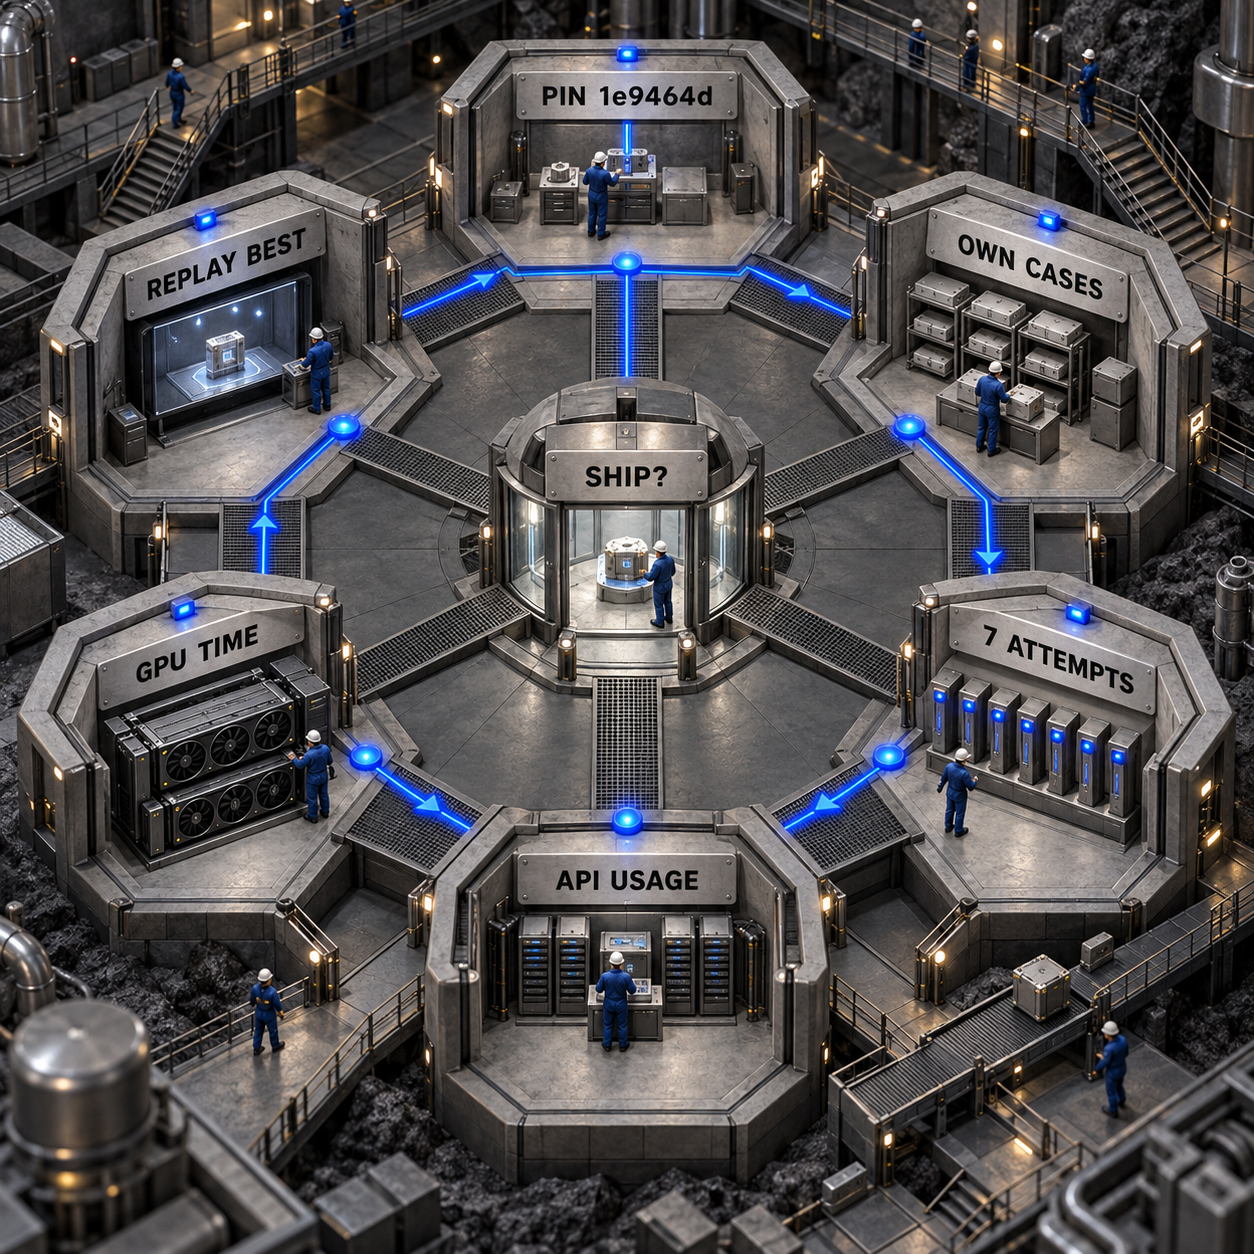
タイミング比較中は、GPUでほかの処理を動かさないでください。バックグラウンドのGPU負荷があると、わずかな見かけ上の改善を測定ノイズと誤認しかねません。
証拠を読み、最良候補を再実行する
結果ディレクトリは成果物置き場ではなく、監査資料一式として扱います。 各セッションはresults/run-NNN/以下に保存されます。まず、次のファイルを確認してください。
history.jsonには、評価した全試行、ケース単位の実行詳細、検証結果、起動設定、計測レイテンシーが記録されます。summary.jsonには、最良イテレーション、ケースごとのレイテンシー、利用可能なベースライン比の高速化率、終了理由が記載されます。best.cuは、提供した全ケースを通過した候補のうち最速のものです。best-case-N.jsonは、提供した各ケースで最良ソースを再実行するためのリクエストです。model-*.jsonとツールレスポンスファイルには、エージェントとのやり取りが残ります。summary.jsonはモデル費用を合計しないため、APIコストの把握には各ファイルの利用メタデータを確認してください。heatmap.pngとheatmap.svgは、計測履歴を可視化します。調査箇所を探す助けにはなりますが、正しさの証拠ではありません。
有効な候補だけでなく、棄却した候補も同じ慎重さで数えてください。6件の提案が棄却され、限定的な勝者が1件だけ残った実行と、全候補が有効だった実行では、得られる示唆が異なります。コンパイル失敗や出力不一致を確認し、最良候補のソースが親候補から実際に変化しているかもレビューします。
次に、アイドル状態の同じGPUで、保存された各best-case-N.jsonをテストランナーに渡して再実行します。その後、独立した正解判定を使い、未公開の形状と新しい値でbest.cuをテストします。提供したケースが示せるのは、その候補が当該ケースに合格したことだけです。一般的な正しさ、競合状態がないこと、すべての有効形状で安全に動くことまでは証明できません。
ホールドアウトに1つでも失敗する場合、計測を繰り返すとベースラインとの差がノイズ範囲に収まる場合、実アプリケーション内で改善が消える場合は、その候補を棄却してください。生成した参照実装だけを正解判定に使うのは不十分です。また、生成された初期カーネルに勝っても、cuBLASなど本番用ベースラインに勝ったことにはなりません。このリポジトリはcuBLASとの比較を公開していません。
高速化がコストに見合うか判断する
単体カーネルのスコアではなく、ジョブ全体の採算で判断します。 公開リポジトリにサブスクリプション価格はありませんが、商用ライセンスも付与されていません。実験には、それでもエンジニアの工数、モデルAPI利用料、GPU時間がかかります。
実用的な試算表は、次の3行で構成できます。
pilot cost = engineer setup and review + model charges + GPU wall-clock costsaved GPU hours per month = end-to-end milliseconds saved per invocation × monthly invocations ÷ 3,600,000payback months = pilot cost ÷ monthly gross GPU saving
summary.jsonのCUDAイベントレイテンシーではなく、統合後に短縮できたエンドツーエンドのミリ秒を使います。1リクエスト内でカーネルを複数回実行するなら、実測した呼び出し回数を反映してください。高速化によってスループット、メモリ負荷、バッチ処理が変わる場合は、カーネル結果から推測で延長せず、ワークロード全体を再計測します。
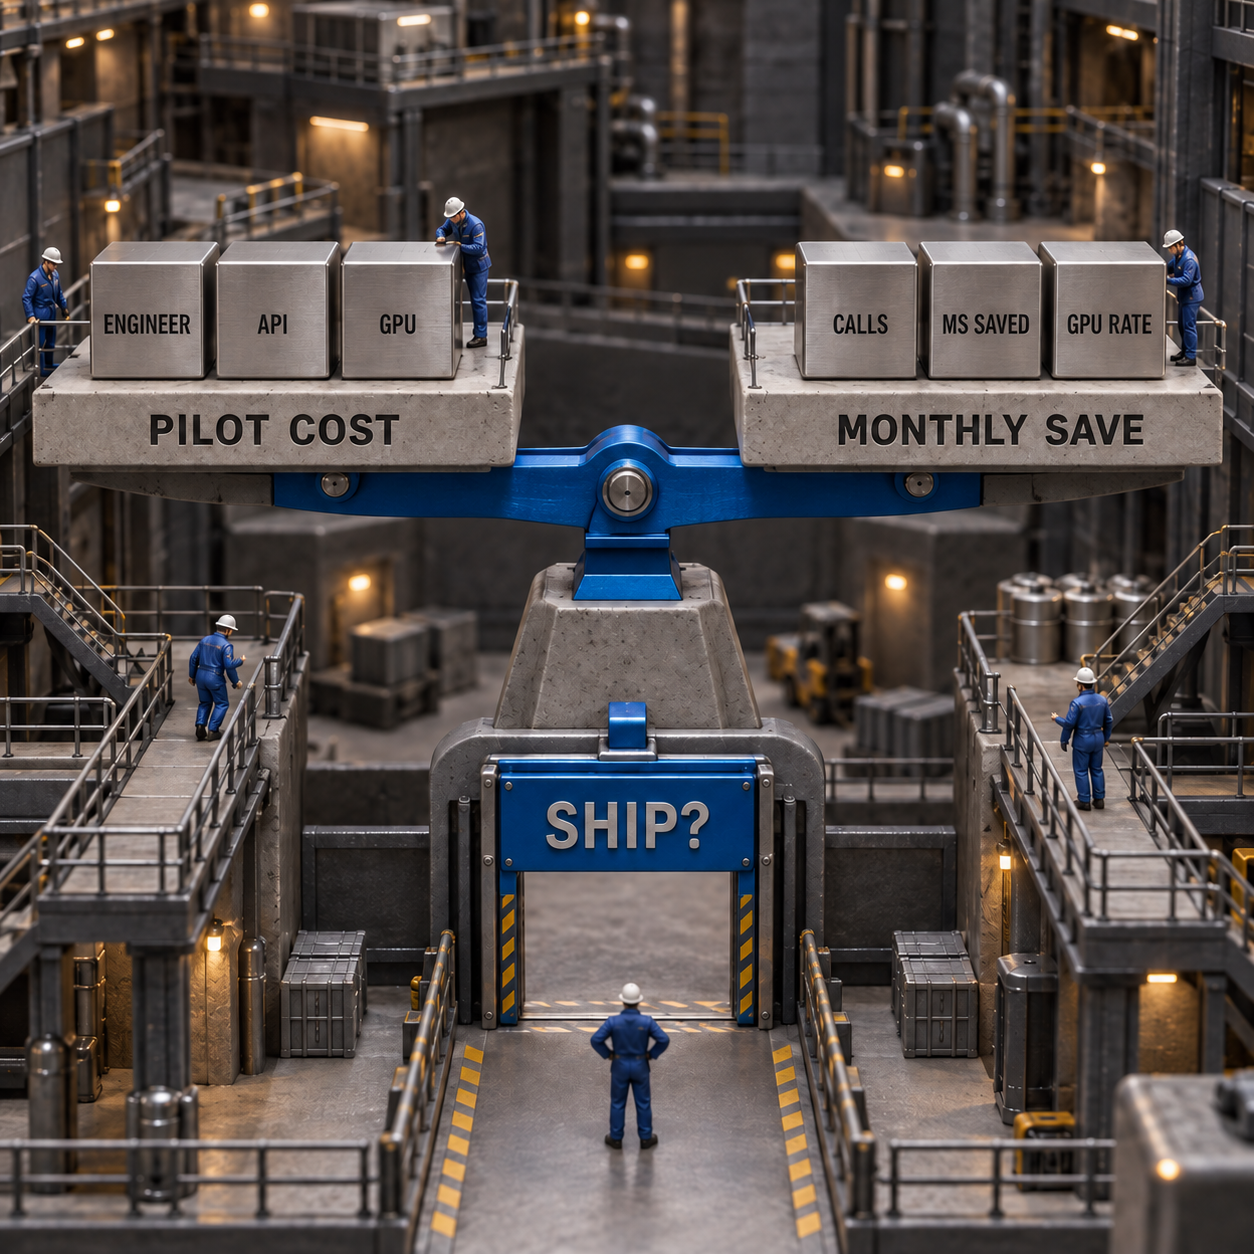
人手による代替手段にも費用がかかります。UpworkのCUDAコンサルタント向けページでは現在、計画時の目安としてパフォーマンスプロファイリングは$500〜$1,200、カーネルチューニングは$2,500〜$4,500と示されています。これはマーケットプレイス上の価格帯であって見積もりではなく、エージェントが専門家を代替できる証拠でもありません。ただし、証拠の整った候補に高額な専門作業を絞り込めるなら、再現可能な初期実験に価値がある理由は分かります。
採用判断は明快です。独立ケースに合格し、ベースラインを繰り返し上回り、実ワークロードを改善し、実験前にチームで決めた回収期間に収まる場合に限って、管理された統合テストへ進めます。
この仕組みを活用しやすい7つのチーム
検証済みのカーネル改善を、収益または計算資源の節約につなげやすい順に並べています。
対象がアプリケーション全体、成熟したベンダー製プリミティブ、あるいは形状が絶えず変わるワークロードなら、別の手段から始めるべきです。このオプティマイザーは明確に実験段階で、個別カーネルを対象にしています。
周辺システムを広く比較したい場合は、既存のGPU最適化向けAIエージェント比較でAKO、KernelAgent、AutoKernel、Apex、CUDA Agentを取り上げています。Bertayeのリポジトリは、それらとは別の新しいプロジェクトです。
周辺に構築できる2つのプロダクト
1. 範囲限定型CUDA最適化監査
最も有望なのはこの案です。 高コストなCUDAカーネルを1つ抱えるチームに、範囲を固定した証拠パッケージを販売します。内容は、環境情報の記録、信頼できるテストケースの受け入れ、7回の探索、独立リプレイ、モデルとGPUのコスト集計、採用可否レポートです。
需要は小さいものの、非常に具体的です。DataForSEOによると、米国でのcuda optimizationは月間約30検索、cuda kernel optimizationは月間約20検索で、どちらも有料検索の競争は低水準です。同じ市場では、Upworkにおける計画価格がプロファイリングで$500〜$1,200、チューニングで$2,500〜$4,500となっています。この組み合わせが示すのは、大衆向けセルフサービスアプリではなく、狭い領域に特化した専門サービスです。
販売可能な最小構成は、安全な受付フォーム、使い捨てGPUランナー、ロックしたケースマニフェスト、実行コスト収集機能、HTML形式の証拠レポートです。人によるレビューは必ず残してください。課題は信頼性です。誤った最良候補が1つあれば、多くの監査成功で積み上げた価値が失われかねません。また、リポジトリにライセンスがないため、そのコードを商用サービスの基盤にする前に許可が必要です。
2. GPUカーネル回帰ゲート
予約済みハードウェア上で承認済みカーネルを再実行し、保存済み出力を確認して、レイテンシーまたは正しさに後退があればリリースを止める管理型CIサービスを構築します。GPUプラットフォームチームやCUDAコンサルティング会社にとって、ドライバー、ツールキット、ソースの変更をまたいで安定した記録を残せることには対価を払う価値があります。
DataForSEOによると、米国でのgpu performance optimizationは月間約10検索です。SEOだけで事業を成立させるには少なすぎますが、買い手が使う言葉を検証するには十分です。販売経路は、コンサルティング会社、GPUベンダー、社内プラットフォームチームとの連携が中心になります。
MVPに必要なのは、ハードウェアキュー、環境フィンガープリント、署名済み参照ケース、反復計測、しきい値、前回承認した実行との差分をまとめた簡潔な表示です。課題はばらつきです。ランナー側でマシンを管理して測定を繰り返さない限り、共有ホスト、熱状態、ドライバー変更によって誤検知が起こり得ます。
判断を左右する制約
率直に言えば、v0.0は有用な実験用の足場ですが、利用者側に大きな検証責任があります。
- 最適化対象は個別のCUDAカーネルであり、アプリケーション全体ではありません。
- 提供したケースへの合格は、一般的な正しさを保証しません。
- 生成した参照実装は、独立した正解判定にはなりません。
- 性能向上はワークロードとハードウェアに依存します。
- cuBLASなど、ほかのベンダーライブラリとの比較は含まれていません。
- デフォルトの計測にはコンパイルとプロファイラーのリプレイが含まれず、総実行コストではありません。
- 生成された入力スクリプトは、サンドボックスなしでローカル実行されます。
- 文書化されたビルド手順はWindows向けです。ほかのプラットフォームでは、別途検証したセットアップ記録が必要です。
- 固定したコミットには、名前の挙がっている設定例がありません。
- このリポジトリは商用利用権を明示していません。
工程を明示し、証拠を継続的に保存し、予算を繰り返し管理したい場合は、独立したランナーに価値があります。一方、専門家がすでにターミナルを監督し、テストが十分で、本当に1回限りの作業なら、一般的なコーディングエージェントで足りる可能性があります。このランナーを採用する意味があるのは、ガードレールと監査証跡によってリスクや反復作業を減らせる場合だけです。
よくある質問
MacでAgentic CUDA Optimizerを使うには?
固定したリポジトリで文書化されているのは、NVIDIA GPUと互換性のあるCUDA環境を備えたWindowsビルドであり、Mac向けセットアップではありません。検証可能なリモートまたは使い捨てのNVIDIAマシンを使い、Windowsコマンドを推測で置き換えるのではなく、別プラットフォームとして明記してください。
Agentic CUDA OptimizerとByteDance CUDA Agentは同じですか?
いいえ。本稿で扱うのは、2026年9月に公開されたLangGraphワークフローとC++ CUDAテストランナーからなるBertayeのagentic-cuda-optimizerです。ByteDanceとTsinghuaのCUDA Agentは、別の研究システムであり、リポジトリも異なります。
本稿で使うCUDA-AgentのGitHubリポジトリはどれですか?
使用するのは、コミット1e9464dに固定したbertaye/agentic-cuda-optimizerです。検索結果にはBytedTsinghua-SIA/CUDA-Agentも表示されますが、本稿で設定するソフトウェアではありません。
このオプティマイザーはNVIDIA CUDA Agentを使いますか?
文書化されたループに、独立したNVIDIAエージェントは含まれていません。--nvidia-researchでNVIDIAのガイダンスを取得し、--use-nsightでNsight Computeのカウンターを調べることはできますが、候補生成とオーケストレーションは、このリポジトリ独自のワークフロー内で行われます。
週明けにやることはシンプルです。GPUエンジニア1名に、低リスクなfloat32カーネル1つ、使い捨てNVIDIAマシン1台、独立した参照実装・ケース・コスト表を準備する1日を割り当てます。これらのゲートを文書化してから、7回のパイロットを実行してください。
計測可能なGPU実験とそのレビュープロセスを本番システムに組み込みたい場合は、AI本番システムが適した出発点です。
- 最終更新
- 2026年9月25日
- カテゴリー
- Build
Googleでこのサイトを優先する


omidsaffari.comを優先ソースに設定すると、GoogleがTop Stories・AI Overviews・AI Modeであなたのために優先表示します。

Runpod 料金ガイド(2026年版):PodsとServerlessはどちらが得か
Runpod 料金をPods、Serverless、ストレージ別に整理。H100の実勢価格、100時間・730時間・リクエスト単位の試算、課金時間60.33%の損益分岐点を、2026年9月25日に確認した公式価格に基づいて比較します。GPUクラウドの構成選びと予算化に必要な判断基準も分かります。2026年9月25日Build
Vercel Sandbox Driveで作る永続クラウド開発環境:導入と検証ガイド
Vercel Sandbox Driveで、エージェントの作業フォルダを新しいサンドボックスへ引き継ぐ方法を解説します。永続クラウド開発環境の構築手順、スナップショット、単一ライター制約、リージョン設計、料金、導入前に確認したい4つのテストをTypeScript例とともに整理します。2026年9月25日Build
Webクローラー比較:Firecrawl代替7選を料金・機能・移行コストで検証
Firecrawlの代替となるWebクローラー7製品を、Markdown・JSON出力、探索範囲、レンダリング、料金、運用工数で比較。1,000〜100,000件の採用ページを基準に、Apify、Crawl4AI、ScrapFlyなどの向き不向きと、安全な移行手順まで具体的に整理します。2026年9月25日Build
AI コードレビューで選ぶCodeRabbit代替ツール7選
CodeRabbitの代替7製品を、Gitホスト対応、データ境界、料金単位、セルフホスト可否で比較。5人・300回のAI コードレビューを基準に、Greptile、cubic、Qodo、PR-Agent、Kodus、Cursor Bugbot、GitHub Copilotの費用、選び方、乗り換え条件を整理します。2026年9月25日Build
AI コードレビュー比較:GreptileとCodeRabbitはどちらを選ぶ?
AI コードレビューのGreptileとCodeRabbitを、料金体系、レビュー上限、対応Gitホスト、実行時検証の違いで比較。5人チームの費用試算を基に、定常的なPRにはCodeRabbit、深度調整やT-Rexが必要なレビューにはGreptileを選ぶ判断基準を解説します。2026年9月25日Build
Perplexity Portable Computerの使い方:AMD WindowsでローカルAIを動かす
Perplexity Portable ComputerをAMD Ryzen AI Max搭載Windows PCでローカル実行する条件と設定手順を解説。GPUアクセス可能メモリ24 GB、モデル選択、フォルダー権限、クラウド承認、定期実行まで、既知の例外3件を使った検証方法とともに整理します。2026年9月25日Build
AgentRun レビュー:beta.4を実測、導入価値と限界を検証
AgentRun レビューとしてbeta.4をサポート業務で実測。分岐制御、型付き状態、エスカレーション、料金、LangGraph.jsやTemporalとの違いを検証し、31行のTypeScript関数より導入価値が出る条件、ホスト側に残る実装負担、採用前に確認すべき制約まで具体的なテスト結果から解説します。2026年9月24日Build