Otimização CUDA com Agentic CUDA Optimizer: guia prático
Aprenda a usar o Agentic CUDA Optimizer em um teste controlado, validar kernels, medir custos de GPU e decidir se o ganho de desempenho compensa.


Conduza a otimização CUDA de um pequeno kernel de multiplicação de matrizes float32 em uma busca de sete tentativas, mantenha candidatos apenas quando todos os casos confiáveis forem aprovados e não coloque nada em produção até que o vencedor salvo compense as chamadas ao modelo, o tempo de GPU e o trabalho de revisão. Este guia trata do Agentic CUDA Optimizer de Bertaye, não do sistema de pesquisa CUDA Agent da ByteDance e da Tsinghua.
Otimização CUDA: a resposta curta
Use o Agentic CUDA Optimizer como executor de experimentos com limites claros, não como uma máquina autônoma de provas. Fixe o commit inicial v0.0, compile o executor de testes em C++ no ambiente Windows documentado, forneça seu próprio kernel de referência e seus casos de entrada, limite a busca com --max-iterations 7 e, depois, audite history.json, summary.json e best.cu antes de repetir os testes separadamente.
O otimizador automatiza um ciclo útil: escreve um candidato, compila, executa, rejeita quando as saídas divergem, mede o tempo quando elas são aprovadas e usa essas evidências na tentativa seguinte. O que ele não consegue fazer é confirmar se a referência está correta, se os casos representam o ambiente de produção ou se um kernel isolado mais rápido reduz a conta total de GPU.
O repositório foi lançado no commit 1e9464da54dfc651337a97c3643bfeefec712bc1, em 24 de setembro de 2026, às 19:41:43 UTC. Fixar esse commit é importante porque este guia descreve a v0.0, não as mudanças que vierem depois.
O que o otimizador realmente faz
Pense nele como uma oficina com etapas de inspeção. O modelo pode redesenhar a pequena peça na bancada — o kernel CUDA — e ajustar a forma como ela é lançada. Já o executor de testes controla os instrumentos de medição. Um candidato só chega à vitrine depois de produzir uma saída aceitável em todos os casos fornecidos.
Nos bastidores, um executor independente em C++ compila o código CUDA com NVRTC, inicia sua execução pela CUDA Driver API e salva as saídas. O Python compara essas saídas com a referência e seleciona os candidatos. Casos marcados como correctness precisam ser aprovados, mas não afetam a pontuação. Casos marcados como performance validam o resultado e também entram na latência por média geométrica usada na classificação.
Por padrão, cada caso cronometrado recebe 10 execuções de aquecimento e 100 execuções medidas com eventos CUDA. Esses números representam o tempo do kernel, não o custo da tarefa. Compilação, chamadas ao modelo, tentativas rejeitadas, geração de entradas, repetições do profiler e revisão humana ficam fora dessa latência.
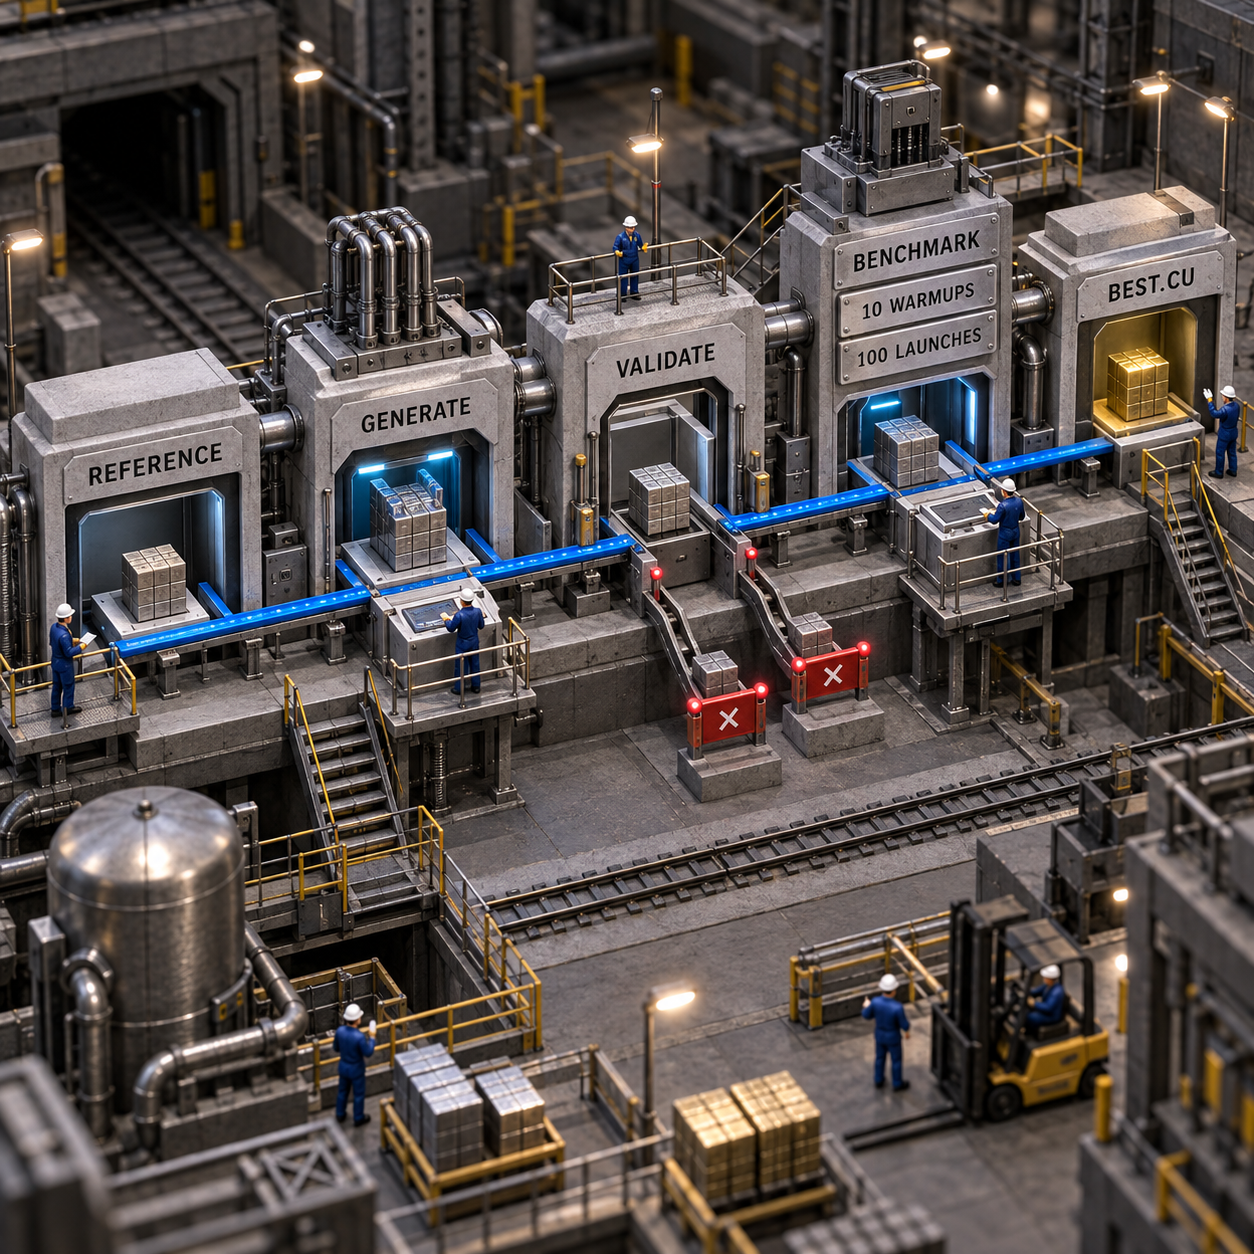
Essa separação justifica usar o executor de testes em vez de pedir a um agente de programação genérico um único kernel engenhoso em um único prompt. O ganho está em ter um ciclo registrado, limitado e com critérios explícitos. Isso não prova que o LangGraph encontrará uma resposta melhor do que um agente de programação competente. O autor do repositório destacou o mesmo ponto na discussão de lançamento: o valor está nos limites impostos às etapas.
Como preparar o build fixado no Windows
Comece pelo caminho documentado para Windows. O repositório foi desenvolvido com uma RTX 3060 Laptop GPU e documenta o uso do Visual Studio 2026 com as ferramentas de C++. Antes de compilar, confirme que você tem Python 3.12 ou mais recente, CMake 3.24 ou mais recente, um compilador C++17, um driver NVIDIA e um CUDA Toolkit compatível.
python --version
cmake --version
where.exe cl
nvidia-smi
nvcc --version

git clone https://github.com/bertaye/agentic-cuda-optimizer.git
cd agentic-cuda-optimizer
git checkout --detach 1e9464da54dfc651337a97c3643bfeefec712bc1

python -m venv .venv
.venv\Scripts\python -m pip install -r optimizer_agent/requirements.txt
cmake -S cuda_test_harness -B cuda_test_harness/build -DCMAKE_BUILD_TYPE=Release
cmake --build cuda_test_harness/build --parallel

Set-Content .env 'OPENAI_API_KEY=your-key-here'
Pare se algum pré-requisito falhar. Corrigir o ambiente de desenvolvimento enquanto um agente também altera kernels torna difícil identificar a causa de cada falha.
Dois detalhes da v0.0 merecem atenção:
- O README sugere
--config optimizer_agent/example.json, mas esse arquivo não existe no commit fixado. Use flags explícitas ou crie e revise sua própria configuração. - O repositório público não contém um arquivo de licença, e o GitHub informa que nenhuma licença foi detectada. Visibilidade pública não equivale a autorização de uso comercial. Obtenha permissão ou uma análise jurídica antes de usar o projeto em uma empresa, redistribuí-lo ou incorporá-lo a um produto pago.
Nenhuma outra plataforma tem um processo de configuração documentado nessa versão. Um ambiente Linux foi verificado para este artigo, mas não tinha as ferramentas necessárias de CUDA e build; portanto, foi uma auditoria de pré-requisitos, não um teste bem-sucedido no Linux.
Por fim, isole a máquina. Se você permitir que o otimizador crie as entradas, o Python gerado será executado localmente sem sandbox. O CUDA gerado também roda diretamente na GPU. Use uma máquina descartável ou VM, com credenciais restritas, sem dados de produção, sem outros segredos e sem acesso a compartilhamentos de arquivos importantes.
Monte um experimento capaz de falhar com honestidade
Comece com um único kernel cujo contrato caiba em uma página. Uma multiplicação de matrizes float32 com armazenamento row-major é um bom piloto: entradas, saída e dimensões são explícitas, e tamanhos ímpares revelam problemas de tratamento das bordas que casos quadrados convenientes podem esconder.
Prepare três recursos fora do diretório de resultados do otimizador:
reference.cu, uma implementação simples e revisada, obtida de uma fonte confiável. Não peça ao mesmo modelo que crie o oráculo e o candidato.initial.cu, o baseline real que seria colocado em produção. Assim, um ganho expressivo sobre um código gerado fraco não será confundido com um ganho para o negócio.input_cases.json, com entradas binárias fixas e reproduzíveis, além de tolerâncias de comparação adequadas ao seu contrato numérico.
Um piloto limitado pode incluir um caso de correção com dimensões ímpares, como M=31, N=37, K=29, seguido de dois casos modestos de desempenho, como 256 por 256 por 256 e M=384, N=256, K=320. Essas são sugestões para o desenho do experimento, não benchmarks do repositório. Mantenha uma quarta dimensão de holdout e valores inéditos fora do otimizador, para que o candidato final enfrente um caso que não viu durante a busca.
Use valores não triviais, em vez de apenas zeros ou uns. Revise o tamanho de cada buffer, a ordem dos argumentos, o tipo escalar e a tolerância. O manifesto deve conter ao menos um caso de performance. Todos os casos precisam ser aprovados, mas somente os de desempenho afetam a classificação.
Calcule o hash ou faça uma cópia da referência, das entradas e do executor de testes antes da execução. O otimizador deve ter liberdade para mudar o código candidato e as configurações de lançamento de cada caso, não a definição de sucesso.
Execute exatamente sete tentativas de melhoria
O comando abaixo usa entradas explícitas e o caminho documentado do interpretador no Windows. Ele fixa a assinatura de entrada, fornece a referência independente e o baseline real e limita o orçamento de melhoria a sete tentativas.
.venv\Scripts\python optimizer_agent\optimizer_agent.py `
  --description "Row-major float32 matrix multiplication C=MxN from A=MxK and B=KxN." `
  --signature 'extern "C" __global__ void matmul_f32(const float* a, const float* b, float* c, int m, int n, int k)' `
  --reference .\experiment\reference.cu `
  --initial-kernel .\experiment\initial.cu `
  --input-cases .\experiment\input_cases.json `
  --max-iterations 7
O modelo padrão é o gpt-5-mini, com esforço de raciocínio médio, e o uso da API é cobrado na sua conta. Sete tentativas de melhoria não significam sete chamadas ao modelo nem sete execuções do kernel. Uma proposta pode usar chamadas de ferramentas e novas tentativas de correção, enquanto cada caso cronometrado, por si só, usa por padrão 10 aquecimentos e 100 execuções medidas.
Deixe --use-nsight e --nvidia-research desativados no primeiro baseline limpo. O perfilamento com Nsight acrescenta repetições e exige o Nsight Compute, além de permissão para ler os contadores de desempenho da GPU. A pesquisa da NVIDIA acrescenta trabalho de modelo e recuperação de informações. Depois que o ciclo básico estiver estável, introduza uma variável de cada vez.
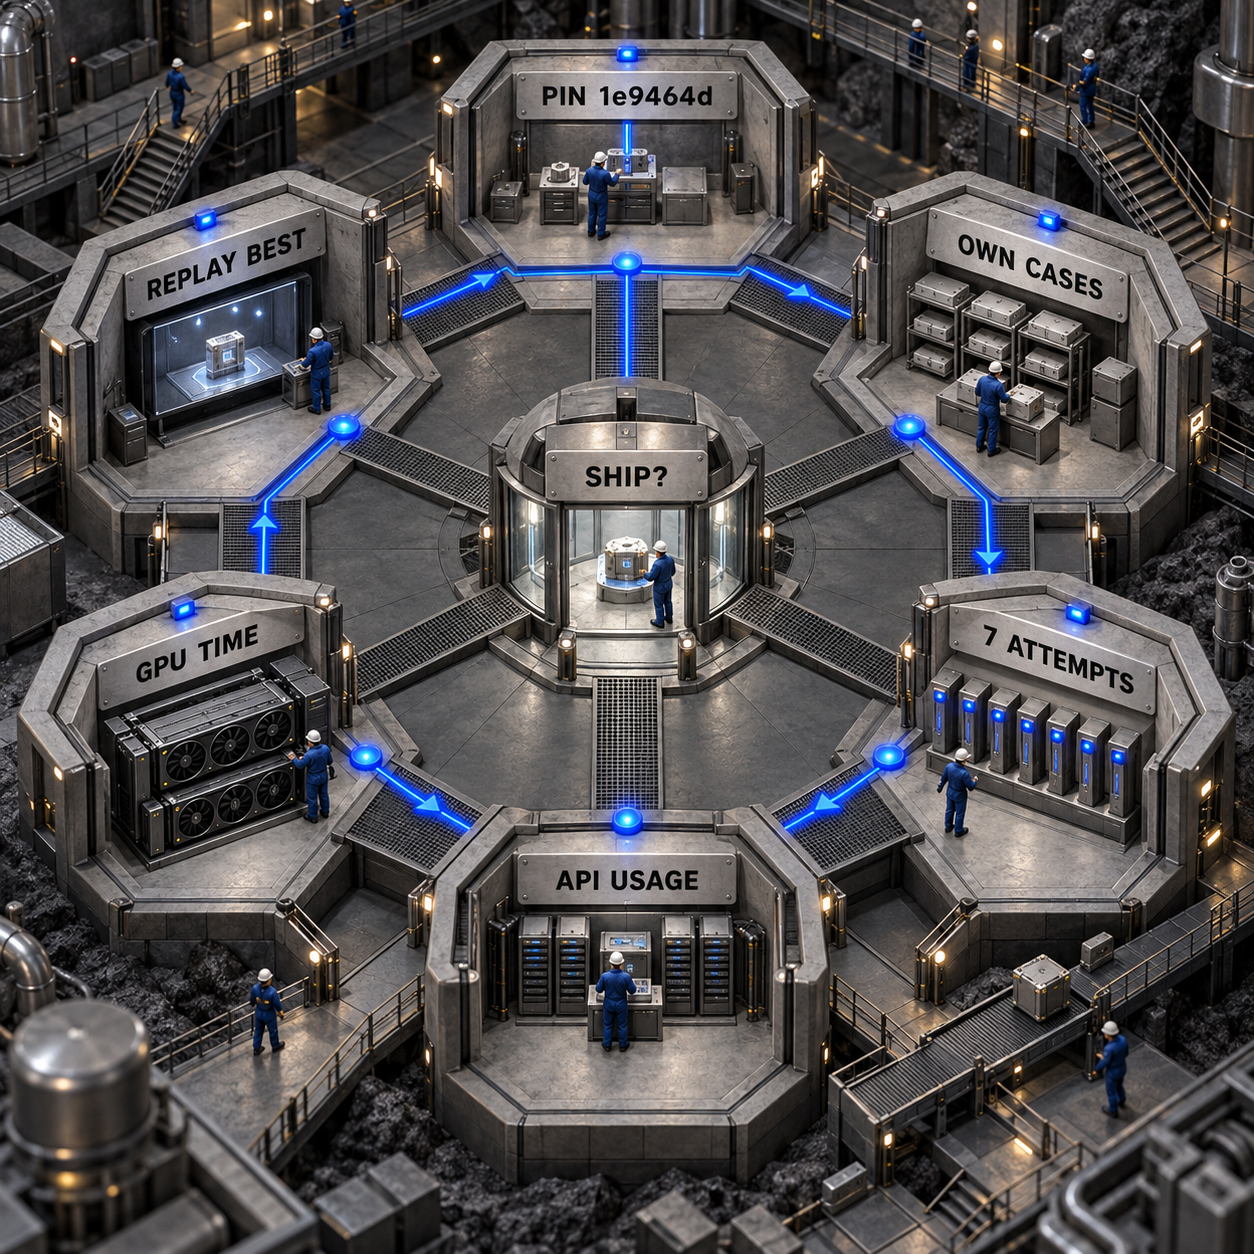
Antes de pressionar Enter, abra um registro do experimento e anote:
- commit fixado e status de alterações locais
- modelo da GPU e versões do driver e do CUDA Toolkit
- hashes da referência e dos casos
- horários de início e término
- tempo total de GPU decorrido
- nome do modelo, chamadas, tokens ou outros metadados de uso disponíveis nos arquivos de resposta salvos
- candidatos válidos, candidatos rejeitados e motivos das rejeições
- latência de cada caso no baseline e no vencedor
Mantenha a GPU ociosa durante a comparação dos tempos. Trabalho de GPU em segundo plano pode transformar uma pequena melhora aparente em mero ruído de medição.
Leia as evidências e repita o teste do vencedor
Trate o diretório de resultados como um pacote de auditoria, não como uma galeria de troféus. Cada sessão fica em results/run-NNN/. Comece por estes arquivos:
history.jsonreúne todas as tentativas avaliadas, os detalhes da execução por caso, os resultados da validação, a configuração de lançamento e a latência medida.summary.jsonidentifica a melhor iteração, a latência por caso, as acelerações disponíveis em relação ao baseline e o motivo do encerramento.best.cué o candidato mais rápido aprovado em todos os casos fornecidos.- Os arquivos
best-case-N.jsonsão solicitações para repetir a execução do código vencedor nos casos fornecidos. model-*.jsone os arquivos de resposta das ferramentas preservam a interação do agente. Inspecione os metadados de uso para contabilizar a API, poissummary.jsonnão soma os gastos com o modelo.heatmap.pngeheatmap.svgmostram o histórico dos tempos. Eles ajudam na navegação, mas não são evidência de correção.
Conte os candidatos rejeitados com o mesmo cuidado dedicado aos válidos. Uma execução com seis propostas rejeitadas e um vencedor de alcance restrito conta uma história diferente daquela em que todos os candidatos continuaram válidos. Analise falhas de compilação, divergências nas saídas e se o código vencedor realmente difere do seu antecessor.
Em seguida, execute novamente cada best-case-N.json salvo pelo executor de testes na mesma GPU ociosa. Depois, teste best.cu com a dimensão oculta e os valores inéditos, usando um oráculo independente. Os casos fornecidos só demonstram que o candidato passou por eles. Não comprovam correção geral, ausência de condições de corrida nem comportamento seguro para toda dimensão válida.
Rejeite o vencedor se algum holdout falhar, se a repetição das medições cruzar o baseline dentro da margem de ruído ou se o ganho desaparecer na aplicação real. Uma referência gerada não serve como único oráculo, e superar o kernel inicial gerado não significa superar a cuBLAS ou outro baseline de produção. O repositório não publica comparação com a cuBLAS.
Decida se a aceleração se paga
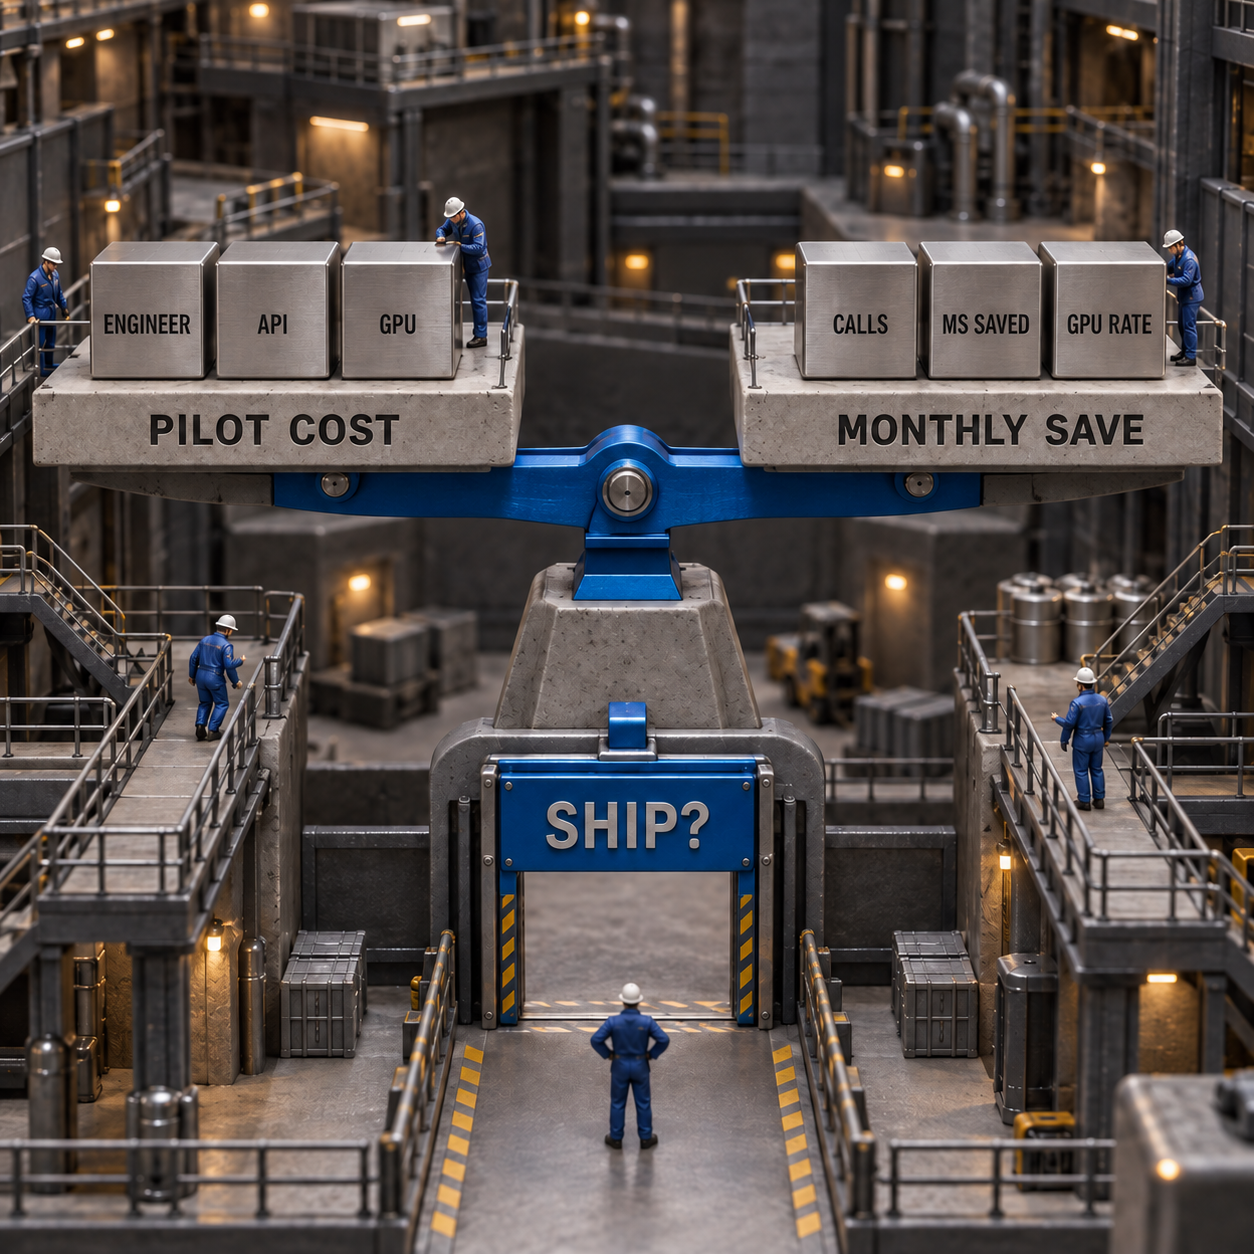
Faça as contas sobre a tarefa completa, não sobre a pontuação do kernel isolado. O repositório público não cobra assinatura, mas também não oferece uma licença comercial. Ainda assim, seu experimento consome tempo de engenharia, uso da API do modelo e tempo de GPU.
Uma planilha útil tem três linhas:
pilot cost = engineer setup and review + model charges + GPU wall-clock costsaved GPU hours per month = end-to-end milliseconds saved per invocation × monthly invocations ÷ 3,600,000payback months = pilot cost ÷ monthly gross GPU saving
Use os milissegundos economizados de ponta a ponta depois da integração, não a latência dos eventos CUDA registrada em summary.json. Se o kernel for executado várias vezes por solicitação, conte as invocações medidas. Se a execução mais rápida alterar throughput, pressão de memória ou batching, meça novamente a carga completa em vez de extrapolar o resultado do kernel.
A alternativa humana também custa caro. A página de consultores CUDA da Upwork apresenta atualmente faixas de planejamento de $500 a $1,200 para análise de desempenho e de $2,500 a $4,500 para ajuste de kernels. São faixas de um marketplace, não orçamentos nem prova de que um agente substitui um especialista. Ainda assim, mostram por que um primeiro experimento repetível pode ser valioso quando reduz o trabalho especializado mais caro a candidatos acompanhados de evidências claras.
A regra de aprovação ou rejeição é direta: avance apenas para um teste de integração controlado quando o candidato passar por casos independentes, superar o baseline repetidamente, melhorar a carga real e apresentar um prazo de retorno definido pela equipe antes da execução.
Sete equipes que podem aproveitar bem a ferramenta
Estes casos de uso estão ordenados por quem tem maior chance de converter um ganho validado no kernel em dinheiro ou capacidade economizados.
Se a carga for uma aplicação completa, uma primitiva madura de fornecedor ou uma coleção de dimensões em constante mudança, comece por outro caminho. Este otimizador é explicitamente experimental e voltado a kernels individuais.
Para uma visão mais ampla dos sistemas vizinhos, o comparativo existente sobre agentes de IA para otimização de GPU aborda AKO, KernelAgent, AutoKernel, Apex e CUDA Agent. O repositório de Bertaye é um projeto separado e mais recente.
Dois produtos que vale a pena criar ao redor dele
1. Auditoria limitada de otimização CUDA
Esta é a oportunidade mais forte. Venda a equipes com um kernel CUDA caro um pacote de evidências de escopo fixo: captura do ambiente, recebimento de casos confiáveis, execução de sete tentativas, repetição independente dos testes, contabilização dos custos do modelo e da GPU e um relatório de aprovação ou rejeição.
A demanda é pequena, mas muito específica. A DataForSEO registra cerca de 30 buscas mensais nos EUA por cuda optimization e 20 por cuda kernel optimization, ambas com baixa concorrência em anúncios pagos. No mesmo mercado, a Upwork apresenta valores de planejamento de $500 a $1,200 para análise e de $2,500 a $4,500 para ajuste. Essa combinação indica um serviço especializado de nicho, não um aplicativo de autoatendimento em massa.
A menor versão que já pode ser vendida inclui um formulário seguro de entrada, um executor descartável com GPU, um manifesto de casos bloqueado, um coletor de custos da execução e um relatório HTML com evidências. Mantenha uma pessoa responsável pela revisão. O obstáculo é a confiança: um único vencedor incorreto pode eliminar o valor de muitas auditorias bem-sucedidas, e a ausência de licença no repositório exige permissão antes de basear um serviço comercial no código.
2. Gate de regressão para kernels de GPU
Crie um serviço controlado de CI que execute novamente kernels aprovados em hardware reservado, confira as saídas salvas e bloqueie uma versão quando houver regressão de latência ou correção. Equipes de plataforma de GPU e consultorias CUDA pagariam por um histórico estável entre mudanças de driver, toolkit e código-fonte.
A DataForSEO registra cerca de 10 buscas mensais nos EUA por gpu performance optimization. É pouco demais para sustentar um negócio baseado apenas em SEO, mas basta para validar a linguagem usada pelos compradores. A distribuição deve acontecer por consultorias, fornecedores de GPU e equipes internas de plataforma.
Um MVP precisa de uma fila de hardware, identificadores do ambiente, casos de referência assinados, medições repetidas, limites e uma comparação compacta com a última execução aceita. O problema é a variância: hosts compartilhados, estado térmico e mudanças de driver podem disparar alarmes falsos, a menos que o executor controle a máquina e repita as medições.
Limitações que devem influenciar sua decisão
A avaliação honesta é que a v0.0 oferece uma estrutura útil para experimentos, mas impõe um grande ônus de confiança.
- Ela otimiza kernels CUDA individuais, não aplicações completas.
- Passar pelos casos fornecidos não comprova correção geral.
- Uma referência gerada não é um oráculo independente.
- Os ganhos de desempenho dependem da carga e do hardware.
- Não há comparação com a cuBLAS nem com outra biblioteca de fornecedor.
- O tempo padrão exclui a compilação e as repetições do profiler, portanto não representa o custo total da execução.
- Scripts de entrada gerados são executados localmente sem sandbox.
- O processo de build documentado é para Windows; outra plataforma exige seu próprio registro de configuração verificado.
- O arquivo de configuração de exemplo citado não existe no commit fixado.
- O repositório não estabelece direitos de licenciamento comercial.
O executor separado compensa quando você precisa de etapas explícitas, evidências persistentes e um orçamento repetível. Um agente de programação genérico pode bastar quando um especialista já supervisiona o terminal, os testes são sólidos e o trabalho realmente será feito uma única vez. O executor só justifica seu lugar quando os limites e a trilha de auditoria reduzem risco ou repetição.
Perguntas frequentes
Como usar o Agentic CUDA Optimizer no Mac?
O repositório fixado documenta um build no Windows, com uma GPU NVIDIA e uma pilha CUDA compatível, não uma configuração para Mac. Use uma máquina NVIDIA remota ou descartável que possa ser verificada e registre essa plataforma separadamente, em vez de adaptar os comandos do Windows por tentativa.
O Agentic CUDA Optimizer é igual ao CUDA Agent da ByteDance?
Não. Este guia aborda o agentic-cuda-optimizer de Bertaye, um fluxo do LangGraph com um executor de testes CUDA em C++, lançado em setembro de 2026. O CUDA Agent da ByteDance e da Tsinghua é outro sistema de pesquisa, com outro repositório.
Qual repositório do CUDA-Agent no GitHub este guia usa?
O guia usa o bertaye/agentic-cuda-optimizer, fixado no commit 1e9464d. Os resultados de busca também exibem o BytedTsinghua-SIA/CUDA-Agent, mas esse não é o software configurado aqui.
O otimizador usa um NVIDIA CUDA Agent?
Nenhum agente separado da NVIDIA faz parte do ciclo documentado. O projeto pode, opcionalmente, recuperar orientações da NVIDIA com --nvidia-research e inspecionar contadores do Nsight Compute com --use-nsight, mas a geração de candidatos e a orquestração continuam dentro do fluxo do próprio repositório.
A próxima ação para segunda-feira é simples: dê a um engenheiro de GPU um kernel float32 de baixo risco, uma máquina NVIDIA descartável e um dia para preparar a referência independente, os casos e a planilha de custos. Execute o piloto de sete tentativas somente depois de documentar esses critérios.
Se você quer incorporar um experimento de GPU mensurável e seu processo de revisão a um sistema de produção, sistemas de IA em produção é o ponto de partida certo.
- Última atualização
- 25 de set. de 2026
- Categoria
- Build
Prefira este site no Google


Marque omidsaffari.com como fonte preferida e o Google destaca o site para você em Top Stories, AI Overviews e AI Mode.

Runpod pricing: guia de custos de Pods e Serverless em 2026
Veja quanto custa a Runpod, compare Pods e Serverless, entenda o ponto de equilíbrio e estime gastos com GPU, armazenamento e requisições na prática.25 de set. de 2026Build
Vercel Sandbox: como usar Drives persistentes
Aprenda a criar e montar um Drive no Vercel Sandbox, preservar o workspace entre execuções e lidar com limites de escrita, snapshots e região.25 de set. de 2026Build
7 ferramentas de web scraping para substituir o Firecrawl
Compare ferramentas de web scraping para pipelines de IA por rastreamento, saída em Markdown e JSON, esforço de migração e custo por página útil.25 de set. de 2026Build
Alternativas ao CodeRabbit: qual escolher para sua equipe?
Compare alternativas ao CodeRabbit por preço, suporte a provedores Git, privacidade e cobrança, de serviços gerenciados a opções self-hosted.25 de set. de 2026Build
Greptile vs CodeRabbit: qual review de código com IA vale mais?
Greptile vs CodeRabbit: compare preços, créditos, limites, plataformas e profundidade da revisão de código com IA antes de escolher para sua equipe.25 de set. de 2026Build
Como usar Perplexity Portable Computer no Windows com AMD
Veja como usar Perplexity Portable Computer em um PC Windows com AMD, validar os requisitos, limitar o acesso a pastas e automatizar tarefas locais.25 de set. de 2026Build
AgentRun na prática: vale a pena para orquestração de agentes de IA?
O AgentRun organiza workflows de agentes de IA com estado tipado, chamadas limitadas e escalonamento explícito. Veja testes, custos e quando adotar.24 de set. de 2026Build