تحسين GPU عمليًا باستخدام Agentic CUDA Optimizer
دليل عملي لتحسين GPU عبر Agentic CUDA Optimizer: ثبّت بيئة الاختبار، نفّذ سبع محاولات، راجع الأدلة، ثم احسب جدوى النواة قبل اعتمادها في الإنتاج.


مرّر نواة صغيرة لضرب المصفوفات من نوع float32 عبر بحث من سبع محاولات، ولا تحتفظ بأي مرشح إلا بعد اجتياز جميع الحالات الموثوقة، ولا تعتمد الفائز المحفوظ قبل أن يغطي عائده تكلفة استدعاءات النموذج ووقت GPU والمراجعة. يشرح هذا الدليل تحسين GPU باستخدام Bertaye's Agentic CUDA Optimizer، وليس نظام CUDA Agent البحثي من ByteDance وTsinghua.
الخلاصة السريعة
استخدم Agentic CUDA Optimizer كمنصة تجارب محكومة، لا كآلة إثبات مستقلة. ثبّت إصدار v0.0 الأولي، وابنِ مشغّل اختبارات C++ ضمن بيئة Windows الموثقة، وقدّم نواة مرجعية وحالات إدخال من إعدادك، وحدّد سقف البحث باستخدام --max-iterations 7، ثم راجع history.json وsummary.json وbest.cu قبل إعادة تشغيل منفصلة.
تستطيع الأداة أتمتة حلقة مفيدة: كتابة مرشح، ثم تجميعه وتشغيله، ورفضه إذا اختلفت المخرجات، وقياس زمنه إذا تطابقت، ثم تمرير الأدلة إلى المحاولة التالية. لكنها لا تستطيع إثبات صحة مرجعك، أو كفاية الحالات لتغطية بيئة الإنتاج، أو أن تسريع نواة معزولة سيخفض فاتورة GPU الإجمالية.
ظهر المستودع عند الالتزام 1e9464da54dfc651337a97c3643bfeefec712bc1 بتاريخ 24 سبتمبر 2026، الساعة 19:41:43 UTC. تثبيت هذا الالتزام مهم لأن الدليل يصف v0.0، لا أي تغييرات لاحقة.
كيف يعمل تحسين GPU داخل الأداة فعليًا
تخيّلها ورشة نماذج لها بوابات فحص. يستطيع النموذج إعادة تصميم القطعة الصغيرة على طاولة العمل، أي نواة CUDA، وضبط طريقة تشغيلها. أما مشغّل الاختبارات فيتحكم في أدوات القياس. ولا يصل أي مرشح إلى واجهة العرض إلا بعد أن ينتج خرجًا مقبولًا في كل حالة مقدمة.
في الداخل، يجمع مشغّل مستقل مكتوب بلغة C++ مصدر CUDA عبر NVRTC، ويشغّله من خلال CUDA Driver API، ثم يحفظ المخرجات. تقارن Python تلك المخرجات بالمرجع وتختار المرشحين. يجب أن تجتاز الحالات الموسومة correctness الاختبار، لكنها لا تدخل في حساب النتيجة. أما الحالات الموسومة performance فتتحقق من الصحة وتساهم كذلك في زمن الاستجابة محسوبًا بالمتوسط الهندسي، وهو معيار الترتيب.
افتراضيًا، تحصل كل حالة موقّتة على 10 عمليات تشغيل للإحماء و100 عملية تشغيل مقاسة باستخدام أحداث CUDA. تصف هذه الأرقام زمن النواة، لا تكلفة المهمة. فالتجميع واستدعاءات النموذج والمحاولات الفاشلة وتوليد المدخلات وعمليات إعادة تشغيل أداة التحليل والمراجعة البشرية كلها خارج هذا الزمن.
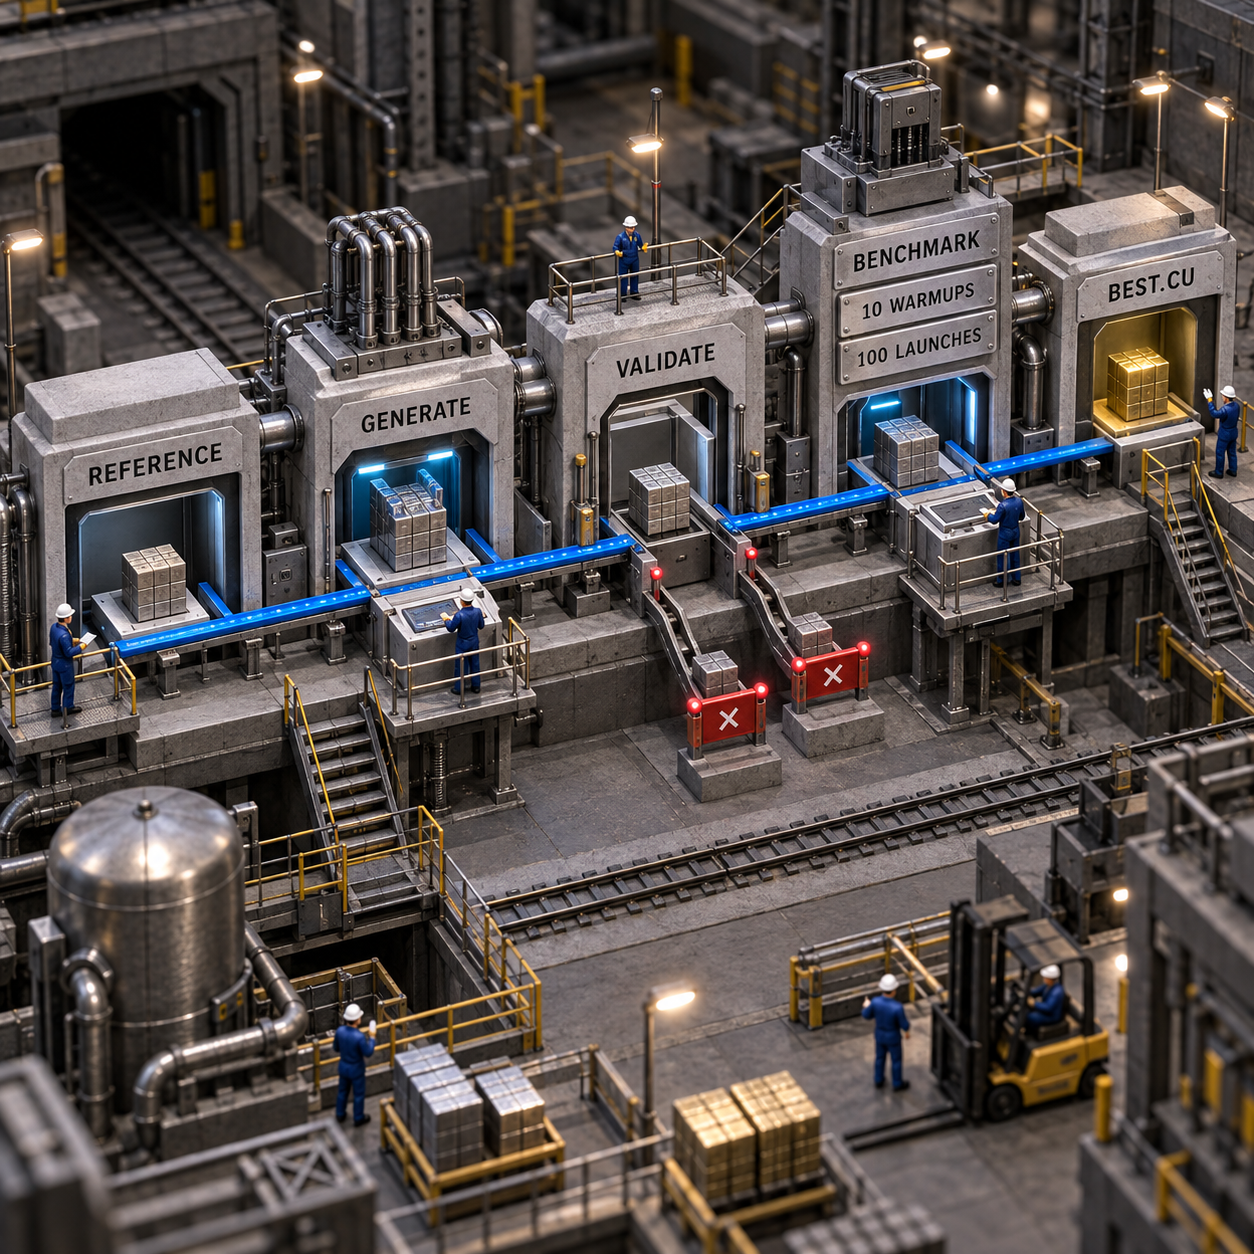
هذا الفصل بين الأدوار هو سبب تفضيل مشغّل الاختبارات على مطالبة وكيل برمجة عام بإنتاج نواة ذكية عبر prompt واحد. الفائدة هي حلقة مسجلة ومحدودة ذات بوابات صريحة، لا إثبات أن LangGraph سيصل إلى إجابة أفضل من وكيل برمجة كفء. وقد شدد صاحب المستودع على الفكرة نفسها في نقاش الإطلاق: القيمة في السياج الذي يضبط الخطوات.
إعداد بنية Windows المثبتة
ابدأ بمسار Windows الموثق. طُوّر المستودع باستخدام RTX 3060 Laptop GPU، وتوثق تعليماته Visual Studio 2026 مع أدوات C++. قبل التجميع، تأكد من توفر Python 3.12 أو أحدث، وCMake 3.24 أو أحدث، ومترجم C++17، وبرنامج تعريف NVIDIA، وإصدار متوافق من CUDA Toolkit.
python --version
cmake --version
where.exe cl
nvidia-smi
nvcc --version

git clone https://github.com/bertaye/agentic-cuda-optimizer.git
cd agentic-cuda-optimizer
git checkout --detach 1e9464da54dfc651337a97c3643bfeefec712bc1

python -m venv .venv
.venv\Scripts\python -m pip install -r optimizer_agent/requirements.txt
cmake -S cuda_test_harness -B cuda_test_harness/build -DCMAKE_BUILD_TYPE=Release
cmake --build cuda_test_harness/build --parallel

Set-Content .env 'OPENAI_API_KEY=your-key-here'
توقف إذا فشل أي فحص للمتطلبات. فإصلاح سلسلة الأدوات بالتزامن مع تعديل الوكيل للنوى يجعل تحديد مصدر الأعطال صعبًا.
هناك تفصيلان في v0.0 يستحقان الانتباه:
- يقترح README الخيار
--config optimizer_agent/example.json، لكن هذا الملف غير موجود في الالتزام المثبت. استخدم خيارات صريحة، أو أنشئ إعدادًا خاصًا بك وراجعه. - لا يحتوي المستودع العام على ملف ترخيص، كما لا يرصد GitHub أي ترخيص. إتاحة الشفرة للعامة لا تعني منح ترخيص تجاري. احصل على إذن أو مراجعة قانونية قبل استخدامها في شركة أو إعادة توزيعها أو دمجها في منتج مدفوع.
لا يوجد مسار إعداد موثق لمنصة أخرى في هذا الإصدار. جرت معاينة بيئة Linux لهذا المقال، لكنها كانت تفتقر إلى أدوات CUDA والبناء المطلوبة؛ لذلك كانت المعاينة تدقيقًا للمتطلبات وليست اختبار Linux ناجحًا.
وأخيرًا، اعزل الجهاز. إذا سمحت للأداة بإنشاء المدخلات، فستُنفذ Python المولدة محليًا من دون sandbox. كذلك تعمل CUDA المولدة مباشرة على GPU. استخدم مضيفًا مؤقتًا أو VM بصلاحيات محدودة، ومن دون بيانات إنتاج أو أسرار لا علاقة لها بالتجربة أو وصول إلى مشاركات ملفات مهمة.
صمّم تجربة واحدة تقبل الفشل بصدق
ابدأ بنواة واحدة يمكنك صياغة عقدها في صفحة. ضرب مصفوفتين بترتيب الصفوف ومن نوع float32 يصلح تجربة أولى؛ فالمدخلات والمخرجات والأبعاد واضحة، بينما تكشف الأحجام الفردية أخطاء التعامل مع الحواف التي قد تخفيها الحالات المربعة السهلة.
جهّز ثلاثة أصول خارج مجلد نتائج الأداة:
reference.cu: تنفيذ بسيط خضع للمراجعة ومن مصدر موثوق. لا تطلب من النموذج نفسه إنشاء المرجع والمرشح.initial.cu: خط الأساس الحقيقي الذي كنت ستنشره لولا التجربة. يمنع ذلك تفسير تفوق كبير على شفرة مولدة ضعيفة باعتباره مكسبًا تجاريًا.input_cases.json: مدخلات ثنائية ثابتة وقابلة لإعادة الإنتاج، مع سماحيات مقارنة ذات معنى لعقدك العددي.
قد تضم تجربة أولى محدودة حالة صحة واحدة بأبعاد فردية مثل M=31 وN=37 وK=29، ثم حالتي أداء متواضعتين مثل 256 في 256 في 256، وM=384 وN=256 وK=320. هذه اقتراحات لتصميم التجربة وليست نتائج أداء من المستودع. احتفظ بحالة رابعة مخفية، بأبعاد وقيم جديدة خارج الأداة، حتى يواجه المرشح النهائي حالة لم يرها أثناء البحث.
استخدم قيمًا غير بسيطة، لا أصفارًا أو آحادًا فقط. راجع حجم كل مخزن مؤقت وترتيب الوسائط ونوع القيمة والسماحية. يجب أن يتضمن ملف التعريف حالة performance واحدة على الأقل. لا بد أن تنجح كل الحالات، لكن حالات الأداء وحدها تؤثر في الترتيب.
احسب بصمة المرجع والمدخلات ومشغّل الاختبارات أو انسخها قبل التشغيل. يجب أن تكون الأداة حرة في تغيير مصدر المرشح وإعدادات التشغيل لكل حالة، لا في تغيير تعريف النجاح.
نفّذ سبع محاولات تحسين بالضبط
يستخدم الأمر التالي مدخلات صريحة ومسار مفسر Windows الموثق. فهو يثبت توقيع نقطة الدخول، ويقدّم المرجع المستقل وخط الأساس الحقيقي، ويضع سقف التحسين عند سبع محاولات.
.venv\Scripts\python optimizer_agent\optimizer_agent.py `
  --description "Row-major float32 matrix multiplication C=MxN from A=MxK and B=KxN." `
  --signature 'extern "C" __global__ void matmul_f32(const float* a, const float* b, float* c, int m, int n, int k)' `
  --reference .\experiment\reference.cu `
  --initial-kernel .\experiment\initial.cu `
  --input-cases .\experiment\input_cases.json `
  --max-iterations 7
النموذج الافتراضي هو gpt-5-mini بجهد استدلال متوسط، وتُحتسب تكلفة استخدام API على حسابك. ولا تعني سبع محاولات تحسين وجود سبعة استدعاءات للنموذج أو سبع عمليات تشغيل للنواة. قد يستخدم المقترح استدعاءات أدوات ومحاولات تصحيح، في حين تتضمن كل حالة موقّتة وحدها افتراضيًا 10 عمليات إحماء و100 عملية تشغيل مقاسة.
اترك --use-nsight و--nvidia-research معطلين عند إنشاء خط الأساس النظيف الأول. يضيف تحليل Nsight عمليات إعادة تشغيل، كما يتطلب Nsight Compute وإذنًا لقراءة عدادات أداء GPU. ويضيف بحث NVIDIA عملًا خاصًا بالنموذج والاسترجاع. بعد استقرار الحلقة الأساسية، أضف متغيرًا واحدًا في كل مرة.
قبل الضغط على Enter، افتح سجلًا للتجربة ودوّن:
- الالتزام المثبت وحالة شجرة العمل وما إذا كانت تحتوي على تعديلات
- طراز GPU وإصداري برنامج التعريف وCUDA Toolkit
- بصمات المرجع والحالات
- وقتي البدء والانتهاء
- إجمالي الوقت الفعلي لاستخدام GPU
- اسم النموذج والاستدعاءات والرموز أو غيرها من بيانات الاستخدام المتاحة في ملفات الاستجابة المحفوظة
- المرشحين الصالحين والمرفوضين وأسباب الرفض
- زمن الاستجابة لكل حالة في خط الأساس والفائز
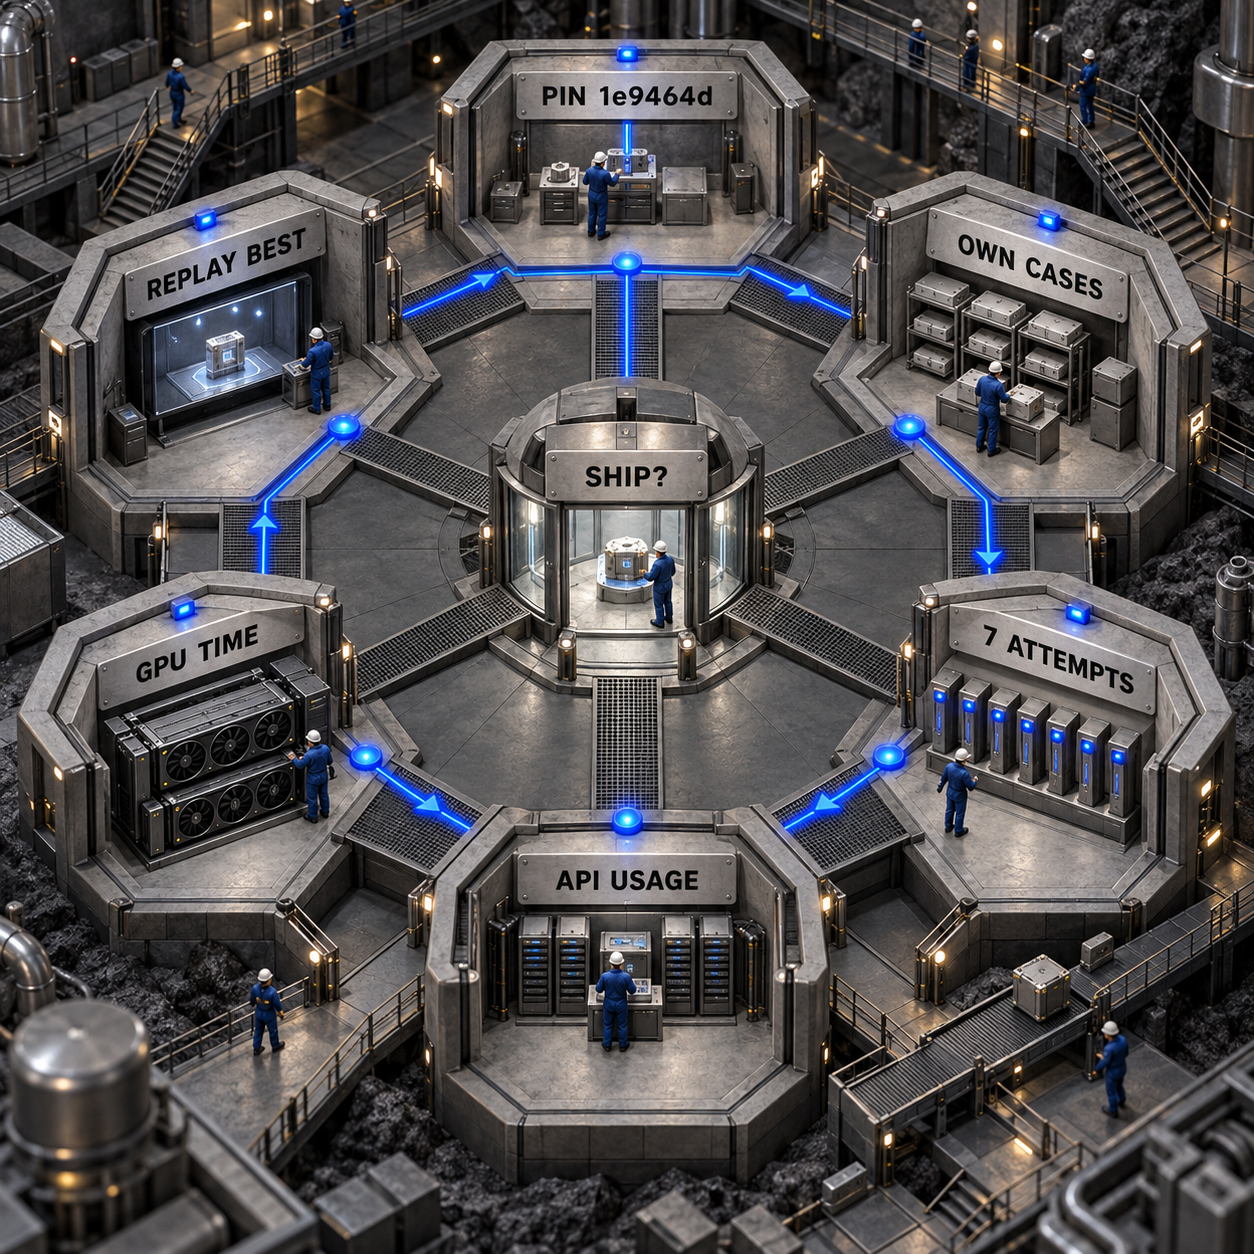
أبقِ GPU خاملًا من أي مهام أخرى أثناء مقارنة الأزمنة. فقد يحوّل حمل GPU في الخلفية تحسنًا طفيفًا ظاهريًا إلى ضوضاء قياس.
اقرأ الأدلة ثم أعد تشغيل الفائز
تعامل مع مجلد النتائج كحزمة تدقيق، لا كخزانة جوائز. تحفظ كل جلسة في results/run-NNN/. ابدأ بهذه الملفات:
- يضم
history.jsonكل محاولة مقيمة، وتفاصيل التنفيذ على مستوى الحالات، ونتائج التحقق، وإعدادات التشغيل، وزمن الاستجابة المقاس. - يحدد
summary.jsonأفضل تكرار، وزمن كل حالة، وأرقام التسارع المتاحة مقابل خط الأساس، وسبب التوقف. - يحتوي
best.cuعلى أسرع مرشح اجتاز جميع الحالات المقدمة. - تمثل ملفات
best-case-N.jsonطلبات إعادة تشغيل للمصدر الفائز على الحالات المقدمة. - تحفظ ملفات
model-*.jsonواستجابات الأدوات تفاعل الوكيل. افحص بيانات الاستخدام فيها لحساب تكلفة API، لأنsummary.jsonلا يجمع إنفاق النموذج. - تعرض
heatmap.pngوheatmap.svgسجل الأزمنة. تفيدان في التنقل بين النتائج، لكنهما ليستا دليلًا على الصحة.
احسب المرشحين المرفوضين بالحرص نفسه الذي تحسب به المقبولين. فتجربة رُفضت فيها ستة مقترحات ونجح فائز محدود تخبرك بشيء مختلف عن تجربة بقي فيها كل مرشح صالحًا. راجع أعطال التجميع، وحالات عدم تطابق المخرجات، وما إذا كان مصدر الفائز يختلف فعلًا عن مصدره الأب.
بعد ذلك، أعد تشغيل كل ملف best-case-N.json محفوظ عبر مشغّل الاختبارات وعلى GPU الخامل نفسه. ثم اختبر best.cu على الأبعاد المخفية والقيم الجديدة باستخدام مرجع مستقل. لا تثبت الحالات المقدمة سوى أن المرشح اجتازها؛ فهي لا تثبت الصحة العامة، أو الخلو من حالات السباق، أو السلوك الآمن عبر كل بُعد صالح.
ارفض الفائز إذا أخفقت أي حالة مخفية، أو إذا تداخلت قياسات الزمن المتكررة مع خط الأساس ضمن هامش الضوضاء، أو إذا اختفى المكسب داخل التطبيق الحقيقي. المرجع المولد غير مقبول بوصفه المرجع الوحيد، كما أن التفوق على نواة البداية المولدة لا يساوي التفوق على cuBLAS أو خط أساس إنتاجي آخر. ولا ينشر المستودع أي مقارنة مع cuBLAS.
هل يغطي التسارع تكلفته؟
احسب اقتصاديات المهمة كاملة، لا نتيجة النواة المعزولة. لا يعلن المستودع العام سعر اشتراك، لكنه أيضًا لا يمنح ترخيصًا تجاريًا. ومع ذلك، تستهلك تجربتك وقت المهندس واستخدام API الخاص بالنموذج ووقت GPU.
تتكون ورقة العمل المفيدة من ثلاثة أسطر:
pilot cost = engineer setup and review + model charges + GPU wall-clock costsaved GPU hours per month = end-to-end milliseconds saved per invocation × monthly invocations ÷ 3,600,000payback months = pilot cost ÷ monthly gross GPU saving
استخدم عدد الملّي ثواني الذي جرى توفيره من البداية إلى النهاية بعد الدمج، لا زمن أحداث CUDA من summary.json. إذا كانت النواة تعمل عدة مرات لكل طلب، فاحسب عدد الاستدعاءات المقاس. وإذا غيّر التسريع الإنتاجية أو ضغط الذاكرة أو التجميع، فأعد قياس حمل العمل الكامل بدل تعميم نتيجة النواة بالافتراض.
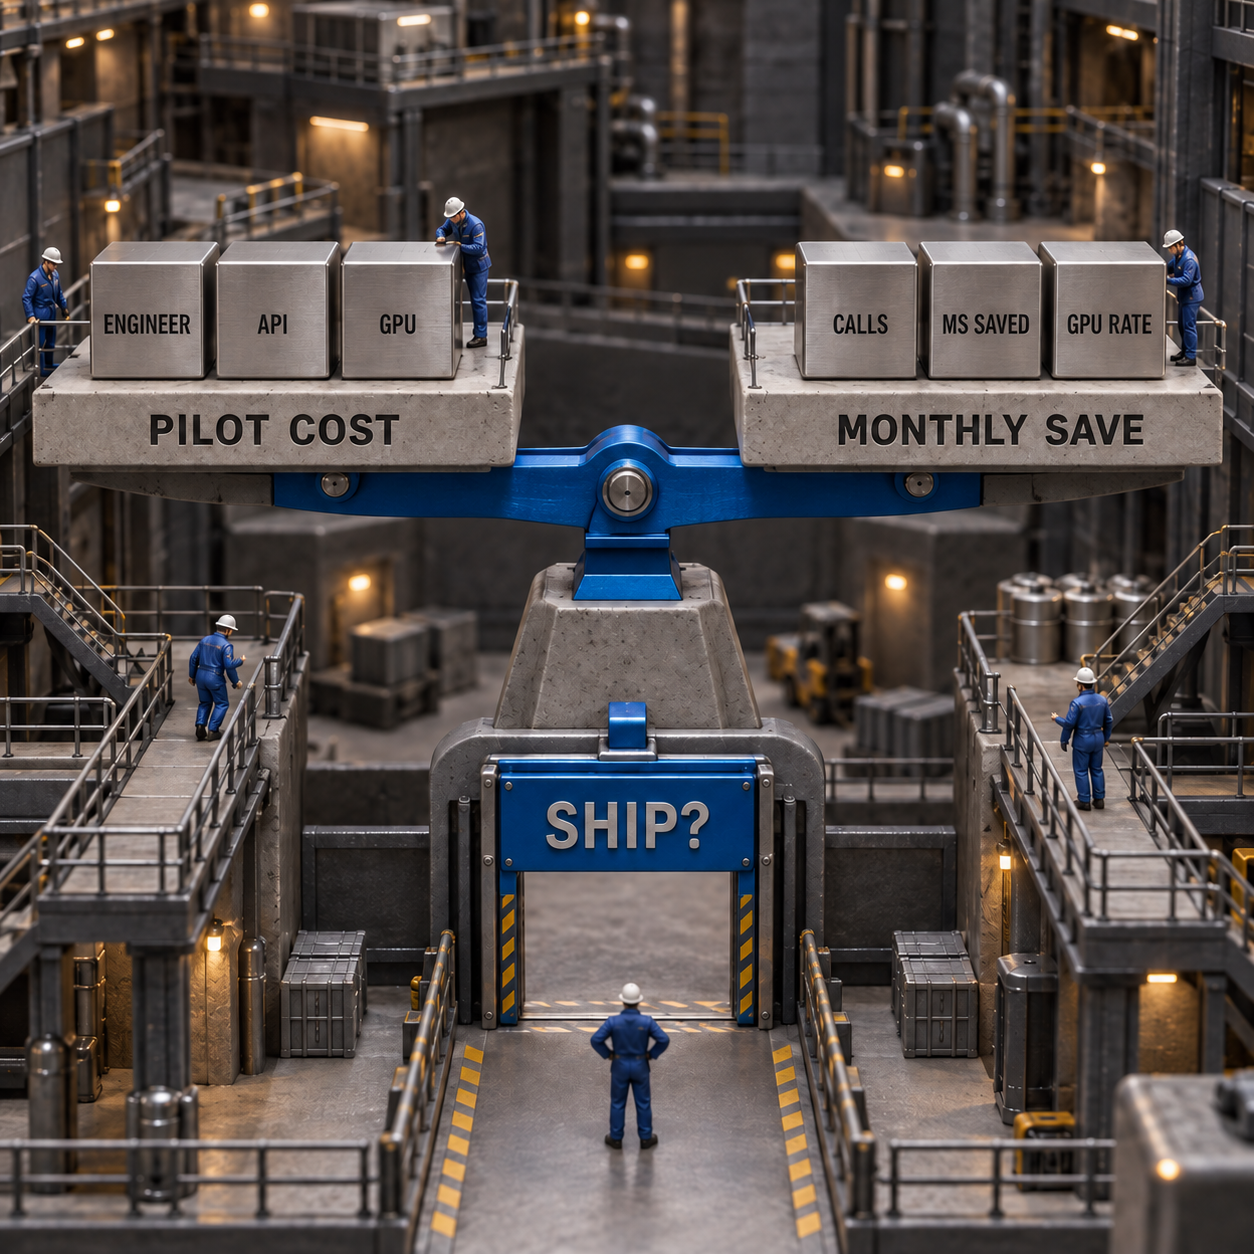
الخيار البشري ليس رخيصًا. تعرض صفحة مستشاري CUDA على Upwork حاليًا نطاقات تخطيط قدرها $500 إلى $1,200 لتحليل الأداء، و$2,500 إلى $4,500 لضبط النواة. هذه نطاقات في سوق خدمات، وليست عروض أسعار أو دليلًا على أن الوكيل يحل محل المختص. لكنها توضح قيمة تجربة أولية قابلة للتكرار عندما تحصر العمل المتخصص المكلف في مرشحين تدعمهم أدلة واضحة.
قاعدة القرار مباشرة: لا تنقل المرشح إلى اختبار دمج محكوم إلا إذا اجتاز حالات مستقلة، وتفوق على خط الأساس بصورة متكررة، وحسّن حمل العمل الحقيقي، وحقق فترة الاسترداد التي حددها فريقك قبل التشغيل.
سبعة فرق تستطيع الاستفادة منه
رُتبت حالات الاستخدام التالية وفق قدرة الفريق على تحويل مكسب موثّق في النواة إلى مال أو سعة موفرة.
إذا كان حمل العمل تطبيقًا كاملًا، أو دالة أولية ناضجة من مزود، أو مجموعة متغيرة من الأبعاد، فابدأ من مكان آخر. هذه الأداة تجريبية بوضوح ومخصصة للنوى المنفردة.
لإلقاء نظرة أوسع على الأنظمة المجاورة، تغطي مقارنة وكلاء AI لتحسين GPU كلًا من AKO وKernelAgent وAutoKernel وApex وCUDA Agent. أما مستودع Bertaye فهو مشروع أحدث ومنفصل.
منتجان يستحقان البناء حوله
1. تدقيق محدود لتحسين CUDA
هذه أقوى فرصة. بع حزمة أدلة ثابتة النطاق إلى الفرق التي لديها نواة CUDA واحدة مرتفعة التكلفة: توثيق البيئة، واستلام الحالات الموثوقة، وتشغيل من سبع محاولات، وإعادة تشغيل مستقلة، وحساب تكلفة النموذج وGPU، وتقرير يوصي بالاعتماد أو الرفض.
الطلب محدود لكنه شديد التحديد. تفيد DataForSEO بوجود نحو 30 عملية بحث شهريًا في الولايات المتحدة عن cuda optimization و20 عن cuda kernel optimization، وكلتاهما بمنافسة منخفضة في البحث المدفوع. وفي السوق نفسها، تتراوح أسعار التخطيط على Upwork بين $500 و$1,200 للتحليل، وبين $2,500 و$4,500 للضبط. يشير هذا المزيج إلى خدمة خبراء ضيقة، لا إلى تطبيق جماهيري ذاتي الخدمة.
أصغر نسخة قابلة للبيع هي نموذج استقبال آمن، ومشغّل GPU مؤقت، وملف حالات مقفل، وأداة تجمع تكلفة التشغيل، وتقرير أدلة بصيغة HTML. أبقِ مراجعًا بشريًا ضمن الحلقة. أما المأخذ فهو الثقة: فائز واحد غير صحيح قد يمحو قيمة تجارب ناجحة كثيرة، كما أن غياب الترخيص عن المستودع يعني ضرورة الحصول على إذن قبل تأسيس خدمة تجارية على شفرته.
2. بوابة انحدار لنوى GPU
ابنِ خدمة CI محكومة تعيد تشغيل النوى المعتمدة على عتاد محجوز، وتتحقق من المخرجات المحفوظة، وتمنع الإصدار عند تراجع زمن الاستجابة أو الصحة. ستدفع فرق منصات GPU وشركات استشارات CUDA لقاء سجل مستقر عبر تغييرات برنامج التعريف ومجموعة الأدوات والمصدر.
تفيد DataForSEO بوجود نحو 10 عمليات بحث شهريًا في الولايات المتحدة عن gpu performance optimization. وهذا أقل من أن يدعم مشروعًا يعتمد على SEO وحده، لكنه يكفي للتحقق من المفردات التي يستخدمها المشترون. وينبغي أن يأتي التوزيع عبر شركات الاستشارات ومزودي GPU وفرق المنصات الداخلية.
يحتاج MVP إلى طابور عتاد، وبصمات للبيئة، وحالات مرجعية موقعة، وقياسات متكررة، وحدود، وفارق موجز مقارنة بآخر تشغيل مقبول. أما المأخذ فهو التباين: قد تتسبب المضيفات المشتركة والحالة الحرارية وتغييرات برنامج التعريف في إنذارات كاذبة، ما لم يتحكم المشغّل في الجهاز ويكرر القياسات.
قيود ينبغي أن تغيّر قرارك
التقييم الصريح هو أن v0.0 إطار مفيد للتجارب، لكنه يضع على عاتقك عبئًا كبيرًا لبناء الثقة.
- يحسن نوى CUDA منفردة، لا تطبيقات كاملة.
- اجتياز الحالات المقدمة لا يثبت الصحة العامة.
- المرجع المولد ليس مرجعًا مستقلًا.
- تعتمد مكاسب الأداء على حمل العمل والعتاد.
- لا توجد مقارنة مع cuBLAS أو مكتبات مزودين أخرى.
- يستبعد التوقيت الافتراضي التجميع وإعادة تشغيل أداة التحليل، لذا لا يمثل تكلفة التشغيل الإجمالية.
- تعمل سكربتات الإدخال المولدة محليًا من دون sandbox.
- مسار البناء الموثق مخصص لـ Windows؛ وتحتاج أي منصة أخرى إلى سجل إعداد خاص جرى التحقق منه.
- إعداد المثال المذكور غير موجود في الالتزام المثبت.
- لا يثبت المستودع وجود حقوق ترخيص تجاري.
يكون المشغّل المنفصل جديرًا بالاستخدام عندما تحتاج إلى مراحل صريحة وأدلة دائمة وميزانية قابلة للتكرار. وقد يكفي وكيل برمجة عام عندما يشرف خبير بالفعل على الطرفية، وتكون الاختبارات قوية، ويكون العمل لمرة واحدة فعلًا. ولا يبرر المشغّل وجوده إلا عندما يقلل السياج ومسار التدقيق المخاطر أو التكرار.
الأسئلة الشائعة
كيف تستخدم Agentic CUDA Optimizer على Mac؟
يوثق المستودع المثبت بناءً على Windows مع NVIDIA GPU وحزمة CUDA متوافقة، ولا يوثق إعدادًا على Mac. استخدم جهاز NVIDIA بعيدًا أو مؤقتًا يمكنك التحقق منه، وسجّل تلك المنصة بصورة مستقلة بدل تخمين ما يقابل أوامر Windows.
هل Agentic CUDA Optimizer هو نفسه ByteDance CUDA Agent؟
لا. يغطي هذا الدليل agentic-cuda-optimizer من Bertaye، وهو سير عمل قائم على LangGraph مع مشغّل اختبارات CUDA مكتوب بلغة C++ وصدر في سبتمبر 2026. أما CUDA Agent من ByteDance وTsinghua فهو نظام بحثي ومستودع منفصلان.
أي مستودع CUDA-Agent على GitHub يستخدمه هذا الدليل؟
يستخدم الدليل bertaye/agentic-cuda-optimizer مثبتًا على الالتزام 1e9464d. وتُظهر نتائج البحث أيضًا BytedTsinghua-SIA/CUDA-Agent، وهي ليست البرمجية التي يجري إعدادها هنا.
هل تستخدم الأداة NVIDIA CUDA Agent؟
لا يوجد وكيل NVIDIA منفصل ضمن الحلقة الموثقة. يمكن للمشروع اختياريًا جلب إرشادات NVIDIA باستخدام --nvidia-research وفحص عدادات Nsight Compute عبر --use-nsight، لكن توليد المرشحين والتنسيق يظلان جزءًا من سير عمل هذا المستودع نفسه.
خطوة يوم الاثنين بسيطة: عيّن مهندس GPU واحدًا لنواة float32 منخفضة المخاطر، وجهاز NVIDIA مؤقتًا واحدًا، ويومًا واحدًا لإعداد المرجع المستقل والحالات وورقة التكلفة. لا تنفذ التجربة ذات السبع محاولات قبل تدوين هذه البوابات.
إذا أردت بناء تجربة GPU مقاسة ومسار مراجعتها داخل نظام إنتاجي، فإن أنظمة AI للإنتاج هي نقطة البداية المناسبة.
- آخر تحديث
- 25 سبتمبر 2026
- التصنيف
- Build
فضّل هذا الموقع في Google


اجعل omidsaffari.com مصدرًا مفضّلًا، وسيرفعه Google لك في Top Stories وAI Overviews وAI Mode.

Runpod pricing: احسب تكلفة Pods وServerless بالوقت المدفوع
دليل عملي لفهم أسعار Runpod ومقارنة Secure Cloud Pods مع Serverless Flex، مع نقطة التعادل وتكاليف التخزين ونماذج حساب واضحة قبل اعتماد ميزانية H100.25 سبتمبر 2026Build
دليل Vercel Sandbox Drives لمساحات عمل الوكلاء الدائمة
دليل عملي لاستخدام Vercel Sandbox Drives لحفظ ملفات وكلاء البرمجة بين الجلسات، مع اختبار الكاتب الواحد ولقطات القراءة وحساب تكاليف التخزين والحوسبة.25 سبتمبر 2026Build
بدائل Firecrawl: مقارنة 7 أدوات للزحف واستخراج البيانات
مقارنة عملية لأفضل بدائل Firecrawl من حيث الزحف، واستخراج Markdown وJSON، والتكلفة لكل صفحة مقبولة، مع ورقة ترحيل تساعد الفرق الصغيرة على الاختيار.25 سبتمبر 2026Build
أفضل أدوات AI code review: بدائل CodeRabbit العملية
قارن أفضل بدائل CodeRabbit لمراجعة الكود بالذكاء الاصطناعي حسب السعر، ودعم منصات Git، وحدود البيانات، والاستضافة الذاتية قبل نقل سير عمل فريقك.25 سبتمبر 2026Build
AI code review: متى تختار Greptile ومتى تختار CodeRabbit؟
مقارنة عملية بين Greptile وCodeRabbit في الأسعار وحدود المراجعة ودعم Git وتكلفة الفرق، مع نموذج قرار يوضح متى يناسبك كل منتج قبل الاشتراك فعليًا.25 سبتمبر 2026Build
كيفية استخدام Perplexity Portable Computer محلياً على Windows وAMD
دليل عملي لتشغيل Perplexity Portable Computer محلياً على أجهزة AMD بنظام Windows، من فحص المتطلبات وضبط الصلاحيات إلى اختبار الملفات وجدولة المهام بأمان.25 سبتمبر 2026Build
مراجعة AgentRun: هل تستحق مكانًا في سير عمل الوكلاء؟
اختبار عملي لـ AgentRun beta.4 يوضح ضبط فروع سير العمل، وحدود استدعاءات الوكلاء، والتصعيد، والتكلفة، ومتى تكون دالة TypeScript أبسط خيار لفريقك.24 سبتمبر 2026Build