AI 에이전트용 GPT-6.1 Sol 설정과 Codex 사용법
AI 에이전트에 GPT-6.1 Sol을 적용하는 실전 가이드입니다. Responses API와 Codex 설정, reasoning effort 선택, 실제 작업의 토큰 비용, GPT-6 Sol 또는 Astra로 전환할 기준까지 한 번에 명확히 확인하세요.



가벼운 모델에 맡기기에는 까다롭지만 Astra로 무조건 보내기에는 너무 자주 발생하는 진지하고 반복적인 AI 에이전트 업무라면 GPT-6.1 Sol을 투입해 보십시오. 실전 설정은 간단합니다. Responses API에서 gpt-6.1-sol을 사용하고, medium으로 시작하며, 작업에 꼭 필요한 툴만 열어 둔 뒤 정해진 승인 기준을 통과했을 때만 운영 환경으로 승격합니다. 이 가이드를 위해 새 Codex 실행에서 작은 JavaScript 유틸리티를 만들고 테스트 4개를 작성했으며, 모두 통과했습니다. 토큰만 계산한 API 환산 비용은 $0.02816이었습니다.
1분 만에 내리는 선택
GPT-6.1 Sol은 API 에이전트, Codex, 유료 ChatGPT Work 플랜에서 사용할 수 있습니다. 일반 Chat에는 아직 제공되지 않으며, 이 모델의 Ultrafast는 발표됐지만 아직 출시되지 않았습니다.
Standard API 가격은 입력 토큰 100만 개당 $2, 출력 토큰 100만 개당 $10입니다. GPT-6 Astra는 각각 $10와 $50입니다. OpenAI의 출시 발표에서 제품 제공 범위를 확인할 수 있습니다. 접근 권한과 사용량 제한을 더 자세히 비교하려면 GPT-6.1 Sol과 GPT-6 Sol 비교를 참고하십시오. 이 글은 설정과 운영 선택에 집중합니다.
GPT-6.1 Sol은 어떤 모델인가
GPT-6 제품군을 하나의 운영팀으로 생각하면 이해하기 쉽습니다. Astra는 가장 어렵고 판단이 엇갈리는 사안에 투입하는 전문가입니다. GPT-6.1 Sol은 반복되는 복잡한 업무를 꾸준히 맡길 수 있는 숙련된 실무자입니다. GPT-6 Sol은 기존 툴 경로와의 호환성을 유지해야 할 때 남겨 두는 선택지입니다. 새 모델을 모든 곳의 기본값으로 보는 것보다 이 구분이 실용적입니다.
GPT-6.1 Sol은 텍스트와 이미지를 입력받아 텍스트를 출력하며, 컨텍스트 윈도는 1,050,000토큰, 최대 출력은 128,000토큰입니다. 에이전트에서 진짜 가치는 툴 활용 범위에 있습니다. Responses에서는 웹 검색, 파일 검색, 이미지 생성, 코드 인터프리터, 호스팅 셸, 패치 적용, 스킬, 컴퓨터 사용, MCP, 툴 검색, 사용자 정의 함수를 지원합니다. Responses 툴 가이드는 허용된 툴 가운데 무엇을 다음에 호출할지 모델이 판단하는 동안 API가 에이전트 루프를 유지하는 방식을 설명합니다.
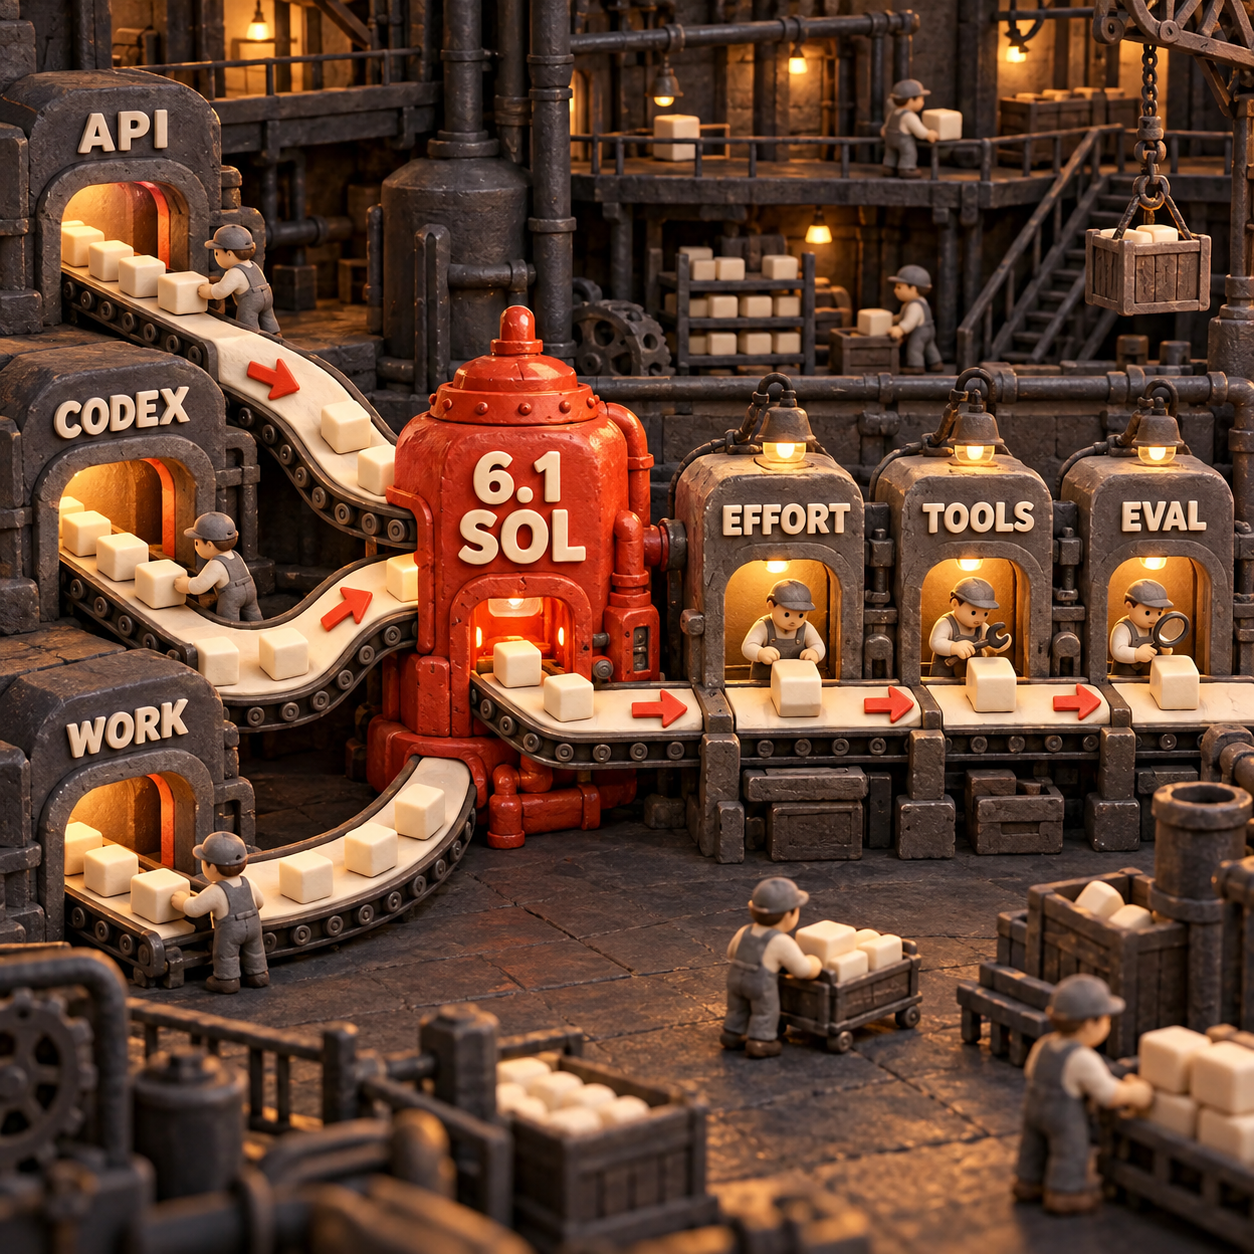
제약도 그만큼 중요합니다. GPT-6.1 Sol은 Responses를 통해서만 툴을 사용할 수 있습니다. Chat Completions는 일반 요청은 계속 받지만 툴 호출 요청은 처리하지 못합니다. 현재 에이전트가 Chat Completions에서 함수를 호출한다면 모델 ID만 바꾸는 것으로는 마이그레이션이 되지 않습니다.
AI 에이전트 만들기: Responses API 설정
하나의 경로와 하나의 승인 기준부터 시작하십시오. 모델 페이지에 나열됐다는 이유로 모든 툴을 열어 둘 필요는 없습니다. 리서치 워커에는 웹 검색과 파일 검색이 필요할 수 있습니다. 저장소 작업에는 셸과 패치 권한이 필요할 수 있습니다. 운영 에이전트에는 함수 2개와 승인 경계만 있으면 될 수 있습니다.
실제로 쓸 수 있는 가장 작은 JavaScript 요청은 다음과 같습니다.
import OpenAI from "openai";

const client = new OpenAI();

const response = await client.responses.create({
  model: "gpt-6.1-sol",
  reasoning: { effort: "medium" },
  tools: [{ type: "web_search" }],
  input: "Find today's source for our target metric, cite it, and return one sentence."
});

console.log(response.output_text);
모델 ID는 Sol을 선택합니다. reasoning 객체는 추론에 얼마나 많은 작업량을 쓸지 정합니다. tools 배열은 기능을 허용할 뿐, 반드시 사용하라고 지시하지는 않습니다. 프롬프트에는 여전히 원하는 결과, 증거 요건, 중단 조건이 필요합니다.
기존 Chat Completions 에이전트를 옮길 때는 세 가지를 바꿔야 합니다. 요청을 Responses로 보내고, 타입이 지정된 output 항목을 파싱하며, 대화 상태를 어떻게 이어 갈지 결정해야 합니다. Astra Responses 마이그레이션 가이드에서 이 연결 작업을 더 자세히 다룹니다.
실제 작업 5개를 고정합니다
실패 사례 1개를 포함해 워크플로에서 이미 승인된 예시를 고릅니다. 프롬프트, 입력, 권한, 성공 기준을 그대로 보존합니다.
medium으로 시작합니다
먼저 기본 effort를 사용합니다. 한 번에 변수 하나만 바꿔야 모델의 개선 효과가 프롬프트나 툴 변경과 섞이지 않습니다.
필요한 툴만 허용합니다
해당 경로에 필요한 검색, 파일, 함수, 셸, 컴퓨터 제어만 노출합니다. 쓰기 작업에는 명시적인 정책과 승인 경계를 둡니다.
승인된 결과의 비용을 기록합니다
신규 입력, 캐시된 입력, 출력, 재시도, 툴 요금과 최종 상태의 통과 여부를 기록합니다. 저렴하게 실패한 실행은 절감이 아닙니다.
근거에 따라 라우팅합니다
통과하는 작업은 Sol에 둡니다. 어려운 잔여 작업만 Astra로 올립니다. 호출부가 바뀔 때까지 호환되지 않는 경로는 GPT-6 Sol에 유지합니다.
작업에 맞는 reasoning effort 선택법
대부분의 에이전트 업무는 medium에서 시작하는 것이 적절합니다. GPT-6.1 Sol은 low, high, xhigh, max도 지원합니다. none과 minimal은 거부하므로 둘 중 하나를 쓰는 기존 경로라면 동작과 지연 시간을 별도로 테스트해야 합니다. OpenAI의 reasoning effort 가이드도 효율적인 실행에서 최대 추론으로 높여 가는 같은 방식을 제시합니다.
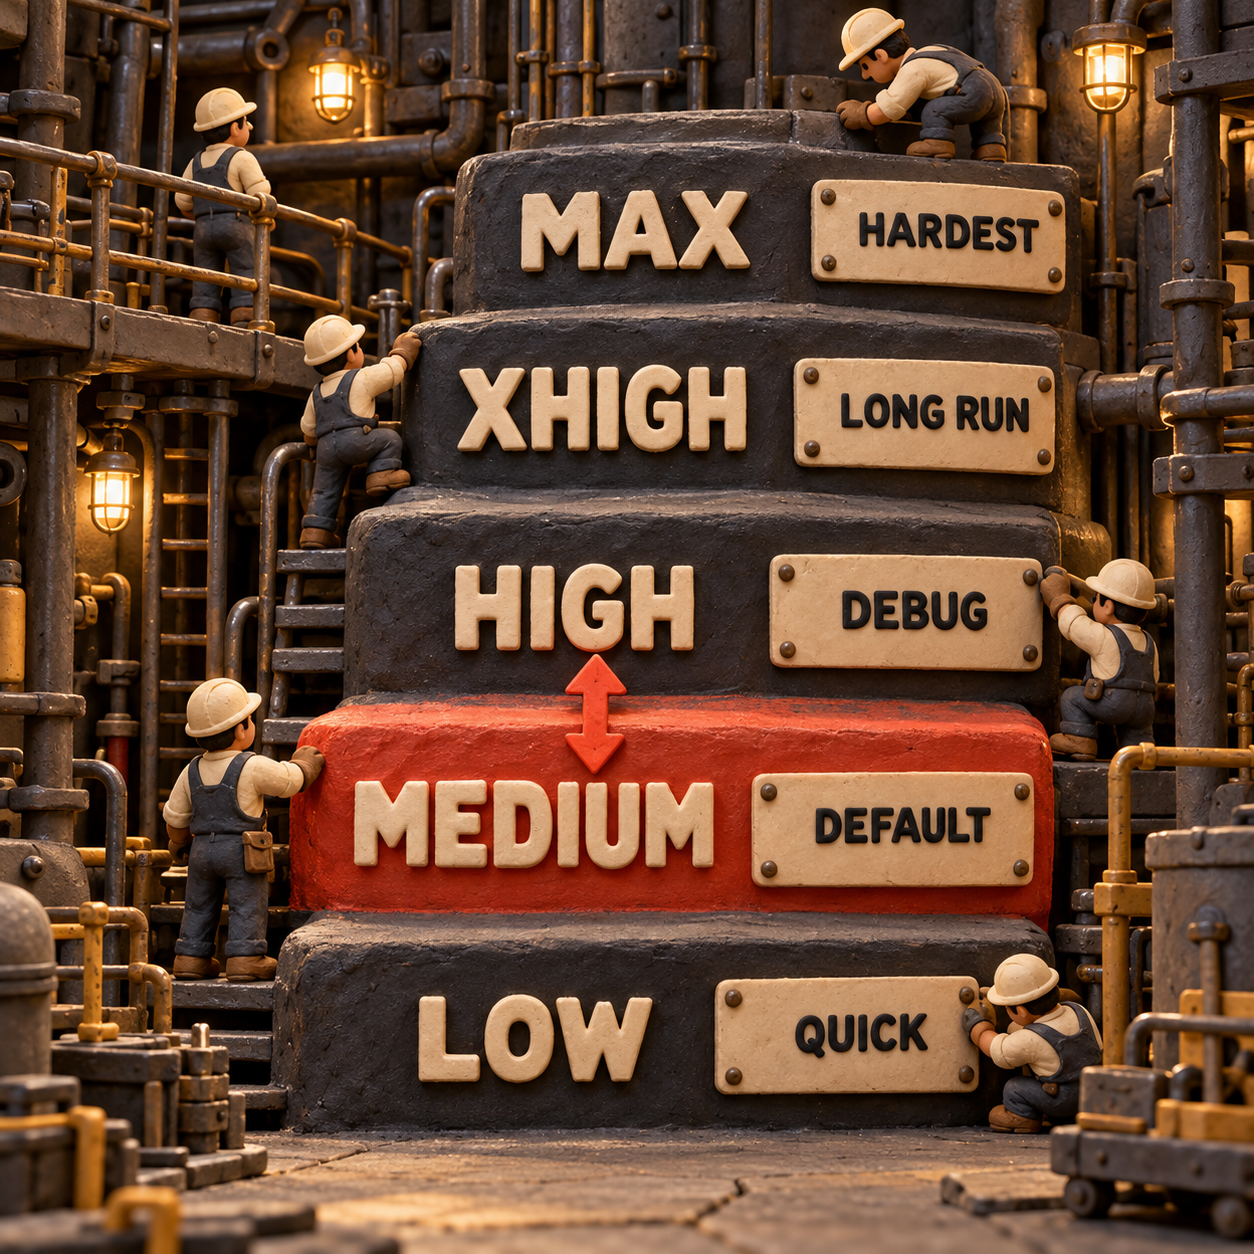
이름이 비슷한 세 용어는 서로 다른 제어 기능입니다. max는 API의 reasoning effort입니다. Codex의 Ultra는 작업을 여러 서브에이전트에 나누는 멀티 에이전트 모드입니다. Ultrafast는 속도 모드이며 GPT-6.1 Sol 지원은 아직 준비 중입니다. 현재 사용할 수 있는 것처럼 Ultrafast 예산이나 출시 계획을 세워서는 안 됩니다.
실제 GPT-6.1 Sol 작업과 토큰 비용
작은 실행 하나가 표면적인 가격표보다 유용한 비용 구조를 보여 줍니다. low effort의 GPT-6.1 Sol에 Codex에서 다음 작업을 맡겼습니다. 의존성 없는 JavaScript slugify 함수를 만들고, 앞뒤 공백 제거, 공백 문자, 문장부호, 대소문자 혼합을 검증하는 node:test 케이스를 정확히 4개 추가한 뒤, 테스트를 실행하고 실패하면 수정하는 작업입니다.
모델은 slugify.js와 slugify.test.js를 만든 다음 node --test slugify.test.js를 실행했습니다. 결과는 4개 통과, 0개 실패였습니다. 기록된 사용량은 입력 토큰 57,578개였고, 이 가운데 48,640개는 캐시된 토큰이었으며, 출력 토큰은 542개였습니다. 따라서 신규 입력 요율로 청구되는 토큰은 8,938개뿐이었습니다.
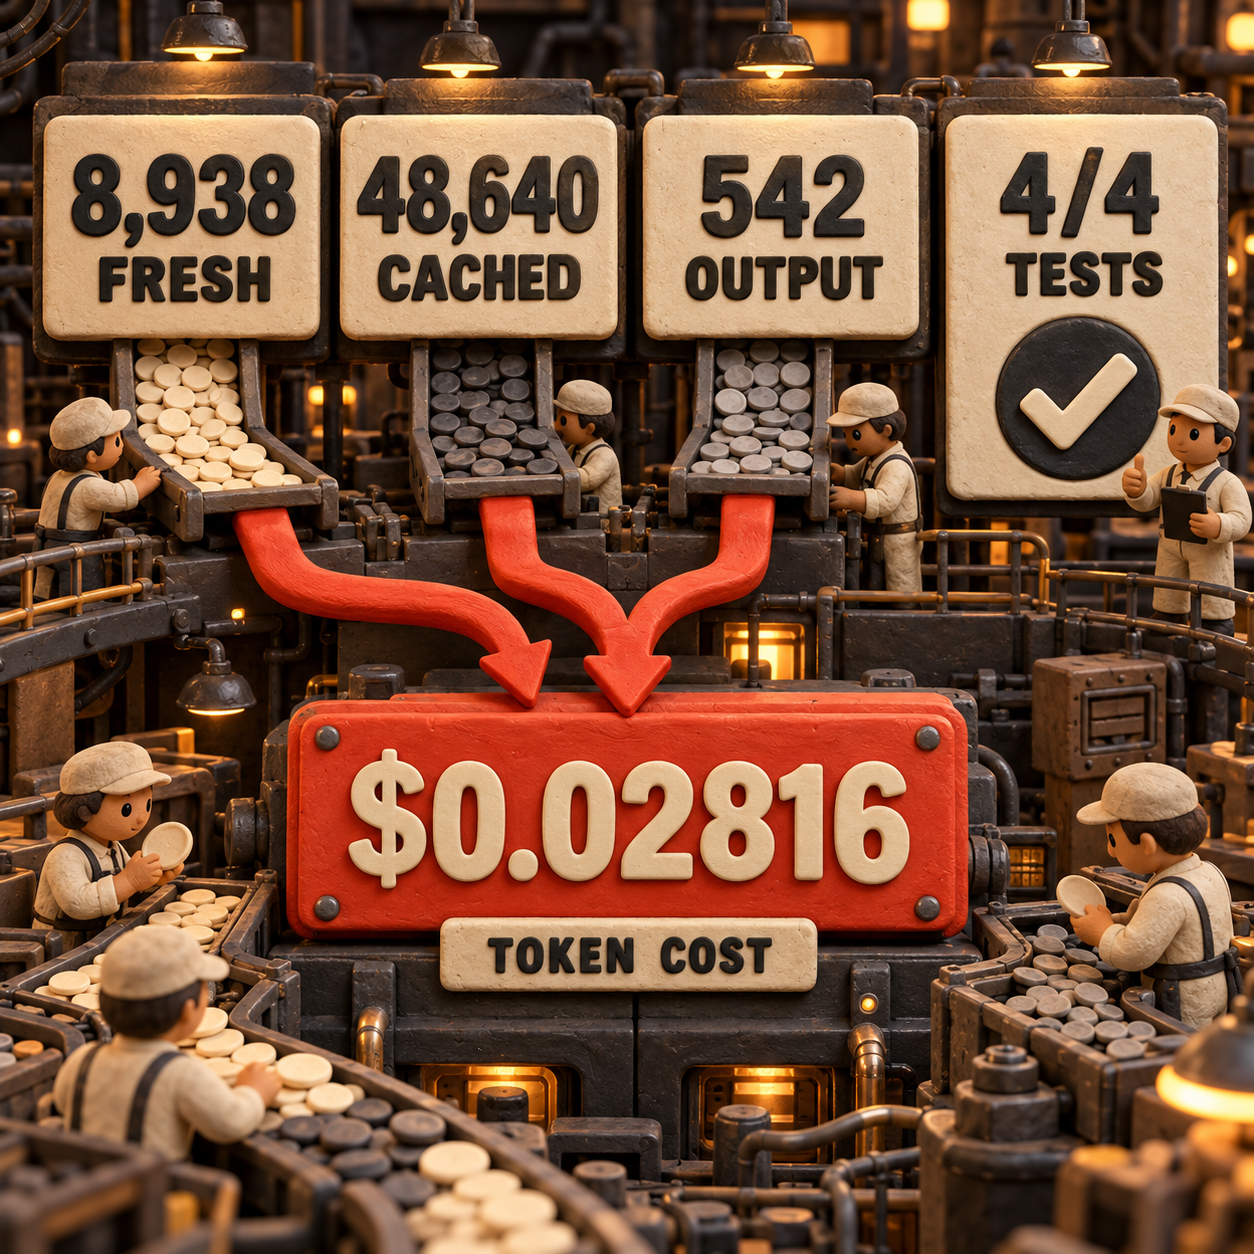
실제 Codex 실행이었으므로 API 청구서가 생긴 것이 아니라 플랜 사용량을 소비했습니다. $0.02816은 실제 토큰 구성에 GPT-6.1 Sol의 공개된 Standard API 요율을 적용한 정확한 값입니다. 유료 호스팅 툴 요금은 포함하지 않습니다. 동일한 실행을 10,000번 수행하면 모델 토큰 비용은 $281.60입니다. 토큰 구성이 같다고 가정하면 Astra 요율에서는 $1,651.20이 됩니다. Astra 비교치는 요율을 이용한 산술 계산일 뿐, Astra가 같은 수의 토큰을 사용한다는 주장이 아닙니다.
여기서 모든 작은 패치가 3센트라는 결론을 내리면 안 됩니다. 에이전트 런타임, 툴 정의, 지침, 대화 이력이 화면에 보이는 요청보다 더 큰 비중을 차지할 수 있다는 뜻입니다. 캐시된 컨텍스트와 재시도를 포함해 승인된 실행 전체를 측정해야 합니다.
Sol이 가장 잘 맞는 7가지 업무
어려운 업무를 반복해서 처리하는 팀이 가장 큰 이점을 얻습니다. 예상 운영 가치 순으로 정리하면 다음과 같습니다.
Sol이 승인 설계, 결정론적 검사, 관측 가능성의 필요성을 없애 주는 것은 아닙니다. Astra보다 낮은 토큰 요율로 이런 시스템에 더 유능한 작업자를 투입할 수 있게 해 줍니다.
만들어 볼 만한 제품 3가지
1. 코딩 에이전트용 Sol 마이그레이션 테스트 벤치
가장 가능성이 큰 기회입니다. 미국에서 ai powered coding agent를 검색하는 횟수는 월 약 8,100회이며 상업적 의도가 있습니다. 팀에 필요한 것은 또 하나의 모호한 모델 순위표가 아닙니다. 동일한 프롬프트, 툴, 검사 조건에서 저장소 작업이 gpt-6-sol, gpt-6.1-sol, Astra 중 어느 모델을 통과하는지 알아야 합니다.
판매 가능한 최소 버전은 CLI와 CI 액션의 조합입니다. 팀이 JSON fixture 5개, 통과 명령, 허용할 툴을 제공합니다. 테스트 벤치는 각 모델을 실행해 승인된 결과, 지연 시간, 신규 및 캐시된 토큰, 재시도, 비용을 기록하고 승격 여부를 출력합니다. 문제는 범용 평가 러너를 쉽게 복제할 수 있다는 점입니다. 실용적인 코딩 fixture 라이브러리, 연동 기능, 유용한 실패 진단이 방어력을 만듭니다.
2. 운영 에이전트용 effort·비용 라우터
미국에서 ai workflow automation을 검색하는 횟수는 월 약 1,000회이며, 상업적 의도가 있고 CPC는 $37.80입니다. 이 시장이 원하는 것은 또 하나의 채팅창이 아니라 완료된 업무입니다. 라우터는 범위가 명확한 사례를 low, 일반적인 다단계 업무를 medium, 어려운 실패를 high로 보내고, 해결되지 않은 잔여 작업만 Astra로 넘길 수 있습니다.
MVP에는 대기열 1개, effort 정책 3개, 승인 함수 1개, 지출 대시보드가 필요합니다. 이미 여러 자동화에 비용을 쓰는 운영팀에 판매할 수 있습니다. 문제는 잘못된 확신입니다. 저렴한 라우터가 결과가 중대한 사례 1개를 잘못 분류하면 절감액이 사라질 수 있습니다. 처음부터 재실행 가능한 fixture와 수동 재정의 기능을 넣어야 합니다.
3. 문서 에이전트 승인 레이어
ai document analysis는 미국에서 월 약 1,000회 검색되며 CPC는 $10.44입니다. 제품은 파일을 올리고 요약해 주는 또 하나의 화면이 아닙니다. 문서 에이전트가 모든 필수 필드를 찾았는지, 인용을 보존했는지, 합계를 대조했는지, 불확실성을 상위 단계로 넘겼는지 확인하는 검증 레이어입니다.
가장 작은 버전은 공급업체 계약서나 월간 재무 PDF처럼 반복되는 문서 묶음 1종을 고정 스키마와 예외 대기열로 지원합니다. 반복 분석은 GPT-6.1 Sol이 처리하고, 판단이 엇갈리거나 미완성인 사례만 Astra로 보냅니다. 문제는 도메인 특수성입니다. 광범위한 수평형 제품은 평범해 보이지만, 신뢰할 만한 검사를 갖춘 좁은 문서 묶음은 신뢰를 얻을 수 있습니다.
GPT-6 Sol을 유지하거나 Astra에 비용을 써야 할 때
호환성이 제약이라면 GPT-6 Sol을 유지하십시오. GPT-6 Sol은 여전히 none reasoning을 지원하며, reasoning_effort가 none일 때 Chat Completions를 통해 함수를 호출할 수 있습니다. GPT-6.1 Sol은 둘 다 지원하지 않습니다. 이러한 동작에 의존하는 안정적인 경로라면 먼저 API 경로를 옮기고 회귀 테스트를 통과한 뒤 모델을 바꿔야 합니다.
토큰 비용보다 최상의 결과가 중요하다면 GPT-6 Astra에 비용을 쓰십시오. OpenAI는 Astra를 가장 까다로운 reasoning, 코딩, 컴퓨터 사용, 리서치, 문서 제작을 위한 최고 성능 모델로 설명합니다. 고정된 평가에서 실질적인 향상이 나타나는, 모호하지만 가치가 큰 후반부 작업에 사용하십시오. Standard 요율은 Astra가 입력 100만 토큰당 $10, 출력 100만 토큰당 $50이고 GPT-6.1 Sol은 각각 $2와 $10입니다.
반복되고 측정 가능한 성공 조건이 있는 본격적인 Responses 기반 업무, 즉 넓은 중간 영역에는 GPT-6.1 Sol을 사용하십시오. OpenAI의 출시 평가에서는 여러 어려운 워크로드에서 GPT-6 Sol보다 더 좋은 결과가 보고됐지만, 이는 공급업체가 실행한 평가입니다. 운영 전환의 기준은 자체 승인 결과 비율이어야 합니다.
설정을 좌우하는 제약 사항
GPT-6.1 Sol이 모든 경로를 대체하지는 않습니다. none 또는 minimal effort, Chat Completions를 통한 툴 호출, 파인튜닝, 오디오나 비디오 입력, 출시 시점의 일반 Chat 접근을 지원하지 않습니다. 유료 툴에는 별도 요금도 붙습니다. 입력 토큰이 272,000개를 넘으면 전체 요청에 더 높은 장문 컨텍스트 요율이 적용되므로, 1,050,000토큰 윈도를 무료 작업 공간처럼 여겨서는 안 됩니다.
Ultrafast 역시 솔직히 짚어야 할 제약입니다. OpenAI는 Codex에서 표준 속도 대비 최대 8x 빠른 토큰 생성을 발표했지만, 추후 제공될 기능이라고 설명했습니다. 계정과 클라이언트에 실제로 나타나기 전까지는 Standard 또는 Fast를 기준으로 계획하고, 직접 받은 지연 시간을 측정하십시오.
월요일에 바로 할 일
현재 에이전트가 최근 완료한 작업 5개를 고르십시오. 쉬운 성공 사례 1개, 일반 작업 2개, 툴 사용이 많은 작업 1개, 알려진 실패 사례 1개입니다. 프롬프트나 권한을 바꾸지 말고 같은 fixture를 medium의 GPT-6.1 Sol에서 실행합니다. 통과 여부, 경과 시간, 신규 입력, 캐시된 입력, 출력, 재시도, 툴 요금을 기록하십시오.
그다음 승자를 선언하지 말고 라우팅하십시오. 범위가 명확한 작업이 계속 통과한다면 low로 낮춥니다. 더 깊은 추론이 필요한 실패 사례에만 high를 테스트합니다. 호환성에 묶인 호출부는 GPT-6 Sol에 유지합니다. 승인율 향상이 가격을 정당화할 때만 비용이 큰 잔여 작업을 Astra로 보냅니다. 이렇게 하면 모델에 대한 의견이 아니라 이번 주에 적용할 운영 결정을 얻을 수 있습니다.
자주 묻는 질문
GPT-6.1 Sol은 어떤 모델인가요?
GPT-6.1 Sol은 복잡한 코딩, 컴퓨터 사용, 전문 업무를 위한 OpenAI의 저비용 모델입니다. API ID는 gpt-6.1-sol이며 툴 호출은 Responses API를 통해 실행됩니다.
AI 코딩 에이전트란 무엇인가요?
AI 코딩 에이전트는 정해진 권한 안에서 저장소를 검사하고, 파일을 편집하고, 명령과 테스트를 실행한 뒤 결과를 보고할 수 있습니다. 유용성을 판단하는 단위는 생성된 코드만이 아니라 테스트를 거친 결과입니다.
ChatGPT에도 코딩 에이전트가 있나요?
있습니다. Codex는 OpenAI의 코딩 에이전트이며 GPT-6.1 Sol은 유료 플랜 출시 범위에서 사용할 수 있습니다. 이 모델은 ChatGPT Work에도 포함되지만 일반 Chat에는 아직 제공되지 않습니다.
GPT-6 Sol이 더 저렴한가요?
신규 입력과 출력은 그렇지 않습니다. 두 Sol 모델 모두 Standard 토큰 100만 개당 입력 $2, 출력 $10입니다. GPT-6.1 Sol의 캐시된 입력 요율이 더 낮습니다. 전체 Sol 비교에서 가격과 호환성 차이를 자세히 설명합니다.
비즈니스에 맞는 에이전트 경로를 설계하고 테스트해 운영까지 연결하려면 AI 프로덕션 시스템을 확인하십시오.
- 마지막 업데이트
- 2026년 9월 30일
- 카테고리
- AI
Google에서 이 사이트를 우선하기


omidsaffari.com을 선호 소스로 지정하면 Google이 Top Stories, AI Overviews, AI Mode에서 우선적으로 보여 줍니다.
GPT-6.1 Sol 비교: GPT-6 Sol에서 업그레이드해야 할까?
GPT-6.1 Sol과 GPT-6 Sol의 가격, 캐시 비용, 벤치마크, 컨텍스트, 추론 옵션과 툴 호출 호환성을 한눈에 비교했습니다. Responses API 워크로드의 업그레이드 조건, 기존 모델을 유지해야 할 경우와 실무 테스트 기준까지 확인하세요.2026년 9월 30일AI
Claude 사용법: Sonnet 5.5 실전 가이드
Claude 사용법을 실무 중심으로 정리했습니다. Claude Sonnet 5.5를 Medium effort로 시작하는 방법부터 비용 계산, 7가지 워크플로, API 마이그레이션, 검증 절차, 제품화 아이디어까지 실제 지원 티켓 테스트를 바탕으로 자세히 설명합니다.2026년 9월 28일AI
Jev GLM-5.3-Flash 비교: 텍스트 비용과 이미지 처리의 승자는?
Jev와 GLM-5.3-Flash를 비용, 정확도, 지연 시간, 이미지 입력, 보안 처리 관점에서 비교합니다. 텍스트 라우팅에는 Jev, 멀티모달 문서 분류에는 Privatemode 경로가 유리한 이유와 전환 전 30건 테스트 방법까지 확인해 보세요.2026년 9월 27일AI
Claude Opus 5.5, Opus 5에서 갈아탈 때인가
Claude Opus 5.5와 Opus 5의 가격, 코딩 근거, API 호환성, thinking 설정을 비교합니다. 토큰 비용표와 5가지 마이그레이션 위험을 바탕으로 어떤 워크로드를 옮겨야 할지, 전환 전에 무엇을 검증해야 할지 한눈에 빠르게 확인하세요.2026년 9월 23일AI
GPT-6 Sol Luna 비교: 20× 가격 차이를 넘는 선택 기준
GPT-6 Sol Luna 비교를 가격, 코딩 성능, 컨텍스트, 툴 지원 기준으로 정리합니다. 동일 작업 100건의 20× 비용 차이를 계산하고, 검증 가능한 반복 작업은 Luna로 처리하며 고난도 코딩과 에이전트 작업만 Sol로 올리는 라우팅 기준과 평가 절차를 설명합니다.2026년 9월 23일AI
GPT-6 Luna 무료 사용 조건과 API 가격 총정리
GPT-6 Luna 무료 이용은 Free·Go 계정의 데스크톱 앱에 한정됩니다. 유료 Work·Codex, 일반 Chat, 별도 과금 API의 차이와 토큰 가격, 공개되지 않은 사용 한도, 도입 전에 확인할 실무 항목과 평가 방법까지 한눈에 정리했습니다.2026년 9월 22일AI
MiMo V2.6 사용법: API로 첫 업무 워크플로 만들기
MiMo V2.6을 Studio에서 검증하고 Xiaomi API에 연결하는 과정을 단계별로 설명합니다. Flash·Pro 선택, 키와 base URL 설정, Python 요청, 비용 계산, 문제 해결, 안전한 실무 워크플로 설계까지 한 번에 확인하세요.2026년 9월 22일AI