برمجة بالذكاء الاصطناعي مع GPT-6.1 Sol: إعداد الوكلاء وCodex
تعرّف إلى إعداد GPT-6.1 Sol للبرمجة بالذكاء الاصطناعي والوكلاء عبر Responses API، واختيار مستوى الاستدلال والأدوات وقياس التكلفة قبل الانتقال إلى الإنتاج.



استخدم GPT-6.1 Sol في البرمجة بالذكاء الاصطناعي وغيرها من الأعمال الجادة والمتكررة: المهام التي تتجاوز قدرات نموذج خفيف، لكنها تتكرر أكثر مما يسمح بإرسالها تلقائيا إلى Astra. الإعداد العملي مباشر: استخدم gpt-6.1-sol عبر Responses API، وابدأ بمستوى medium، ولا تفتح إلا الأدوات اللازمة للمهمة، ثم انقل المسار إلى الإنتاج بعد اجتياز اختبارات قبول ثابتة. وفي تجربة Codex جديدة نُفّذت لهذا الدليل، أنشأ النموذج أداة JavaScript صغيرة، وكتب أربعة اختبارات، واجتازها كلها، بتكلفة مكافئة عبر API للرموز فقط قدرها $0.02816.
القرار في دقيقة واحدة
أصبح GPT-6.1 Sol جاهزا لوكلاء API وCodex وخطط ChatGPT Work المدفوعة. لكنه لم يصل بعد إلى Chat العادي، كما أُعلن عن وضع Ultrafast لهذا النموذج من دون أن يصبح متاحا حتى الآن.
سعر Standard عبر API هو $2 لكل مليون رمز إدخال و$10 لكل مليون رمز إخراج. أما GPT-6 Astra فسعره $10 و$50. ويؤكد إعلان الإطلاق من OpenAI تفاصيل طرح المنتج. وللمقارنة الأشمل بين الإتاحة وحدود المعدل، راجع GPT-6.1 Sol vs GPT-6 Sol؛ إذ يركز هذا الدليل على الإعداد وقرارات التشغيل.
ما GPT-6.1 Sol فعليا؟
يمكن النظر إلى عائلة GPT-6 كفريق تشغيل متدرج. Astra هو الخبير الذي تستدعيه لأصعب حالة خلافية، بينما GPT-6.1 Sol هو المشغّل الخبير الذي يمكن الاعتماد عليه في الأعمال المعقدة المتكررة. ويبقى GPT-6 Sol خيار التوافق لمسار أدوات أقدم. هذا التصور أنفع من اعتبار النموذج الجديد خيارا افتراضيا لكل شيء.
يستقبل GPT-6.1 Sol النصوص والصور، ويعيد النصوص، ويوفر نافذة سياق من 1,050,000 رمز مع مخرجات تصل إلى 128,000 رمز. لكن القيمة الحقيقية للوكيل تكمن في منظومة أدواته. فعبر Responses يدعم البحث في الويب، والبحث في الملفات، وتوليد الصور، ومفسر الأكواد، وبيئة shell المستضافة، وapply patch، والمهارات، واستخدام الكمبيوتر، وMCP، والبحث عن الأدوات، إضافة إلى دوالك الخاصة. ويشرح دليل أدوات Responses كيف تُبقي API النموذج داخل حلقة عمل وكيلية يقرر فيها الأداة المسموح بها التي ينبغي استدعاؤها تاليا.
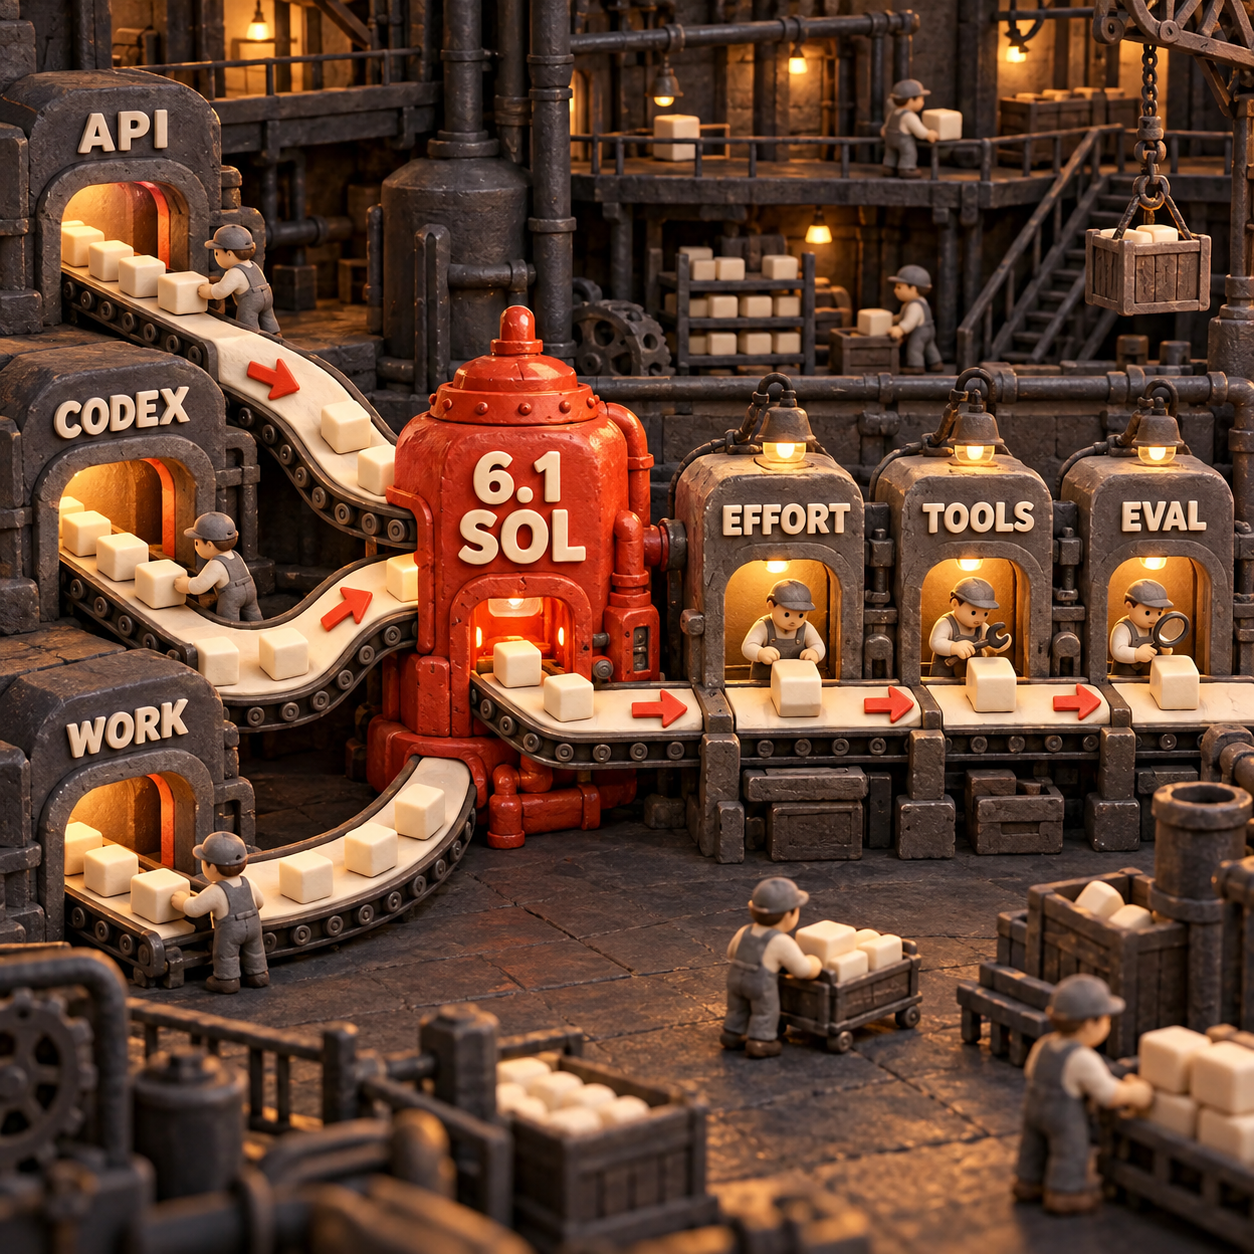
والقيد مهم بالقدر نفسه: لا يستطيع GPT-6.1 Sol استخدام الأدوات إلا عبر Responses. لا تزال Chat Completions تقبل الطلبات النصية العادية، لكنها لا تقبل طلبا يتضمن استدعاء أدوات. فإذا كان وكيلك الحالي يستدعي الدوال عبر Chat Completions، فلن يكفي تغيير معرّف النموذج وحده لإتمام الترحيل.
إعداد البرمجة بالذكاء الاصطناعي على Responses API
ابدأ بمسار واحد واختبار قبول واحد. لا تعرض كل أداة لمجرد ورودها في صفحة النموذج. فقد يحتاج وكيل البحث إلى البحث في الويب والملفات، بينما يحتاج وكيل المستودع إلى shell وإمكان تعديل الملفات. وقد لا يحتاج وكيل العمليات إلا إلى دالتين وحد واضح للموافقة.
هذا هو أصغر طلب JavaScript مفيد:
import OpenAI from "openai";

const client = new OpenAI();

const response = await client.responses.create({
  model: "gpt-6.1-sol",
  reasoning: { effort: "medium" },
  tools: [{ type: "web_search" }],
  input: "Find today's source for our target metric, cite it, and return one sentence."
});

console.log(response.output_text);
يحدد معرّف النموذج Sol. ويتحكم كائن reasoning في مقدار الجهد المتاح للتفكير. أما مصفوفة tools فتمنح قدرة ولا تصدر أمرا باستخدامها. لذلك يجب أن يحدد الطلب النتيجة المطلوبة، ودليل الإثبات، وشرط التوقف.
عند نقل وكيل قائم على Chat Completions، تعامل مع العملية بوصفها ثلاثة تغييرات: أرسل الطلب إلى Responses، وحلّل عناصر output ذات الأنواع المحددة، ثم قرر كيف ستستمر حالة المحادثة. يشرح دليل ترحيل Astra إلى Responses API هذه البنية بمزيد من التفصيل.
ثبّت خمس مهام حقيقية
اختر أمثلة مقبولة من سير العمل، على أن تتضمن حالة فشل واحدة. واحتفظ بالطلب والمدخلات والصلاحيات ومعايير النجاح كما هي.
ابدأ بمستوى medium
استخدم مستوى الجهد الافتراضي أولا. غيّر متغيرا واحدا في كل مرة، حتى لا تختلط مكاسب النموذج بتغيير الطلب أو الأدوات.
امنح أقل مجموعة لازمة من الأدوات
لا تعرض سوى أدوات البحث أو الملفات أو الدوال أو shell أو التحكم بالكمبيوتر التي يحتاجها المسار. وأبق إجراءات الكتابة خلف سياسات صريحة وحدود موافقة واضحة.
سجّل تكلفة النتيجة المقبولة
سجّل الإدخال الجديد والإدخال المخزّن مؤقتا والمخرجات والمحاولات ورسوم الأدوات وما إذا كانت الحالة النهائية قد اجتازت الاختبار. فالتشغيل الرخيص الذي يفشل ليس وفرا.
وجّه العمل بحسب الدليل
أبق Sol حيث ينجح. ولا تصعّد إلى Astra إلا الجزء الصعب المتبقي. واترك المسارات غير المتوافقة على GPT-6 Sol إلى أن يتغير المستدعي الخاص بها.
كيف تختار مستوى الاستدلال بحسب المهمة؟
يمثل medium نقطة البداية الصحيحة لمعظم أعمال الوكلاء. ويقبل GPT-6.1 Sol أيضا low وhigh وxhigh وmax. لكنه يرفض none وminimal، لذلك يحتاج أي مسار قائم يستخدم أحدهما إلى اختبار مقصود للسلوك وزمن الاستجابة. ويعرض دليل مستوى جهد الاستدلال من OpenAI التدرج نفسه، من التنفيذ الكفؤ إلى أقصى عمق في الاستدلال.
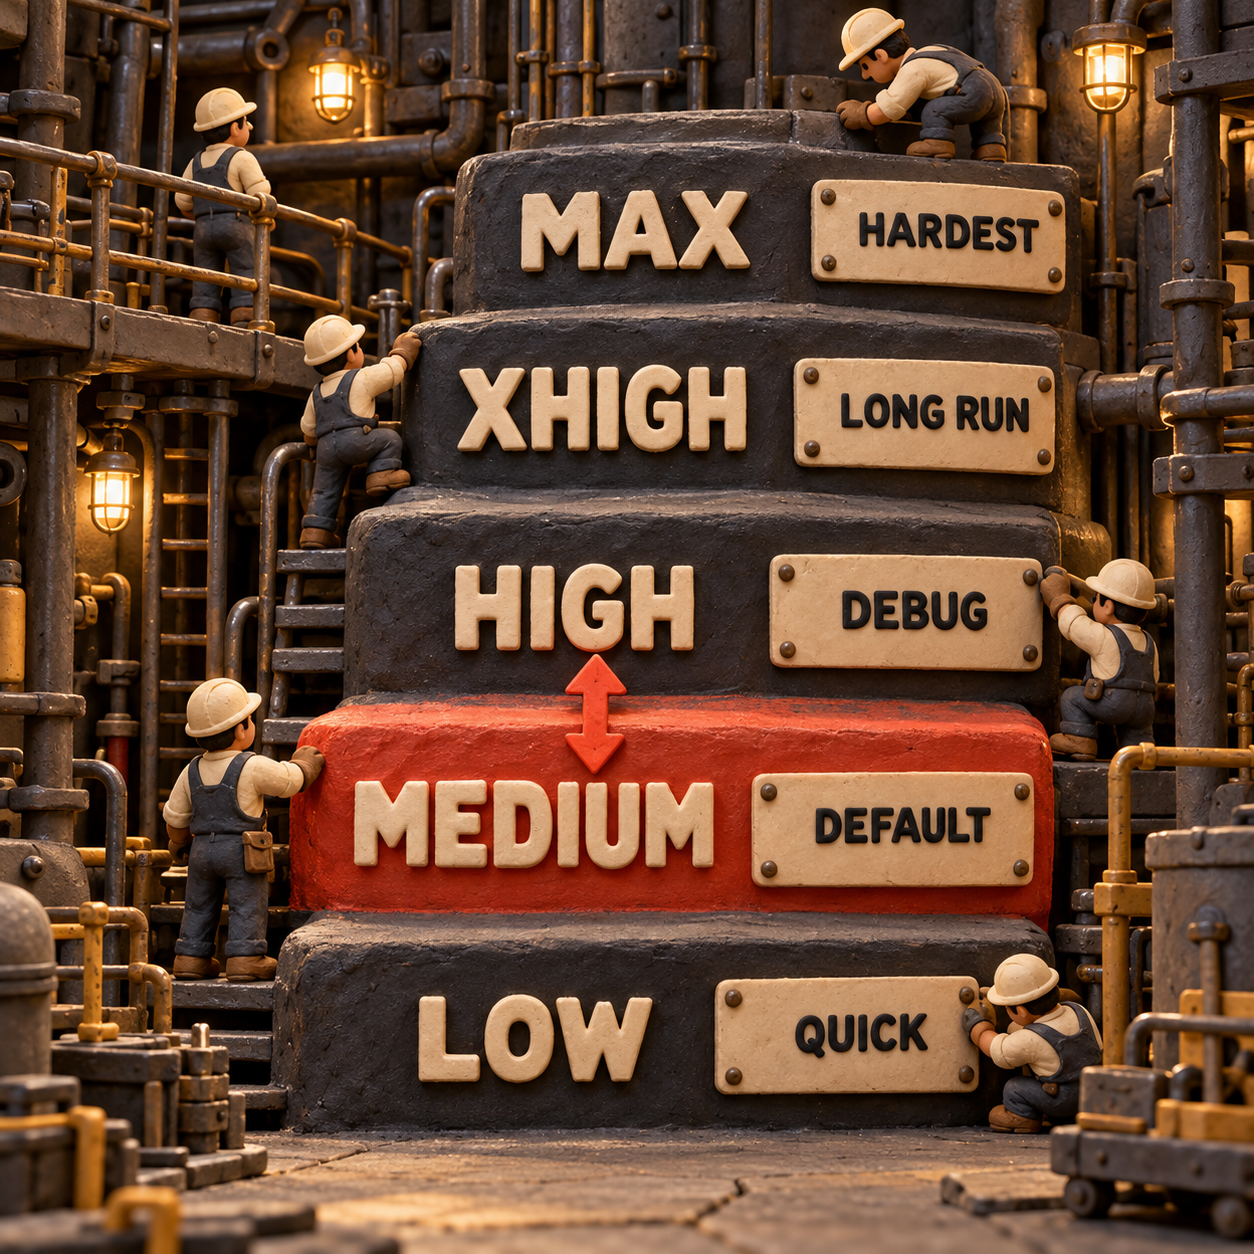
هناك ثلاثة أسماء متشابهة، لكنها تشير إلى عناصر تحكم مختلفة. max هو مستوى جهد للاستدلال في API. أما Ultra في Codex فهو وضع متعدد الوكلاء يوزع العمل على وكلاء فرعيين. وUltrafast وضع للسرعة، ولا يزال دعم GPT-6.1 Sol له قادما. لذلك لا تضع ميزانية أو خطة إطلاق تعتمد على Ultrafast وكأنه متاح اليوم.
مهمة حقيقية عبر GPT-6.1 Sol وتكلفتها من الرموز
تكشف عملية تشغيل صغيرة عن اقتصاديات أنفع من سعر معلن مجرد. تلقى GPT-6.1 Sol عند مستوى low هذه المهمة في Codex: أنشئ دالة JavaScript باسم slugify بلا تبعيات، وأضف أربعة اختبارات node:test بالضبط لمعالجة الفراغات الطرفية والمسافات وعلامات الترقيم وحالة الأحرف المختلطة، ثم شغّل الاختبارات وأصلح أي فشل.
أنشأ النموذج الملفين slugify.js وslugify.test.js، ثم شغّل node --test slugify.test.js. وكانت النتيجة نجاح 4 اختبارات و0 إخفاقات. وبلغ الاستهلاك المسجل 57,578 رمز إدخال، منها 48,640 رمزا مخزّنا مؤقتا، إضافة إلى 542 رمز إخراج. وهذا يعني أن 8,938 رمز إدخال فقط احتُسبت بسعر الإدخال الجديد.
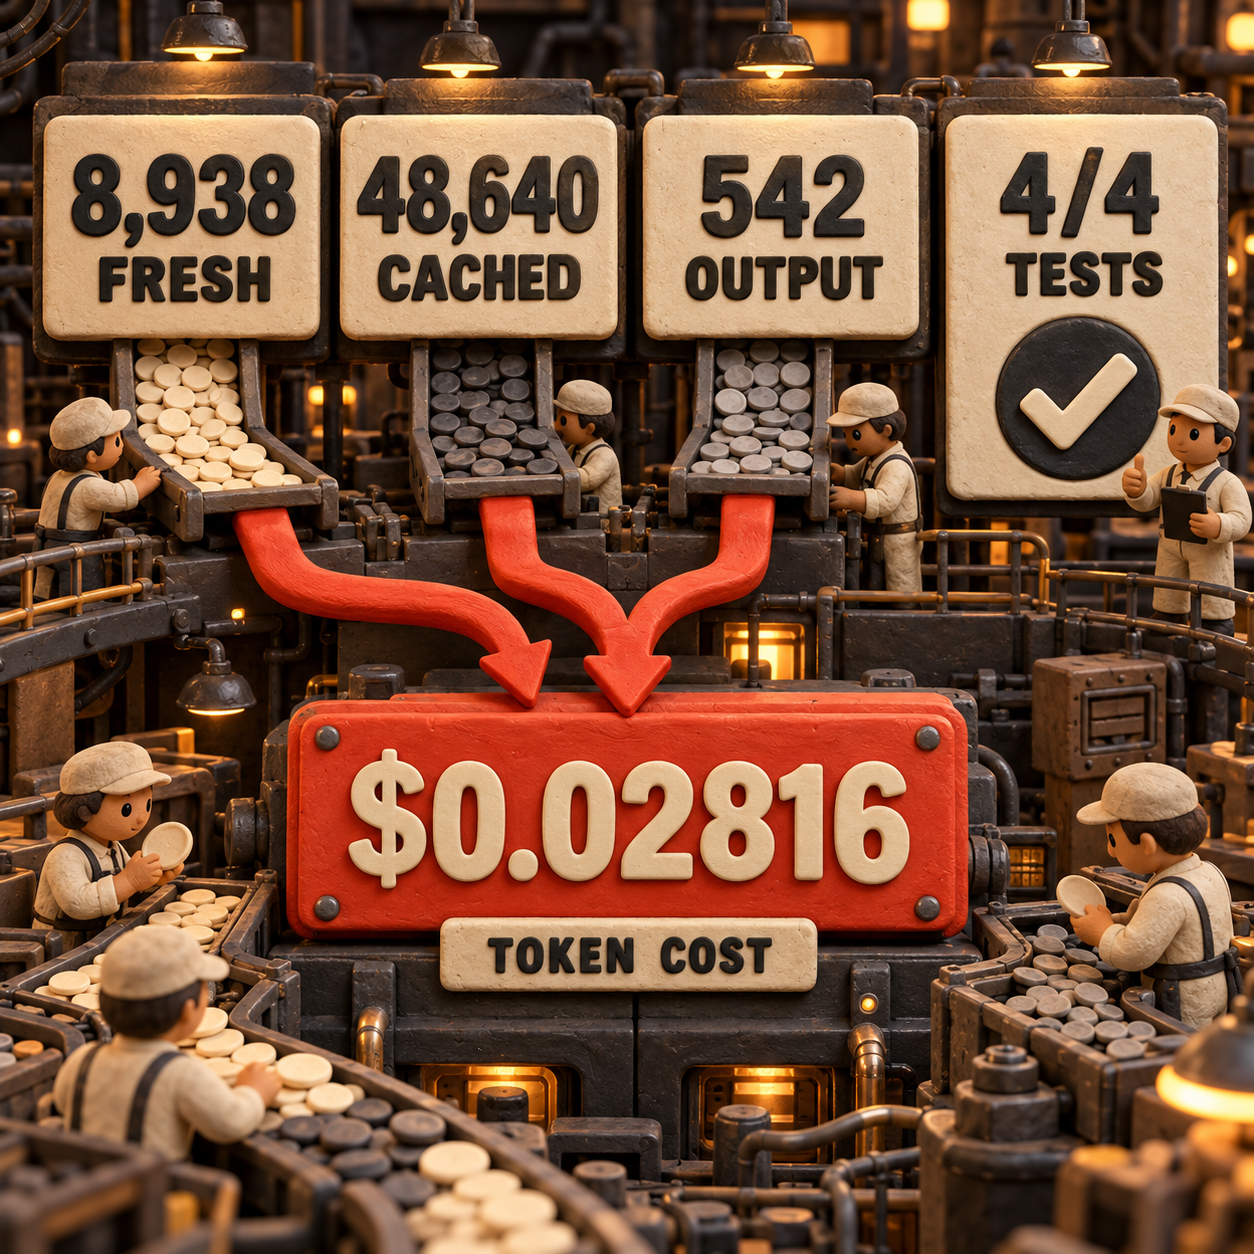
كان هذا تشغيلا حقيقيا عبر Codex، لذا استهلك حصة الخطة بدلا من إنشاء فاتورة API. وتمثل قيمة $0.02816 المزيج الدقيق للرموز بعد تسعيره وفق أسعار Standard المنشورة لـGPT-6.1 Sol. وهي لا تشمل أي رسوم لأداة مستضافة مدفوعة. وعند تنفيذ 10,000 عملية مماثلة، سيبلغ هذا المزيج $281.60 من رموز النموذج. ومع ثبات مزيج الرموز، سترفع أسعار Astra المبلغ إلى $1,651.20. وهذه المقارنة مع Astra عملية حسابية للأسعار، وليست ادعاء بأن Astra سيستهلك عدد الرموز نفسه.
ولا تعني النتيجة أن كل تعديل صغير يكلف ثلاثة سنتات. بل تعني أن بيئة تشغيل الوكيل وتعريفات الأدوات والتعليمات والسجل قد تفوق الطلب الظاهر حجما. لذلك قس التشغيل المقبول كاملا، بما فيه السياق المخزّن مؤقتا والمحاولات المتكررة.
أفضل سبع مهام لوكلاء الذكاء الاصطناعي مع Sol
تحقق الفرق التي تنفذ أعمالا صعبة ومتكررة أكبر استفادة منه. وفيما يلي الترتيب بحسب القيمة التشغيلية المتوقعة:
لا يلغي Sol الحاجة إلى تصميم الموافقات أو الاختبارات الحتمية أو قابلية المراقبة. لكنه يمنح هذه الأنظمة عاملا أكثر قدرة بسعر رموز أقل من Astra.
ثلاثة منتجات تستحق البناء
1. منصة اختبار ترحيل Sol لوكلاء البرمجة
هذه هي الفرصة الأقوى. تستهدف نحو 8,100 عملية بحث شهريا في الولايات المتحدة عبارة ai powered coding agent، بقصد تجاري. ولا تحتاج الفرق إلى لوحة ترتيب مبهمة أخرى للنماذج؛ بل تحتاج إلى معرفة ما إذا كانت مهام مستودعاتها تنجح على gpt-6-sol وgpt-6.1-sol وAstra عند استخدام الطلب والأدوات والاختبارات نفسها.
أصغر نسخة قابلة للبيع هي CLI مع إجراء CI. يقدم الفريق خمس حالات اختبار بصيغة JSON، وأمر التحقق من النجاح، والأدوات المسموح بها. وتشغّل المنصة كل نموذج، وتسجل النتائج المقبولة وزمن الاستجابة والرموز الجديدة والمخزّنة مؤقتا والمحاولات والتكلفة، ثم تطبع قرار الترقية. لكن تقليد أدوات التقييم العامة سهل؛ أما الميزة التي يصعب نسخها فهي مكتبة حالات اختبار برمجية عملية، وتكاملات، وتشخيصات مفيدة للفشل.
2. موجّه لمستوى الجهد والتكلفة لدى وكلاء العمليات
تستهدف نحو 1,000 عملية بحث شهريا في الولايات المتحدة عبارة ai workflow automation، بقصد تجاري وCPC قدره $37.80. فهذا سوق يبحث عن عمل منجز، لا عن صندوق محادثة آخر. ويمكن للموجّه إرسال الحالات المحدودة إلى low، والعمل المعتاد متعدد الخطوات إلى medium، وحالات الفشل الصعبة إلى high، ثم إرسال الجزء العالق وحده إلى Astra.
يحتاج المنتج الأولي إلى قائمة انتظار واحدة، وثلاث سياسات للجهد، ودالة قبول، ولوحة إنفاق. ويمكن بيعه لفرق العمليات التي تدفع بالفعل مقابل عمليات أتمتة عدة. لكن الخطر هو الثقة الزائفة: فموجّه رخيص يسيء تصنيف حالة حساسة واحدة قد يمحو وفره. لذا يحتاج المنتج منذ يومه الأول إلى تجهيزات قابلة لإعادة التشغيل وإمكانية تجاوز يدوي.
3. طبقة قبول لوكلاء المستندات
تحصل عبارة ai document analysis على نحو 1,000 عملية بحث شهريا في الولايات المتحدة، وتحمل CPC قدره $10.44. والمنتج المقصود ليس شاشة أخرى لرفع الملفات وتلخيصها؛ بل طبقة تحقق تتأكد من أن وكيل المستندات عثر على كل حقل مطلوب، وحافظ على المراجع، وطابق المجاميع، وصعّد مواضع عدم اليقين.
تدعم النسخة الأصغر حزمة دورية واحدة، مثل عقود الموردين أو ملفات PDF المالية الشهرية، بمخطط ثابت وقائمة انتظار للاستثناءات. يتولى GPT-6.1 Sol التحليل المتكرر، ولا يستقبل Astra إلا الحالات المختلف عليها أو غير المكتملة. والتحدي هنا هو التخصص القطاعي: فالمنتج الأفقي الواسع سيبدو عاما، بينما تستطيع حزمة ضيقة باختبارات موثوقة أن تكسب الثقة.
متى تُبقي GPT-6 Sol ومتى تدفع مقابل Astra؟
أبق GPT-6 Sol عندما يكون التوافق هو القيد الحاسم. فهو ما زال يقبل مستوى الاستدلال none، ويمكنه استدعاء الدوال عبر Chat Completions عندما يكون reasoning_effort مضبوطا على none. أما GPT-6.1 Sol فلا يستطيع ذلك. وإذا كان مسار مستقر يعتمد على هذين السلوكين، فيجب نقل مسار API واجتياز اختبارات الانحدار قبل تغيير النموذج.
ادفع مقابل GPT-6 Astra حين تكون أفضل نتيجة أهم من فاتورة الرموز. تصفه OpenAI بأنه نموذجها الأقدر على أصعب مهام الاستدلال والبرمجة واستخدام الكمبيوتر والبحث وإنشاء المستندات. استخدمه للحالات الملتبسة عالية القيمة التي يُظهر فيها تقييمك الثابت تفوقا ملموسا. وبأسعار Standard، تبلغ تكلفة Astra $10 للإدخال و$50 للإخراج لكل مليون رمز، مقابل $2 و$10 لـGPT-6.1 Sol.
استخدم GPT-6.1 Sol للمنطقة الوسطى الواسعة: أعمال جادة ومتكررة قائمة على Responses ولها معيار نجاح قابل للقياس. وتُظهر تقييمات الإطلاق التي نشرتها OpenAI نتائج أقوى من GPT-6 Sol في عدة أعباء عمل صعبة، لكنها تظل نتائج أجراها المورّد. أما بوابة الإطلاق الفعلية فهي معدل النتائج المقبولة في بيئتك.
قيود تغيّر طريقة الإعداد
لا يصلح GPT-6.1 Sol بديلا لكل مسار. فهو لا يدعم مستويي none أو minimal، ولا استدعاء الأدوات عبر Chat Completions، ولا الضبط الدقيق، ولا إدخال الصوت أو الفيديو، ولا Chat العادي عند الإطلاق. كما تضيف الأدوات المدفوعة رسوما خاصة بها. وأي طلب يتجاوز 272,000 رمز إدخال ينقل الطلب بأكمله إلى أسعار السياق الطويل الأعلى، لذلك لا ينبغي التعامل مع نافذة من 1,050,000 رمز كمساحة عمل مجانية.
وUltrafast قيد آخر يجب توضيحه. فقد أعلنت OpenAI عن توليد رموز أسرع بما يصل إلى 8x من السرعة القياسية في Codex، لكنها وصفته بأنه قادم. وإلى أن يظهر في حسابك وعميلك، خطط باستخدام Standard أو Fast، وقس زمن الاستجابة الذي تحصل عليه فعليا.
ما الذي ينبغي فعله يوم الاثنين؟
خذ خمس مهام أنجزها وكيلك الحالي مؤخرا: نجاحا سهلا واحدا، ومهمتين عاديتين، ومهمة كثيفة الأدوات، وحالة فشل معروفة. شغّل التجهيزات نفسها على GPT-6.1 Sol عند مستوى medium من دون تغيير الطلبات أو الصلاحيات. وسجّل النجاح أو الفشل، والزمن الفعلي، والإدخال الجديد، والإدخال المخزّن مؤقتا، والمخرجات، والمحاولات، ورسوم الأدوات.
بعد ذلك وجّه المهام، ولا تعلن فائزا مطلقا. انقل العمل المحدود إلى low إذا ظل ينجح. ولا تختبر high إلا مع حالات الفشل التي تحتاج إلى استدلال أعمق. وأبق المستدعين المقيدين بالتوافق على GPT-6 Sol. ولا ترسل الجزء المكلف المتبقي إلى Astra إلا إذا كان تحسن القبول يبرر السعر. بهذه الطريقة تصل إلى قرار إنتاجي هذا الأسبوع، لا إلى رأي نظري في نموذج.
الأسئلة الشائعة
ما GPT-6.1 Sol؟
GPT-6.1 Sol هو نموذج OpenAI الأقل تكلفة للأعمال المعقدة في البرمجة واستخدام الكمبيوتر والمهام المهنية. معرّفه في API هو gpt-6.1-sol، ويعمل استدعاء الأدوات فيه عبر Responses API.
ما وكلاء البرمجة بالذكاء الاصطناعي؟
يستطيع وكلاء البرمجة بالذكاء الاصطناعي فحص المستودع وتعديل الملفات وتشغيل الأوامر والاختبارات وتقديم النتيجة ضمن الصلاحيات التي تحددها. وما يهم هو نتيجة مختبرة، لا مجرد كود مولّد.
هل يتضمن ChatGPT وكيل برمجة؟
نعم. Codex هو وكيل البرمجة من OpenAI، ويتاح GPT-6.1 Sol ضمن طرحه للخطط المدفوعة. كما يتوفر النموذج في ChatGPT Work، لكنه لم يصل بعد إلى Chat العادي.
هل GPT-6 Sol أرخص؟
ليس في الإدخال الجديد أو الإخراج؛ فكلا نموذجي Sol يسعّر مليون رمز Standard عند $2 للإدخال و$10 للإخراج. لكن GPT-6.1 Sol يقدم سعرا أقل للإدخال المخزّن مؤقتا. وتشرح المقارنة الكاملة بين نموذجي Sol الفروق في السعر والتوافق.
إذا كنت تريد تصميم أحد مسارات الوكلاء هذه واختباره وإطلاقه لعملك، فاطّلع على أنظمة الذكاء الاصطناعي للإنتاج.
- آخر تحديث
- 30 سبتمبر 2026
- التصنيف
- AI
فضّل هذا الموقع في Google


اجعل omidsaffari.com مصدرًا مفضّلًا، وسيرفعه Google لك في Top Stories وAI Overviews وAI Mode.
مقارنة GPT-6.1 Sol و GPT-6 Sol: هل تستحق الترقية؟
مقارنة GPT-6.1 Sol و GPT-6 Sol في الأسعار والأداء والتوافق واستدعاء الأدوات، مع اختبار عملي يوضح متى تستحق الترقية ومتى يكون البقاء هو الخيار الأفضل.30 سبتمبر 2026AI
كيفية استخدام Claude Sonnet 5.5 بفاعلية
تعلّم كيفية استخدام Claude Sonnet 5.5 في مهام محددة، وضبط مستوى الجهد، والتحقق من المخرجات، ونقل تكامل API بأمان مع أمثلة عملية وتكلفة واضحة.28 سبتمبر 2026AI
مقارنة Jev وGLM-5.3-Flash: أيهما أنسب لاتخاذ القرار؟
مقارنة عملية بين Jev وGLM-5.3-Flash في تكلفة توجيه التذاكر، ودعم الصور، والسرعة، والدقة، مع خطة اختبار تساعدك على اختيار المسار الأنسب لعملك.27 سبتمبر 2026AI
Claude Opus 5.5 أم Opus 5: مقارنة التكلفة والأداء قبل الترقية
مقارنة عملية بين Claude Opus 5.5 وOpus 5 تشمل أسعار الرموز، وفورات التخزين المؤقت، أداء البرمجة، وتغييرات API التي يجب فحصها قبل الترقية بأمان.23 سبتمبر 2026AI
مقارنة GPT-6 Sol و GPT-6 Luna: متى يستحق Sol فرق السعر؟
مقارنة عملية بين GPT-6 Sol و GPT-6 Luna في السعر والأداء والبرمجة، مع قاعدة واضحة لاختيار النموذج الأرخص وتصعيد المهام الصعبة عندما تبرر النتائج فرق السعر.23 سبتمبر 2026AI
هل GPT-6 Luna مجاني؟ دليل الخطط والأسعار والحدود
هل GPT-6 Luna مجاني؟ نوضح عمليًا أين يتوفر بلا تكلفة لحسابات Free وGo، وما الذي تتطلبه خطط Work وCodex، وأسعار API وحدود الاستخدام غير المعلنة.22 سبتمبر 2026AI
Xiaomi MiMo عمليًا: إعداد MiMo V2.6 وبناء أول سير عمل
دليل عملي لاختبار Xiaomi MiMo في AI Studio، واختيار مفتاح API الصحيح، وتشغيل MiMo V2.6 Flash، ثم مقارنة التكلفة والأداء قبل ربط بيانات العملاء.22 سبتمبر 2026AI