AIエージェントでGPT-6.1 Solを使う:CodexとAPI実践設定
GPT-6.1 SolをAIエージェントやCodexで安全に使う設定を実践的に解説します。Responses APIへの移行、推論強度の選び方、ツール権限、実測トークンコスト、GPT-6 SolやAstraとの使い分け、固定評価による本番投入の判断まで、開発・運用チームが押さえる手順を具体例とともにまとめます。



軽量モデルには荷が重い一方、何も考えず毎回Astraへ回すほどではない――そんな難度が高く反復的な業務に、GPT-6.1 Solを組み込みます。AIエージェントの実践的な設定はシンプルです。Responses APIでgpt-6.1-solを使い、まずmediumから始め、業務に必要なツールだけを許可し、固定した合格基準を満たしてから本番へ昇格させます。このガイド用に新規のCodex実行で小さなJavaScriptユーティリティを作成し、4件のテストを書いてすべて合格させたところ、トークン料金だけをAPI換算したコストは$0.02816でした。
AIエージェント向けGPT-6.1 Sol:1分でわかる選び方
GPT-6.1 Solは、APIエージェント、Codex、有料のChatGPT Workプランですでに利用できます。通常のChatにはまだ提供されておらず、このモデル向けのUltrafastも発表済みではあるものの、まだ利用開始には至っていません。
Standard APIの料金は、入力100万トークンあたり$2、出力100万トークンあたり$10です。GPT-6 Astraはそれぞれ$10と$50です。製品の提供範囲は、OpenAIのローンチ発表でも確認できます。アクセス条件と料金を詳しく比較したい場合は、GPT-6.1 SolとGPT-6 Solの比較を参照してください。ここでは設定と運用上の判断に絞ります。
GPT-6.1 Solはどんなモデルか
GPT-6ファミリーは、実務を担うチームとして捉えるとわかりやすくなります。Astraは、特に難しく見解が割れる案件のために確保する専門家です。GPT-6.1 Solは、複雑な反復業務を継続して任せられるシニア担当者です。GPT-6 Solは、旧来のツール経路との互換性を保つ選択肢です。新モデルを万能のデフォルトと考えるより、この役割分担のほうが実用的です。
GPT-6.1 Solはテキストと画像を入力でき、テキストを出力します。コンテキストウィンドウは1,050,000トークン、最大出力は128,000トークンです。AIエージェントで真価を発揮するのは、対応するツール群です。Responsesでは、web search、file search、image generation、code interpreter、hosted shell、apply patch、skills、computer use、MCP、tool search、独自関数を利用できます。Responsesのツールガイドでは、許可されたツールのうち次に何を呼び出すかをモデル自身が判断しながら、APIでエージェントループを維持する仕組みを解説しています。
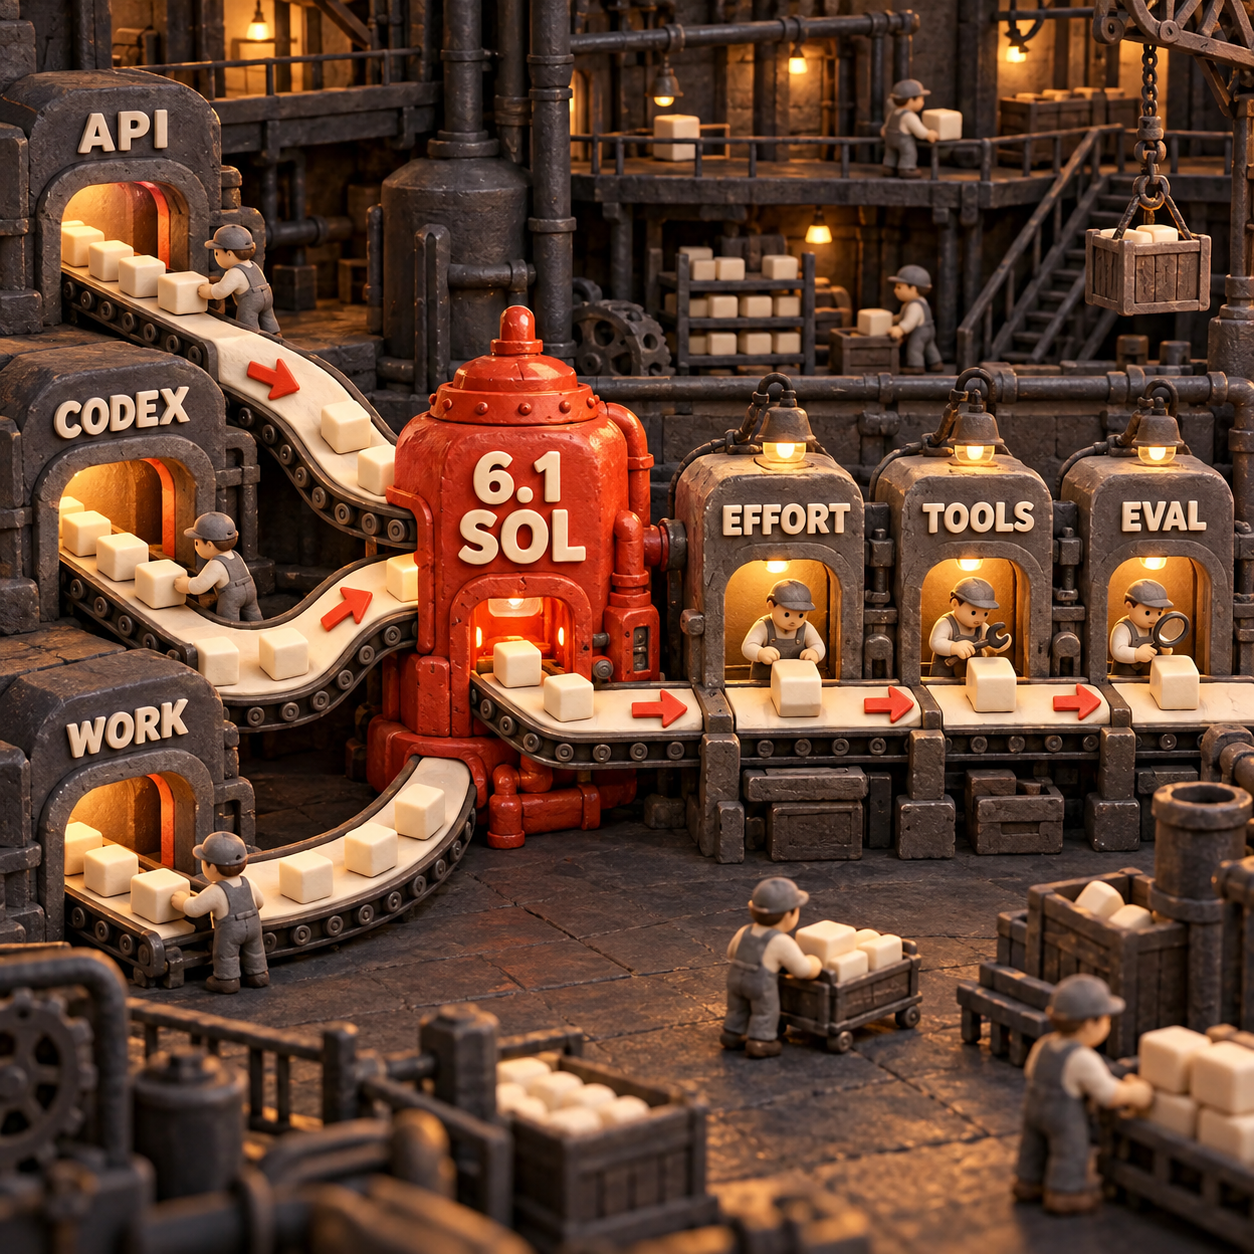
制約も同じくらい重要です。GPT-6.1 Solがツールを使えるのはResponses経由だけです。Chat Completionsは通常のリクエストなら受け付けますが、ツール呼び出しを伴うリクエストには対応しません。現在のエージェントがChat Completions経由で関数を呼び出している場合、モデルIDだけを差し替えても移行にはなりません。
Responses APIでの設定方法
最初は1つの経路と1つの合格基準に絞ります。モデルページに載っているからといって、すべてのツールを公開する必要はありません。調査担当ならweb searchとfile search、リポジトリ担当ならshellとpatchの権限が必要かもしれません。運用エージェントなら、2つの関数と承認境界だけで足りる場合があります。
実用に足る最小のJavaScriptリクエストは次のとおりです。
import OpenAI from "openai";

const client = new OpenAI();

const response = await client.responses.create({
  model: "gpt-6.1-sol",
  reasoning: { effort: "medium" },
  tools: [{ type: "web_search" }],
  input: "Find today's source for our target metric, cite it, and return one sentence."
});

console.log(response.output_text);モデルIDでSolを選び、reasoningオブジェクトで思考に使える処理量を指定します。tools配列は機能の利用を許可するものであり、使用を命令するものではありません。プロンプト側には、達成すべき結果、必要な根拠、停止条件を引き続き明記します。
既存のChat Completionsエージェントを移行するなら、変更は3点です。リクエストの送信先をResponsesに変え、型付きのoutput項目を解析し、会話状態をどう引き継ぐか決めます。この実装の詳細は、AstraのResponses移行ガイドで解説しています。
実案件5件を固定する
ワークフローですでに合格した例を選び、失敗例も1件含めます。プロンプト、入力、権限、合格基準はそのまま保存します。
mediumから始める
まずデフォルトの推論強度を使います。変える変数は一度に1つだけにし、モデルによる改善をプロンプトやツールの変更と混同しないようにします。
ツールを必要最小限に絞る
その経路に必要な検索、ファイル、関数、shell、computerの操作だけを許可します。書き込み操作には、明示的なポリシーと承認境界を設けます。
合格した実行のコストを記録する
新規入力、キャッシュ済み入力、出力、再試行、ツール料金、最終状態の合否を記録します。安くても失敗した実行は節約になりません。
根拠に基づいて振り分ける
合格できる処理はSolに残します。難しい残余だけをAstraへ上げます。呼び出し側を変更するまでは、互換性のない経路をGPT-6 Solに残します。
業務に合わせた推論強度の選び方
大半のエージェント業務では、最初に選ぶべき設定はmediumです。GPT-6.1 Solではlow、high、xhigh、maxも指定できます。一方、noneとminimalは受け付けません。どちらかを使っている既存経路では、動作とレイテンシーを意図的に検証する必要があります。OpenAIの推論強度ガイドも、効率的な実行から最大限の推論へ進む同じ考え方を示しています。
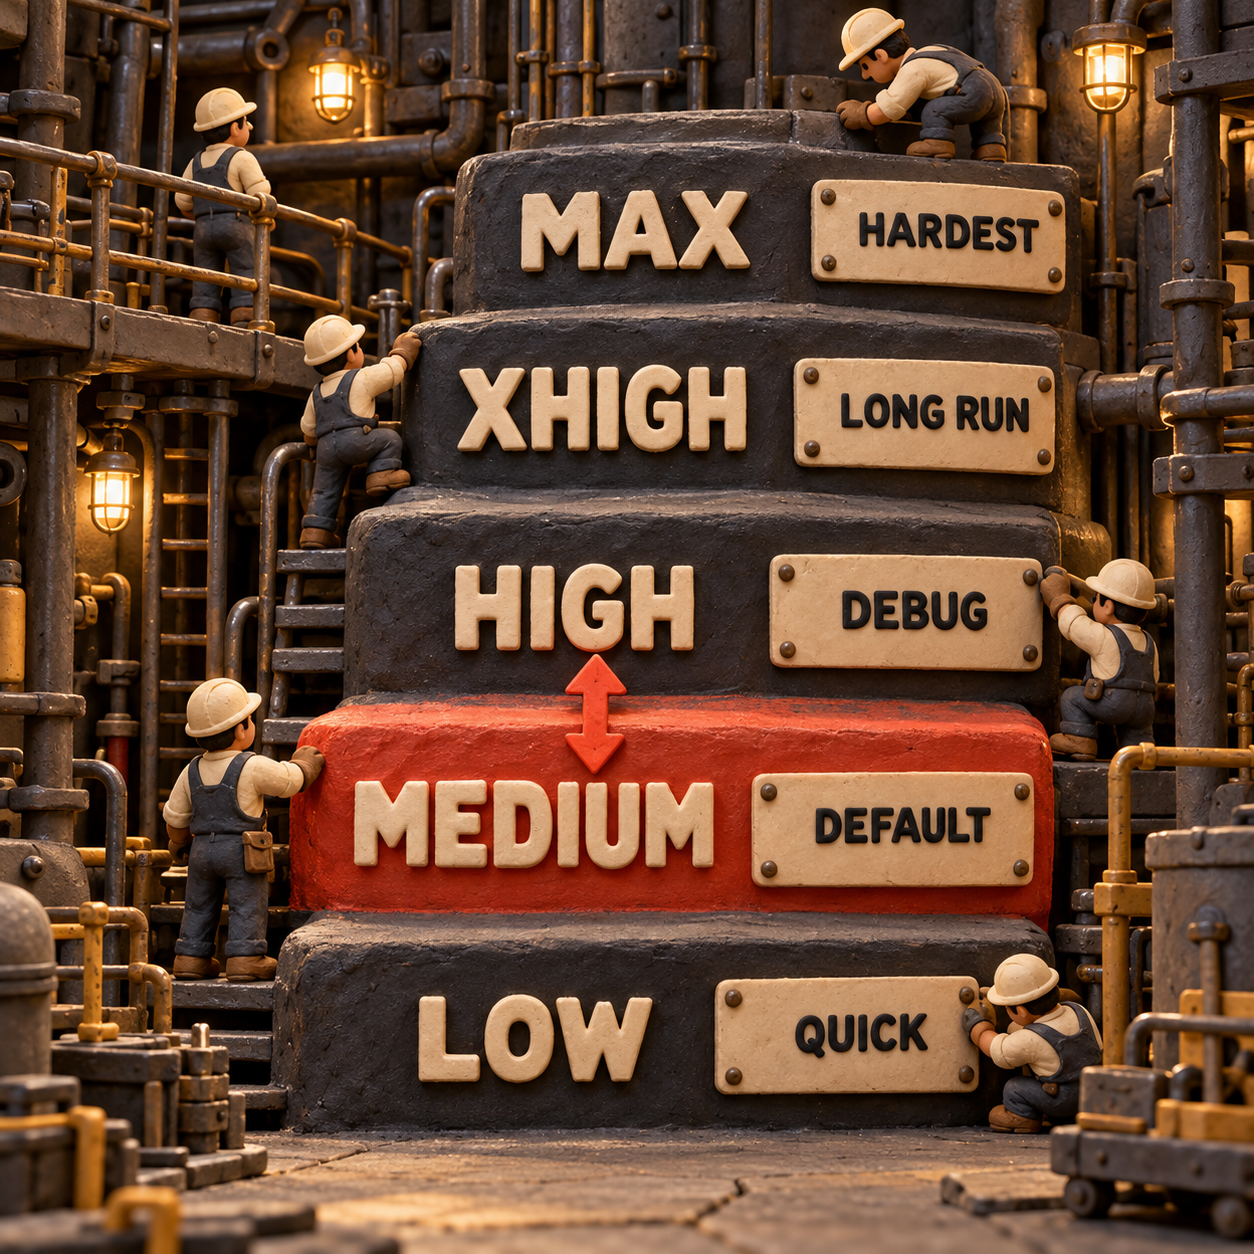
似た名前の3つは、それぞれ別の設定を指します。maxはAPIの推論強度です。CodexのUltraは、作業をサブエージェントへ分割するマルチエージェントモードです。Ultrafastは速度モードであり、GPT-6.1 Solへの対応は今後提供される予定です。すでに使える前提でUltrafastの予算やローンチ計画を立ててはいけません。
GPT-6.1 Solの実タスクとトークンコスト
小規模な実行を見ると、見出し上の料金より実態に近い経済性がわかります。low推論のGPT-6.1 Solに、Codexで次の作業を依頼しました。依存関係のないJavaScriptのslugify関数を作成し、前後の空白、単語間の空白、句読点、大文字・小文字の混在を対象にnode:testのテストを正確に4件追加し、テストを実行して失敗があれば修正する、という内容です。
モデルはslugify.jsとslugify.test.jsを作成し、node --test slugify.test.jsを実行しました。結果は4件合格、0件失敗です。記録された使用量は入力57,578トークンで、そのうち48,640トークンがキャッシュ済み、出力は542トークンでした。したがって、新規入力料金の対象になったのは8,938トークンだけです。
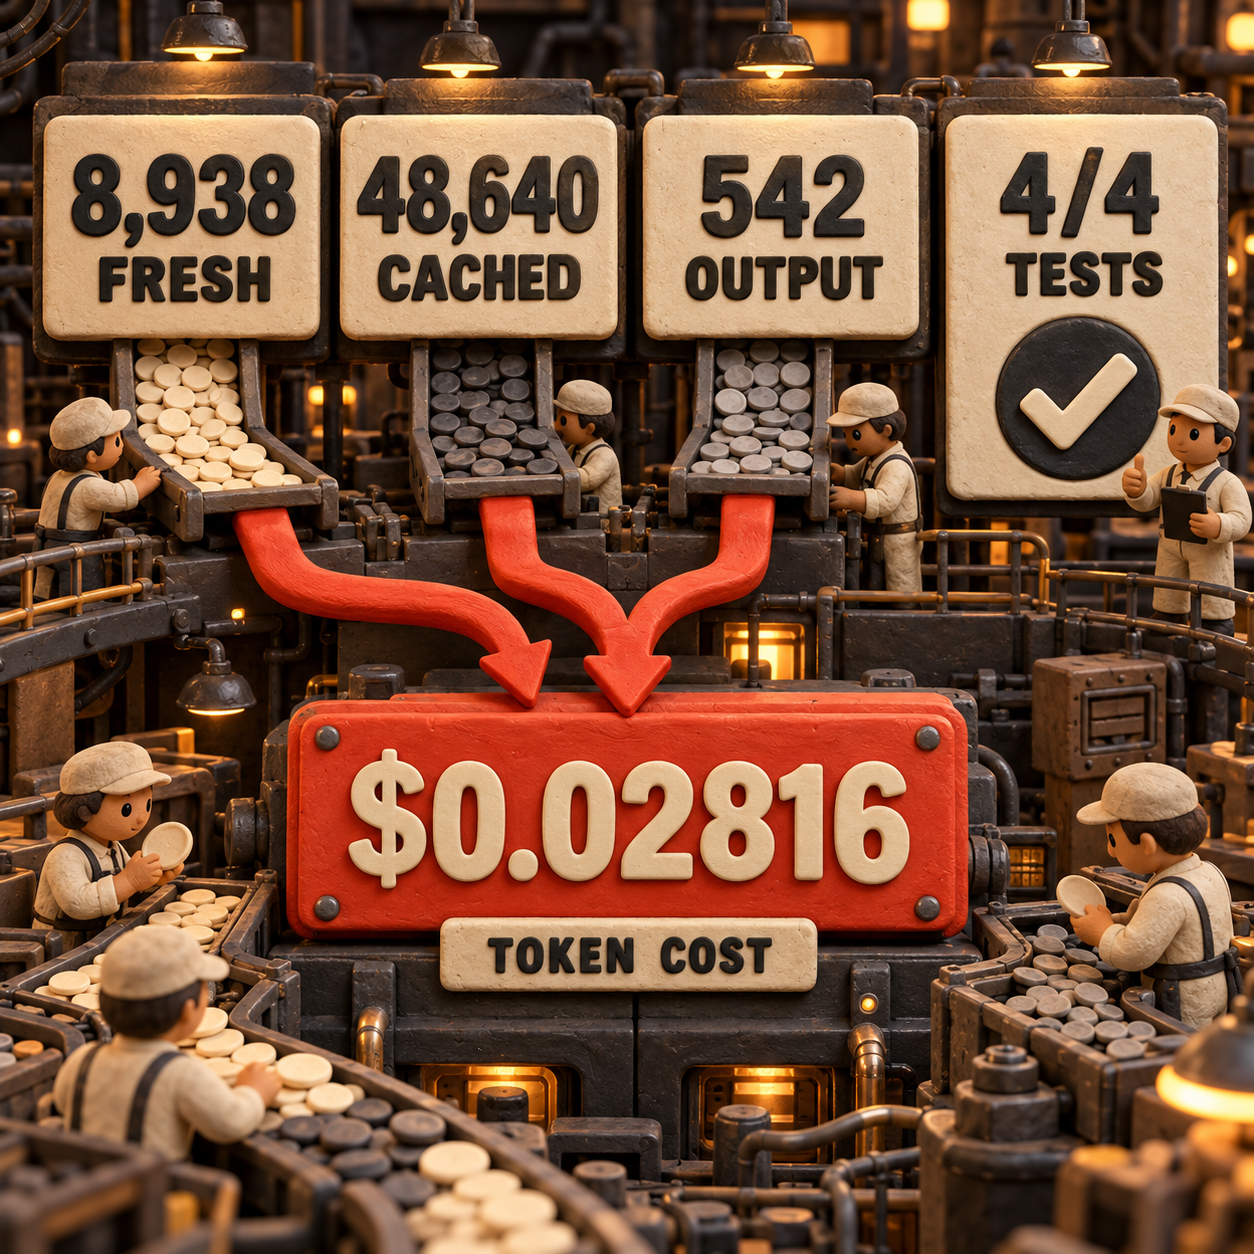
これは実際のCodex実行だったため、API請求ではなくプランの利用枠を消費しました。$0.02816は、実際のトークン構成にGPT-6.1 Solの公開Standard API料金を当てた正確な換算額です。有料のホステッドツール料金は含みません。同じ構成で10,000回実行すると、モデルのトークン料金は$281.60になります。トークン構成が変わらないと仮定した場合、Astraの料金では$1,651.20です。このAstraとの比較は単価に基づく計算であり、Astraが同じトークン数を使うという主張ではありません。
ここから得るべき教訓は、小さなpatchなら必ず3セントで済むということではありません。エージェントのランタイム、ツール定義、指示、履歴は、画面に見える依頼文より大きくなる場合があります。キャッシュ済みコンテキストと再試行を含め、合格した実行全体を測定してください。
Solが特に向いている7つの業務
最も恩恵を受けるのは、難しい作業を繰り返すチームです。運用上の価値が高い順に並べると、次のようになります。
Solを導入しても、承認設計、決定論的なチェック、可観測性は不要になりません。そうした仕組みの実行役を、Astraより低いトークン単価で高性能なモデルに任せられる点が利点です。
構築する価値がある3つのプロダクト
1. コーディングエージェント向けSol移行テストベンチ
最も有望な機会です。米国ではai powered coding agentが月間約8,100回検索されており、商用意図があります。チームが必要としているのは、曖昧なモデル比較表ではありません。同じプロンプト、ツール、チェック条件で、リポジトリの作業がgpt-6-sol、gpt-6.1-sol、Astraのどれに合格するかを知ることです。
販売可能な最小構成は、CLIとCIアクションです。チームが5つのJSONフィクスチャ、合否判定コマンド、許可するツールを指定します。テストベンチは各モデルを実行し、合格結果、レイテンシー、新規・キャッシュ済みトークン、再試行、コストを記録して、昇格判断を出力します。ただし、汎用的な評価ランナーは模倣されやすいものです。競争力の源泉になるのは、実践的なコーディング用フィクスチャ、連携機能、役に立つ失敗診断の蓄積です。
2. 運用エージェント向け推論強度・コストルーター
米国ではai workflow automationが月間約1,000回検索され、商用意図があり、CPCは$37.80です。この市場が求めているのは、新しいチャット画面ではなく、完了した仕事です。ルーターを使えば、範囲が明確な案件はlow、通常の複数ステップ作業はmedium、難しい失敗はhighへ送り、それでも解決しない残余だけをAstraに回せます。
MVPに必要なのは、1つのキュー、3つの推論強度ポリシー、1つの合否判定関数、支出ダッシュボードです。すでに複数の自動化へ費用を払っている運用チームに販売できます。ただし、過信は禁物です。安価なルーターでも、重大な案件を1件誤分類すれば節約分が消えかねません。初日から、再実行可能なフィクスチャと手動オーバーライドを用意する必要があります。
3. 文書エージェント向け合否判定レイヤー
ai document analysisの米国での月間検索数は約1,000回で、CPCは$10.44です。作るべきなのは、また別の「アップロードして要約する」画面ではありません。文書エージェントが必須項目をすべて見つけたか、引用を保持したか、合計を照合したか、不確実な点をエスカレーションしたかを確認する検証レイヤーです。
最小構成では、ベンダー契約書や月次財務PDFのような反復的な文書パック1種類を、固定スキーマと例外キュー付きで扱います。反復分析はGPT-6.1 Solが担当し、Astraには見解が割れた案件や不完全な案件だけを送ります。ただし、分野への特化は避けられません。広すぎる水平型プロダクトは凡庸に見えますが、信頼できるチェックを備えた狭い文書パックなら信用を獲得できます。
GPT-6 Solを残す場面とAstraに投資する場面
互換性が制約になる場合は、GPT-6 Solを残します。GPT-6 Solは引き続きnone推論を受け付け、reasoning_effortがnoneならChat Completions経由で関数を呼び出せます。GPT-6.1 Solではできません。こうした挙動に依存する安定稼働中の経路は、モデルを変更する前にAPI経路を移し、回帰テストへ合格させる必要があります。
トークン料金より最高品質の結果が重要なら、GPT-6 Astraを選びます。OpenAIは、最も難度の高い推論、コーディング、computer use、調査、文書作成に最も高性能なモデルと説明しています。固定評価で明確な改善が確認できる、曖昧で価値の高い最難関部分に使います。Standard料金は、Astraが100万トークンあたり入力$10、出力$50であるのに対し、GPT-6.1 Solは入力$2、出力$10です。
GPT-6.1 Solが担うのは、その間の大きな領域です。Responsesを基盤とし、繰り返し発生し、成功条件を測定できる本格的な業務に適しています。OpenAIが公開したローンチ時の評価では、複数の難しいワークロードでGPT-6 Solを上回っていますが、これはベンダー自身による評価です。本番投入の基準にすべきなのは、自社の合格率です。
設定を左右する制約
GPT-6.1 Solですべての経路を置き換えられるわけではありません。noneとminimalの推論強度、Chat Completions経由のツール呼び出し、fine-tuningには対応していません。音声・動画入力も扱えず、ローンチ時点では通常のChatにも提供されていません。有料ツールには別料金が発生します。入力が272,000トークンを超えるリクエストでは、そのリクエスト全体に長大コンテキスト向けの高い料金が適用されます。1,050,000トークンのウィンドウを、無料の作業領域と考えるべきではありません。
Ultrafastも、正直に伝えるべき制約です。OpenAIはCodexで標準速度の最大8xとなるトークン生成を発表しましたが、提供予定の機能と説明しています。自分のアカウントとクライアントで利用可能になるまでは、StandardまたはFastを前提に計画し、実際に得られるレイテンシーを測定してください。
月曜日に実行すること
現在のエージェントが最近完了した業務を5件選びます。内訳は、簡単な成功例1件、通常タスク2件、ツールを多用するタスク1件、既知の失敗例1件です。プロンプトや権限を変えず、同じフィクスチャをGPT-6.1 Solのmediumで実行します。合否、経過時間、新規入力、キャッシュ済み入力、出力、再試行、ツール料金を記録してください。
そのうえで、勝者を宣言するのではなく処理を振り分けます。範囲が明確な作業は、lowでも合格するなら下げます。より深い推論が必要な失敗だけをhighで試します。互換性に縛られる呼び出し元はGPT-6 Solに残します。高コストな残余をAstraへ送るのは、合格率の向上が料金に見合う場合だけです。これならモデルへの感想ではなく、今週中に本番運用の判断を下せます。
よくある質問
GPT-6.1 Solとは何ですか?
GPT-6.1 Solは、複雑なコーディング、computer use、専門業務向けのOpenAIの低コストモデルです。API IDはgpt-6.1-solで、ツール呼び出しにはResponses APIを使います。
AIコーディングエージェントとは何ですか?
AIコーディングエージェントは、設定した権限の範囲内でリポジトリを調査し、ファイルを編集し、コマンドとテストを実行して結果を報告できます。価値の単位は、生成したコードそのものではなく、テスト済みの成果です。
ChatGPTにコーディングエージェントはありますか?
あります。CodexはOpenAIのコーディングエージェントで、有料プラン向けの展開ではGPT-6.1 Solを利用できます。このモデルはChatGPT Workでも提供されていますが、通常のChatではまだ利用できません。
GPT-6 Solのほうが安いですか?
新規入力と出力については安くありません。どちらのSolモデルも、Standardでは100万トークンあたり入力$2、出力$10です。キャッシュ済み入力の単価はGPT-6.1 Solのほうが低く設定されています。料金と互換性の違いは、Solの詳細比較で解説しています。
これらのエージェント経路をビジネス向けに設計、検証、導入したい場合は、AIプロダクションシステムをご覧ください。
- 最終更新
- 2026年9月30日
- カテゴリー
- AI
Googleでこのサイトを優先する


omidsaffari.comを優先ソースに設定すると、GoogleがTop Stories・AI Overviews・AI Modeであなたのために優先表示します。
GPT-6.1 Solを徹底比較:GPT-6 Solとの料金・性能・移行条件
GPT-6.1 SolとGPT-6 Solを、料金、キャッシュ単価、ベンチマーク、API互換性で比較。Chat Completionsのツール呼び出しや推論設定による移行条件、切り替え前に行う5つの固定テスト、キャッシュを多用する業務での選び方まで実務目線で分かりやすく解説します。2026年9月30日AI
Claude 使い方ガイド:Sonnet 5.5の実践手順
Claude Sonnet 5.5を実務で使う手順を、Mediumエフォートの設定から検証可能なワークフロー、料金、Claude API移行の注意点まで解説します。サポート要約の実測をもとに、向いている仕事、エフォートの選び方、もっともらしい誤推論を防ぐ確認方法、製品化の機会を具体的に整理しました。2026年9月28日AI
Jevを選ぶべきか?GLM-5.3-Flashと料金・精度・画像対応を比較
JevとGLM-5.3-Flashを、料金、精度、レイテンシ、画像対応、機密処理の観点から比較します。低コストのテキスト分類に強いJevと、マルチモーダル処理に強いPrivatemode Decisionsの選び分け、30件の共通テストで導入前に検証する手順まで具体的に解説します。2026年9月27日AI
Claude Opus 5を5.5へ移行すべきか:料金・性能・APIの判断基準
Claude Opus 5とOpus 5.5を、料金、コーディング評価、API互換性、Thinking仕様から比較します。入力・出力単価とキャッシュ料金を整理し、ツールの強制選択、Computer Use、進捗表示など、移行前に確認すべき5項目と実運用での選び方をわかりやすく解説します。2026年9月23日AI
GPT-6 Sol Luna 比較:20倍の価格差で選ぶべきモデル
GPT-6 SolとLunaは同じツールとコンテキスト枠を備えながら、料金は20倍違います。100件の基準タスクで$9と$0.45になるコスト差、DeepSWEの2.2ポイント差、レビュー負担を含む損益分岐点を整理し、Lunaを標準にしてSolへ切り替える条件を具体的に解説します。2026年9月23日AI
GPT-6 Luna 無料利用ガイド:対象プラン・API料金・制限
GPT-6 Luna 無料利用はどこまで可能なのか。Free・Go向けデスクトップアプリ、通常のChat、Work、Codex、APIの提供条件を比較します。入力100万トークン$0.10からのAPI料金、未公表の利用上限、契約前に試す確認手順まで、リリース時点の情報を分かりやすく整理しました。2026年9月22日AI
MiMo AIの使い方:V2.6 APIを業務で動かす実践ガイド
MiMo AI(MiMo-V2.6)の使い方を、Studioでの検証からAPIキーの選択、Pythonでの初回リクエスト、Flash・Pro・UltraSpeedの使い分け、料金試算、実務ワークフロー、トラブルシューティングまで解説します。Xiaomi APIを安全に業務へ導入するための実践ガイドです。2026年9月22日AI