Claude 使い方ガイド:Sonnet 5.5の実践手順
Claude Sonnet 5.5を実務で使う手順を、Mediumエフォートの設定から検証可能なワークフロー、料金、Claude API移行の注意点まで解説します。サポート要約の実測をもとに、向いている仕事、エフォートの選び方、もっともらしい誤推論を防ぐ確認方法、製品化の機会を具体的に整理しました。



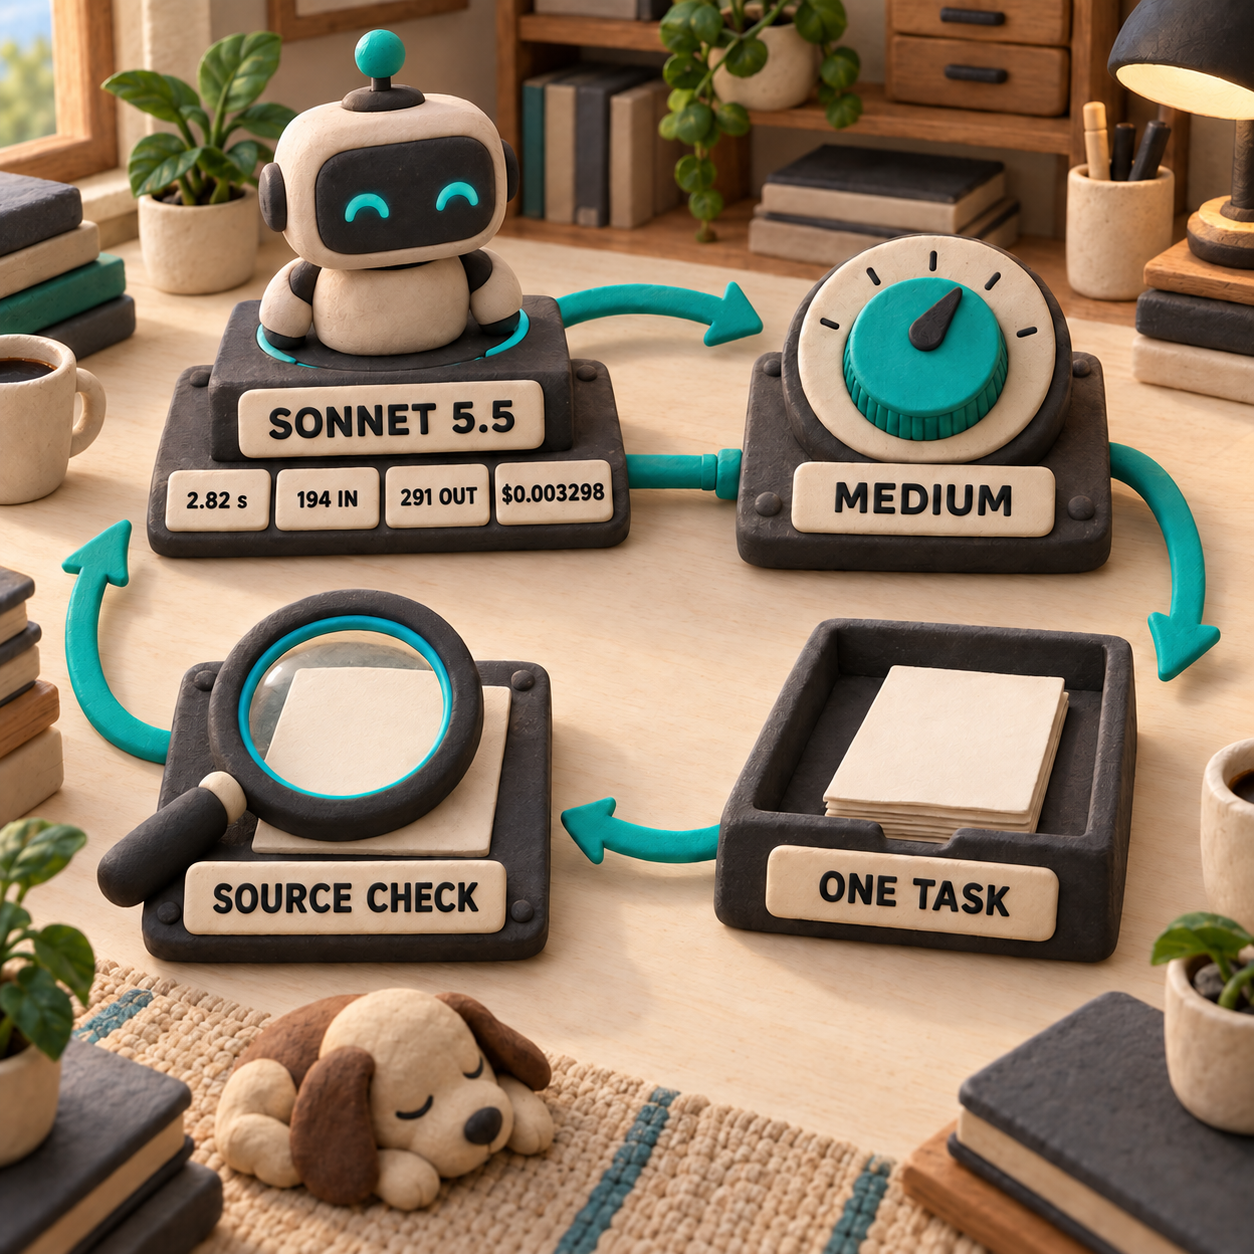
Claude 使い方の基本は、まず検証しやすい範囲のタスクを一つ選び、Claude Sonnet 5.5をMediumエフォートで試すことです。たとえば、サポートチケットの要約やクライアント向けブリーフが向いています。ローカル環境で合成サポートチケットを処理したところ、応答時間は2.82秒、入力は194トークン、出力は291トークンで、料金は$0.003298でした。チケットの重要な事実は保たれましたが、元の情報にはない、もっともらしい対応策まで補われていました。ここが実務上の要点です。Sonnet 5.5なら下書きのコストを極めて低く抑えられますが、検証作業まで不要になるわけではありません。
Claude 使い方の基本:まずはMediumで一つのタスクから
最短で役立つ形を試すなら、Claudeアプリから始めます。Sonnet 5.5を選択し、エフォートがMediumになっていることを確認したうえで、資料を一式だけ渡し、各行を検証できる形式で出力するよう依頼します。
AnthropicのアプリとClaude Codeでは、Mediumがデフォルトです。一方、Claude PlatformのデフォルトはHighなので、APIユーザーはレベルを明示的に指定する必要があります。サポート要約、クライアント向けブリーフ、定型分析、要件が明確なツール作業を初めて試すなら、Mediumが適しています。最低設定まで落とさずに、短いフィードバックループを維持できるからです。
Sonnet 5.5を選ぶ
Claudeで新しいチャットを開きます。送信ボタンの横にあるモデル名をクリックし、Sonnet 5.5を選んでから、Effortメニューを開きます。最初の一覧にモデルが表示されない場合は、More modelsをクリックします。Enterprise管理者は、表示するモデルやエフォートレベルを制限できます。
最初はMediumのまま試す
範囲が明確な業務タスクでは、エフォートをMediumにします。より深い判断、長い作業工程、厳格な検証が必要な場合に限り、Highへ上げます。自社の検証で品質を維持できると確認できた後なら、Lowも選択肢になります。
資料と出力形式を指定する
チケット、通話記録、文書一式のいずれか一つを貼り付けます。読み手と必須項目も明示します。サポートチケットなら、Issue、Impact、Evidence、Next actionの四項目だけを箇条書きで出すよう依頼します。さらに「事実を作らないこと。推論には必ず印を付けること」と加えます。
元資料と照合する
氏名、数値、原因、約束、推奨対応をすべて入力内容と照らし合わせます。もっともらしく聞こえても、裏付けのない助言は削除します。自社の業務から複数の事例を使って合格を確認してから、プロンプトを保存します。
テストに使った合成チケットには、ログイン用ドメインの変更後に六人のサポート担当者がロックアウトされ、二人はログイン状態を維持していたこと、「Invalid organization」というエラーが出たこと、ユーザーレコードにはすでに新しいドメインが登録されていたことが記載されていました。Sonnet 5.5はこれらの詳細を保ち、四項目の形式にも従いました。ただし、組織のマッピングが旧ドメインを参照している可能性が高いと推測し、ある修正案については影響が小さいとも述べました。どちらもチケットにはない情報です。
モデル単体の料金計算は単純です。Anthropicの公表料金では、入力194トークンが$0.000388、出力291トークンが$0.00291で、合計は$0.003298です。10,000回の呼び出しがすべて同じトークン構成なら、モデル単体の費用は$32.98になります。ただし、これは10,000件のチケットを解決する費用ではありません。モデル呼び出しの周囲には、検索、連携、再試行、ストレージ、監視、人によるレビューの費用も発生します。
Claude Sonnet 5.5とは
Sonnet 5.5は、Anthropicの5.5ファミリーに属する高速な汎用モデルです。要件が定まった業務を日常的に担うのがこのモデルであり、答えが一意に定まらず、高度な判断を要する場面で起用する上級スペシャリストがOpus 5.5だと考えると分かりやすいでしょう。
今回のリリースはSonnet 5とは別物です。Claude APIで直接指定するIDは、日付サフィックスのないclaude-sonnet-5-5です。テキストと画像を入力でき、出力はテキストです。コンテキストウィンドウは100万トークン、最大出力は128,000トークンです。前モデルの料金やトークナイザーの前提を確認したい場合は、Claude Sonnet 5のレビューを参照してください。
Anthropicによると、Sonnet 5.5はSonnet 5より30%以上高速に出力し、同社のテストでは、完了したタスク当たりのコストを最大30%抑えられます。後者はトークン単価が下がったという意味ではなく、作業完了までに使うトークンが減ったという主張です。料金はSonnet 5から変わっていません。
ベンチマークの数値もAnthropicによるものです。Terminal-Bench 4.0ではSonnet 5.5が70.6%、Sonnet 5が10.3%、CursorBench 4.0ではそれぞれ55.5%と34.1%だったと報告されています。新モデルを試す根拠にはなりますが、自社のチケットポリシー、コードベース、文書テンプレートで合格できるかまでは分かりません。Anthropicのリリースレポートでも、ベンチマークスコアと、答えの定まらない業務で判断を持続できるかは区別されています。
間違えた場合の損失でエフォートを選ぶ
エフォートは、品質、待ち時間、トークン消費を調整する設定であり、文章の長さを指定するものではありません。高くすればモデルが推論や確認に使える余地が増えますが、待ち時間と料金も増える可能性があります。短い回答が必要なら、エフォートとは別にプロンプトで指定します。
AnthropicはSonnet 5.5向けに各レベルを再調整しています。そのため、このモデルのMediumは、Sonnet 5のMediumと同じ思考量ではありません。自社の事例でもう一度比較してください。ラベルが同じという理由だけで、以前の設定を引き継ぐべきではありません。
短期で成果につながりやすい七つのワークフロー
有効な用途には三つの共通点があります。入力資料を用意できること、求める出力形式が明確であること、そして人またはルールで結果を検証できることです。
1. サポートチケットの振り分け
サポート業務の責任者は、顧客からの問い合わせ、アカウント状態、直近のチケット履歴、エスカレーションポリシーをまとめて入力できます。Sonnet 5.5は、問題、影響、根拠、不足情報、次に許可される対応を整理して返せます。振り分けや引き継ぎ前の読み直しを減らせるのが利点です。ただし、アカウントを変更する助言、返金、約束、根本原因に関する主張は、人が確認する必要があります。
最初に試す用途として特に優れているのは、各出力を特定の入力項目までたどれるからです。モデルの誤りも早く見つかります。主張の出典を示せない要約は、まだアクションを起こせる段階ではありません。
2. 商談前のクライアント向けブリーフ
アカウント責任者は、最新の通話記録、作業範囲記述書、未完了タスク、契約更新メモを渡せます。決定事項、約束、リスク、未解決の質問、次回会議の議題を一ページにまとめるよう依頼します。毎回白紙から作る代わりに、一定の形式でブリーフを準備できるのが利点です。
「確認済み」と「推論」を別のセクションに分けてください。この区別だけでも、モデルのもっともらしい解釈が顧客への約束に変わるのを防げます。
3. プルリクエストのレビュー
エンジニアリング責任者は、コード差分、リポジトリの規約、セキュリティ・テスト・後方互換性のチェックリストを渡せます。Sonnet 5.5は、リスク順に整理した一次レビューとテスト案を作成できます。レビュー担当者が変更内容をすばやく把握できるのが利点であり、自動承認が目的ではありません。マージの可否は、システムに責任を持つ人が決めるべきです。
4. 範囲を限定したバグ修正
再現可能なバグであれば、プロダクトエンジニアは不具合の挙動、関連ファイル、受け入れ条件を渡せます。要件が明確な修正は、Mediumエフォートから始めるのが妥当です。複数のサービスにまたがる問題や、最初の実行で検証を飛ばした場合はHighへ上げます。受け入れ条件で作業の拡大を防ぎつつ、実装とテストの反復を短くできるのが利点です。
5. 経営レビューと取締役会資料の下書き
財務・業務チームは、元資料と承認済みのスライドまたは文書テンプレートを渡せます。Sonnet 5.5は、構造化されたレビューの下書きを作り、不足を洗い出し、初稿の体裁を整えられます。Anthropicも、仕上がりの整った文書、スライド、スプレッドシートを用途として明示しています。資料の組み立て作業を減らせますが、財務上の主張には必ず元のセルまたは文書への参照が必要です。
6. インシデント要約
インシデント責任者は、発生時系列、アラート、実施した対応、担当者のメモを入力できます。確認済みの出来事、仮説、顧客への影響、未解決の質問、フォローアップを別々のブロックにするよう依頼します。引き継ぎと事後報告の下書きが整理されるのが利点です。相関関係を根本原因へ格上げさせないでください。
7. ビジュアルQAとインターフェース改善
プロダクトデザイナーやフロントエンドエンジニアは、スクリーンショットにブランドルールと受け入れチェックリストを組み合わせて渡せます。Sonnet 5.5は、不整合を見つけ、修正の優先順位を付け、範囲を限定した改善の実装を支援できます。目に見える不具合をすばやく反復改善できるのが利点です。ただし、デザイン上の判断、アクセシビリティテスト、プロダクトの最終判断は人が担います。
構築する価値がある三つのプロダクト
モデルをそのまま使えるだけでは、事業にはなりません。販売できるプロダクトには、独自のコンテキスト、制御されたワークフロー、根拠、そして人が最終判断を下す場所が必要です。
1. 根拠をひも付けるサポート振り分け:最有力の機会
チケットとアカウント情報を構造化された要約へ変換し、すべての主張に出典リンクを付け、提案する対応をポリシーと照合し、承認待ちの下書きとして並べるサポートコパイロットを構築します。サポート責任者や外部委託のサービスチームにとって、より速く一貫した振り分けには対価を払う価値があります。
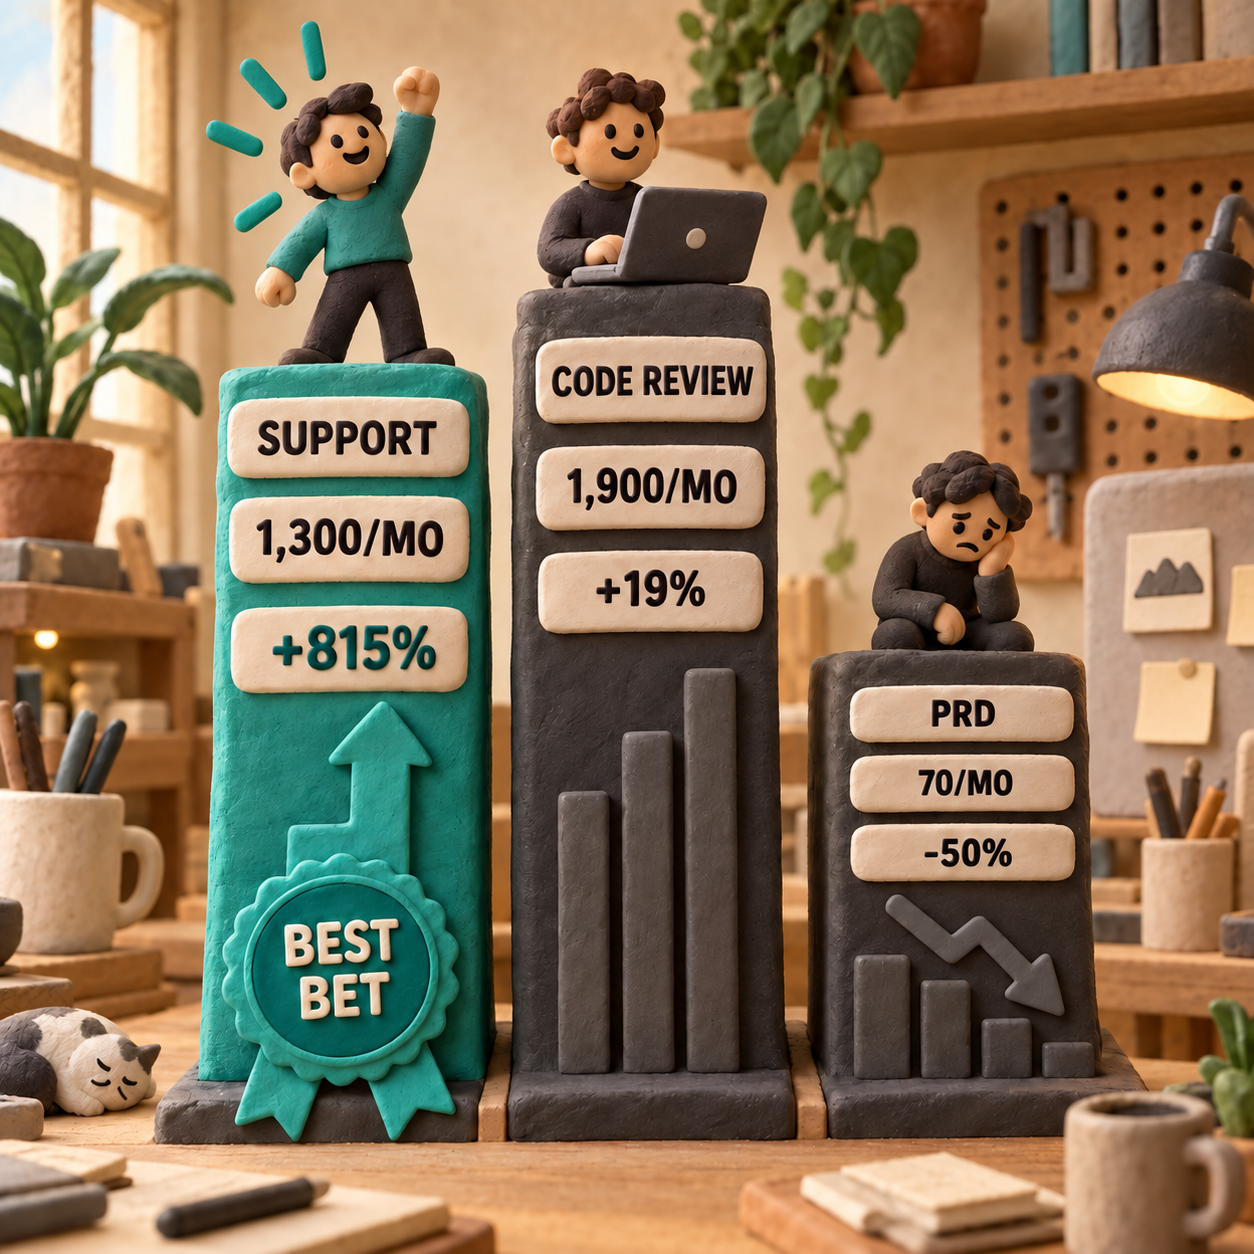
需要は数字にも表れています。ai customer service agentは、この調査のキーワードデータで米国の月間検索数が1,300、検索意図はcommercial、前年比成長率は815%でした。IntercomのFinは、outcome当たり$0.99です。解決済みのoutcomeは要約の呼び出しより大きな仕事なので単純比較はできませんが、サポート自動化に従量課金を受け入れる買い手がすでにいることは分かります。
販売可能な最小構成には、受信トレイ用コネクター一つ、アカウントデータ用コネクター一つ、四項目の要約、出典、ポリシーチェック、承認または却下の操作が必要です。難所は連携と信頼です。推奨の根拠を証明できなければ、顧客は既存のワークフローを使い続けます。
2. ポリシーを理解するコードレビュー層
コード差分とチーム固有のルールを読み、リスク順のレビュー、テストの不足、短いマージ用ブリーフを返すGitHubアプリを構築します。買い手は、エンジニアリングマネージャーやプラットフォームチームです。
ai powered code review platformは、米国の月間検索数が1,900、前年比成長率は19%です。CodeRabbitの公開料金は、年払いで開発者当たり月額$24から始まり、上位プランは$48と$72です。MVPに必要なのは、リポジトリプロバイダー一つ、プルリクエストのWebhook、カスタムチェック、コメント画面、各指摘を発火させたルールが分かる監査証跡です。
競争の激しさが課題です。汎用レビュー機能だけでは、守れる優位性になりません。規制対象リリースの確認、データ移行の安全性、特定フレームワークなど、痛みの強いニッチを選び、見逃しと同じ厳密さで誤検知も測定してください。
3. 業界特化のブリーフ生成ツール:ただし汎用品は避ける
通話、制約、過去の決定事項を、受け入れ条件と未解決の質問を含むプロダクトブリーフへ変換する、用途を絞ったワークフローを構築します。テンプレートが実務に合えば、プロダクトコンサルティング会社や業界特化型ソフトウェアチームが購入候補になります。
完全一致キーワードのai product requirements document generatorは、米国の月間検索数がわずか70で、前年比50%減です。これは売り文句ではなく、警告です。汎用の独立したPRDジェネレーターは、ここで最も弱い機会です。成立し得るのは、エージェンシーの要件整理、医療分野の導入支援、企業の変更管理など、より価値の高いワークフローに組み込む場合です。
MVPは、固定された資料一式、方針の明確なテンプレート一つ、意思決定の追跡可能性、買い手が現在使うシステムへのエクスポートで構成します。需要の薄さと模倣の容易さが課題です。すでに顧客との関係または業界固有のデータ経路を持っていない限り、構築すべきではありません。
単価は据え置きでも、ワークフロー全体の費用は下がり得る
Sonnet 5.5の料金は、100万入力トークン当たり$2、100万出力トークン当たり$10、100万キャッシュ読み取りトークン当たり$0.20です。Sonnet 5と同じ公表料金です。Anthropicが費用低減をうたう根拠は、より少ないトークンでタスクを完了できる点にあります。
予算を立てる際は、この違いが重要です。モデルの処理過程が短くなれば、料金表が変わらなくても、待ち時間とトークン費用をどちらも減らせます。一方、検索、外部ツール、再試行、人によるレビューが費用の大半を占めるなら、プロダクト全体のコストはほとんど変わらない可能性があります。一回の呼び出しではなく、採用された出力一件当たりの費用を測定してください。
ClaudeアプリのサブスクリプションとAPI利用は別の商品です。Pro、Max、Team、Enterpriseの料金を支払っても、Claude ConsoleやAPIの利用料は含まれません。一般的なプランの範囲はClaudeのプランガイドで確認できます。APIワークフローには、別途Consoleへのアクセスと従量課金が必要です。
タスクの合格後にClaude APIワークフローを移行する
安全な移行手順は明快です。代表的な事例でプロンプトを検証し、新しいモデルIDを固定し、エフォートを明示してから、thinkingとツール呼び出しの契約を修正し、本番トラフィックを流します。
adaptive thinkingを使う通常のリクエストでは、thinkingフィールドを省略し、テキストブロックをtypeごとに読み取ります。
from anthropic import Anthropic

client = Anthropic()
response = client.messages.create(
    model="claude-sonnet-5-5",
    max_tokens=4096,
    output_config={"effort": "medium"},
    messages=[{
        "role": "user",
        "content": "Summarize this ticket as Issue, Impact, Evidence, and Next action.",
    }],
)

for block in response.content:
    if block.type == "text":
        print(block.text)
移行時には、次の四点を意識して確認してください。
thinking: {"type": "disabled"}は、AnthropicのClaude APIへ直接送る場合、すでに受け付けられません。事前のthinkingを行わない場合はthinking: {"type": "between_tools"}を使います。Low、Medium、Highでは動作しますが、XhighまたはMaxでは使えません。tool_choiceでanyまたは名前付きtoolを強制する指定は、直接APIでは受け付けられません。autoを使い、対応している場合はスキーマをstrictにし、ツールを実行すべき条件をプロンプトで伝えます。- 応答の先頭が
thinkingブロックになる場合があります。すべてのcontentブロックをtypeで判定し、content[0].textが必ず存在するとは考えないでください。 - ツールループでは、thinkingブロックを変更せずに返します。以前の会話に結び付いた署名を含むため、メッセージ履歴は追記のみで維持します。
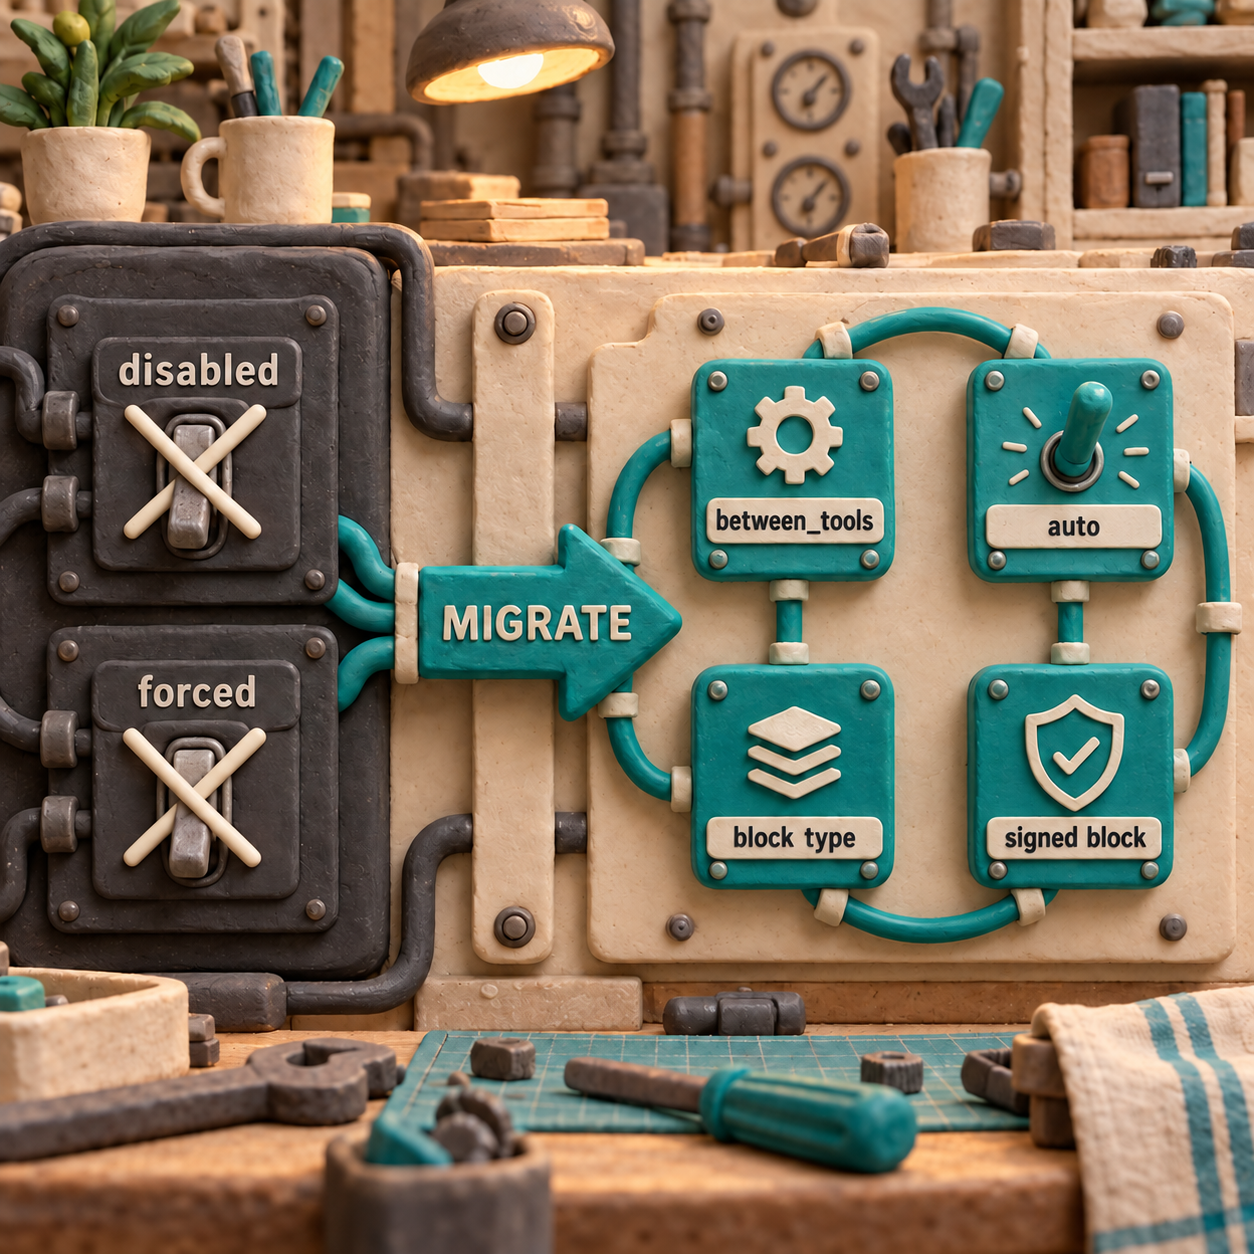
次の最小構成ではbetween_toolsを使い、tool choiceをautoに保ち、assistantの応答全体を保持しています。
tools = [{
    "name": "lookup_ticket",
    "description": "Look up a support ticket",
    "strict": True,
    "input_schema": {
        "type": "object",
        "properties": {"ticket_id": {"type": "string"}},
        "required": ["ticket_id"],
        "additionalProperties": False,
    },
}]

messages = [{"role": "user", "content": "Use lookup_ticket for T-42."}]
response = client.messages.create(
    model="claude-sonnet-5-5",
    max_tokens=4096,
    thinking={"type": "between_tools"},
    output_config={"effort": "medium"},
    tools=tools,
    tool_choice={"type": "auto"},
    messages=messages,
)

# Keep every block, including signed thinking blocks, exactly as returned.
messages.append({
    "role": "assistant",
    "content": [block.model_dump() for block in response.content],
})

tool_call = next(block for block in response.content if block.type == "tool_use")
messages.append({
    "role": "user",
    "content": [{
        "type": "tool_result",
        "tool_use_id": tool_call.id,
        "content": "Ticket T-42 is open and assigned to Support Ops.",
    }],
})

follow_up = client.messages.create(
    model="claude-sonnet-5-5",
    max_tokens=4096,
    thinking={"type": "between_tools"},
    output_config={"effort": "medium"},
    tools=tools,
    tool_choice={"type": "auto"},
    messages=messages,
)AnthropicのSonnet 5.5移行ガイドには、直接APIで返る400エラーと代替フィールドが記載されています。ローカル環境からMediumのbetween_toolsリクエストを送ったところ、1.35秒でHTTP 200が返りました。別のadaptive tool loopでは署名付きthinkingブロックが生成され、そのブロックを変更せず次のターンで再送すると成功しました。
ここには重要な注意点が一つあります。テスト時の呼び出しはAI gatewayを経由していました。この互換レイヤーでは、Anthropicの資料上は直接APIでエラーになる古いdisabledのthinking値と、tool_choice: anyの強制指定をあえて送っても、HTTP 200が返りました。ミドルウェアで受け付けられたからといって、直接接続でも互換性があるとは限りません。切り替え前にAnthropicのPlaygroundで生のリクエストを確認するか、直接エンドポイントをテストしてください。
Sonnet 5.5で解決できないこと
裏付けのない推論を事実に変えることはできません。ローカルのサポートテストが、その点をはっきり示しています。影響の大きい主張には出典を必須とし、返金、アカウント変更、法的な約束、医療上の判断、セキュリティ対応には承認工程を残してください。
すべてのタスクがMedium向きになるわけでもありません。自社の事例で推論の見落としや作業の未完了が見つかったら、エフォートを上げます。判断を長く維持する必要がある、答えの定まらない業務ではOpusを使います。上位モデルが適する場面は、Opus 5.5との比較で解説しています。
モデルをそのまま呼び出すだけで、プロダクトになるわけでもありません。本番運用の作業の多くは、コネクター、権限、ポリシーチェック、評価、可観測性、フォールバック動作、使いやすいレビュー画面にあります。
また、最新の情報源も引き続き必要です。サポートや調査の回答が、現在何を許可・要求しているか、またはいくらかかるかに左右されるなら、検索ツールまたはナレッジツールをモデルへ与え、確認するよう指示してください。
月曜日に始めること
信頼できる情報源が明確なキューを一つ選びます。月曜日に直近20件の事例を用意し、不要な個人データを取り除いたうえで、固定した出力スキーマを使い、Sonnet 5.5をMediumで実行します。事実の正確性、裏付けのない推論、網羅性、経過時間、トークン使用量を採点してください。そのプロンプトが合格して初めて、既存APIのモデルIDを変更し、前述の移行チェックを実施します。
Claudeの使い方は?
Claudeアプリでは、送信ボタンの横にあるモデル名をクリックし、Sonnet 5.5とMediumエフォートを選び、出力を検証できる範囲の明確なタスクから始めます。Claude Codeでは/modelを実行してSonnet 5.5を選ぶか、claude --model claude-sonnet-5-5でセッションを開始します。
Claude Sonnet 5はどんな用途に向いていますか?
現在のSonnet 5.5なら、サポート要約、クライアント向けブリーフ、バグ修正、コードレビュー、仕上がりの整った業務文書など、範囲が明確な日常業務から始めるのが適切です。答えが定まらず、わずかな誤りの損失が大きい仕事では、エフォートを上げるかOpusを使います。
Claude Sonnetは無料で使えますか?
利用可否と上限は、Claudeのプランと組織の設定によって異なります。アプリの利用権とAPIの請求は別なので、有料のClaudeサブスクリプションにAPI利用料は含まれません。現在のプラン範囲は、リンク先のClaudeプランガイドで確認してください。
Claude Sonnet 5の料金はいくらですか?
Claude Sonnet 5.5の料金は、100万入力トークン当たり$2、100万出力トークン当たり$10、100万キャッシュ読み取りトークン当たり$0.20です。Anthropicによると、Sonnet 5より少ないトークンで処理できるため、料金単価が低いわけではなくても、完了したタスク当たりの費用を抑えられます。
自社向けに出典を確認できるClaudeワークフローを構築したい場合は、AIプロダクションシステムをご覧ください。
- 最終更新
- 2026年9月28日
- カテゴリー
- AI
Googleでこのサイトを優先する


omidsaffari.comを優先ソースに設定すると、GoogleがTop Stories・AI Overviews・AI Modeであなたのために優先表示します。

Jevを選ぶべきか?GLM-5.3-Flashと料金・精度・画像対応を比較
JevとGLM-5.3-Flashを、料金、精度、レイテンシ、画像対応、機密処理の観点から比較します。低コストのテキスト分類に強いJevと、マルチモーダル処理に強いPrivatemode Decisionsの選び分け、30件の共通テストで導入前に検証する手順まで具体的に解説します。2026年9月27日AI
Claude Opus 5を5.5へ移行すべきか:料金・性能・APIの判断基準
Claude Opus 5とOpus 5.5を、料金、コーディング評価、API互換性、Thinking仕様から比較します。入力・出力単価とキャッシュ料金を整理し、ツールの強制選択、Computer Use、進捗表示など、移行前に確認すべき5項目と実運用での選び方をわかりやすく解説します。2026年9月23日AI
GPT-6 Sol Luna 比較:20倍の価格差で選ぶべきモデル
GPT-6 SolとLunaは同じツールとコンテキスト枠を備えながら、料金は20倍違います。100件の基準タスクで$9と$0.45になるコスト差、DeepSWEの2.2ポイント差、レビュー負担を含む損益分岐点を整理し、Lunaを標準にしてSolへ切り替える条件を具体的に解説します。2026年9月23日AI
GPT-6 Luna 無料利用ガイド:対象プラン・API料金・制限
GPT-6 Luna 無料利用はどこまで可能なのか。Free・Go向けデスクトップアプリ、通常のChat、Work、Codex、APIの提供条件を比較します。入力100万トークン$0.10からのAPI料金、未公表の利用上限、契約前に試す確認手順まで、リリース時点の情報を分かりやすく整理しました。2026年9月22日AI
MiMo AIの使い方:V2.6 APIを業務で動かす実践ガイド
MiMo AI(MiMo-V2.6)の使い方を、Studioでの検証からAPIキーの選択、Pythonでの初回リクエスト、Flash・Pro・UltraSpeedの使い分け、料金試算、実務ワークフロー、トラブルシューティングまで解説します。Xiaomi APIを安全に業務へ導入するための実践ガイドです。2026年9月22日AI
MiMo V2.6徹底比較:Flashを選ぶ条件、Proへ切り替える基準
MiMo V2.6 ProとFlashを料金、ベンチマーク、コンテキスト、前提を明示したコスト試算で比較します。3つの同一タスクで合否、再試行、人手レビューまで測る方法を解説。Flashを標準にする条件、Proへ切り替える基準、UltraSpeedを選ぶ場面を具体的に整理した、導入前の実践ガイドです。2026年9月22日AI
MiMo V2.6 無料版はどこまで使える?料金と条件を整理
MiMo-V2.6-FlashはOpenCodeで1週間無料。ただしXiaomi API、Desktop、Token Planは別条件で、MIT表記のモデルも自前運用には費用がかかります。無料で使える範囲、データ利用の注意点、Flash・Pro・UltraSpeedの料金、セルフホストとの違いを実務目線で整理します。2026年9月22日AI