GPT-6.1 Solを徹底比較:GPT-6 Solとの料金・性能・移行条件
GPT-6.1 SolとGPT-6 Solを、料金、キャッシュ単価、ベンチマーク、API互換性で比較。Chat Completionsのツール呼び出しや推論設定による移行条件、切り替え前に行う5つの固定テスト、キャッシュを多用する業務での選び方まで実務目線で分かりやすく解説します。



GPT-6.1 SolとGPT-6 Solの比較では、まずテストを通じてアップグレードの可否を判断する必要があります。長いプロンプトをキャッシュして使い回すResponses APIエージェントならGPT-6.1 Solへの移行が有力です。一方、Chat Completionsでツールを呼び出している場合や、推論設定のnoneが移行の壁になる場合はGPT-6 Solを維持します。100万トークン当たりの料金は、どちらも入力が$2、出力が$10です。違いがあるのはキャッシュ済み入力だけで、$0.20から$0.10に下がります。
GPT-6.1 SolとGPT-6 Solの比較:どちらを選ぶべきか
Responses APIに対応済みで、長いプロンプトの共通部分を再利用するワークロードなら、GPT-6.1 Solを選ぶ価値があります。コーディング、コンピューター操作、文書作業、複数ステップの業務タスクでも、より有力な候補です。対して、アプリがChat Completionsの関数呼び出しやreasoning_effort: noneに依存している間は、GPT-6 Solを維持すべきです。これは小さな設定差ではありません。モデルIDの変更だけで済むのか、リクエスト経路から作り直すのかを分ける境界です。
状況別に整理すると、判断は明快です。
- 推論強度がmedium以上の既存Responses APIエージェント: GPT-6.1 Solを今すぐテストします。キャッシュ読み取り単価が低く、リリース時点の性能評価でも優位性が示されています。
- Chat Completionsで関数を呼び出すアプリ: いきなりモデルIDを置き換えてはいけません。ツール経路をResponsesへ移し、回帰テストを済ませてからモデルを比較します。
- 推論設定に
noneを使うワークロード: 少なくともlowを許容できるまでGPT-6 Solを維持します。GPT-6.1 Solのデフォルトはmediumです。 - 入力の大半が新規で、出力も多いワークロード: トークン単価による節約はありません。新規入力、キャッシュ書き込み、出力の料金は両モデルで同じなので、切り替えるなら性能向上でコストを正当化する必要があります。
判断基準はシンプルです。呼び出し側の互換性を確認したうえで、GPT-6.1 Solによって合格品質の成果が増える場合にだけ切り替えます。 キャッシュ単価の低下は魅力ですが、ツール呼び出しの失敗、推論強度の下限変更、追加の再試行が1つでもあれば、節約分はすぐに消えます。
GPT-6.1 SolとGPT-6 Solの料金比較
料金面でGPT-6.1 Solが優位になるのは、リクエストでキャッシュ読み取りが発生する場合だけです。新規入力、キャッシュ書き込み、出力の料金は変わりません。
2026年9月30日時点で、OpenAIが公開しているGPT-6.1 SolモデルページとGPT-6 Solモデルページを照合しました。
1,000トークン単位に換算すると、新規入力は両モデルとも$0.002、キャッシュ書き込みは$0.0025、出力は$0.01です。キャッシュ読み取りはGPT-6.1 Solが$0.0001、GPT-6 Solが$0.0002となります。この料金体系では、GPT-6 Solのほうが安くなる処理量の境界はありません。キャッシュ読み取りが少しでもあればトークン料金はGPT-6.1 Solが有利になり、ゼロなら同額です。
GPT-6.1 Solのキャッシュ料金
キャッシュ済み入力の単価は50%下がりますが、変わるのはコストの一部だけなので、タスク全体の費用が同じ割合で下がるわけではありません。キャッシュ済み入力とは、モデルが再利用できる未変更のプロンプト接頭部を指します。OpenAIのプロンプトキャッシュガイドによると、GPT-5.6以降では接頭部に1,024以上の可視入力トークンが必要で、セッションを維持してもキャッシュヒットは保証されません。
キャッシュ書き込みの項目も正しく読む必要があります。書き込みは別の入力トークン料金であり、通常の入力料金に上乗せされる追加手数料ではありません。両モデルとも、書き込まれる100万トークン当たり$2.50です。GPT-6.1 Solで変わるのは、その後の読み取り料金であり、再利用可能な接頭部を作成する費用ではありません。
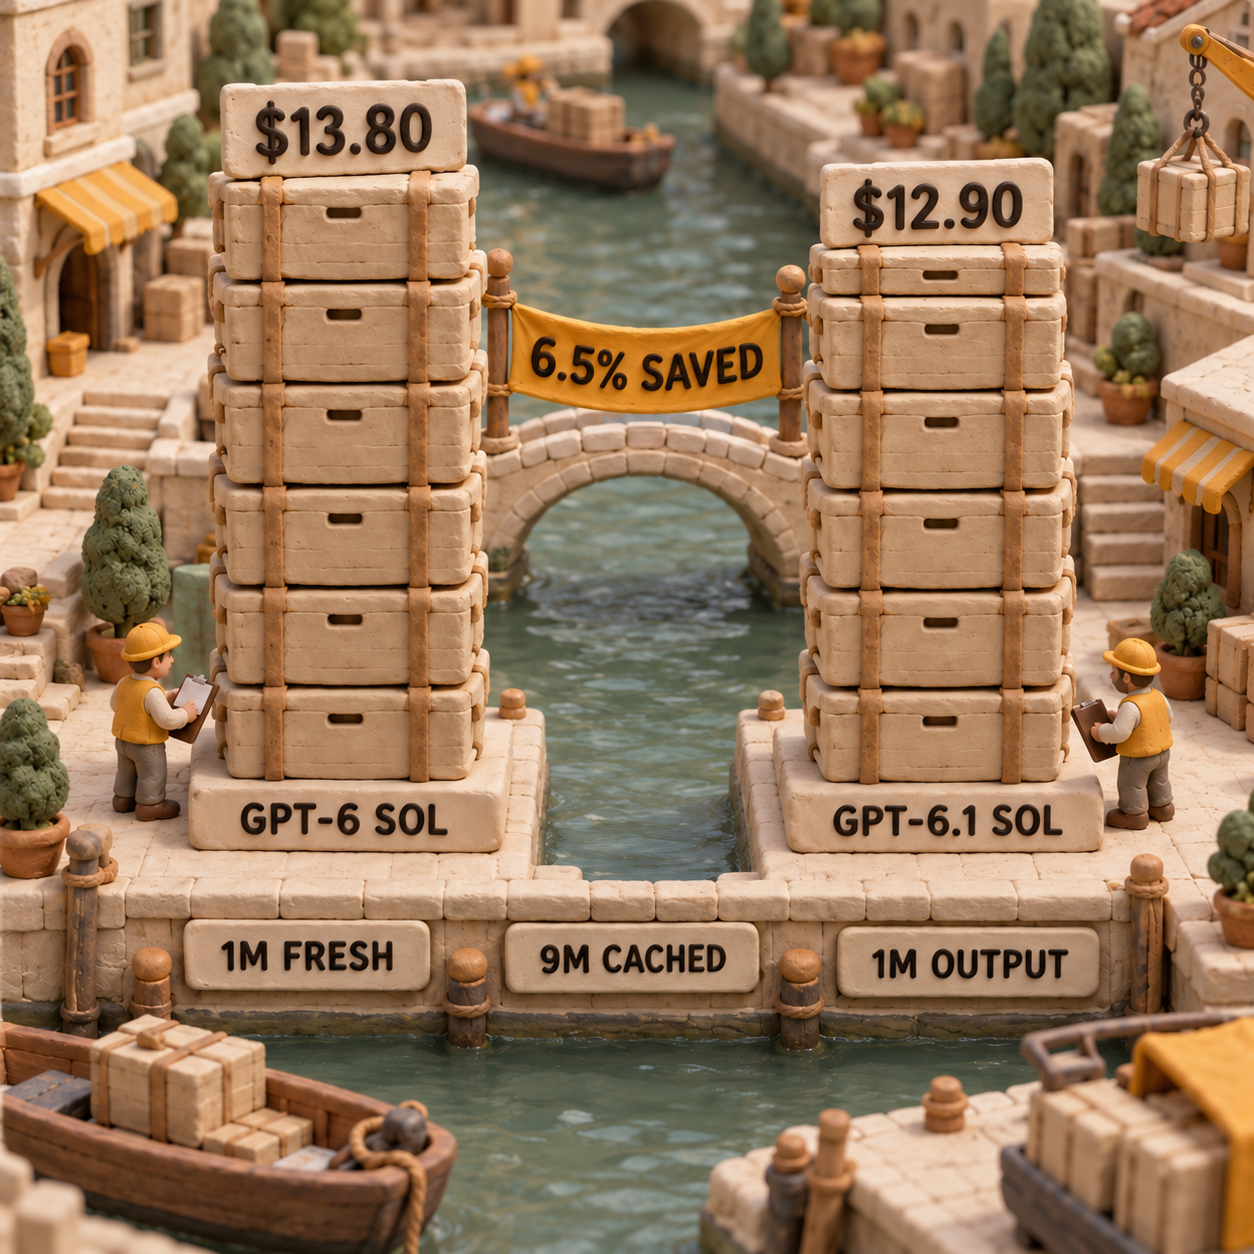
新規入力100万トークン、キャッシュ済み入力900万トークン、出力100万トークンの短いコンテキストによるバッチを考えます。
- GPT-6 Sol: (1 x $2.00) + (9 x $0.20) + (1 x $10.00) = $13.80
- GPT-6.1 Sol: (1 x $2.00) + (9 x $0.10) + (1 x $10.00) = $12.90
差額は$0.90、つまり6.5%の節約です。キャッシュ書き込みとツール料金は含みません。これは料金表から算出した例であり、実行済みワークロードや実際の請求結果ではありません。
この計算例は、各リクエストの入力が272,000トークン以下であることも前提としています。このしきい値を超えると、両モデルのページではリクエスト全体の入力料金とキャッシュ料金が2倍、出力料金が1.5倍になると説明されています。小さなリクエストをまとめれば、バッチ全体が数百万トークンでもしきい値を超えないことがあります。判定はリクエスト単位です。
既存のエージェントでは、プロンプト長から推測するのではなく、まずcached_tokensとキャッシュ書き込みトークンを測定します。GPT-6のプロンプトキャッシュ診断ガイドでは、キャッシュヒット率の低さとモデル料金の問題を切り分ける方法を解説しています。
キャッシュを多用する処理ではGPT-6.1 Solが優位です。キャッシュ読み取りがなければ同等です。
GPT-6.1 Solのベンチマーク
リリース時点の性能評価ではGPT-6.1 Solが上回っています。ただし、これは独立機関による直接比較ではなく、OpenAIが示した結果です。この違いは重要です。システムプロンプト、利用できるツール、推論強度、再試行ポリシーによって、結果もコストも変わるからです。
OpenAIのリリースレポートから、GPT-6 Solとの比較で参考になる5つの結果を確認できます。
- コーディング: GPT-6.1 Solは、より低い推論強度とコストでGPT-6 SolのDeepSWE v1.1最高スコアを6.4パーセントポイント上回りました。
- 業務ワークフロー: 同じ設定のAutomationBench 1.0.6で4.8パーセントポイント高いスコアを記録しました。
- コンピューター操作: 最大推論強度のOSWorld 2.0オフラインセットで7パーセントポイント向上し、タスク当たりのコストは半分未満でした。
- 科学ワークフロー: 最大推論強度のTerminal-Bench Science 0.1でGPT-6 Solのスコアを2倍以上に伸ばし、ここでもタスク当たりのコストは半分未満でした。
- 正確性: 意図的に難しくしたプロンプトを低い推論強度で処理した場合、事実誤認を少なくとも1つ含む回答の割合が11.4%から7.7%へ下がりました。相対的には約32%の減少です。
これらは有望な差ですが、あらゆるタスクに共通する性能向上率ではありません。OpenAIは、GPTの評価を同社の研究環境またはAPI経由で実施しており、プロンプト、ツール、推論強度の設定が異なるため、本番のChatGPTとは結果が変わり得ると説明しています。2026年9月30日時点では、この2つの正確なモデルIDを同条件で比べた独立ベンチマークはありませんでした。外部スコアを、自社ワークロードに即した合否判定の代わりにしてはいけません。
各ベンチマークが示せる対象は、見出しから受ける印象より限定的です。DeepSWEは、エージェントに長時間のリポジトリ作業を任せるチームに関係します。AutomationBenchは、営業、マーケティング、サポート、財務、人事のツールを連携する運用担当者に参考になります。OSWorldが重要なのは、モデルにコンピューターアプリを操作させる場合です。いずれも、2段階のサポート分類、短い文章の編集、自社の非公開コードベースで性能が上がることを証明するものではありません。
現時点の性能根拠ではGPT-6.1 Solが優位です。ただし、独立した同一モデル間の検証が出るまでは、ベンダー報告に基づく判断です。
GPT-6.1 SolとGPT-6 Solの仕様比較
運用上の基本仕様は、ほぼ共通しています。両モデルとも、1,050,000トークンのコンテキストウィンドウ、最大128,000トークンの出力、テキストと画像の入力、テキスト出力、構造化出力、ストリーミング、同じResponsesのツール群に対応します。各モデルページによると、音声入力と動画入力には対応せず、ファインチューニングにも対応していません。
GPT-6.1 Solでは、公開されている知識カットオフが2026年4月20日から4月30日へ移りました。わずか10日の差だけでは、移行理由になりません。多くの本番システムでは、検索の品質、非公開コンテキスト、ツールの正確性のほうが、この小さな日付差より大きく影響します。
GPT-6.1 Sol:新しい第一候補
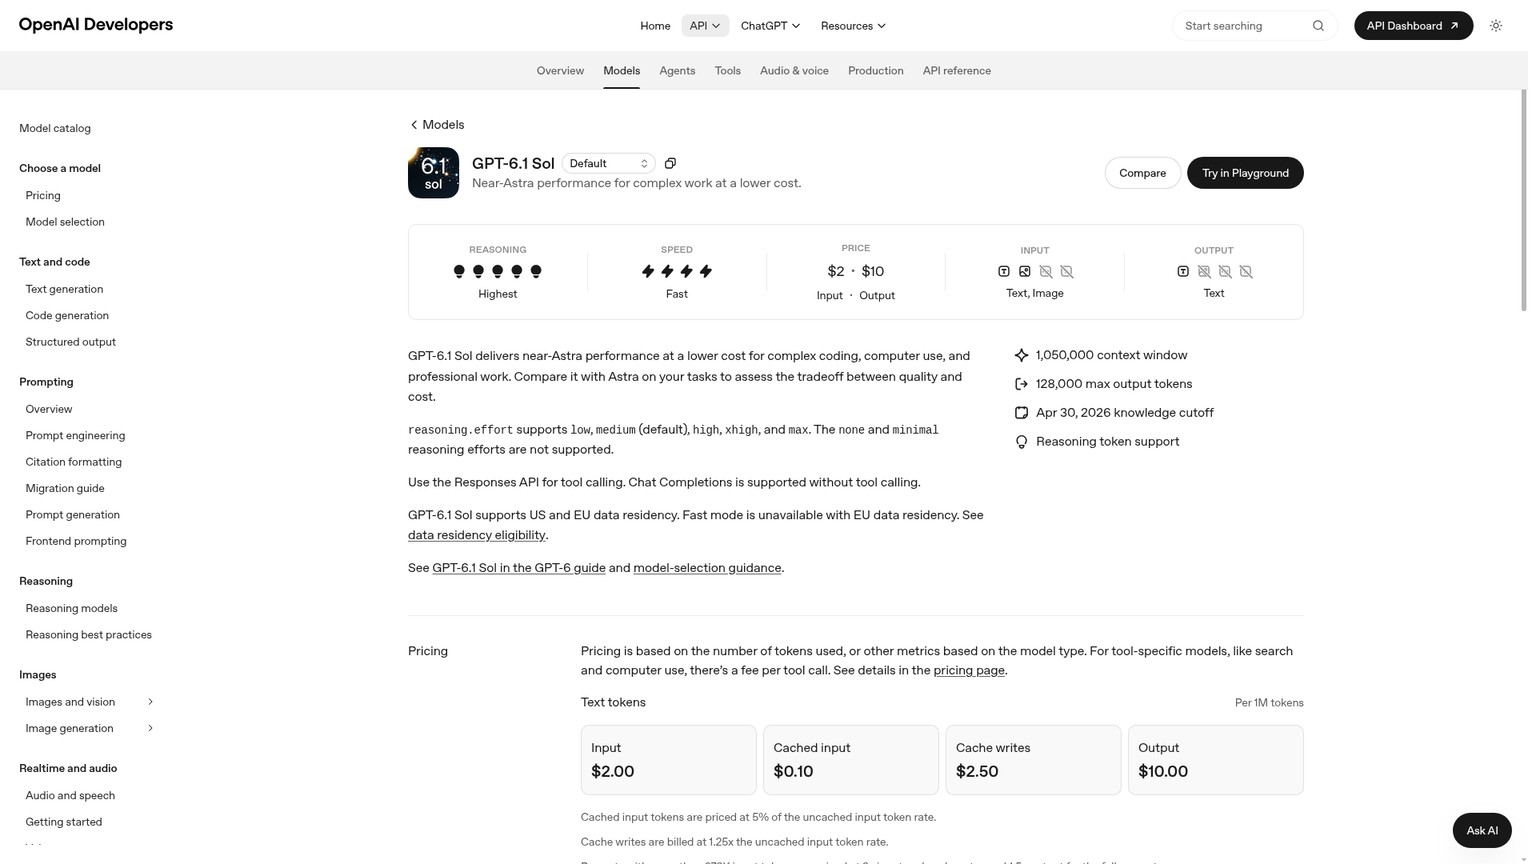
GPT-6.1 Solは、正確なAPI IDがgpt-6.1-solである、OpenAIの新しい複雑タスク向けモデルです。推論強度はlow、medium、high、xhigh、maxに対応し、デフォルトはmediumです。100万トークン当たりの標準料金は、新規入力$2、キャッシュ済み入力$0.10、キャッシュ書き込み$2.50、出力$10です。
モデルページでは、Responses経由でWeb検索、ファイル検索、画像生成、コードインタープリター、ホステッドシェル、apply patch、スキル、コンピューター操作、MCP、ツール検索を利用できるとされています。API経路に問題がなく、より強い性能が示されたコーディング、文書、コンピューター操作、ワークフローに近いタスクなら選択肢になります。独自の合否テストが済んでいない場合や、廃止された推論設定に依存している場合は、すぐにデフォルトを切り替えるべきではありません。
GPT-6 Sol:互換性を優先する選択肢
GPT-6 Solはgpt-6-solとして引き続き利用できます。推論強度はnone、low、medium、high、xhigh、maxに対応します。100万トークン当たりの標準料金は、新規入力$2、キャッシュ済み入力$0.20、キャッシュ書き込み$2.50、出力$10のままです。
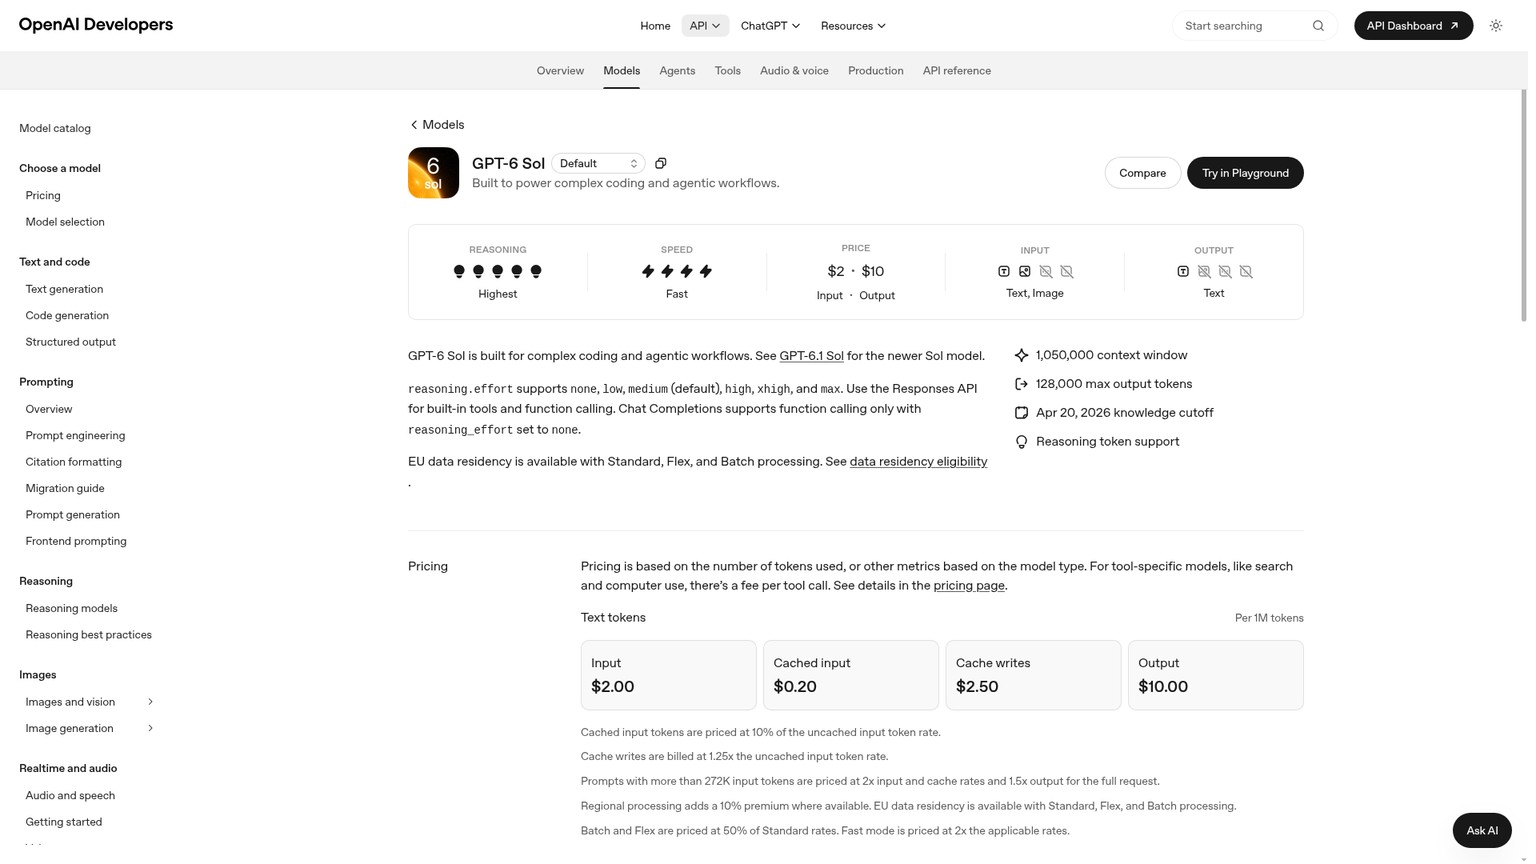
Responsesで利用できるツール群は、新しいモデルの公開リストと同じです。実務上の違いは、従来方式を残せることです。推論強度をnoneに設定すれば、Chat Completionsから関数を呼び出せます。そのため、ツールループをResponsesへ移していない安定稼働中のアプリでは、GPT-6 Solが当面の最適解になります。キャッシュ読み取りが発生する場合、料金面で安いモデルではありません。
コンテキスト、出力上限、モダリティ、公開されているResponsesツールは同等です。情報の新しさではGPT-6.1 Sol、従来方式との互換性ではGPT-6 Solが優位です。
GPT-6.1 Solへの移行:まず互換性を確認する
すでにResponsesを使い、noneとminimalを避け、モデル出力をそのまま互換性のある契約とみなさず検証対象としている呼び出し側なら、GPT-6.1 Solへの移行はモデル名を1行変えるだけで済む可能性があります。それ以外では、モデル評価の前に移行作業が必要です。
GPT-6.1 Solのツール呼び出し
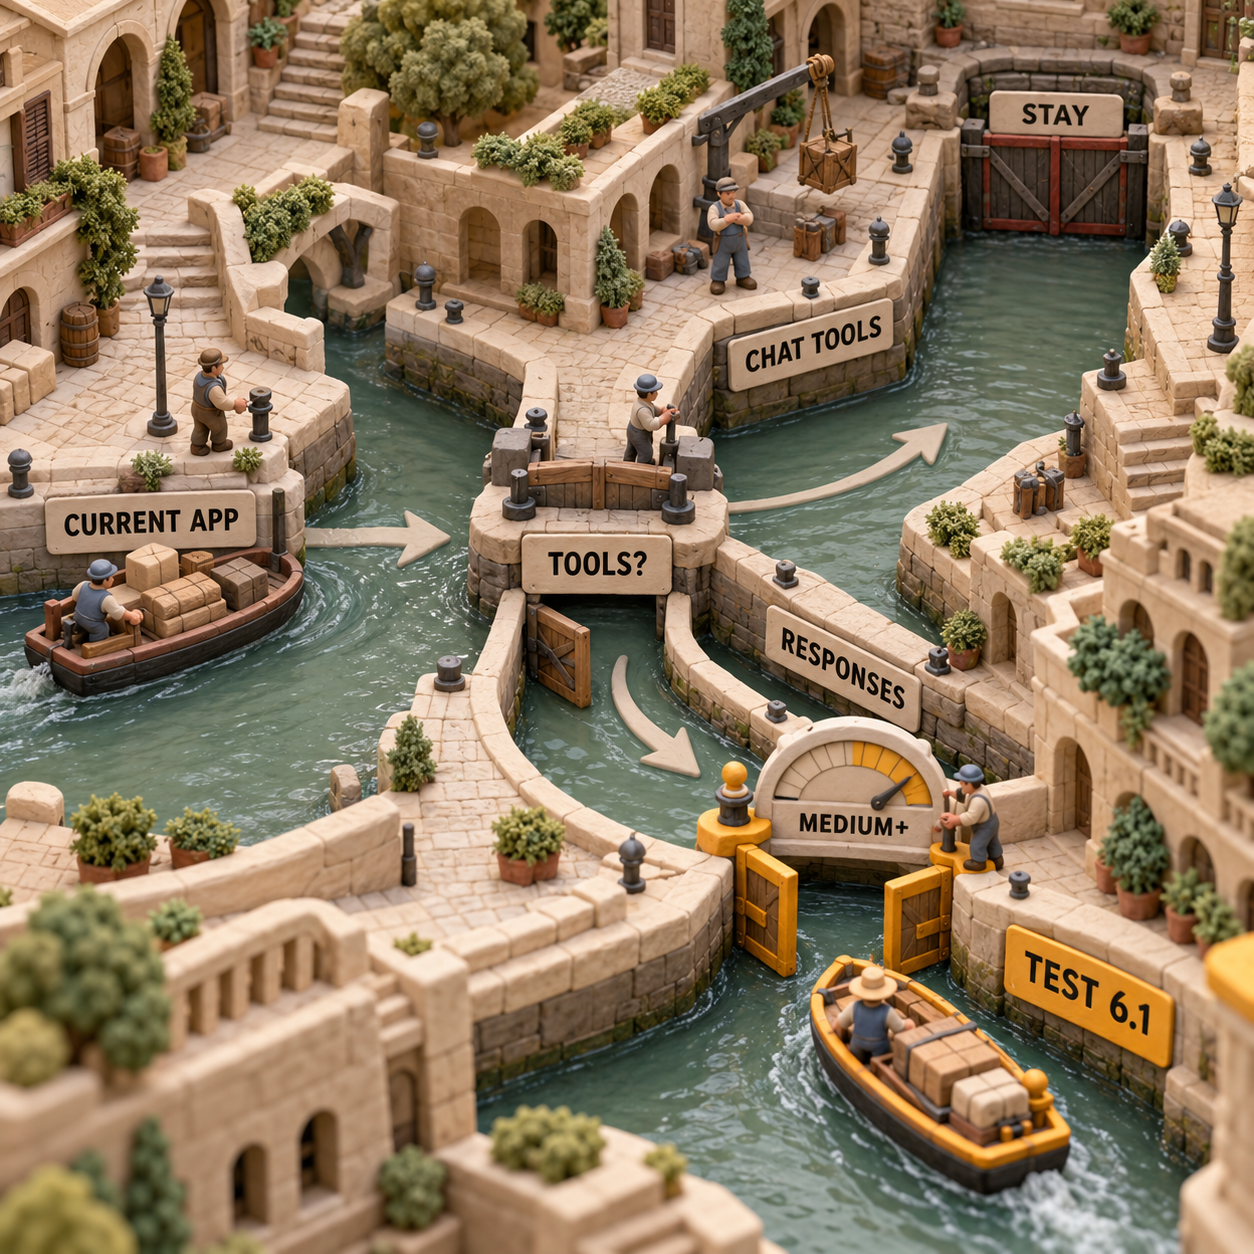
GPT-6.1 Solでツールを呼び出すにはResponses APIが必要です。通常のモデル呼び出しではChat Completionsを引き続き利用できますが、ツール呼び出しには使えません。GPT-6 Solは異なり、モデルページではreasoning_effortをnoneに設定した場合に限り、Chat Completionsの関数呼び出しが認められています。
モデルIDを変更する前に、既存のChat Completions関数呼び出しをすべて確認してください。移行コストには、リクエストの組み立て、会話状態、ツール結果の処理、レスポンスの解析、再試行ロジック、トレース、キャッシュ接頭部の安定性への対応が含まれる可能性があります。エンドポイントを隠すラッパーがあっても、こうした違いは消えません。テストすべき場所が移るだけです。
推論設定も、もう1つの契約です。GPT-6.1 Solはnoneとminimalに対応していません。本番経路が低遅延、決定論的なツール選択、コスト管理のためにnoneを使っている場合、最も近い有効な設定へ変えても挙動が同じとは限りません。対応する推論強度へ移し、速度や費用を比較する前に、同じ合否テストを実施してください。
まだ切り替えるべきでないケース
次のいずれかに該当するなら、まだデフォルトを切り替えるべきではありません。
- ツール呼び出しが今もChat Completions経由で動いている。
- いずれかの処理経路が推論設定として
noneまたはminimalを明示している。 - 課金対象トークンの大半が新規入力と出力で、キャッシュによる節約がほとんどない。
- 現行モデルが業務上の合否基準をすでに満たしており、同じテスト条件でGPT-6.1 Solの性能向上を確認していない。
- 規制対象の導入環境で、処理モード、データ所在地、ログ、モデル挙動の変化について別途審査が必要になる。
これは永続的なベンダーロックインではなく、ワークフローへの依存です。モデル名は似ていますが、呼び出し側はエンドポイント、推論強度の下限、レスポンス形式、ツールループに結び付いている可能性があります。検証作業の費用も、アップグレードコストに含めてください。
現時点で互換性のない呼び出し側ならGPT-6 Solが適しています。呼び出し側と固定テストが合格した後はGPT-6.1 Solが有力です。
デフォルト変更前に5つの固定テストを実行する
対象となる2つのモデルIDそのものに対して、同じプロンプト、ツール、コンテキスト、出力上限、合否基準を使い、mediumの推論強度で5つの固定テストを実行します。これは本記事で実行したベンチマークではなく、評価設計の提案です。
リポジトリのバグを修正する
両モデルに、失敗する同一のテスト、同じリポジトリ状態、同じ使用可能なツールを与えます。既存のテストスイートを壊さず、対象の不具合を直すパッチだけを合格とします。
複数ファイルをまたいでリファクタリングする
対象範囲を限定した複数ファイルの変更を用意し、ビルド、lint、テストを合否判定に使います。説明が洗練されていても、リポジトリの検査に失敗したら不合格です。
サポート案件を振り分ける
同じポリシー、顧客メッセージ、振り分け用ツールを与えます。正しいキュー、優先度、構造化フィールドを必須とし、根拠のない操作を認めません。
ポリシーの根拠を示して回答する
同じ文書群を根拠に、顧客向け回答を作成させます。必要な結論、引用した根拠、適切なエスカレーションのすべてを満たした場合だけ合格です。
業務ワークフローを完了する
同じ複数ステップの検索・更新タスクに、権限の境界を設定します。正しいツールの実行順序と最終状態を求め、許可されていない手順は拒否させます。
合格した出力、処理全体の遅延、新規入力、キャッシュ済み入力、推論トークンと出力トークン、ツール料金、再試行回数を記録します。そのうえで、最初の回答当たりではなく、合格した成果当たりの総コストを計算します。
effective cost per accepted result = total model, retry, and tool spend / accepted outputs
この分母によって、トークン単価だけで見た結論が逆転することがあります。キャッシュを多用するバッチで$0.90節約できても、ツール実行の失敗が1回増えれば、総コストは上がりかねません。新規トークンの料金が同じでも、再試行を減らせるモデルなら、本番環境ではそちらのほうが安くなる可能性があります。
API、Work、Codex、Chatで提供状況が異なる
GPT-6.1 SolはAPIでgpt-6.1-solとして利用できます。OpenAIのリリース発表によると、Plus、Pro、Business、Enterprise、Eduユーザー向けのChatGPT WorkとCodexでも提供されています。リリース時点では、通常のChatでは利用できませんでした。
OpenAIはGPT-6.1 Sol Ultrafastも今後提供するとしており、Codexでは標準速度の最大8倍でトークンを生成できると説明しています。発表にはUltrafastの料金が掲載されていないため、非公式な倍率をもとにコストを予測すべきではありません。
API利用料はChatGPTのサブスクリプションとは別に請求されます。WorkやCodexでアクセスできても、本番アプリのAPI料金である$2と$10が利用枠に含まれるわけではありません。
よくある質問
GPT-6 SOLとは何ですか?
GPT-6 Solは、正確なAPI IDがgpt-6-solである、OpenAIの複雑なコーディングやエージェント型ワークフロー向けモデルです。GPT-6.1 Solは2026年9月29日に登場したアップグレード版で、キャッシュ済み入力の単価が低く、推論とツール呼び出しの互換条件も異なります。
GPT Solはどのくらい性能が上がりましたか?
正直に言えば、性能差を単一の割合で表すことはできません。OpenAIは、特定の設定でGPT-6 Solと比べたGPT-6.1 Solの向上幅として、DeepSWEで6.4パーセントポイント、AutomationBenchで4.8ポイント、OSWorldで7ポイントを報告しています。実際の効果は、固定した自社ワークロードで判断すべきです。
どのGPTバージョンが優れていますか?
対応済みのコーディングやビジネスエージェント業務で試すなら、GPT-6.1 Solが有力です。Chat Completionsのツール呼び出しやnone推論がまだ必要なら、当面の実行環境にはGPT-6 Solが適しています。
OpenAIの新しいGPT-6 SolとLunaの機能・料金は?
これは、1つ前のモデルファミリー内での選択に関する質問です。GPT-6 SolとLunaの比較では、両モデルの役割分担と現在のトークン料金を解説しています。本ページが扱うのは、既存のSolワークロードをGPT-6.1 Solへ移行すべきかという判断です。
GPTはSol、Terra、Lunaのどれが優れていますか?
すべての用途に共通する勝者はいません。タスクの難易度、遅延、合格した成果当たりのコストに合わせてモデルを選び、実際に導入する正確なIDを評価します。この比較はSolからSolへのアップグレード判断を支援するもので、TerraやLunaとの優劣を決めるものではありません。
GPT-6 Solのほうが安いですか?
公開されている標準トークン料金では安くありません。新規入力、キャッシュ書き込み、出力はGPT-6.1 Solと同額で、キャッシュ済み入力はGPT-6.1 Solが100万トークン当たり$0.10、GPT-6 Solが$0.20です。
ChatGPTに$20払う価値はありますか?
これは個人向けサブスクリプションの判断であり、APIモデルの料金比較とは別です。GPT-6.1 Solはリリース時点で対象の有料プランにおけるWorkとCodexで利用できましたが、通常のChatでは提供されていませんでした。API利用料は別途請求されます。
GPT-5.6 SolはGPT-5より優れていますか?
旧世代の比較だけで、今回のアップグレードを判断することはできません。現在の導入環境では、アプリで実際に使うAPI経路、推論強度、ツール、合否基準を揃えてGPT-6.1 SolとGPT-6 Solを評価してください。
GPT-6の性能はどの程度ですか?
GPT-6の性能は、モデル、タスク、推論強度、ツール構成によって変わります。複数の難しい評価では、GPT-6.1 SolのほうがGPT-6 Solより強いというベンダー報告がありますが、本番での答えは固定した非公開評価で確認する必要があります。
GPT-6.1 SolとGPT-6 Solのパラメータ数は?
OpenAIが公開している両モデルのページには、パラメータ数もダウンロード可能な重みも掲載されていません。代わりに、公開されている上限、料金、APIの挙動、実測したタスク結果を比較してください。
月曜から始める実務手順
モデル選択画面ではなく、呼び出し側の確認から始めます。コードとワークフロー設定を検索し、Chat Completionsの関数呼び出しと、noneまたはminimalに設定されたreasoning_effortを探してください。どちらかが見つかった場合は、デフォルトモデルを変える前に移行範囲を明確にします。
次に、同じツールと合否基準を使い、推論強度をmediumに揃えて、5つの固定テストをgpt-6-solとgpt-6.1-solの両方で実行します。合格した成果当たりのコスト、遅延、キャッシュ使用量、再試行回数を比較してください。GPT-6.1 Solが優位な経路だけを切り替え、それ以外は互換性や成果の差が解消するまでGPT-6 Solに残します。
本番のモデル経路を変える前に、Claude CodeとCodexのセットアップチェックリストを入手してください。
- 最終更新
- 2026年9月30日
- カテゴリー
- AI
Googleでこのサイトを優先する


omidsaffari.comを優先ソースに設定すると、GoogleがTop Stories・AI Overviews・AI Modeであなたのために優先表示します。

Claude 使い方ガイド:Sonnet 5.5の実践手順
Claude Sonnet 5.5を実務で使う手順を、Mediumエフォートの設定から検証可能なワークフロー、料金、Claude API移行の注意点まで解説します。サポート要約の実測をもとに、向いている仕事、エフォートの選び方、もっともらしい誤推論を防ぐ確認方法、製品化の機会を具体的に整理しました。2026年9月28日AI
Jevを選ぶべきか?GLM-5.3-Flashと料金・精度・画像対応を比較
JevとGLM-5.3-Flashを、料金、精度、レイテンシ、画像対応、機密処理の観点から比較します。低コストのテキスト分類に強いJevと、マルチモーダル処理に強いPrivatemode Decisionsの選び分け、30件の共通テストで導入前に検証する手順まで具体的に解説します。2026年9月27日AI
Claude Opus 5を5.5へ移行すべきか:料金・性能・APIの判断基準
Claude Opus 5とOpus 5.5を、料金、コーディング評価、API互換性、Thinking仕様から比較します。入力・出力単価とキャッシュ料金を整理し、ツールの強制選択、Computer Use、進捗表示など、移行前に確認すべき5項目と実運用での選び方をわかりやすく解説します。2026年9月23日AI
GPT-6 Sol Luna 比較:20倍の価格差で選ぶべきモデル
GPT-6 SolとLunaは同じツールとコンテキスト枠を備えながら、料金は20倍違います。100件の基準タスクで$9と$0.45になるコスト差、DeepSWEの2.2ポイント差、レビュー負担を含む損益分岐点を整理し、Lunaを標準にしてSolへ切り替える条件を具体的に解説します。2026年9月23日AI
GPT-6 Luna 無料利用ガイド:対象プラン・API料金・制限
GPT-6 Luna 無料利用はどこまで可能なのか。Free・Go向けデスクトップアプリ、通常のChat、Work、Codex、APIの提供条件を比較します。入力100万トークン$0.10からのAPI料金、未公表の利用上限、契約前に試す確認手順まで、リリース時点の情報を分かりやすく整理しました。2026年9月22日AI
MiMo AIの使い方:V2.6 APIを業務で動かす実践ガイド
MiMo AI(MiMo-V2.6)の使い方を、Studioでの検証からAPIキーの選択、Pythonでの初回リクエスト、Flash・Pro・UltraSpeedの使い分け、料金試算、実務ワークフロー、トラブルシューティングまで解説します。Xiaomi APIを安全に業務へ導入するための実践ガイドです。2026年9月22日AI
MiMo V2.6徹底比較:Flashを選ぶ条件、Proへ切り替える基準
MiMo V2.6 ProとFlashを料金、ベンチマーク、コンテキスト、前提を明示したコスト試算で比較します。3つの同一タスクで合否、再試行、人手レビューまで測る方法を解説。Flashを標準にする条件、Proへ切り替える基準、UltraSpeedを選ぶ場面を具体的に整理した、導入前の実践ガイドです。2026年9月22日AI