مقارنة GPT-6.1 Sol و GPT-6 Sol: هل تستحق الترقية؟
مقارنة GPT-6.1 Sol و GPT-6 Sol في الأسعار والأداء والتوافق واستدعاء الأدوات، مع اختبار عملي يوضح متى تستحق الترقية ومتى يكون البقاء هو الخيار الأفضل.



تبدأ مقارنة GPT-6.1 Sol و GPT-6 Sol من الاختبار قبل الترقية: انقل الوكلاء كثيفي استخدام الذاكرة المؤقتة على Responses API إلى GPT-6.1 Sol، لكن أبقِ GPT-6 Sol إذا كان استدعاء الأدوات عبر Chat Completions أو استخدام الاستدلال none لا يزال يمنع الانتقال. كلاهما يكلف $2 للإدخال و$10 للإخراج لكل مليون رمز؛ وحده سعر الإدخال المخزن مؤقتًا ينخفض، من $0.20 إلى $0.10.
مقارنة GPT-6.1 Sol و GPT-6 Sol: أيهما تختار؟
اختر GPT-6.1 Sol لأعباء العمل المتوافقة مع Responses API عندما تعيد استخدام بدايات طويلة من المطالبات، أو عندما تحتاج إلى مرشح أقوى للبرمجة واستخدام الحاسوب والعمل على المستندات ومهام الأعمال متعددة الخطوات. واصل استخدام GPT-6 Sol ما دام تطبيقك يعتمد على استدعاء الدوال عبر Chat Completions أو على reasoning_effort: none. هذه ليست فروقًا بسيطة في الإعدادات؛ فهي التي تحدد إن كان الانتقال مجرد تغيير لمعرّف النموذج أم إعادة بناء لمسار الطلب المحيط به.
يمكن حسم القرار بحسب كل حالة:
- وكيل قائم على Responses API بجهد medium أو أعلى: اختبر GPT-6.1 Sol الآن؛ فسعر قراءة الذاكرة المؤقتة أقل، ومؤشرات قدرته عند الإطلاق أقوى.
- نظام يستدعي الدوال عبر Chat Completions: لا تبدأ بتبديل معرّف النموذج. انقل مسار الأدوات إلى Responses، واختبره ضد الانحدارات، ثم قارن النموذجين.
- عبء عمل يستخدم الاستدلال
none: ابقَ على GPT-6 Sol إلى أن تتمكن من قبولlowعلى الأقل، علمًا بأن الإعداد الافتراضي في GPT-6.1 Sol هوmedium. - إدخال وإخراج جديدان في الغالب: لا يوجد توفير في سعر الرموز. يتقاضى النموذجان الأسعار نفسها للإدخال الجديد والكتابة إلى الذاكرة المؤقتة والإخراج، لذا يجب أن تبرر القدرة الإضافية الانتقال.
قاعدة القرار واضحة: لا تنتقل إلا إذا حسّن GPT-6.1 Sol العمل المقبول بعد اجتياز نظام الاستدعاء فحص التوافق. انخفاض سعر الذاكرة المؤقتة مفيد، لكن فشل استدعاء أداة أو تغير الحد الأدنى لجهد الاستدلال أو محاولة إضافية قد يلتهم هذا التوفير سريعًا.
أسعار GPT-6.1 Sol مقارنةً بـ GPT-6 Sol
يتفوق GPT-6.1 Sol في فئة السعر فقط عندما تنتج طلباتك قراءات من الذاكرة المؤقتة. أسعار الإدخال الجديد والكتابة إلى الذاكرة المؤقتة والإخراج لم تتغير.
راجعتُ الأسعار في صفحتي OpenAI المباشرتين لنموذجي GPT-6.1 Sol وGPT-6 Sol في 30 سبتمبر 2026.
عند توحيد الحساب لكل 1,000 رمز، يكلف الإدخال الجديد $0.002 في كلا النموذجين، وتكلف الكتابة إلى الذاكرة المؤقتة $0.0025، ويكلف الإخراج $0.01. أما قراءة الذاكرة المؤقتة فتكلف $0.0001 في GPT-6.1 Sol و$0.0002 في GPT-6 Sol. لا يوجد حجم استخدام يصبح عنده GPT-6 Sol أرخص وفق هذه الأسعار: كل كمية غير صفرية من الرموز المقروءة من الذاكرة المؤقتة ترجح الفاتورة لمصلحة GPT-6.1 Sol، بينما يؤدي انعدام هذه القراءات إلى التعادل.
تسعير الذاكرة المؤقتة في GPT-6.1 Sol
سعر الإدخال المخزن مؤقتًا أقل بنسبة 50%، لكن تكلفة المهمة الكلية تنخفض بنسبة أصغر لأن عنصرًا واحدًا فقط تغير. والمقصود بالإدخال المخزن مؤقتًا هو بداية مطالبة لم تتغير ويمكن للنموذج إعادة استخدامها. يوضح دليل تخزين المطالبات مؤقتًا من OpenAI أن هذه البداية يجب أن تبلغ 1,024 رمز إدخال ظاهرًا في GPT-5.6 وما بعده، وأن استمرار الجلسة لا يضمن تحقق إصابة في الذاكرة المؤقتة.
ويجب أيضًا قراءة بند الكتابة إلى الذاكرة المؤقتة بدقة. فالكتابة تمثل سعرًا بديلًا لرموز الإدخال، وليست رسمًا إضافيًا فوق سعر إدخال آخر. يتقاضى كلا النموذجين $2.50 لكل مليون رمز تتم كتابته. يغير GPT-6.1 Sol سعر القراءة اللاحقة، لا تكلفة إنشاء البداية القابلة لإعادة الاستخدام.
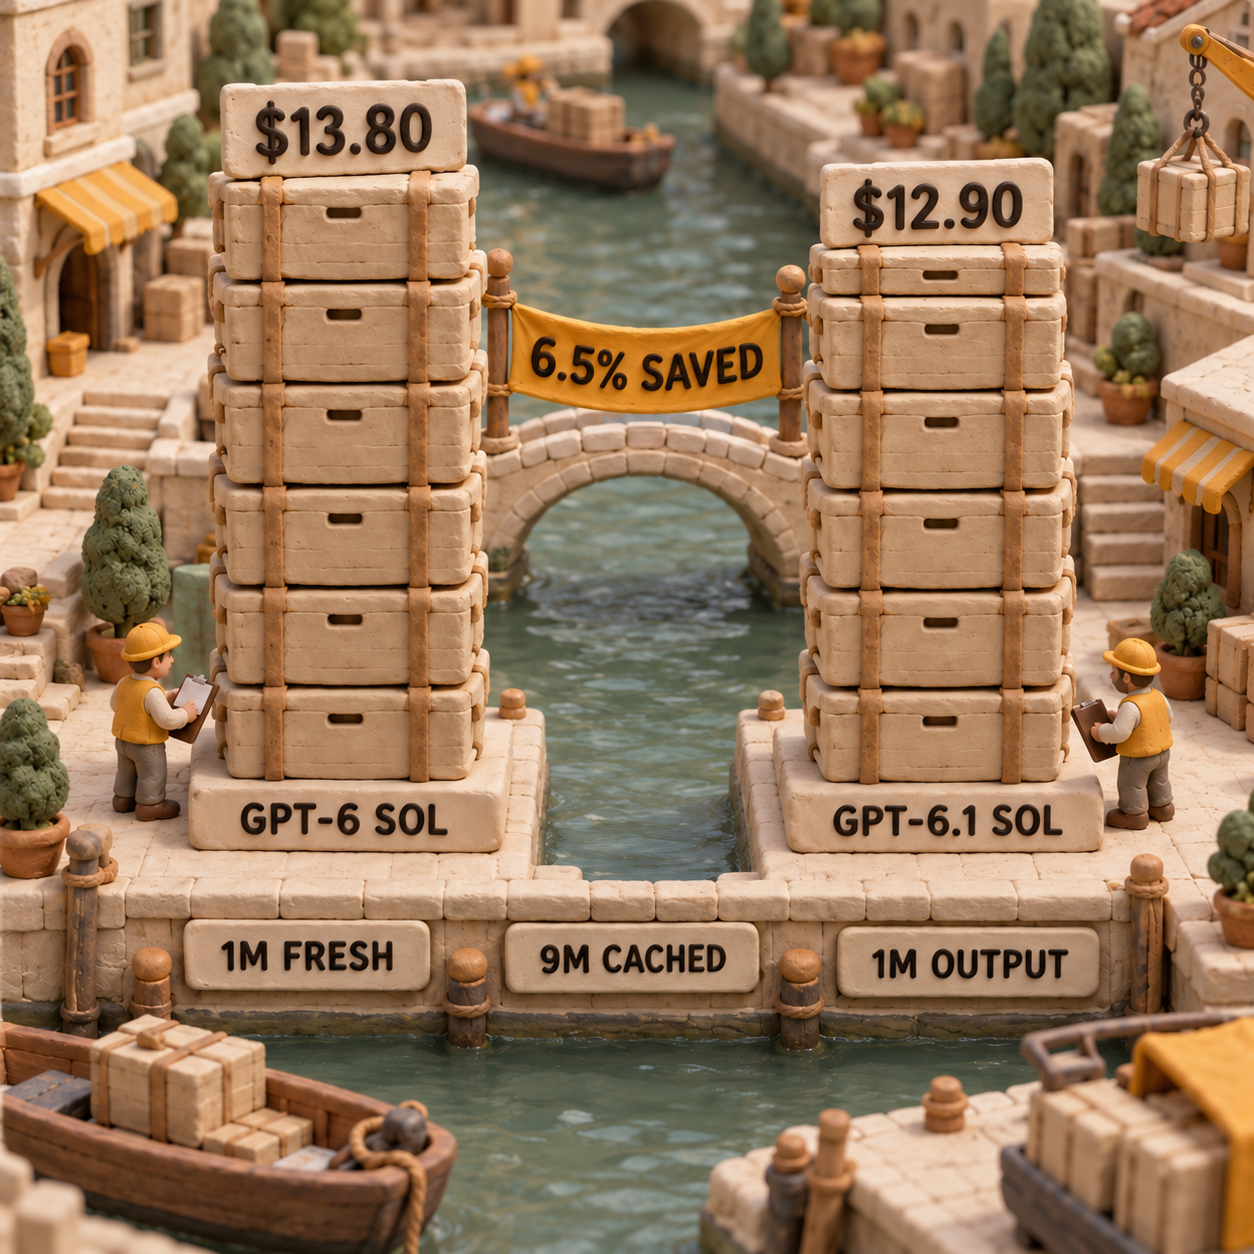
لنأخذ دفعة قصيرة السياق تحتوي على 1 مليون رمز إدخال جديد، و9 ملايين رمز إدخال مخزن مؤقتًا، و1 مليون رمز إخراج:
- GPT-6 Sol: (1 x $2.00) + (9 x $0.20) + (1 x $10.00) = $13.80
- GPT-6.1 Sol: (1 x $2.00) + (9 x $0.10) + (1 x $10.00) = $12.90
هذا توفير قدره $0.90، أو 6.5%، قبل احتساب عمليات الكتابة إلى الذاكرة المؤقتة ورسوم الأدوات. هذه أرقام تسعير محسوبة، وليست نتيجة لعبء عمل نُفّذ فعليًا أو فاتورة تمت ملاحظتها.
يفترض المثال أيضًا أن كل طلب لا يتجاوز 272,000 رمز إدخال. وفوق هذا الحد، تفيد صفحتا النموذجين بأن الطلب كاملًا يُحاسب بمعدل 2x لأسعار الإدخال والذاكرة المؤقتة و1.5x لسعر الإخراج. قد يبلغ مجموع الدفعة ملايين الرموز من دون تجاوز الحد إذا كانت مؤلفة من طلبات أصغر؛ فالحد يطبق على كل طلب منفرد.
بالنسبة إلى وكيل قائم، ابدأ بقياس cached_tokens ورموز الكتابة إلى الذاكرة المؤقتة بدلًا من تقديرها من طول المطالبة. يشرح دليل تشخيص تخزين مطالبات GPT-6 مؤقتًا كيفية الفصل بين ضعف معدل إصابة الذاكرة المؤقتة ومشكلة سعر النموذج.
الفائز: GPT-6.1 Sol للأعمال كثيفة استخدام الذاكرة المؤقتة. تعادل في أعباء العمل التي لا تتضمن قراءات مخزنة مؤقتًا.
نتائج اختبارات GPT-6.1 Sol
يتفوق GPT-6.1 Sol في فئة القدرة وفق أدلة يوم الإطلاق، لكن هذه الأدلة صادرة عن OpenAI وليست اختبارًا مستقلًا مباشرًا بين النموذجين. وهذا فرق مهم، لأن مطالبة النظام والوصول إلى الأدوات وجهد الاستدلال وسياسة إعادة المحاولة كلها قد تغير النتيجة وتكلفتها.
يعرض تقرير الإطلاق من OpenAI خمس إشارات مفيدة عند المقارنة مع GPT-6 Sol:
- البرمجة: تجاوز GPT-6.1 Sol أفضل نتيجة لـ GPT-6 Sol في DeepSWE v1.1 بفارق 6.4 نقطة مئوية، مع جهد استدلال وتكلفة أقل.
- سير عمل الأعمال: حقق نتيجة أعلى بـ 4.8 نقطة مئوية في AutomationBench 1.0.6 عند الإعداد نفسه.
- استخدام الحاسوب: تقدم 7 نقاط في مجموعة OSWorld 2.0 غير المتصلة بالإنترنت عند أقصى جهد، وبتكلفة تقل عن نصف تكلفة المهمة.
- سير العمل العلمي: تجاوز ضعف نتيجة GPT-6 Sol في Terminal-Bench Science 0.1 عند أقصى جهد، ومرة أخرى بتكلفة تقل عن النصف لكل مهمة.
- الدقة الواقعية: في مطالبات صعبة عمدًا عند جهد منخفض، تراجعت نسبة الإجابات التي تتضمن خطأ واقعيًا واحدًا على الأقل من 11.4% إلى 7.7%، أي انخفاض نسبي يقارب 32%.
هذه فروق واعدة، وليست نسبة تحسن عامة تصلح لكل حالة. تشير OpenAI إلى أن تقييمات GPT لديها أُجريت في بيئة البحث التابعة لها أو عبر API، وقد تختلف عن ChatGPT المستخدم في الإنتاج لاختلاف المطالبات والأدوات وإعدادات الجهد. لم يكن هناك في 30 سبتمبر 2026 اختبار مستقل يقارن معرّفي النموذجين نفسيهما على أساس متكافئ، لذلك لا ينبغي أن تحل نتيجة خارجية محل بوابة تحقق خاصة بعبء عملك.
كما أن صلة الاختبار بالمشتري أضيق مما يوحي به العنوان. يهم DeepSWE فريقًا يكلف وكيلًا بعمل طويل الأمد على مستودع برمجي. ويهم AutomationBench مشغلًا يربط أدوات المبيعات أو التسويق أو الدعم أو المالية أو الموارد البشرية. أما OSWorld فيهم عندما يتحكم النموذج في تطبيقات الحاسوب. لا يثبت أي منها تحسن مصنف دعم من خطوتين أو تحرير نص قصير أو العمل على قاعدة شيفرتك الخاصة.
الفائز: GPT-6.1 Sol وفق أدلة القدرة الحالية. مستوى الثقة: أدلة يقدمها المورّد إلى أن تظهر نتائج مستقلة للزوج نفسه.
مواصفات GPT-6.1 Sol مقارنةً بـ GPT-6 Sol
يتشارك النموذجان معظم النطاق التشغيلي. يذكر كلاهما نافذة سياق من 1,050,000 رمز، وحدًا أقصى للإخراج يبلغ 128,000 رمز، وإدخالًا نصيًا وصوريًا، وإخراجًا نصيًا، ومخرجات منظمة، وبثًا، وسطح الأدوات نفسه عبر Responses. لا تدعم صفحتا النموذجين إدخال الصوت أو الفيديو، ولا يدعم أي منهما الضبط الدقيق.
ينقل GPT-6.1 Sol تاريخ انتهاء المعرفة الموثق من 20 أبريل إلى 30 أبريل 2026. عشرة أيام ليست سببًا للانتقال. في معظم أنظمة الإنتاج، ستكون جودة الاسترجاع والسياق الخاص وصحة الأدوات أهم من هذا الفارق الصغير في التاريخ.
GPT-6.1 Sol: المرشح الافتراضي الجديد
GPT-6.1 Sol هو نموذج OpenAI الأحدث للأعمال المعقدة تحت معرّف API الدقيق gpt-6.1-sol. يدعم مستويات الاستدلال low وmedium وhigh وxhigh وmax، ويستخدم medium افتراضيًا. أسعاره القياسية هي $2 للإدخال الجديد، و$0.10 للإدخال المخزن مؤقتًا، و$2.50 للكتابة إلى الذاكرة المؤقتة، و$10 للإخراج لكل مليون رمز.
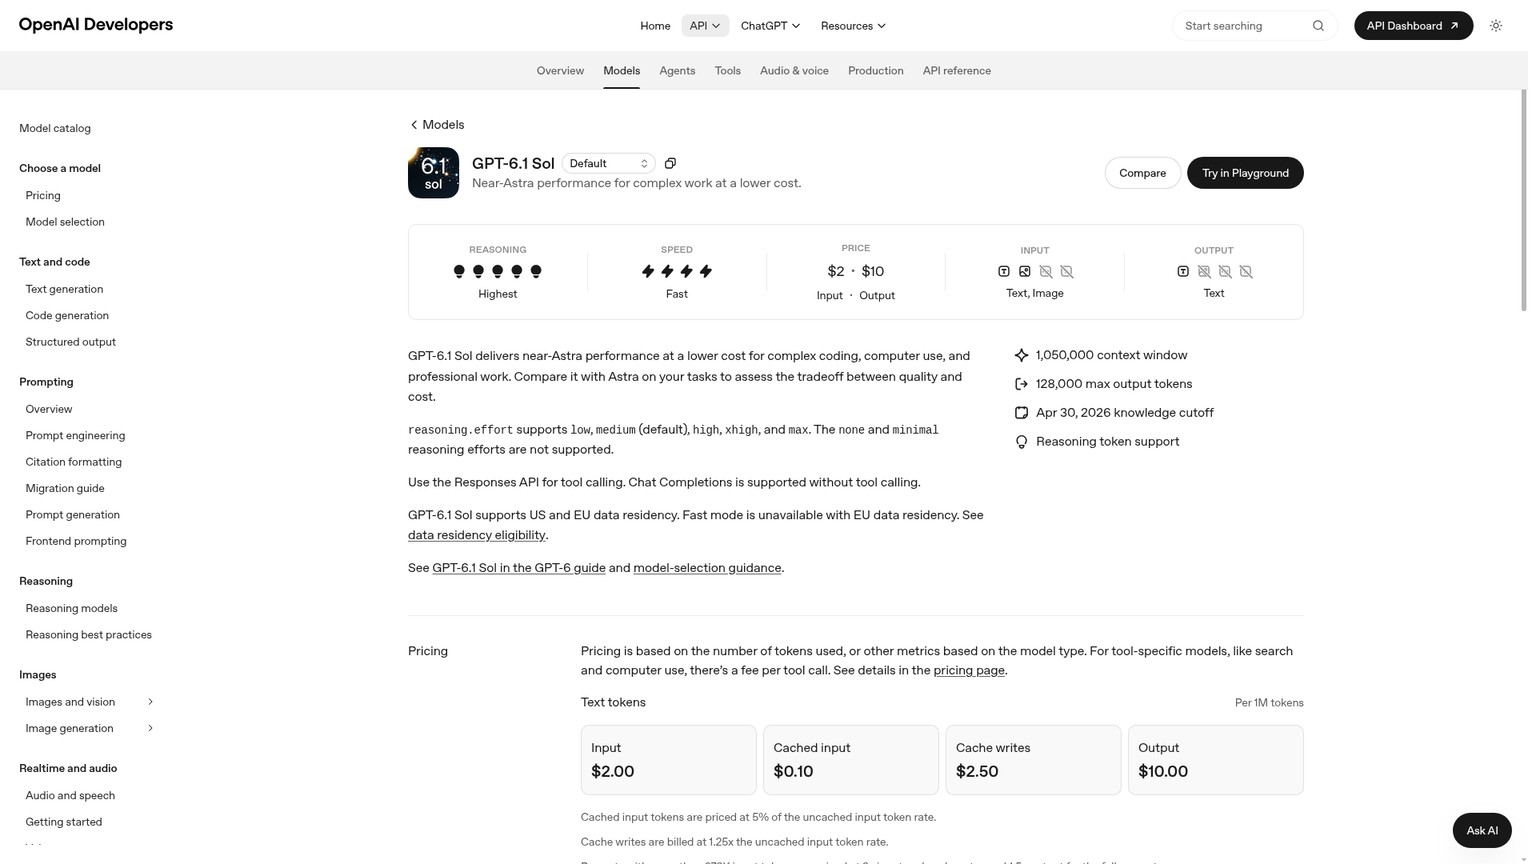
تسرد صفحة النموذج أدوات web search وfile search وimage generation وcode interpreter وhosted shell وapply patch وskills وcomputer use وMCP وtool search عبر Responses. اختره عندما يكون هذا المسار في API ملائمًا بالفعل، وعندما تشبه المهمة مؤشرات القوة في البرمجة أو المستندات أو استخدام الحاسوب أو سير العمل. ولا تجعله الإعداد الافتراضي فورًا إذا كنت ما زلت تحتاج إلى اختبار قبول مستقل أو تعتمد على إعداد استدلال أزيل منه.
GPT-6 Sol: خيار التوافق المؤقت
لا يزال GPT-6 Sol متاحًا تحت المعرّف gpt-6-sol. وهو يدعم مستويات الاستدلال none وlow وmedium وhigh وxhigh وmax. وتبقى أسعاره القياسية $2 للإدخال الجديد، و$0.20 للإدخال المخزن مؤقتًا، و$2.50 للكتابة إلى الذاكرة المؤقتة، و$10 للإخراج لكل مليون رمز.
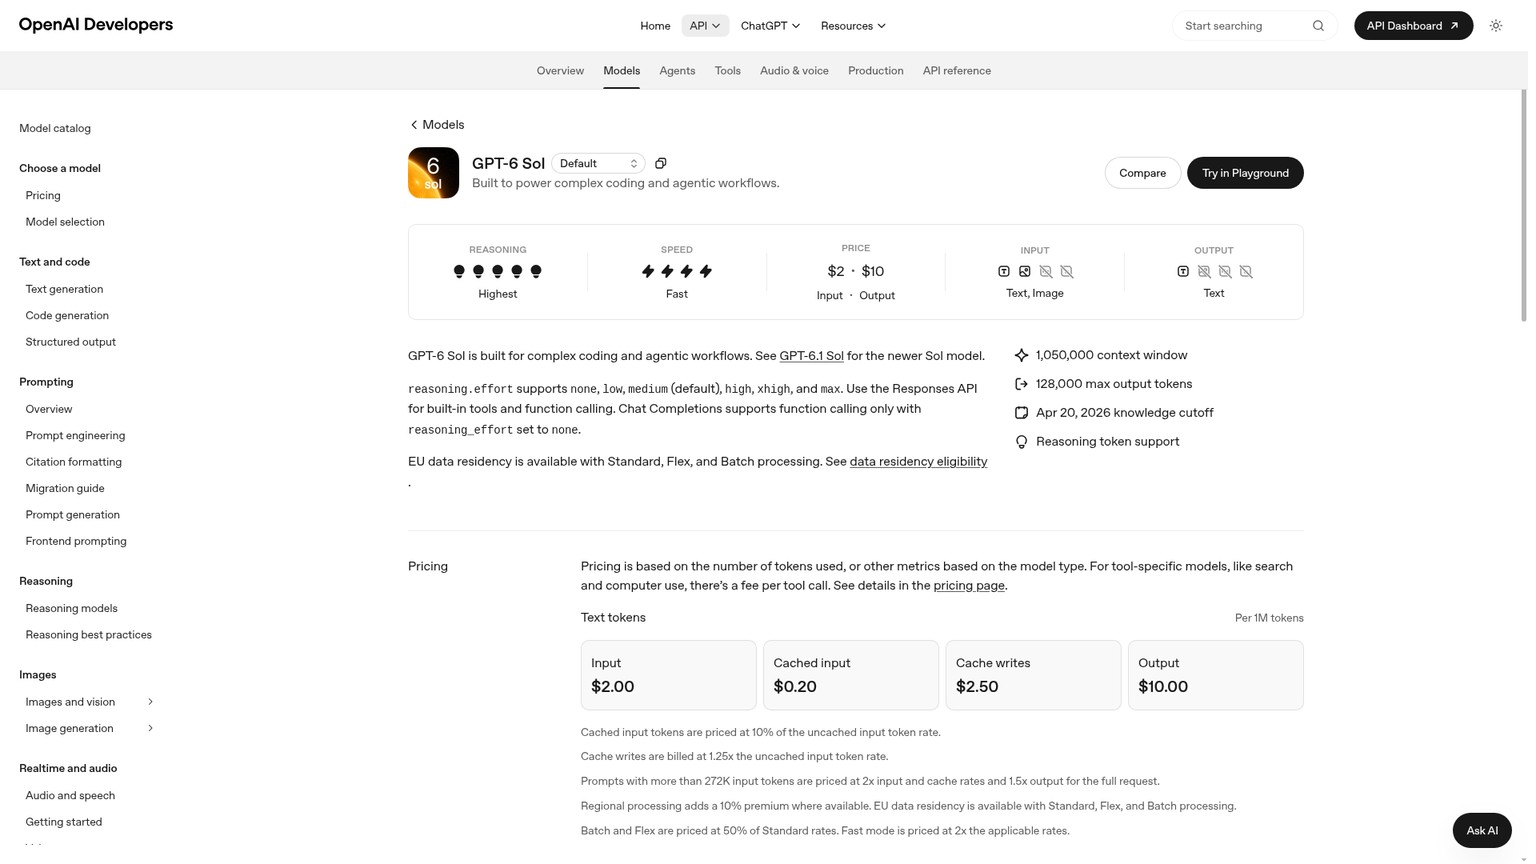
يتطابق سطح أدوات Responses لديه مع القائمة الموثقة للنموذج الأحدث. الفارق العملي هو منفذ التوافق القديم: يستطيع Chat Completions استدعاء الدوال عندما يكون جهد الاستدلال none. وهذا يجعل GPT-6 Sol الفائز مؤقتًا لتطبيق مستقر لم ينقل حلقة أدواته إلى Responses. لكنه ليس النموذج الأرخص متى ظهرت قراءات من الذاكرة المؤقتة.
الفائز: تعادل في السياق وحد الإخراج والوسائط وأدوات Responses الموثقة. يتفوق GPT-6.1 Sol في حداثة المعرفة، ويتفوق GPT-6 Sol في التوافق مع الأنظمة القديمة.
ترقية GPT-6.1 Sol: افحص التوافق أولًا
يمكن أن تكون ترقية GPT-6.1 Sol مجرد تغيير من سطر واحد للنموذج، لكن فقط إذا كان نظام الاستدعاء يستخدم Responses بالفعل، ولا يعتمد على none أو minimal، ويتعامل مع مخرجات النموذج كسلوك يجب التحقق منه لا كعقد بديل مطابق. أما الحالات الأخرى فتحتاج إلى عمل انتقال قبل تقييم النموذج.
استدعاء الأدوات في GPT-6.1 Sol
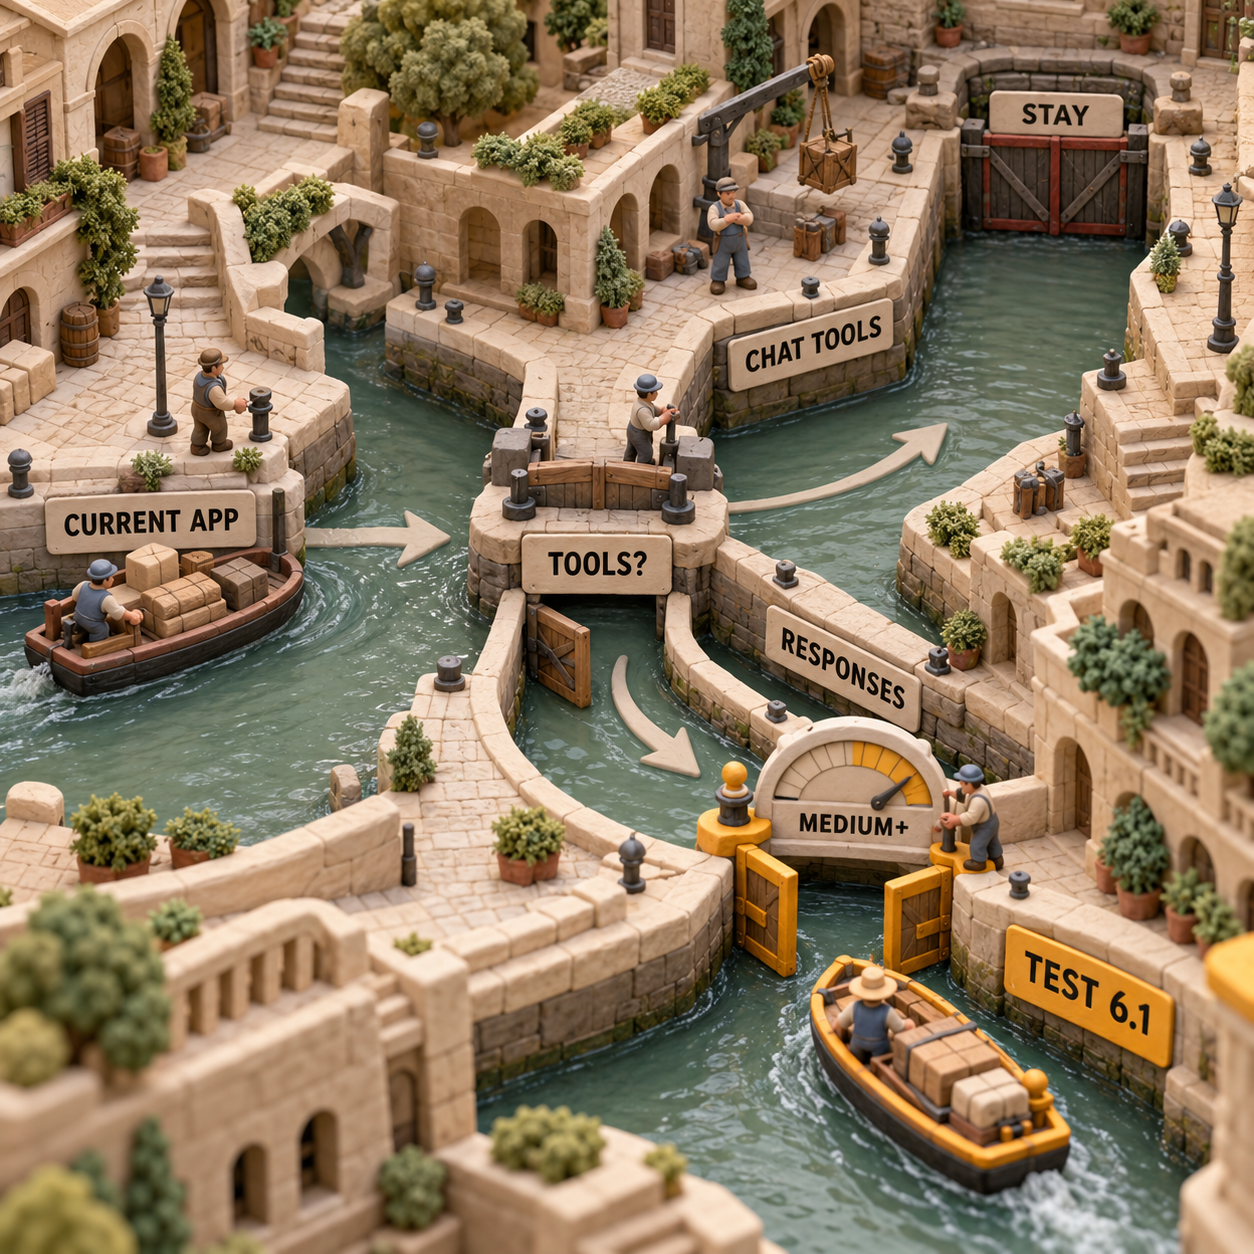
يتطلب استدعاء الأدوات في GPT-6.1 Sol استخدام Responses API. يظل Chat Completions متاحًا لاستدعاءات النموذج النصية من دون أدوات، لكنه لا يدعم استدعاء الأدوات هنا. يختلف GPT-6 Sol: تسمح صفحة النموذج باستدعاء الدوال عبر Chat Completions فقط عند ضبط reasoning_effort على none.
افحص كل نظام قائم يستدعي الدوال عبر Chat Completions قبل تغيير معرّف النموذج. قد تشمل تكلفة الانتقال بناء الطلب وحالة المحادثة ومعالجة نتائج الأدوات وتحليل الاستجابة ومنطق إعادة المحاولة والتتبع واستقرار بداية المطالبة المخزنة مؤقتًا. وجود غلاف برمجي يخفي نقطة النهاية لا يلغي هذه الفروق؛ بل يغير فقط موضع اختبارها.
الاستدلال عقد ثانٍ أيضًا. لا يدعم GPT-6.1 Sol الإعدادين none أو minimal. إذا كان مسار إنتاج يستخدم none لتقليل زمن الاستجابة أو ضبط اختيار الأدوات أو التحكم في التكلفة، فلا يمكن افتراض أن أقرب إعداد صالح مكافئ له سلوكيًا. انقل المسار إلى جهد مدعوم، ثم نفذ اختبارات القبول نفسها قبل مقارنة السرعة أو الإنفاق.
من ينبغي له عدم الانتقال بعد؟
لا تغير النموذج الافتراضي بعد إذا انطبق أي مما يلي:
- لا تزال استدعاءات الأدوات تعمل عبر Chat Completions.
- يستخدم أحد المسارات جهد الاستدلال
noneأوminimalصراحةً. - معظم الرموز المفوترة من الإدخال الجديد والإخراج، ولذلك لا يكون توفير الذاكرة المؤقتة مؤثرًا.
- يجتاز النموذج الحالي اختبارات القبول الخاصة بالعمل بالفعل، ولم يُقَس أي تحسن من GPT-6.1 Sol على الحالات نفسها.
- يحتاج نشر خاضع للتنظيم إلى مراجعة منفصلة لوضع المعالجة وموقع البيانات والسجلات وتغير سلوك النموذج.
هذا ارتباط بسير العمل، لا ارتهان دائم للمورّد. قد تكون أسماء النموذجين متقاربة، لكن نظام الاستدعاء ربما يكون مرتبطًا بنقطة نهاية وحد أدنى للاستدلال وشكل استجابة وحلقة أدوات. احتسب تكلفة هذا التحقق ضمن تكلفة الترقية.
الفائز: GPT-6 Sol لنظام استدعاء غير متوافق اليوم. GPT-6.1 Sol بعد اجتياز نظام الاستدعاء وحالات الاختبار.
شغّل خمس حالات ثابتة قبل تغيير الإعداد الافتراضي
استخدم خمس حالات ثابتة مع معرّفي النموذجين الدقيقين عند جهد medium، وبالمطالبات والأدوات والسياق وحدود الإخراج واختبارات القبول نفسها. هذا تصميم تقييم مقترح، وليس اختبارًا نُفذ لهذه المقالة.
إصلاح خلل في مستودع برمجي
امنح النموذجين الاختبار الفاشل نفسه وحالة المستودع نفسها والأدوات المسموح بها نفسها. لا تقبل إلا تعديلًا يصلح الخلل المستهدف من دون كسر مجموعة الاختبارات القائمة.
إعادة هيكلة عبر ملفات متعددة
استخدم تغييرًا محدود النطاق يشمل عدة ملفات، مع بوابة للبناء والتحليل الساكن والاختبارات. ارفض الشرح المصقول إذا فشل فحص المستودع.
توجيه حالة دعم
قدّم السياسة ورسالة العميل وأدوات التوجيه نفسها. اشترط اختيار قائمة الانتظار والأولوية والحقول المنظمة الصحيحة، ومنع أي إجراء غير مدعوم.
الإجابة بأدلة من السياسة
اطلب إجابة موجهة إلى العميل ومستندة إلى مجموعة المستندات نفسها. لا تقبل إلا الخلاصة المطلوبة والأدلة المستشهد بها وسلوك التصعيد الصحيح.
إكمال سير عمل تجاري
استخدم مهمة البحث والتحديث متعددة الخطوات نفسها ضمن حدود صلاحيات محددة. اشترط تسلسل الأدوات الصحيح والحالة النهائية المطلوبة ورفض أي خطوة غير مصرح بها.
سجّل المخرجات المقبولة وزمن التنفيذ الكامل والإدخال الجديد والإدخال المخزن مؤقتًا ورموز الاستدلال والإخراج ورسوم الأدوات والمحاولات المتكررة. ثم احسب التكلفة الإجمالية لكل نتيجة مقبولة، لا تكلفة الاستجابة الأولى:
effective cost per accepted result = total model, retry, and tool spend / accepted outputs
قد يقلب المقام قصة أسعار الرموز. فنموذج يوفر $0.90 في دفعة كثيفة استخدام الذاكرة المؤقتة قد يصبح أعلى تكلفة إذا أضاف محاولة فاشلة واحدة لتشغيل أداة. ونموذج يتساوى في سعر الرموز الجديدة قد يكون الأرخص في الإنتاج إذا أزال المحاولات المتكررة.
التوافر يختلف بين API وWork وCodex وChat
يتوفر GPT-6.1 Sol عبر API بالمعرّف gpt-6.1-sol، كما يتوفر وفق إعلان OpenAI عند الإطلاق في ChatGPT Work وCodex لمستخدمي خطط Plus وPro وBusiness وEnterprise وEdu. ولم يكن متاحًا في Chat العادي عند الإطلاق.
وتقول OpenAI أيضًا إن GPT-6.1 Sol Ultrafast سيصدر لاحقًا، مع توليد رموز أسرع بما يصل إلى 8x من السرعة القياسية في Codex. لا ينشر الإعلان سعر Ultrafast، لذلك لا تبنِ توقعًا للتكلفة على معامل غير رسمي.
يُفوتر استخدام API بصورة منفصلة عن اشتراك ChatGPT. ولا يعني الوصول عبر Work أو Codex أن أسعار API البالغة $2 و$10 تصبح حصة استخدام مشمولة لتطبيق إنتاجي.
الأسئلة الشائعة
ما GPT-6 SOL؟
GPT-6 Sol هو نموذج OpenAI للبرمجة المعقدة وسير العمل القائم على الوكلاء، ويحمل معرّف API gpt-6-sol. أما GPT-6.1 Sol فهو ترقية 29 سبتمبر 2026، ويقدم سعرًا أقل للإدخال المخزن مؤقتًا ونطاق توافق مختلفًا للاستدلال واستدعاء الأدوات.
ما مقدار تحسن GPT Sol؟
لا توجد نسبة واحدة صادقة. تفيد OpenAI بأن GPT-6.1 Sol يتقدم على GPT-6 Sol بفارق 6.4 نقطة مئوية في DeepSWE و4.8 نقطة في AutomationBench و7 نقاط في OSWorld ضمن إعدادات محددة. يجب أن يحدد عبء عملك الثابت ما إذا كانت هذه المكاسب تنتقل إليه.
أي إصدار من GPT أفضل؟
GPT-6.1 Sol هو النموذج الأفضل للاختبار في أعمال البرمجة ووكلاء الأعمال المتوافقة. أما GPT-6 Sol فهو بيئة التشغيل المؤقتة الأفضل عندما تظل بحاجة إلى استدعاء الأدوات عبر Chat Completions أو إلى الاستدلال none.
ما ميزات وأسعار نماذج GPT-6 Sol وLuna الجديدة من OpenAI؟
هذا قرار سابق على مستوى عائلة النماذج. تغطي مقارنة GPT-6 Sol وLuna أدوارهما في توجيه المهام واقتصاديات الرموز الحالية؛ أما هذه الصفحة فتركز على ما إذا كان ينبغي نقل عبء عمل قائم على Sol إلى GPT-6.1 Sol.
أيهما أفضل: GPT بنسخة Sol أم Terra أم Luna؟
لا يوجد فائز عام في عائلة النماذج. طابق النموذج مع صعوبة المهمة وزمن الاستجابة وتكلفة النتيجة المقبولة، ثم قيّم المعرّفات الدقيقة التي تنوي نشرها. تدعم هذه المقارنة قرار الترقية من Sol إلى Sol، لا إصدار حكم على Terra أو Luna.
هل GPT-6 Sol أرخص؟
لا، وفق أسعار الرموز القياسية الموثقة. يتعادل GPT-6 Sol مع GPT-6.1 Sol في الإدخال الجديد والكتابة إلى الذاكرة المؤقتة والإخراج، بينما يكون GPT-6.1 Sol أرخص في الإدخال المخزن مؤقتًا عند $0.10 مقابل $0.20 لكل مليون رمز.
هل يستحق اشتراك ChatGPT بسعر $20؟
هذا قرار يخص اشتراك المستهلك، وليس مقارنة لأسعار نماذج API. كان GPT-6.1 Sol متاحًا عند الإطلاق في Work وCodex ضمن الخطط المدفوعة المذكورة، لكنه لم يكن متاحًا في Chat العادي، كما يُفوتر استخدام API بصورة منفصلة.
هل GPT-5.6 Sol أفضل من GPT-5؟
لا تحسم تلك المقارنة الأقدم قرار الترقية هذا. للنشر الحالي، قيّم GPT-6.1 Sol وGPT-6 Sol باستخدام مسار API وجهد الاستدلال والأدوات واختبارات القبول نفسها التي يستخدمها التطبيق.
ما مدى جودة GPT-6؟
تختلف قدرة GPT-6 باختلاف النموذج والمهمة والجهد وإعداد الأدوات. لدى GPT-6.1 Sol أدلة أقوى تقدمها الجهة المطورة مقارنةً بـ GPT-6 Sol في عدة تقييمات صعبة، لكن تقييمًا خاصًا وثابتًا هو ما يحسم قرار الإنتاج.
ما أوزان GPT-6.1 Sol مقارنةً بـ GPT-6 Sol؟
لا تنشر صفحات النماذج المباشرة من OpenAI عدد المعاملات أو أوزانًا قابلة للتنزيل لأي من النموذجين. قارن بدلًا من ذلك الحدود والأسعار وسلوك API ونتائج المهام المقاسة والموثقة.
ما الذي ينبغي فعله يوم الاثنين؟
ابدأ بنظام الاستدعاء، لا بقائمة اختيار النموذج. ابحث في الشيفرة وإعدادات سير العمل عن استدعاءات الدوال عبر Chat Completions وعن قيم reasoning_effort التي تساوي none أو minimal. إذا وجدت أيًا منها، فحدد نطاق الانتقال قبل تغيير الإعداد الافتراضي.
بعد ذلك شغّل الحالات الخمس الثابتة على gpt-6-sol وgpt-6.1-sol عند جهد medium، مستخدمًا الأدوات والفحوص نفسها. قارن تكلفة النتيجة المقبولة وزمن الاستجابة واستخدام الذاكرة المؤقتة والمحاولات المتكررة. اعتمد GPT-6.1 Sol في المسارات التي يتفوق فيها، واترك البقية على GPT-6 Sol إلى أن تُغلق فجوة التوافق أو النتائج.
احصل على قائمة التحقق لإعداد Claude Code وCodex قبل تغيير مسار نموذج في بيئة الإنتاج.
- آخر تحديث
- 30 سبتمبر 2026
- التصنيف
- AI
فضّل هذا الموقع في Google


اجعل omidsaffari.com مصدرًا مفضّلًا، وسيرفعه Google لك في Top Stories وAI Overviews وAI Mode.

كيفية استخدام Claude Sonnet 5.5 بفاعلية
تعلّم كيفية استخدام Claude Sonnet 5.5 في مهام محددة، وضبط مستوى الجهد، والتحقق من المخرجات، ونقل تكامل API بأمان مع أمثلة عملية وتكلفة واضحة.28 سبتمبر 2026AI
مقارنة Jev وGLM-5.3-Flash: أيهما أنسب لاتخاذ القرار؟
مقارنة عملية بين Jev وGLM-5.3-Flash في تكلفة توجيه التذاكر، ودعم الصور، والسرعة، والدقة، مع خطة اختبار تساعدك على اختيار المسار الأنسب لعملك.27 سبتمبر 2026AI
Claude Opus 5.5 أم Opus 5: مقارنة التكلفة والأداء قبل الترقية
مقارنة عملية بين Claude Opus 5.5 وOpus 5 تشمل أسعار الرموز، وفورات التخزين المؤقت، أداء البرمجة، وتغييرات API التي يجب فحصها قبل الترقية بأمان.23 سبتمبر 2026AI
مقارنة GPT-6 Sol و GPT-6 Luna: متى يستحق Sol فرق السعر؟
مقارنة عملية بين GPT-6 Sol و GPT-6 Luna في السعر والأداء والبرمجة، مع قاعدة واضحة لاختيار النموذج الأرخص وتصعيد المهام الصعبة عندما تبرر النتائج فرق السعر.23 سبتمبر 2026AI
هل GPT-6 Luna مجاني؟ دليل الخطط والأسعار والحدود
هل GPT-6 Luna مجاني؟ نوضح عمليًا أين يتوفر بلا تكلفة لحسابات Free وGo، وما الذي تتطلبه خطط Work وCodex، وأسعار API وحدود الاستخدام غير المعلنة.22 سبتمبر 2026AI
Xiaomi MiMo عمليًا: إعداد MiMo V2.6 وبناء أول سير عمل
دليل عملي لاختبار Xiaomi MiMo في AI Studio، واختيار مفتاح API الصحيح، وتشغيل MiMo V2.6 Flash، ثم مقارنة التكلفة والأداء قبل ربط بيانات العملاء.22 سبتمبر 2026AI
Xiaomi MiMo V2.6: متى تختار Pro ومتى يكفي Flash؟
دليل عملي لمقارنة Xiaomi MiMo V2.6 Pro وFlash في البرمجة ومهام الوكلاء الذكيين: تكاليف التوكنات، وفورات التخزين المؤقت، ومتى تبرر جودة Pro سعره الأعلى.22 سبتمبر 2026AI